

MIDAS रिग्रेशन: मिश्रित-आवृत्ति डेटा और अस्थिरता पूर्वानुमान
जानें कि MIDAS रिग्रेशन दैनिक और साप्ताहिक वित्तीय डेटा को सीमित लैग-वेट से कैसे जोड़ता है, अस्थिरता का पूर्वानुमान कैसे बनता है, और मिश्रित-आवृत्ति मॉडल कहाँ भटका सकते हैं।
इस गाइड मेंप्रेक्षण आवृत्ति के अंतर को MIDAS संबोधित करता है
संक्षिप्त सारांश
MIDAS (mixed data sampling) रिग्रेशन अलग-अलग आवृत्तियों पर दर्ज प्रेक्षणों को जोड़ता है, बिना पहले हर श्रृंखला को जबरन एक ही कैलेंडर पर लाए। कुछ अनुमानित पैरामीटर उच्च-आवृत्ति प्रेक्षणों के इतिहास को वेट देते हैं, जिससे कम-आवृत्ति वित्तीय लक्ष्य का पूर्वानुमान बनाने में मदद मिल सकती है। ये वेट चुने गए मॉडल के तहत पूर्वानुमान का एक पैटर्न बताते हैं; वे कारण-संबंध या ट्रेडिंग बढ़त सिद्ध नहीं करते।
प्रेक्षण आवृत्ति के अंतर को MIDAS संबोधित करता है
वित्तीय और आर्थिक डेटा एक ही घड़ी पर नहीं आते। अस्थिरता का लक्ष्य साप्ताहिक मापा जा सकता है, जबकि संभावित पूर्वानुमानक दैनिक रिटर्न या इंट्राडे realized measures हों। कोई मैक्रोइकॉनॉमिक श्रृंखला तिमाही हो सकती है, जबकि परिसंपत्ति का भाव हर ट्रेडिंग दिन देखा जाता है। साधारण रिग्रेशन लक्ष्य और पूर्वानुमानकों के लिए प्रति प्रेक्षण एक पंक्ति मानता है, इसलिए परिचित मॉडल का अनुमान लगाने से पहले तय करना पड़ता है कि इन अलग कैलेंडरों को कैसे संभालें।
एक विकल्प दैनिक इनपुट को साप्ताहिक औसत या योग में जोड़ना है। यह सरल है, पर हर दिन को एक खास वेट देता है और सप्ताह के भीतर बदलाव कब हुआ, यह मिटा सकता है। दूसरा विकल्प तिमाही मान को दैनिक पंक्तियों में दोहराना या interpolate करना है। दोहराने से धीरे बदलने वाला मान कई नए प्रेक्षणों जैसा दिख सकता है; interpolation ऐसा चिकना पथ बना सकती है जो कभी देखा ही नहीं गया। इनमें से कोई भी नई जानकारी नहीं बनाता।
MIDAS आवृत्तियों को जोड़ने का सीधा तरीका देता है। यह लक्ष्य को उसकी स्वाभाविक कम आवृत्ति पर रखता है और उच्च-आवृत्ति श्रृंखला के संरचित लैग शामिल करता है। नाम mixed data sampling को बताता है, किसी एक अस्थिरता मॉडल को नहीं। शोधकर्ता अस्थिरता पूर्वानुमान के लिए और उन अन्य स्थितियों में भी MIDAS रिग्रेशन इस्तेमाल करते हैं जहाँ पूर्वानुमानक परिणाम से अधिक सूक्ष्म अंतराल पर मापे जाते हैं। मुख्य सवाल है कि हाल के उच्च-आवृत्ति इतिहास का कितना हिस्सा लें और उसके वेट कैसे सीमित करें।
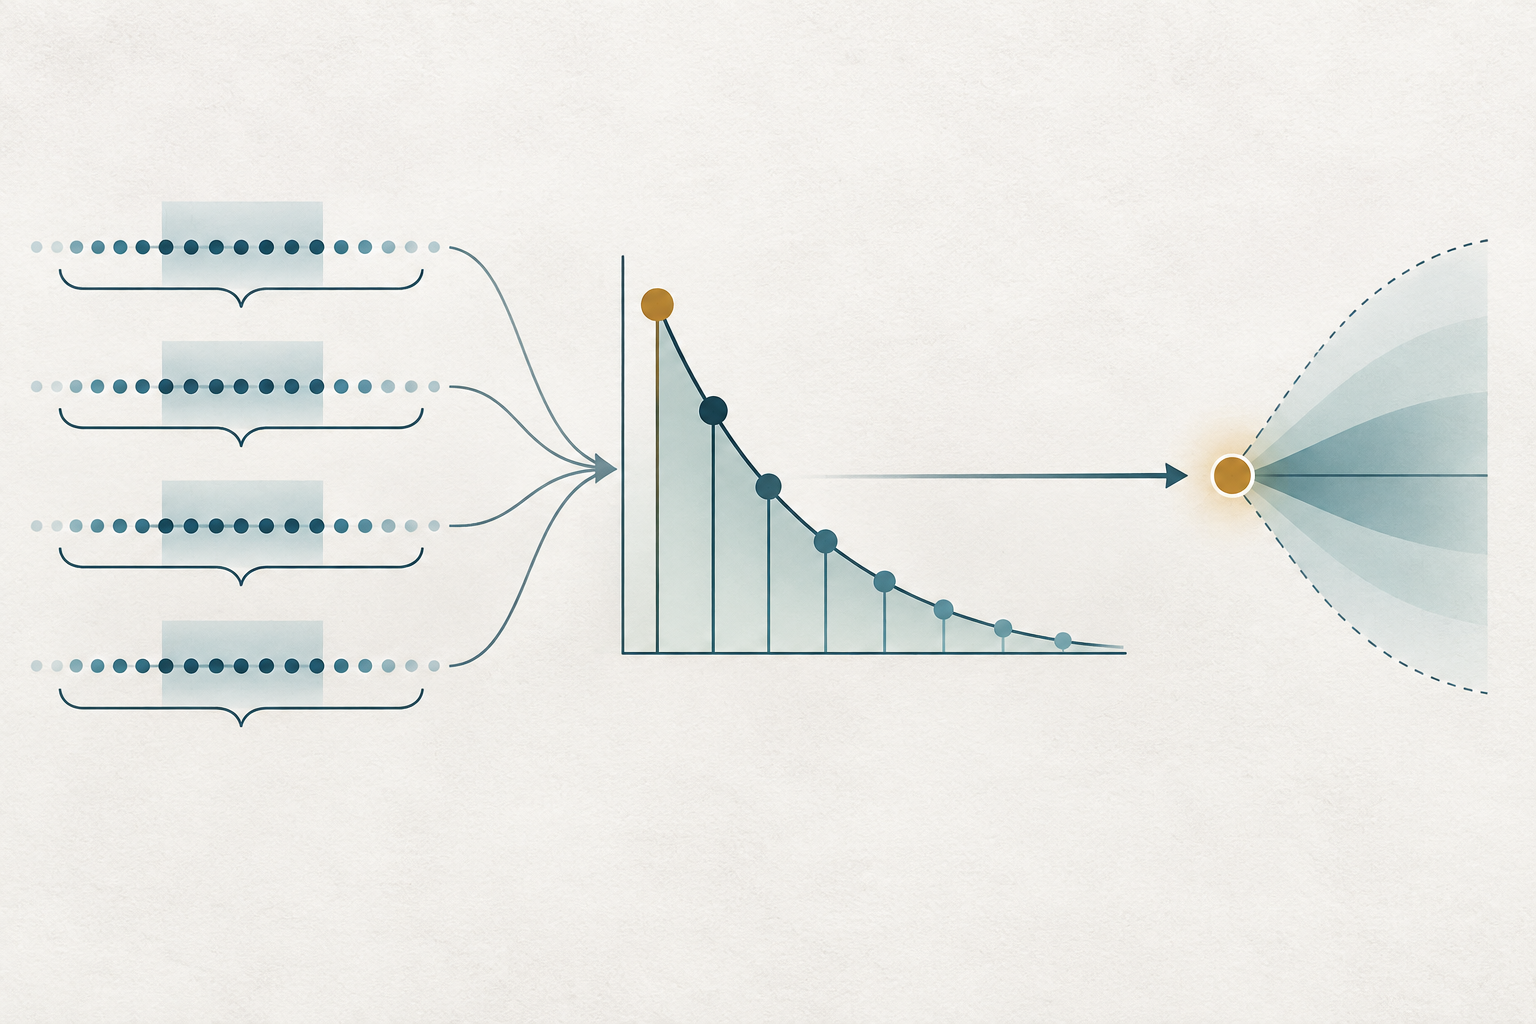
वेटेड लैग कई प्रेक्षणों को एक संक्षिप्त पूर्वानुमानक बनाता है
मान लें कि \(y_{t+1}\) कम-आवृत्ति लक्ष्य है, जैसे अगले सप्ताह का realized variance, जो \(t+1\) सप्ताह समाप्त होने के बाद दिखता है। \(x_{t-j}\) वह दैनिक पूर्वानुमानक है जो सप्ताह \(t\) के अंत में पूर्वानुमान origin से \(j\) ट्रेडिंग सत्र पहले देखा गया। एक सरल MIDAS रिग्रेशन है \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), जहाँ \(K\) दैनिक लैग की संख्या है, \(w_j(\theta)\) कुछ पैरामीटरों से नियंत्रित वेट है, और \(u_{t+1}\) पूर्वानुमान त्रुटि है।
वेट अक्सर इस तरह normalize किए जाते हैं कि \(\sum_{j=1}^{K}w_j(\theta)=1\)। इससे वेटेड योग को वेटेड इतिहास की तरह समझना आसान होता है, जबकि \(b\) उस सारांश और लक्ष्य के संबंध की ताकत नियंत्रित करता है। normalization का अर्थ यह नहीं कि दैनिक प्रेक्षण स्वतंत्र या समान रूप से सूचनाप्रद हैं। यह लैग प्रोफाइल का सुविधाजनक पैरामीटरकरण है।
विश्लेषक \(x\) के रूप में दैनिक squared returns, absolute returns, intraday returns से बना realized-variance माप, या पूर्वानुमान origin पर उपलब्ध कोई दूसरा चर चुन सकता है। लक्ष्य \(y\) भविष्य का साप्ताहिक variance, मासिक मैक्रोइकॉनॉमिक रिलीज़, या कोई और कम-आवृत्ति परिणाम हो सकता है। लक्ष्य की परिभाषा गुणांकों का अर्थ तय करती है। realized-variance proxy का मॉडल अपने-आप latent instantaneous variance, option-implied variance, या कीमत के रिटर्न का मॉडल नहीं बन जाता।
MIDAS रिग्रेशन ढाँचा है, सार्वभौमिक estimator नहीं। प्रतिक्रिया को level, log या link function में मॉडल किया जा सकता है; अनुमान चुने गए वेट परिवार और error assumptions पर निर्भर करता है। गैर-ऋणात्मक variance proxy पर linear regression, जब तक specification पूर्वानुमान को सीमित न करे या लक्ष्य को transform न करे, ऋणात्मक fitted values दे सकता है। मॉडल की सुविधा लक्ष्य के support और units जाँचने की जरूरत खत्म नहीं करती।
वेट फ़ंक्शन लचीलेपन के बदले स्थिरता देता है
बिना प्रतिबंध वाली distributed-lag regression में \(K\) दैनिक इनपुटों में हर एक के लिए अलग गुणांक अनुमानित होता है। यदि साप्ताहिक लक्ष्य प्रेक्षणों की तुलना में \(K\) बड़ा है, तो अनुमान noisy और आपस में अधिक correlated हो सकते हैं। इसके बजाय MIDAS कम-आयामी फ़ंक्शन से lag coefficients तय करता है। उदाहरण के लिए exponential-Almon profile है \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\)। normalized Beta-polynomial profile भी आम है।
ये profile हाल के सत्रों को अधिक वेट दे सकते हैं, धीरे-धीरे घट सकते हैं, या lag window के बीच के हिस्से को अपेक्षाकृत अधिक वेट दे सकते हैं। पैरामीटर चुने गए चिकने curve को बताते हैं, हर दिन का महत्व बिना शर्त नहीं। यदि डेटा छोटी अवधि की प्रतिक्रिया दिखाते हों, लेकिन फ़ंक्शन लंबी चिकनी tail थोपता हो, तो fitted coefficients में वह प्रतिबंध शामिल होगा। दूसरी ओर, कई स्वतंत्र दैनिक गुणांक अनुमानित करने से स्थिर dynamics की बजाय noise fit हो सकती है।
वेट संबंधी प्रतिबंध मॉडल की मान्यताएँ हैं। गैर-ऋणात्मक, normalized वेट variance forecast को weighted average की तरह समझना आसान कर सकते हैं, लेकिन एक-दूसरे को offset करने वाले सकारात्मक और नकारात्मक lag effects रोकते हैं। लचीला profile hump या बदलती ढलान दे सकता है, पर बहुत सारे shape parameters कमजोर रूप से पहचाने जा सकते हैं। कुछ उचित profiles की तुलना करें, उपलब्ध lag बताएं और देखें कि वेट परिवार बदलने पर पूर्वानुमान में बड़ा बदलाव आता है या नहीं।
कोई सार्वभौमिक \(K\) नहीं है। लंबी window स्थायी जानकारी पकड़ सकती है, लेकिन पैरामीटर बढ़ाती है या लंबी आकार वाली profile थोपती है; छोटी window धीमी dynamics छोड़ सकती है। lag count estimation period की उपलब्ध जानकारी से चुनें और भविष्य के evaluation target का उपयोग किए बिना validate करें। नमूने के भीतर अच्छा fit अपने-आप यह नहीं बताता कि window दोहराया जा सकने वाला signal पकड़ती है।
पूर्वानुमान origin को हर मान के उपलब्ध होने के समय से मिलाएँ
आवृत्ति के लेबल वैध forecasting design के लिए पर्याप्त नहीं हैं। मान लें लक्ष्य आने वाले पाँच-सत्र वाले सप्ताह का variance है और पूर्वानुमान शुक्रवार के close के बाद जारी किया जाता है। शुक्रवार तक समाप्त दैनिक प्रेक्षण predictor हो सकते हैं, लेकिन अगले सप्ताह के रिटर्न से निकला realized-variance statistic नहीं। प्रकाशित साप्ताहिक या मासिक statistic उस अवधि के बाद जारी हो सकता है जिसका वह वर्णन करता है। Backtest में उस समय वास्तव में उपलब्ध मान लें, बाद में संशोधित या प्रकाशित मान नहीं।
मॉडल fit करने से पहले forecast-origin तालिका लिखें: पूर्वानुमान कब बनता है, हर predictor का नवीनतम अनुमत timestamp, लक्ष्य अवधि, और लक्ष्य कब दिखाई देता है। वित्तीय रिटर्न में बताएं कि close-to-close return overnight interval शामिल करता है या नहीं, कौन-सा market session एक दिन है, और छुट्टियाँ या missing bars दैनिक lag count कैसे बदलते हैं। पाँच ट्रेडिंग सत्र और सात कैलेंडर दिन अलग अंतराल हैं।
रिलीज़ कैलेंडर में ragged edges बनते हैं। किसी तारीख पर एक predictor का नया daily value हो सकता है, जबकि monthly series अभी जारी न हुई हो। पिछले उपलब्ध मासिक मान को आगे रखना ठीक हो सकता है, यदि मॉडल उसे origin पर ज्ञात पुरानी जानकारी माने। बाद में आई release से अभी अप्रकाशित observation भरना गलत है। ऐतिहासिक revisions अधिक सूक्ष्म look-ahead समस्या पैदा कर सकती हैं: मौजूदा database में revised macro series हो सकती है जो live forecaster को तब उपलब्ध नहीं थी।
अलग समय पर बंद होने वाले बाजार alignment की एक और समस्या जोड़ते हैं। दैनिक equity close और crypto close अलग UTC intervals दर्शा सकते हैं; intraday volatility estimate में forecast time के बाद पूरी हुई bars हो सकती हैं। Time-zone conversion, daylight-saving बदलाव, venue closures और bar construction information set का हिस्सा हैं। इनके निपटारे का तरीका बताएं, यह न मानें कि एक ही तारीख की पंक्तियों का information cutoff समान है।
एक काल्पनिक उदाहरण दैनिक इनपुट से साप्ताहिक पूर्वानुमान बनाता है
मान लें लक्ष्य अगले सप्ताह का realized variance है और पूर्वानुमान शुक्रवार के close पर जारी होता है। मॉडल अभी पूरे हुए सप्ताह के पाँच दैनिक realized-variance inputs लेता है। सबसे नए से पुराने क्रम में अनुमानित वेट \(0.40, 0.25, 0.16, 0.11, 0.08\) हैं, जिनका योग एक है। संबंधित दैनिक इनपुट squared-return units में \(0.0004, 0.0001, 0.0009, 0.0004, 0.0001\) हैं।
उनका weighted history है \(0.40(0.0004)+0.25(0.0001)+0.16(0.0009)+0.11(0.0004)+0.08(0.0001)=0.000381\)। इस काल्पनिक fitted model में intercept \(a=0.00012\) और slope \(b=0.80\) मानें। अगले सप्ताह का variance forecast है \(0.00012+0.80(0.000381)=0.0004248\)। यदि standard-deviation सारांश उपयोगी हो, तो इसका square root लगभग \(0.02061\), यानी चुनी गई target definition के अनुसार सप्ताह में \(2.06\%\) है।
यह गणना दिखाती है कि दैनिक predictors भविष्य के साप्ताहिक लक्ष्य से कैसे जुड़ते हैं; मान और fitted coefficients काल्पनिक हैं। इसका अर्थ यह नहीं कि किसी खास दिन ने अगले सप्ताह का variance पैदा किया या परिसंपत्ति ऊपर या नीचे जाएगी। हाल के सत्र का weight बताता है कि निर्दिष्ट predictive model नमूने और प्रतिबंधों के अधीन देखे गए inputs को कैसे मिलाता है। यह causal response estimate नहीं है।
उदाहरण units का सवाल भी दिखाता है। दैनिक realized variance और साप्ताहिक realized variance दोनों returns के variance हैं, लेकिन accumulation intervals अलग हैं। slope \(b\), intercept और target construction उसी परंपरा के लिए सीखे जाते हैं; दैनिक inputs को बस साप्ताहिक variance नहीं कहा जा सकता। यदि लक्ष्य log weekly variance हो, तो मॉडल का output log units में होगा और conditional log mean को exponentiate करना सामान्यतः conditional mean variance के बराबर नहीं होगा। Level में वापस जाने के लिए स्पष्ट prediction target और जहाँ उचित हो retransformation correction चाहिए।
अनुमान लक्ष्य और lag प्रतिबंध पर निर्भर करता है
वेट vector निश्चित हो तो regression intercept और slope में linear है। जब वेट अज्ञात nonlinear parameter \(\theta\) पर निर्भर हों, तो estimation में अक्सर nonlinear least squares या संबंधित likelihood-based तरीका इस्तेमाल होता है। Estimator वेट-shape parameters और regression coefficients को साथ खोजता है, या हर candidate shape के लिए linear coefficients profile out करता है। Starting values, parameter bounds, convergence criteria और local optima की संख्या मायने रख सकते हैं; असफल convergence या boundary solution छिपाना नहीं चाहिए।
यदि \(y\) गैर-ऋणात्मक volatility measure है, तो सामान्य linear specification खासकर नमूने के बाहर negative fitted value दे सकती है। विकल्पों में level को गैर-ऋणात्मक रखने वाले प्रतिबंध, positive link या target का log लेना शामिल हैं। ये चयन estimand और forecast interpretation बदलते हैं। Log-target model में log variance के conditional mean का forecast अपने-आप variance का conditional mean नहीं होता; disturbance distribution और retransformation अहम हैं।
Sampling uncertainty इस पर भी निर्भर करती है कि लक्ष्य कैसे बनाया गया। Intraday returns से weekly realized variance में measurement error होता है और यह microstructure noise, sampling interval, jumps और missing observations से प्रभावित हो सकता है। यदि weekly target windows overlap करें, तो पड़ोसी origins की forecast errors underlying returns साझा करती हैं। तब independent forecast errors मानने वाले standard errors या comparisons अनुपयुक्त हो सकते हैं। Forecast horizon और dependence structure के अनुकूल inference लें और लक्ष्य की measurement procedure बताएं।
Parameter stability भी चिंता है। अनुमानित weight profile estimation sample का औसत है; market structure बदल जाए तो curve किसी मौजूदा regime का सही वर्णन न करे। Expanding और rolling estimates अलग प्रश्नों के उत्तर देते हैं: पहला अधिक इतिहास लेता है लेकिन पुरानी dynamics रखता है; दूसरा तेजी से ढलता है पर observations कम और estimation noise अधिक होती है। Update rule पहले तय करें और chronological evaluation में fixed benchmark से तुलना करें।
MIDAS, GARCH-MIDAS से संबंधित है, लेकिन समान नहीं
MIDAS अलग-अलग sampling frequencies के observations को weighted lags से जोड़ने का तरीका है। MIDAS regression पुराने daily या intraday measures से future realized-volatility target का सीधा forecast दे सकता है। इसमें GARCH model से जुड़ा one-step conditional-variance recursion होना जरूरी नहीं।
GARCH-MIDAS एक अलग family है जो धीमे चलने वाले long-run volatility component—अक्सर lower-frequency variables से प्रेरित—को recursive short-run conditional-variance component के साथ जोड़ती है। दोनों की parameterization और assumptions अलग हैं। GARCH-MIDAS label वाले paper या software package की सटीक equations देखें: MIDAS weights long-run component चला सकते हैं, जबकि GARCH recursion short-run shocks संभालती है। नाम से target, forecast latent है या realized volatility, और positivity कैसे लागू है, यह नहीं पता चलता।
शुरुआती financial MIDAS volatility research एक parsimonious forecasting framework में अलग predictors, frequencies और lag lengths की तुलना करता है। बाद के methodological work mixed-frequency regression models के estimation और testing गुणों को विकसित करते हैं, जिनमें traditional temporal aggregation से तुलना भी है। ये योगदान mechanics का समर्थन करते हैं, यह दावा नहीं कि MIDAS हमेशा GARCH को पछाड़ता है या high-frequency predictors हमेशा forecast सुधारते हैं। नतीजे asset, sample, target, predictor, horizon और evaluation design पर निर्भर हैं।
प्रश्न के अनुसार model चुनें। Daily history से future realized-volatility measure forecast करना हो तो direct MIDAS regression स्वाभाविक विकल्प हो सकती है। Conditional variance को recursively model करना हो तो उपयुक्त GARCH specification से तुलना करें। Quarterly macro releases को daily financial target से जोड़ने पर release-vintage controls चाहिए हो सकते हैं। मिलते-जुलते नाम वाले models अलग सवालों के जवाब दे सकते हैं; प्रदर्शन तुलना से पहले forecast origins, target definitions और information sets मिलाएँ।
Measurement error और selection weight curve पर भारी पड़ सकते हैं
High-frequency data समय की अधिक बारीकी दे सकता है, लेकिन measurement noise भी बढ़ाता है। बहुत छोटी bars में bid–ask bounce, price discreteness, stale quotes, asynchronous trading और feed errors होते हैं। लगातार छोटे intervals के squared returns जोड़ना बेहतर realized-variance estimate की गारंटी नहीं है। Forecast performance देखने से पहले sampling grid और cleaning rules चुनें और उचित विकल्पों के प्रति sensitivity जाँचें।
सीखने योग्य जानकारी की सीमा lower-frequency outcomes की संख्या है, daily predictor rows की दिखने वाली संख्या नहीं। Weekly targets से जुड़े दस वर्ष के daily inputs में missing values और holdout evaluation से पहले भी लगभग पाँच सौ साप्ताहिक outcome periods होंगे। Smooth weight function free daily lag से कम coefficients लेता है, पर छोटा sample, अत्यधिक persistent predictors या redundant candidate lags इसके आकार को कमजोर रूप से identified कर सकते हैं।
कई high-frequency measures, lag lengths, weight profiles, transformations, markets, forecast horizons और evaluation losses आज़माकर केवल सबसे अच्छा नतीजा बताना selection bias बनाता है। In-sample fit खास तौर पर कमजोर है, क्योंकि वही targets parameter और model choices तय करते हैं। आज़माई model family दर्ज करें, primary metric चुनें और बाद का chronological holdout या selection-aware comparison इस्तेमाल करें। एक ही तारीखों पर कई forecasts की तुलना हो तो dependence और multiplicity गिनें; हर परिणाम को स्वतंत्र पुष्टि न मानें।
Fitted weight curve causal explanation नहीं है। High-frequency inputs news, liquidity या market activity का proxy हो सकते हैं; unobserved factors predictors और future volatility दोनों चला सकते हैं। Predictive usefulness के लिए स्थिर timing और out-of-sample evidence चाहिए। Causal interpretation के लिए MIDAS lag equation से आगे का अलग identification design और assumptions चाहिए।
Forecast अपने-आप लाभकारी trading decision तय नहीं करता
Volatility forecast risk budget, hedge size या scenario range में मदद कर सकता है, लेकिन return का sign या position की दिशा नहीं बताता। साप्ताहिक standard deviation का \(2.06\%\) forecast वादा किया हुआ move, maximum loss या option-implied volatility quote नहीं है। यह fitted model और sample के तहत चुने dispersion measure का पूर्वानुमान है; realized returns इससे बहुत बड़े या छोटे हो सकते हैं।
Strategy study में test से पहले signal time, order time, instrument, exposure rule और exit तय करें। हर historical origin पर केवल उस समय उपलब्ध जानकारी से MIDAS parameters दोबारा estimate करें। Prespecified benchmark और target-consistent loss के विरुद्ध forecasts जाँचें; फिर spread, fees, funding, borrow, market impact और turnover के बाद returns अलग से simulate करें। Variance forecast सांख्यिकीय रूप से बेहतर हो सकता है, पर after-cost returns में सुधार जरूरी नहीं।
Target और उसकी sampling procedure; predictor definitions और units; lower और higher frequencies; forecast origin; lag count; weight function और constraints; estimation window और update schedule; missing data तथा data vintages का उपचार; loss function; benchmark; और chronological test dates रिपोर्ट करें। यदि lag profile से परिणाम महत्वपूर्ण रूप से बदलता हो तो forecast uncertainty या sensitivity दिखाएँ। संबंधित पृष्ठभूमि के लिए realized volatility, volatility clustering और GARCH, तथा forecast accuracy तुलना देखें।
प्रमुख स्रोत Ghysels, Santa-Clara और Valkanov का MIDAS volatility forecasting अध्ययन, Ghysels, Sinko और Valkanov की methodological review और extensions, तथा Andreou, Ghysels और Kourtellos का mixed-frequency regression models का विश्लेषण हैं। उनके empirical results संबंधित samples और designs तक सीमित हैं; वर्तमान बाजार या दूसरी asset class में performance की गारंटी नहीं।
आम सवाल
Q1क्या MIDAS का अर्थ है कि सभी डेटा को एक आवृत्ति में औसत किया जाता है?
नहीं। MIDAS regression target को उसकी चुनी हुई frequency पर रखता है और higher-frequency predictors का structured weighted lag इस्तेमाल करता है। हर series को एक common row-by-row calendar पर interpolate करने की जरूरत नहीं है।
Q2क्या MIDAS regression, GARCH-MIDAS के समान है?
नहीं। MIDAS mixed-frequency weighted-lag framework है। GARCH-MIDAS, MIDAS-जैसे long-run component को short-run GARCH variance recursion से जोड़ता है। Target और components पहचानने के लिए model equations देखें।
Q3क्या बेहतर MIDAS volatility forecast को trading signal बनाया जा सकता है?
अपने-आप नहीं। Volatility forecast चुने गए dispersion measure का वर्णन करता है। Strategy के लिए अलग directional या risk rule, यथार्थवादी execution costs और chronological after-cost evaluation चाहिए।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
MIDAS weight function की मुख्य भूमिका क्या है?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
विस्तृत गाइड पढ़ेंRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
विस्तृत गाइड पढ़ें