

Diebold–Mariano परीक्षण: दो पूर्वानुमानों की सटीकता कैसे तुलना करें
जानें कि Diebold–Mariano परीक्षण युग्मित पूर्वानुमान-हानियों की तुलना कैसे करता है, अतिव्यापी क्षितिजों को कैसे संभालता है, और कम p-value ट्रेडिंग कौशल का प्रमाण क्यों नहीं है।
इस गाइड मेंबैकटेस्ट की कम त्रुटि अभी बेहतर पूर्वानुमान का प्रमाण नहीं है
संक्षिप्त सारांश
Diebold–Mariano परीक्षण दो पूर्वानुमानों की तुलना उन्हीं वास्तविक परिणामों पर उनकी हानियों को देखकर करता है। नतीजा हानि फलन, मूल्यांकन नमूने, पूर्वानुमान क्षितिज और अनिश्चितता के अनुमान पर निर्भर करता है। नमूने में कम त्रुटि अपने आप बेहतर अपेक्षित सटीकता का प्रमाण नहीं है, और बेहतर पूर्वानुमान सटीकता का अर्थ लाभदायक ट्रेडिंग रणनीति भी नहीं है।
बैकटेस्ट की कम त्रुटि अभी बेहतर पूर्वानुमान का प्रमाण नहीं है
मान लें कि दो मॉडल उन्हीं तारीखों में समान रिटर्न, अस्थिरता या आर्थिक मात्रा का पूर्वानुमान करते हैं। मूल्यांकन नमूने में मॉडल A की औसत त्रुटि मॉडल B से कम हो सकती है। यह नमूने में देखे गए अंतर का वर्णन करता है, लेकिन यह नहीं बताता कि अंतर भरोसेमंद ढंग से दोहराया जाएगा या संयोग से चुनी गई परीक्षण तारीखों के कारण बना।
Diebold–Mariano (DM) परीक्षण इस तुलना को युग्मित समय-श्रृंखला में बदलता है। हर पूर्वानुमान आरंभ पर यह दोनों पूर्वानुमानों की तुलना उसी वास्तविक परिणाम से करता है, पहले से चुने गए हानि फलन से उनका मूल्यांकन करता है और फिर हानि-अंतर की पूरी श्रृंखला देखता है। युग्मन महत्वपूर्ण है: बाजार का अस्थिर दिन दोनों मॉडलों की हानि बढ़ा सकता है, जबकि तुलना यह पूछती है कि उन्हीं दिनों में क्या एक मॉडल आम तौर पर कम हानि उठाता है।
मूल ढाँचा केवल वर्ग त्रुटि या सामान्य-वितरित पूर्वानुमान त्रुटियों तक सीमित नहीं है। पूर्वानुमान के प्रश्न से मेल खाने पर यह असममित हानि फलनों सहित अलग-अलग फलनों की तुलना कर सकता है। लेकिन इसके लिए उचित मूल्यांकन डिज़ाइन और औसत हानि-अंतर की अनिश्चितता का अनुमान जरूरी है। Diebold और Mariano (1995) समान पूर्वानुमान सटीकता का परीक्षण प्रस्तुत करते हैं; Harvey, Leybourne और Newbold (1997)00719-4) छोटे नमूने के लिए संशोधन का अध्ययन करते हैं।
आँकड़ा निकालने से पहले समान शर्तों वाले पूर्वानुमानों की तुलना करें
हर पंक्ति एक तुलनीय पूर्वानुमान आरंभ को दर्शाए। दोनों मॉडल एक ही लक्ष्य और क्षितिज का पूर्वानुमान करें और उस आरंभ पर उपलब्ध जानकारी ही इस्तेमाल करें। वास्तविक परिणाम, टाइमस्टैम्प, मुद्रा या इकाई, डेटा का संस्करण और अनुपलब्ध अवलोकनों के नियम एकसमान रखें। यदि एक मॉडल अगले दिन का समापन भाव और दूसरा पाँच दिनों का औसत बताता है, तो उनकी त्रुटियाँ अलग प्रश्नों का उत्तर हैं।
ऐसे पूर्वानुमान इस्तेमाल करें जिनमें भविष्य की जानकारी न हो। कालक्रमानुसार परीक्षण नमूना या रोलिंग छद्म-बाह्य-नमूना डिज़ाइन मदद कर सकता है, लेकिन केवल नमूना बाँटना पर्याप्त नहीं यदि उसी परीक्षण नमूने को बार-बार देखकर विशेषताएँ, सीमाएँ या मॉडल के रूपांतर समायोजित किए गए हों। हर ऐतिहासिक आरंभ पर जारी पूर्वानुमान तथा उस समय प्रयुक्त डेटा और मॉडल संस्करण सुरक्षित रखें। ऐसा न करने पर संशोधित मैक्रो आँकड़े, सर्वाइवरशिप पूर्वाग्रह हटाने वाले फ़िल्टर या बाद के कॉर्पोरेट-कार्रवाई समायोजन मूल्यांकन को पीछे से बदल सकते हैं।
दोनों मॉडलों का मूल्यांकन पूर्वानुमान आरंभों के एक ही समूह पर करें। केवल एक मॉडल के लिए कठिन तारीखें हटाने से युग्मित तुलना टूट जाती है। यदि पूर्वानुमान अनुपलब्ध हैं, तो साझा नमूना तय करें या अनुपलब्ध पूर्वानुमानों के लिए उचित तरीका बताएं; चुपचाप दोनों मॉडलों को अलग-अलग बाजार अवधियों का सामना न करने दें। शुरू और समाप्ति तिथियाँ उस नमूने को खोजने से पहले तय करें जो वांछित परिणाम दे।
हानि फलन तय करता है कि «अधिक सटीक» का अर्थ क्या है
आरंभ t पर वास्तविक मान yₜ हो और मॉडल A व B के पूर्वानुमान क्रमशः ŷA,ₜ और ŷB,ₜ हों। त्रुटियाँ eA,ₜ = yₜ − ŷA,ₜ और eB,ₜ = yₜ − ŷB,ₜ हैं। हानि फलन L हर त्रुटि को ऐसे स्कोर में बदलता है जिसमें कम बेहतर है। वर्ग हानि L(e) = e² बड़ी चूकों को अधिक दंडित करती है। निरपेक्ष हानि L(e) = |e| चूक के आकार के साथ रैखिक रूप से बढ़ती है। क्वांटाइल पूर्वानुमान के लिए असममित पिनबॉल हानि उपयुक्त हो सकती है, क्योंकि अधिक और कम अनुमान की लागत अलग हो सकती है।
चुना गया स्कोर यह बदल सकता है कि कौन-सा मॉडल बेहतर दिखे। एक ही इकाई में त्रुटि के दो काल्पनिक जोड़े लें: A की त्रुटियाँ 0 और 2 हैं; B की 1 और 1। औसत वर्ग हानि A के लिए 2 और B के लिए 1 है, इसलिए B का स्कोर बेहतर है। निरपेक्ष हानि में दोनों का औसत 1 है। कोई भी गणना हर संदर्भ में सही नहीं; प्रत्येक उन त्रुटियों के बारे में अलग प्रश्न पूछती है जो मायने रखती हैं।
रिटर्न के सशर्त माध्य के पूर्वानुमान में वर्ग त्रुटि उपयोगी हो सकती है, जबकि अस्थिरता पूर्वानुमान को लक्ष्य के अनुरूप स्कोर चाहिए और Value-at-Risk (VaR) पूर्वानुमान को क्वांटाइल हानि या जोखिम-विशिष्ट बैकटेस्ट की जरूरत हो सकती है। विजेता देखने के बाद हानि फलन चुनना परीक्षण को एक और खोज बना देता है। तुलना देखने से पहले स्कोर और «बेहतर» की दिशा तय करें।
VaR पूर्वानुमान सामान्य बिंदु-पूर्वानुमान के बजाय वितरण के पूँछ वाले क्वांटाइल को लक्ष्य करता है। VaR बैकटेस्टिंग मार्गदर्शिका बताती है कि अपवादों की आवृत्ति और समय के परीक्षण इस अलग जोखिम-पूर्वानुमान का मूल्यांकन कैसे करते हैं।
युग्मित हानि-अंतर बनाएं और शून्य परिकल्पना स्पष्ट करें
यदि कम हानि बेहतर है, तो अवधि t का अंतर इस प्रकार परिभाषित करें:
dₜ = L(eA,ₜ) − L(eB,ₜ)
इस चिह्न-परंपरा में धनात्मक dₜ का अर्थ है कि उस आरंभ पर B की हानि कम थी; ऋणात्मक मान A के पक्ष में है। नमूना माध्य d̄ = (1/n) Σ dₜ है। बिना शर्त समान सटीकता की शून्य परिकल्पना E[dₜ] = 0 है। दो-तरफ़ा विकल्प पूछता है कि अपेक्षित हानियाँ किसी भी दिशा में अलग हैं या नहीं। पहले से तय एक-तरफ़ा विकल्प यह जाँच सकता है कि नामित मॉडल की अपेक्षित हानि कम है या नहीं।
मूल परीक्षण आँकड़ा है:
DM = d̄ / √(Ŝd / n)
यहाँ Ŝd हानि-अंतर श्रृंखला के दीर्घकालिक प्रसरण का अनुमान है, न कि हर मॉडल की पूर्वानुमान त्रुटियों के प्रसरण का। शून्य परिकल्पना और उचित नियमितता शर्तों के अंतर्गत आँकड़ा आसन्न रूप से मानक सामान्य वितरण का होता है। ऊपर के चिह्न-नियम में बड़े धनात्मक मान B के पक्ष में और बड़े ऋणात्मक मान A के पक्ष में हैं। p-value बताता है कि डेटा निर्दिष्ट शून्य परिकल्पना और नमूना मान्यताओं से कितना मेल खाता है; यह किसी मॉडल के सही होने की संभावना नहीं है।
युग्मन दोनों मॉडलों के समग्र त्रुटि-स्तर के अप्रासंगिक अंतर को केवल उतना हटाता है जितना हर आरंभ पर उनके अंतर में दर्ज है। इससे हानि श्रृंखला स्वतंत्र नहीं हो जाती, पैरामीटर-अनुमान की अनिश्चितता अपने आप समाप्त नहीं होती और अनेक लक्ष्यों या विनिर्देशों में खोज का सुधार भी नहीं होता। इन विकल्पों को डिज़ाइन और अनिश्चितता गणना में संभालना चाहिए।
एक-चरण उदाहरण नमूना-अंतर और साक्ष्य के बीच फर्क बताता है
मान लें कि एक कदम आगे के 100 काल्पनिक पूर्वानुमान युग्मित हैं। मॉडल A की औसत वर्ग हानि 0.26 और मॉडल B की 0.23 है, वर्ग प्रतिशत-अंक इकाइयों में। इसलिए औसत अंतर d̄ = 0.26 − 0.23 = 0.03 है, जो नमूने में B के पक्ष में है। उदाहरण को सरल रखने के लिए मान लें कि dₜ का अनुमानित दीर्घकालिक प्रसरण 0.04 है और पूर्वानुमान आरंभों के बीच कोई क्रमिक सहप्रसरण नहीं है।
औसत अंतर की मानक त्रुटि √(0.04 / 100) = 0.02 है। बिना सुधार वाला आँकड़ा 0.03 / 0.02 = 1.50 है। क्षितिज h = 1 और T = 100 के लिए Harvey–Leybourne–Newbold का छोटे-नमूने वाला गुणक √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995 है। इसे गुणा करने पर समायोजित आँकड़ा लगभग 1.49 आता है; अनुमानित t₉₉ संदर्भ वितरण के अनुसार दो-तरफ़ा p-value लगभग 0.14 है।
B की देखी गई औसत वर्ग त्रुटि कम है, लेकिन यह उदाहरण सामान्य महत्व-स्तरों पर समान अपेक्षित सटीकता के विरुद्ध मजबूत साक्ष्य नहीं देता। शून्य परिकल्पना को अस्वीकार न करना यह साबित नहीं करता कि दोनों मॉडल समान रूप से सटीक हैं; अस्वीकार करने का निष्कर्ष भी चुने गए स्कोर, आरंभों और मान्यताओं पर निर्भर होगा। हानि और प्रसरण के मान केवल गणना समझाने के काल्पनिक इनपुट हैं, अनुभवजन्य परिणाम नहीं।
इनके वर्गमूल, यानी root mean squared error (RMSE), क्रमशः लगभग 0.510 और 0.480 प्रतिशत-अंक हैं; वर्णनात्मक अंतर 0.030 अंक है। फिर भी DM आँकड़ा युग्मित वर्ग-हानि अंतरों का इस्तेमाल करता है; यह दोनों वर्गमूलों के अंतर का t-परीक्षण नहीं है।
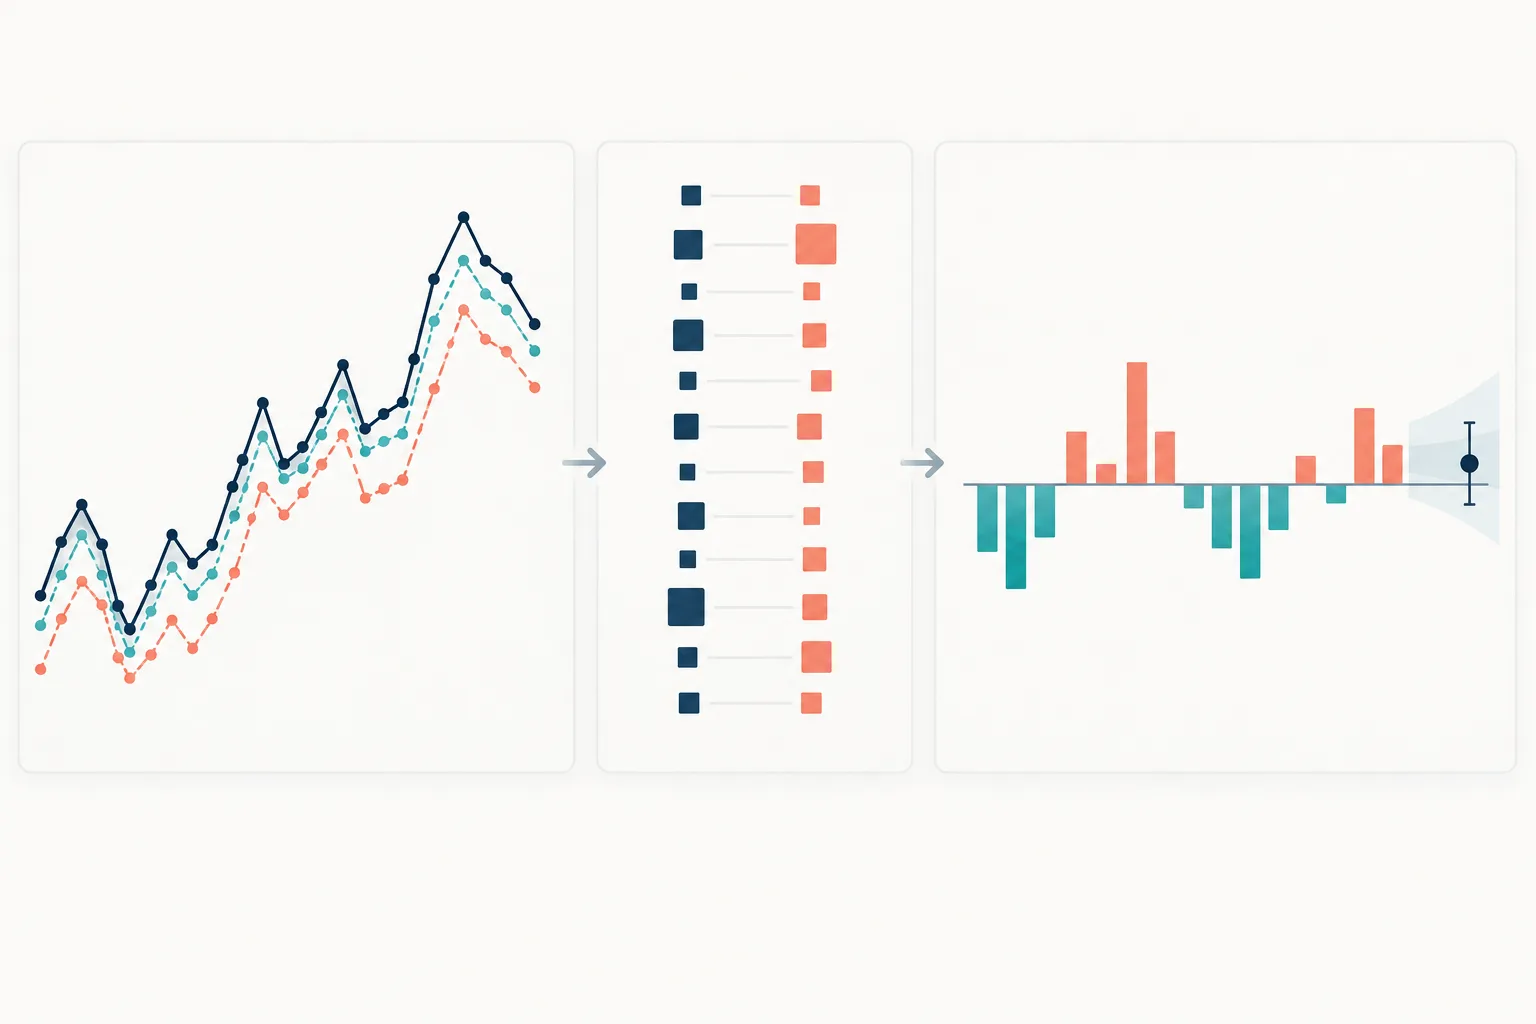
अतिव्यापी क्षितिज हानि-अंतरों को निर्भर बनाते हैं
यदि हर दिन पाँच दिन आगे का पूर्वानुमान जारी होता है, तो पास-पास के पूर्वानुमान अपने पाँच लक्षित दिनों में से चार साझा करते हैं। इसलिए उनकी त्रुटियाँ, हानियाँ और हानि-अंतर साथ बदल सकते हैं। 100 दैनिक पूर्वानुमान आरंभों को 100 स्वतंत्र तुलनाएँ मानने से अनिश्चितता कम आँकी जा सकती है और आँकड़ा वास्तविकता से बड़ा दिख सकता है।
दीर्घकालिक प्रसरण dₜ में क्रमिक सहप्रसरण को शामिल करता है। विषम प्रसरण और स्वतःसहसंबंध के प्रति सुसंगत (HAC) एक आम अनुमान का रूप है:
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
यहाँ γ̂ₖ, k अंतराल पर नमूना स्वतःसहप्रसरण है; wₖ कर्नेल भार और m चुना गया बैंडविड्थ है। Newey और West (1987) धनात्मक अर्ध-निश्चित HAC सहप्रसरण अनुमान देते हैं। प्रासंगिक मान्यताओं के तहत आदर्श h-कदम पूर्वानुमान त्रुटियों में अतिव्यापन से अक्सर कम-से-कम h − 1 अंतराल तक निर्भरता बनती है; इस स्थिति के लिए मूल DM रूपरेखा truncated अनुमान पर चर्चा करती है। वास्तविक डेटा में स्थायी लक्ष्य, रोलिंग अनुमान या रणनीति निर्माण से निर्भरता अधिक लंबे समय तक रह सकती है, इसलिए h − 1 बैंडविड्थ चुनने का सार्वभौमिक नियम नहीं है।
क्षितिज, कर्नेल, बैंडविड्थ और छोटे-नमूने के किसी भी सुधार की जानकारी दें। मनचाहा p-value पाने के लिए बैंडविड्थ चुनने के बजाय दिखाएँ कि उचित निर्भरता विकल्पों के तहत निष्कर्ष बदलते हैं या नहीं। यदि अतिव्यापन से बचने के लिए आरंभों के बीच पर्याप्त अंतर रखा गया है, तो यह बताएं और समझाएं कि इस चुनाव में कितना डेटा या नमूना आकार कम हुआ। निर्भरता को ध्यान में रखकर अनिश्चितता निकालना परीक्षण का हिस्सा है, वैकल्पिक प्रदर्शन सेटिंग नहीं।
नेस्टेड मॉडल और समय के साथ बदलते पूर्वानुमान कौशल के लिए अलग प्रश्न चाहिए
समान-सटीकता की शून्य परिकल्पना के तहत यदि पूर्वानुमान नेस्टेड नहीं हैं, तो सामान्य DM तुलना समझना सरल होता है। यदि बड़े मॉडल में छोटा बेंचमार्क शामिल है, तो अतिरिक्त अनुमानित गुणांक पूर्वानुमान में शोर जोड़ सकते हैं, भले ही उनके वास्तविक मान शून्य हों। उस शून्य के तहत औसत वर्ग पूर्वानुमान त्रुटियों के साधारण अंतर का वितरण गैर-मानक हो सकता है। नेस्टेड मॉडलों के out-of-sample MSPE की तुलना में Clark–West जैसा समायोजन अनुमान-शोर के इस प्रभाव को ध्यान में रखता है; यह हर मॉडल डिज़ाइन में DM का सामान्य विकल्प नहीं है। Clark और West (2007) देखें।
सामान्य DM शून्य परिकल्पना पूरे मूल्यांकन नमूने में औसत, बिना शर्त हानि के बारे में है। यह समय के साथ बदलाव छिपा सकती है: शांत अवधियों में A और अस्थिर अवधियों में B बेहतर हो सकता है, जबकि उनके समग्र औसत समान हों। यदि प्रश्न यह है कि सापेक्ष सटीकता पूर्वानुमान तारीख पर उपलब्ध जानकारी पर निर्भर करती है या नहीं, तो सशर्त पूर्वानुमान क्षमता परीक्षण पहले से तय साधनों के साथ हानि-अंतर का उपयोग करते हैं। Giacomini और White (2006) ऐसी रूपरेखा विकसित करते हैं। मान्यताएँ और मूल्यांकन विंडो का डिज़ाइन महत्वपूर्ण हैं; नतीजे देखने के बाद मनमाने संकेतक जोड़ना वैध शॉर्टकट नहीं है।
परीक्षण का चयन तुलना की संरचना के अनुसार होना चाहिए: स्वतंत्र पूर्वानुमान, नेस्टेड मॉडल, बदलती सशर्त क्षमता या कई उम्मीदवारों में से चुना गया समूह—ये एक-दूसरे के स्थानापन्न मामले नहीं हैं। आखिरी स्थिति के लिए, White Reality Check और Hansen SPA मार्गदर्शिका कई ट्रेडिंग नियमों की खोज के बाद समूह-स्तरीय सुधार समझाती है।
कम पूर्वानुमान-हानि लाभदायक रणनीति साबित नहीं करती
कोई पूर्वानुमान सांख्यिकीय रूप से अधिक सटीक होकर भी शुद्ध ट्रेडिंग परिणाम बेहतर न करे, यह संभव है। रणनीति को पूर्वानुमान से पोज़िशन तय करनी होती है, ट्रेड का समय चुनना होता है और स्प्रेड, कमीशन, स्लिपेज, बाजार प्रभाव, फंडिंग, उधार लागत तथा जोखिम-सीमाएँ सहनी होती हैं। रिटर्न की औसत वर्ग त्रुटि में छोटा सुधार किसी निर्णय के लिए उपयोगी न हो; दूसरी ओर थोड़ी अधिक औसत त्रुटि वाला मॉडल किसी नियम के लिए महत्वपूर्ण tail event बेहतर पहचान सकता है।
पूर्वानुमान मूल्यांकन और पोर्टफोलियो मूल्यांकन को अलग चरण मानें। पहले पूर्वानुमान को ऐसे लक्ष्य और हानि के विरुद्ध जाँचें जो बताई गई भविष्यवाणी-समस्या से मेल खाते हों। फिर पूर्वानुमान चुनने में इस्तेमाल न हुए डेटा पर पूरी तरह निर्दिष्ट ट्रेडिंग नियम का मूल्यांकन करें और निष्पादन व वित्तपोषण की यथार्थवादी मान्यताएँ शामिल करें। पूर्वानुमान परीक्षण का p-value न बैकटेस्ट रिटर्न है, न Sharpe ratio, न भविष्य में लाभ की संभावना।
मॉडल, लक्ष्य, क्षितिज, हानि फलन और नमूना-विंडो बार-बार आज़माने से चयन पूर्वाग्रह पैदा होता है, भले हर अलग DM गणना सही हो। पूरी खोज दर्ज करें और यदि शोध प्रश्न यह है कि क्या कोई उम्मीदवार इस खोज में बचा, तो परिवार-स्तर की विधि अपनाएँ। ब्लॉक-बूटस्ट्रैप मार्गदर्शिका पहले से चुने गए आँकड़े के लिए निर्भरता-संरक्षित अनिश्चितता बताती है; वह अकेले किसी अलिखित मॉडल-खोज का सुधार नहीं करती।
इतनी जानकारी दें कि दूसरा शोधकर्ता विश्लेषण दोहरा सके
दोनों पूर्वानुमान मॉडलों के नाम, बेंचमार्क से उनका संबंध, लक्ष्य, क्षितिज, पूर्वानुमान आरंभों का समय-सारणी, मूल्यांकन तारीखें, सूचना-समूह, डेटा संस्करण और साझा नमूने का नियम बताएं। हानि फलन को गणितीय रूप से परिभाषित करें और स्पष्ट करें कि धनात्मक dₜ A या B में से किसे समर्थन देता है। n, दोनों मॉडलों की औसत हानि, d̄, दीर्घकालिक प्रसरण अनुमान, HAC कर्नेल और बैंडविड्थ, छोटे-नमूने का सुधार, संदर्भ वितरण, परीक्षण की दिशा और p-value रिपोर्ट करें।
यह भी बताएं कि मॉडल नेस्टेड हैं या नहीं, पैरामीटर कैसे अनुमानित किए गए, तुलना परिणाम देखने से पहले चुनी गई या बाद में, और कौन से अन्य रूपांतर आज़माए गए। यदि नमूने का उपयोग मॉडल चुनने में हुआ, तो परीक्षण को अछूता out-of-sample साक्ष्य कहने के बजाय उसी खोज-प्रक्रिया का हिस्सा बताएं। स्पष्ट रिपोर्ट से पाठक देख सकते हैं कि परीक्षण वास्तव में किसकी तुलना करता है और अनिश्चितता या चयन की कौन-सी समस्याएँ उससे बाहर रहती हैं।
आम सवाल
Q1क्या Diebold–Mariano परीक्षण सामान्य-वितरित पूर्वानुमान त्रुटियाँ मानता है?
नहीं। यह ढाँचा गैर-सामान्य पूर्वानुमान त्रुटियों को संभाल सकता है। फिर भी हानि-अंतर के प्रसरण का उचित अनुमान और संदर्भ वितरण के लिए नियमितता शर्तें जरूरी हैं।
Q2क्या अलग-अलग क्षितिज का पूर्वानुमान करने वाले दो मॉडलों की तुलना कर सकता हूँ?
समान आधार पर पूर्वानुमान सटीकता की तुलना के रूप में नहीं। पहले लक्ष्य और क्षितिज मिलाएं; अन्यथा हर मॉडल अलग पूर्वानुमान प्रश्न का उत्तर देता है।
Q3क्या महत्वपूर्ण DM परिणाम ट्रेडिंग मॉडल चुनने के लिए पर्याप्त है?
नहीं। यह एक निर्दिष्ट तुलना में अपेक्षित पूर्वानुमान-हानि के बारे में साक्ष्य है। मॉडल-खोज, निर्णय नियम, निष्पादन लागत, वित्तपोषण और out-of-sample रणनीति प्रदर्शन को भी देखना होगा। मूल शोध - Diebold और Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne और Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini और White, “Tests of Conditional Predictive Ability” (2006) - Clark और West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey और West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
dₜ = L(eA,ₜ) − L(eB,ₜ) हो, तो धनात्मक नमूना माध्य किसके पक्ष में है?
व्याख्या देखने के लिए एक उत्तर चुनें