

Реализованная волатильность методом предварительного усреднения
Разберитесь, как pre-averaging сглаживает короткие высокочастотные окна доходности, корректирует основной шумовой сдвиг, помогает выбрать длину окна и отличается от TSRV и realized kernel.
В этом руководствеПочему слишком частые доходности искажают вариацию цены
Краткое резюме
Предварительное усреднение (pre-averaging) помогает оценить изменение цены, когда очень часто записываемые котировки содержат микроструктурный шум. Вместо возведения каждого необработанного дохода в квадрат метод складывает соседние доходности с весами в перекрывающихся окнах, затем вычитает поправку на основной вклад шума. Результат зависит от формы весов, длины окна, схемы выборки и допущений о шуме. Это оценка вариации за наблюдавшийся интервал, а не прогноз волатильности или торговый сигнал.
Почему слишком частые доходности искажают вариацию цены
Если бы наблюдаемая цена совпадала с эффективной ценой, сумма квадратов внутридневных доходностей была бы естественной оценкой изменения за сессию. Но сделки и котировки отражают чередование bid и ask, округление к шагу цены, задержки, дискретность цены и особенности записи данных. При очень коротком шаге эти эффекты могут составлять большую часть каждого квадрата доходности. Поэтому добавление наблюдений способно увеличить вклад шума, а не просто показать больше движения базовой цены.
Pre-averaging объединяет доходности в коротком локальном окне до возведения в квадрат. Гладкая функция веса начинается с нуля, придает вес соседним доходностям и снова обращается в ноль на границе окна. Полученная сумма действует как локальный фильтр: быстрые независимые ошибки наблюдения частично взаимно компенсируются, а более широкое движение эффективной цены может сохраниться. Перекрывающиеся окна используют информацию на всем интервале.
Одного сглаживания недостаточно для несмещенной оценки: фильтрованный шум по-прежнему вносит вариацию, поэтому нужна поправка. Jacod, Li, Mykland, Podolskij и Vetter вывели метод pre-averaging для интегрированной волатильности при явных предпосылках и показали, что подходящие версии достигают скорости сходимости \(n^{-1/4}\). Исходная статья задает основу метода; здесь разбираются формулы, выбор параметров и ограничения.
Разделите скрытую цену, записанную цену и целевую величину
Пусть \(X_{t_i}\) — скрытый эффективный логарифм цены в момент наблюдения \(t_i\), а \(Y_{t_i}\) — записанный логарифм цены:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
где \(\epsilon_{t_i}\) — ошибка наблюдения. В базовой модели \(X_t\) часто считают непрерывным полумартингалом с локальной дисперсией \(\sigma_t^2\). Целевая величина на фиксированном интервале \([0,T]\) — интегрированная дисперсия:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Наблюдаемая доходность раскладывается как \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Даже если ошибки цены независимы между моментами наблюдения, ошибки соседних доходностей имеют общий конечный член с противоположными знаками. Это создает серийную зависимость доходностей и делает реализованную дисперсию по всем наблюдениям чувствительной к числу шумных приращений.
Простая теоретическая модель обычно предполагает центрированный шум, независимый во времени и от эффективной цены, с конечными моментами нужного порядка. Эти допущения объясняют оценку, но не гарантированы для сделок, котировок и средних цен. Шум может меняться вместе с ликвидностью и временем суток, зависеть от эффективной цены или иметь серийную зависимость. Важна и цель измерения: при скачках квадратичная вариация включает квадраты скачков, а непрерывная интегрированная дисперсия — нет.
Это ретроспективная оценка для заданного ряда цен и временного окна. Она не восстанавливает каждую скрытую цену, не определяет ошибочную сделку и не сообщает будущую волатильность. Перед сравнением укажите, использованы ли цены сделок, середины котировок или другая конструкция.
Постройте перекрывающиеся предварительно усредненные доходности
Для \(n\) наблюдаемых доходностей \(r_i=Y_{t_i}-Y_{t_{i-1}}\) задайте целую длину окна \(k_n\) и функцию веса \(g\) на \([0,1]\). Стандартная предварительно усредненная доходность имеет вид
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Обычно функция непрерывна, равна нулю на обоих концах и достаточно гладкая для асимптотических результатов. Пример треугольного веса: \(g(u)=\min(u,1-u)\). Нулевые веса на границах не позволяют резко присвоить максимальный вес доходности на краю окна. Это локальная схема весов, а не прогноз или оцененный тренд.
Каждая \(\bar r_i\) объединяет соседние доходности до их возведения в квадрат. Из-за перекрытия окон предварительно усредненные доходности коррелируют даже при некоррелированных исходных доходностях. Эту зависимость нужно учитывать в выборочном поведении оценки: суммы по окнам нельзя считать независимыми наблюдениями. Диапазон индексов и правило обработки концов должны соответствовать нормировке весов.
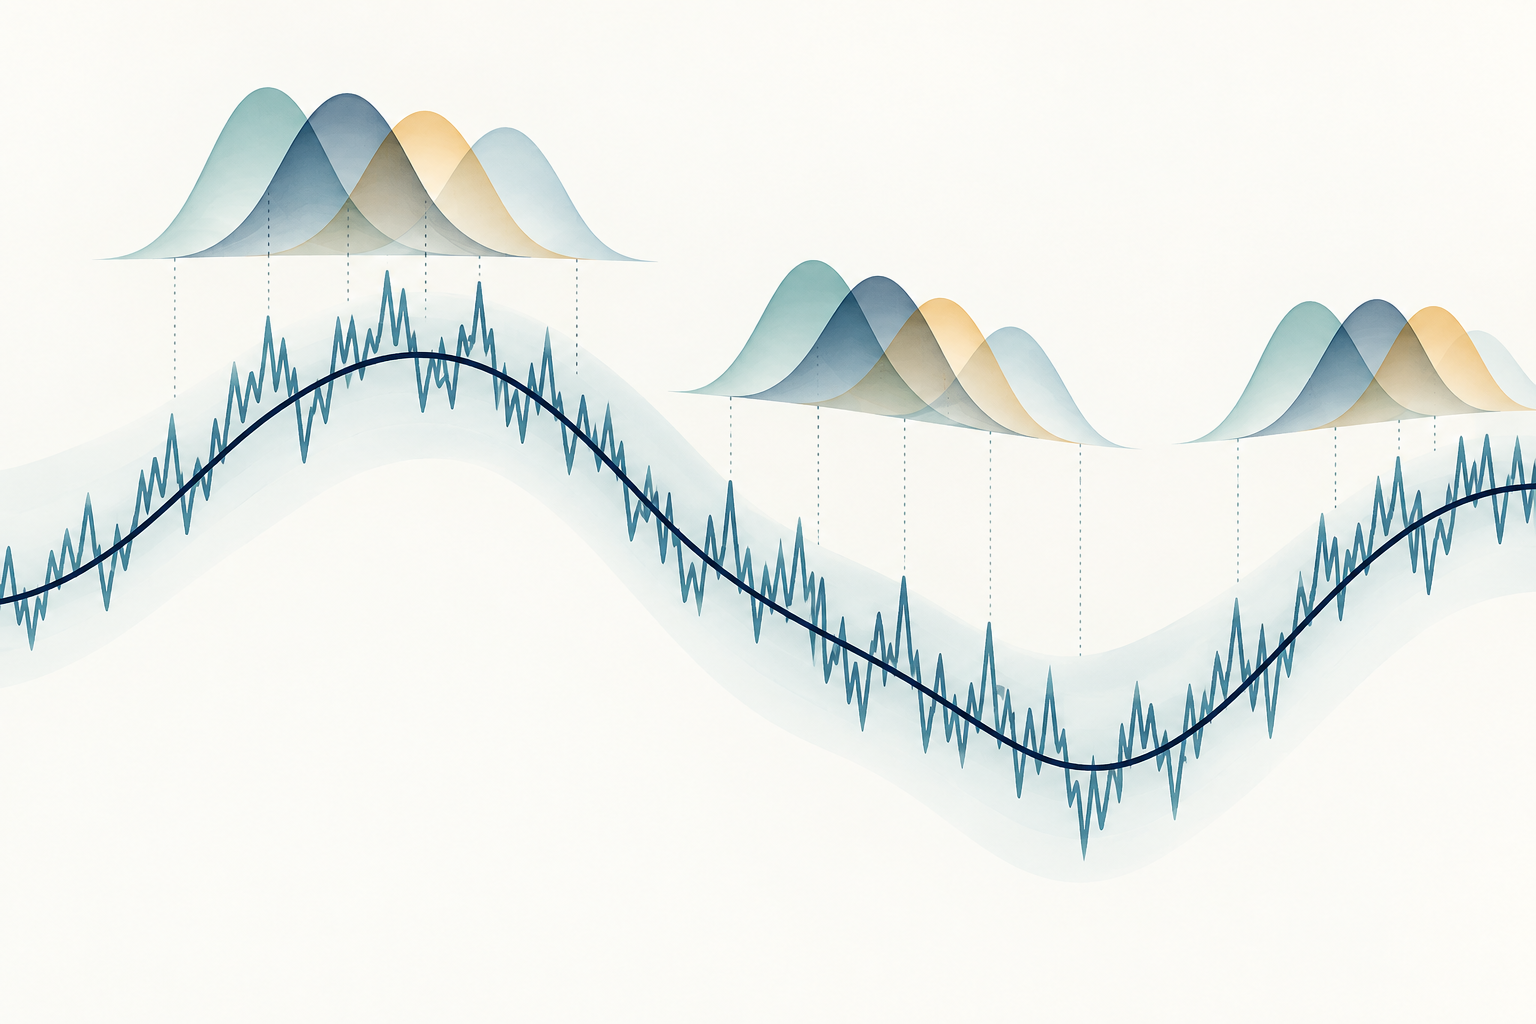
Иллюстрация показывает гладкую скрытую траекторию, зубчатый наблюдаемый путь и несколько перекрывающихся окон с затухающими весами. Это схема локального объединения, а не рыночные данные и не результат эмпирической фильтрации.
<!-- learn:illustration --> <!-- Иллюстрация без текста: гладкая скрытая траектория цены рядом с зубчатой наблюдаемой траекторией; перекрывающиеся локальные окна с плавно затухающими весами объединяют соседние движения. Схема, а не рыночные данные, прогноз или торговый сигнал. -->
Скорректируйте оставшийся вклад шума
Предварительное усреднение ослабляет быстрые ошибки наблюдения, но квадраты фильтрованных доходностей все еще содержат шумовой вклад. Для регулярной сетки распространенная форма одномерной оценки с асимптотическими нормировочными константами такова:
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
где константы весов равны
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
Первый член перенормирует сумму квадратов предварительно усредненных доходностей, приближая ее к интегрированной дисперсии. Второй при заданной модели оценивает и вычитает основной вклад шума наблюдения. Он не оценивает каждую ошибку по отдельности и не исправляет неверное поле цены, плохую метку времени или выброс. В точной формуле для конечной выборки могут использоваться дискретные версии \(\psi_1\) и \(\psi_2\), поправки на края окна и особое правило индексации доходностей. Эти детали следует указывать и применять последовательно.
В конечной выборке оценка после поправки может оказаться малой или отрицательной. Это не означает отрицательную физическую дисперсию актива: в данной выборке вычитаемая поправка превысила первый член. Не заменяйте отрицательное значение нулем молча. Покажите исходный расчет и отдельно укажите правило усечения, если оно применяется: усечение меняет оценку и может повлиять на последующие средние и выводы.
Выберите длину окна с учетом шума и размера выборки
Окно \(k_n\) задает силу сглаживания. Слишком короткое окно оставляет больше высокочастотного шума; слишком длинное усредняет локальное движение цены на большем интервале и оставляет меньше окон, что может усилить другие ошибки оценки. Вес и длина окна работают вместе: значение \(k_n\) нельзя интерпретировать без функции веса и шага выборки.
В классической сбалансированной схеме при фиксированном промежутке времени и все более частых \(n\) наблюдениях окно растет как \(\sqrt n\), обычно \(k_n\sim\theta\sqrt n\), где \(\theta>0\) — параметр настройки. При предпосылках статьи оценка сходится со скоростью \(n^{1/4}\), то есть ошибка имеет порядок \(n^{-1/4}\). Это медленнее безшумной скорости \(n^{1/2}\) и является оптимальной скоростью в изученной базовой шумовой модели, но не обещанием для любого рыночного набора данных.
Параметр \(\theta\), форма весов и автоматический выбор по данным влияют на смещение и дисперсию в конечной выборке. Такой выбор может опираться на оценки шума и волатильности, которые сами неточны. Покажите чувствительность к нескольким обоснованным окнам, поясните временную сетку и границы сессии и не выбирайте окно постфактум в пользу желаемого вывода.
Небольшой гипотетический расчет
Возьмем шесть гипотетических наблюдаемых доходностей в базисных пунктах:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Используем треугольный вес \(g(u)=\min(u,1-u)\) и намеренно короткое окно \(k=3\). Два ненулевых внутренних веса равны \(g(1/3)=g(2/3)=1/3\). Для арифметической иллюстрации на конечной сетке зададим
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Согласно выбранной индексации есть \(n-k+2=5\) перекрывающихся окон. Каждое объединяет соседние доходности \(1\) и \(0\) bp, поэтому \(\bar r_i=(1/3)(1+0)=1/3\) bp и
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
С соответствующей нормировкой конечной сетки получаем
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Пример проверяет арифметику и единицы измерения; шести доходностей и окна длиной всего три шага недостаточно для асимптотического приближения. Значения выбраны для наглядности и не являются рыночными данными, симуляцией шумового процесса или доказательством восстановления скрытой интегрированной дисперсии. Стандартная ошибка и прогноз не рассчитываются.
Учитывайте предпосылки, на которых основана поправка
Стандартный вывод рассчитан на непрерывный процесс эффективной цены, часто наблюдаемый при аддитивном шуме и условиях регулярности. Независимый центрированный шум — полезный пример, но зависимость шума от цены, серийная корреляция ошибок, меняющийся во времени шум, нерегулярные моменты наблюдения или эндогенная выборка могут потребовать другой оценки или отдельной теории. Aït-Sahalia, Mykland и Zhang исследуют интегрированную волатильность при зависимом микроструктурном шуме; их статья показывает, почему формула для iid-шума не универсальна.
Скачки создают отдельный вопрос о цели измерения. Квадратичная вариация включает квадраты скачков, а непрерывная интегрированная дисперсия — нет. Стандартная оценка pre-averaging не отделяет скачки автоматически; устойчивое к скачкам усечение или другая конструкция требуют собственных предпосылок и настроек. Один необычный принт может повлиять сразу на несколько перекрывающихся окон, поэтому проверка данных и обработка выбросов остаются важны.
Pre-averaging также не решает автоматически все задачи многомерных или асинхронных данных. Christensen, Kinnebrock и Podolskij разработали оценки ковариации с предварительным усреднением и устойчивое к шуму расширение Hayashi–Yoshida для несинхронных наблюдений в своей работе. Эти методы учитывают дополнительные особенности дизайна. Независимое применение одномерной формулы к каждому активу не синхронизирует метки времени и не гарантирует корректную матрицу ковариации.
Чем pre-averaging отличается от TSRV и realized kernel
Эти оценки решают близкие задачи высокочастотного измерения вариации, но по-разному используют данные. Two-scale realized volatility (TSRV) усредняет оценки на сдвинутых разреженных сетках и вычитает масштабированную оценку по плотной сетке, чтобы устранить основной шумовой сдвиг. Pre-averaging сначала фильтрует короткие перекрывающиеся окна доходностей гладкими весами, затем возводит их в квадрат и применяет соответствующую поправку. Исходная статья о двух масштабах описывает отдельную конструкцию.
Realized kernel начинает с суммы квадратов доходностей и добавляет взвешенные автоковариации на разных лагах; ширина полосы задает диапазон лагов. Pre-averaging, напротив, меняет локальные доходности до возведения в квадрат. В обоих методах есть веса и параметры настройки, но формулы, нормировки и предпосылки не взаимозаменяемы. Руководство по realized kernel объясняет конструкцию по лагам и выбор полосы.
Метод следует выбирать по данным и нужной величине, а не по названию. Сравните схему выборки, модель шума, обработку краев, целевую величину при скачках и поведение на конечной выборке. Асимптотическая устойчивость не гарантирует, что метод лучше для редко торгуемого актива, короткой сессии, меняющегося шума или нерегулярного потока данных. Руководство TSRV рассматривает его выбор масштабов и поправку.
Отчитайтесь об оценке интервала, а не о торговом выводе
Чтобы результат можно было воспроизвести, укажите актив и поле цены, временной интервал, частоту выборки, правила меток времени и сессии, единицы доходности, функцию веса, длину окна, нормировку, обработку краев и допущения о шуме. Для статистического вывода также укажите оценку дисперсии или метод доверительного интервала и необходимые предпосылки. Таблица чувствительности для нескольких разумных окон покажет, зависит ли результат от одного параметра.
Интегрированная дисперсия измеряет уже завершенный интервал наблюдения. Квадратный корень выражает масштаб волатильности за тот же интервал; годовое пересчитывание добавляет соглашение о времени, но не превращает оценку в прогноз. Для прогноза будущего горизонта нужна отдельная модель и проверка вне выборки. Руководство по расчету реализованной волатильности объясняет базовую сумму квадратов доходностей, а руководство по квадратичной вариации отличает вариацию траектории от непрерывной интегрированной дисперсии.
Оценка не устанавливает причину движения цены, не доказывает прибыльность стратегии и не гарантирует точного измерения риска исполнения. Комиссии, ликвидность, скачки, динамика волатильности и неопределенность оценки остаются отдельными вопросами. Pre-averaging — статистический инструмент измерения; его полезность зависит от соответствия предпосылок наблюдаемым данным.
Частые вопросы
Q1Является ли pre-averaging скользящим средним цены?
Нет. Метод складывает соседние доходности с весами, затем возводит результат в квадрат и корректирует его. Усреднение уровней цены с последующим вычислением разностей — другое преобразование с иными весами и поведением на границах.
Q2Устраняет ли pre-averaging весь микроструктурный шум?
Нет. Он уменьшает основной эффект при определенных предпосылках о шуме и выборке. Зависимый или меняющийся шум, скачки, выбросы и ошибки меток времени по-прежнему могут влиять на результат.
Q3Почему оценки pre-averaging могут различаться?
Могут отличаться функция веса, длина окна, нормировка конечной выборки, поле цены, правила обработки краев или очистка данных. Эти решения нужно указывать и проверять на чувствительность.
Q4Является ли оценка pre-averaging прогнозом волатильности?
Нет. Сама по себе она измеряет вариацию за интервал, использованный в расчете. Для прогноза нужна отдельная модель и проверка вне выборки.
Источники и дополнительное чтение
Сообщить о проблеме
Мы подготовим письмо со ссылкой на эту статью. Mark получит сообщение только после отправки
Быстрая проверка
Прочитали руководство? Проверьте себя в 3 вопросах
Вопрос 01
Для чего в первую очередь формируют предварительно усредненные доходности?
Выберите ответ, чтобы увидеть объяснение
Словарь опционов
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Читать подробное руководствоQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Читать подробное руководство