

রিগ্রেশনে একাধিক কাঠামোগত বিচ্ছেদের Bai–Perron পরীক্ষা
Bai–Perron পদ্ধতি কীভাবে রিগ্রেশনের অজানা বিচ্ছেদের সংখ্যা ও তারিখ খোঁজে, trimming ও critical value কীভাবে কাজ করে এবং এসব অনুমান কী প্রমাণ করে না—তা জানুন।
এই গাইডেএকাধিক বিচ্ছেদের রিগ্রেশন পরীক্ষা কী জানতে চায়
সংক্ষিপ্ত সারাংশ
Bai–Perron পদ্ধতিতে নির্দিষ্ট সংখ্যক বিচ্ছেদের জন্য রিগ্রেশনের বিচ্ছেদ-তারিখগুলো একসঙ্গে অনুমান করা হয়। এরপর পরীক্ষা বা মডেল-নির্বাচন মানদণ্ড দিয়ে দেখা হয় তথ্য কতগুলো বিচ্ছেদ সমর্থন করে। তারিখ ও সংখ্যা নির্ভর করে রিগ্রেশন, সর্বনিম্ন সেগমেন্ট দৈর্ঘ্য, ত্রুটি-সংক্রান্ত অনুমান এবং অনুসন্ধান-পদ্ধতির ওপর; এগুলো কোনো কারণ বা ট্রেডিং-সুবিধা শনাক্ত করে না।
একাধিক বিচ্ছেদের রিগ্রেশন পরীক্ষা কী জানতে চায়
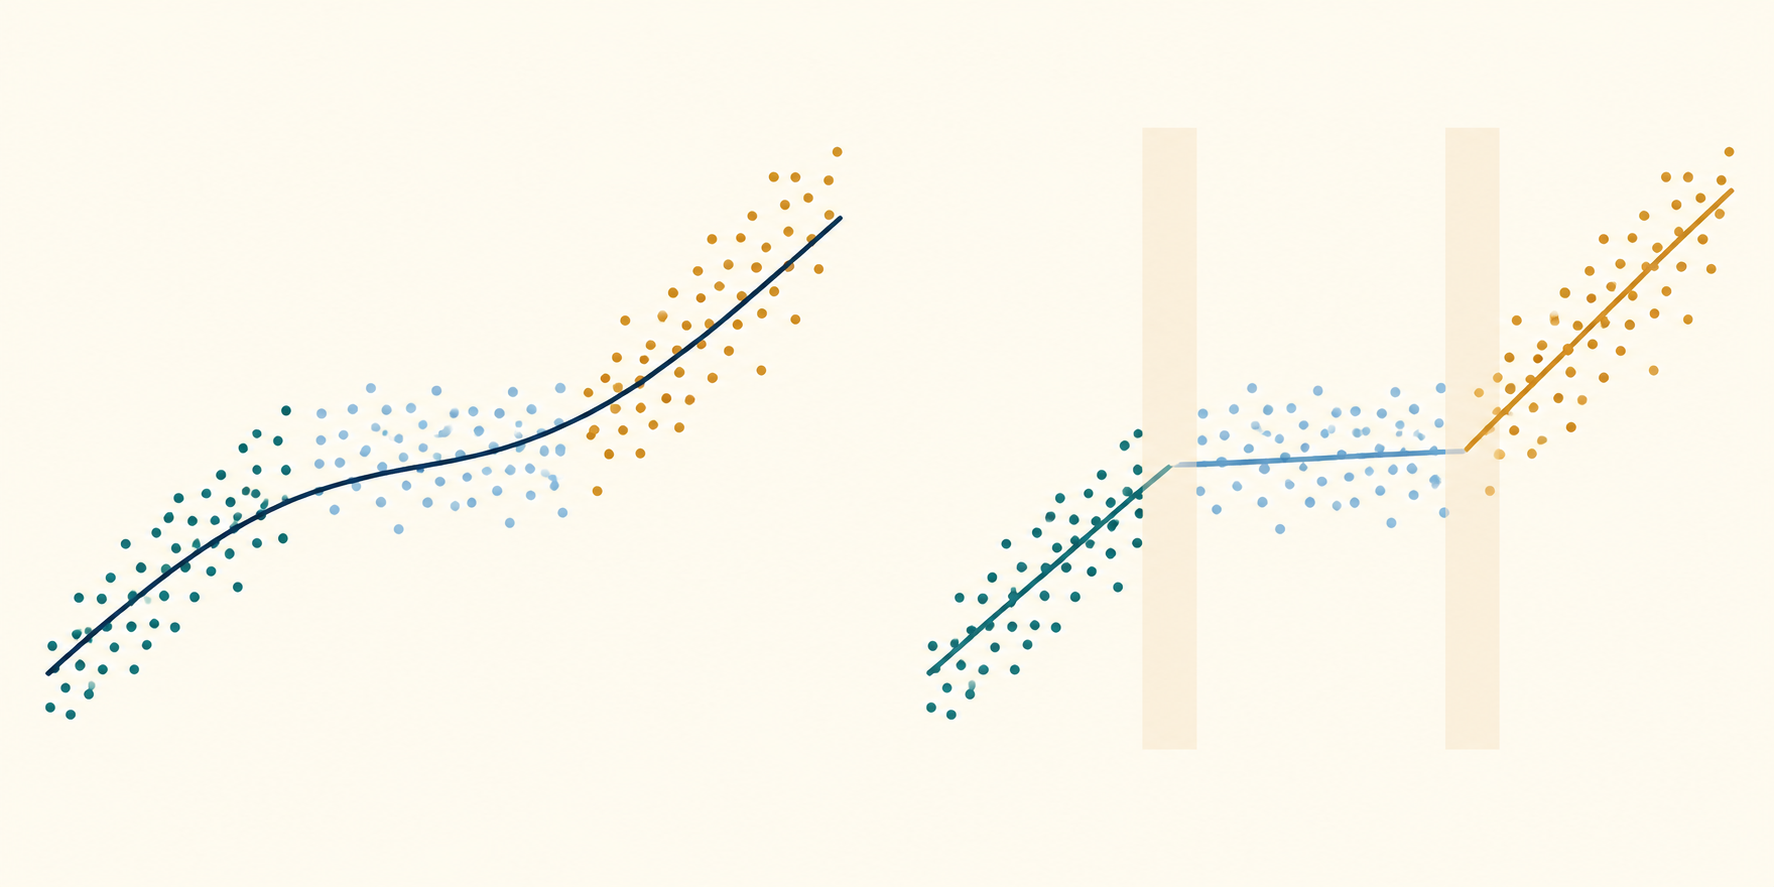
রিগ্রেশনে কাঠামোগত বিচ্ছেদ বলতে বোঝায়, নমুনার কোনো অজানা বিন্দুতে এক বা একাধিক সহগ বদলে থাকতে পারে। পুরো নমুনার জন্য একটিমাত্র অনুমান এই পরিবর্তন আড়াল করতে পারে: যেমন, কোনো সময়ে রিটার্ন ও ঝুঁকির সম্পর্ক ধনাত্মক, পরে দুর্বল বা উল্টো হলে গড় সহগটি হয়তো কোনো সময়পর্বকেই ভালোভাবে বর্ণনা করে না। Bai–Perron পদ্ধতি এই প্রশ্নকে পর্যবেক্ষণগুলোর সম্ভাব্য বিভাজনের ওপর একটি স্পষ্ট অনুসন্ধান হিসেবে দেখে।
Chow পরীক্ষার সঙ্গে মূল পার্থক্য হলো তারিখটি আগে থেকেই নির্ধারিত ছিল কি না। Chow পরীক্ষা দেওয়া একটি তারিখের দুই পাশের উপনমুনা তুলনা করে। অনেক তারিখ চেষ্টা করে সাধারণ Chow পরিসংখ্যানের মধ্যে সবচেয়ে বড়টি জানালে একটি পূর্বনির্ধারিত পরীক্ষার প্রচলিত reference distribution আর প্রযোজ্য থাকে না। Bai–Perron পরীক্ষা সম্ভাব্য তারিখগুলোর অনুসন্ধান বিবেচনা করে এবং একাধিক বিচ্ছেদ মূল্যায়ন করতে পারে। আগে থেকে নির্ধারিত তারিখের ক্ষেত্রে Chow পরীক্ষা নির্দেশিকা দেখুন।
রিগ্রেশন CUSUM-ও আলাদা বিষয়। CUSUM সময়-ক্রমে সাজানো recursive residual-এর পথ পরীক্ষা করে স্থিতিশীলতার বিরুদ্ধে প্রমাণ খোঁজে, কিন্তু নিজে থেকে একাধিক নির্বাচিত বিচ্ছেদ-তারিখ দেয় না। Bai–Perron নির্দিষ্ট piecewise regression মডেলের অধীনে বিভাজন অনুমান করে। কোনো পদ্ধতিই পরিবর্তনের কারণ ব্যাখ্যা করে না। residual-পথের নির্ণয়ের জন্য রিগ্রেশন CUSUM নির্দেশিকা দেখুন।
অজানা তারিখ ও অজানা বিচ্ছেদ-সংখ্যাসহ রিগ্রেশন লিখুন
ধরা যাক \(T\)টি পর্যবেক্ষণ এবং পূর্ণসংখ্যা তারিখ \(T_1<\cdots<T_m\)-এ \(m\)টি বিচ্ছেদ আছে। \(T_0=0\), \(T_{m+1}=T\) ধরা যাক; \(j\)-তম সেগমেন্টে পর্যবেক্ষণ \(T_{j-1}+1,\ldots,T_j\) থাকবে। বিশুদ্ধ কাঠামোগত পরিবর্তন মডেলে,
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
এখানে \(y_t\) হলো ফলাফল, \(x_t\) অন্তর্ভুক্ত explanatory variable-এর ভেক্টর, \(\beta_j\) হলো \(j\)-তম সেগমেন্টের coefficient vector এবং \(u_t\) ত্রুটি। অজানা বিষয় কেবল সহগ নয়: নকশায় আগে থেকে স্থির না থাকলে বিচ্ছেদের তারিখ ও সংখ্যা \(m\)-ও অনুমান বা নির্বাচন করতে হয়। মডেলটি আরও ধরে নেয় যে পর্যবেক্ষণগুলোর অর্থপূর্ণ ক্রম আছে এবং নির্ধারিত specification অনুযায়ী প্রতিটি সেগমেন্টে সহগ-ভেক্টর স্থিতিশীল।
আর্থিক উদাহরণে \(y_t\) হতে পারে পোর্টফোলিওর রিটার্ন, আর \(x_t\)-এ বাজার-রিটার্ন, সুদের হারের পরিবর্তন বা volatility measure থাকতে পারে। বিচ্ছেদ শনাক্ত হওয়া মানে নির্দিষ্ট পদ্ধতিতে নমুনার ভেতরে segment অনুযায়ী linear conditional mean ভালোভাবে fit হয়েছে। এর মানে কোনো নির্দিষ্ট ঘটনা সহগ বদলেছে, explanatory variable exogenous, বা নমুনার বাইরেও সম্পর্ক স্থিতিশীল—এমন নয়।
পর্যবেক্ষণের তারিখ ও ক্যালেন্ডারের তারিখ আলাদা করে ভাবুন। দৈনিক trading session ব্যবহার করলে session 120 ও 121-এর মাঝের বিচ্ছেদ একটি ক্যালেন্ডার দিনের বাজার-চলাচল বোঝায় না; ছুটি, অনুপস্থিত quote এবং অনিয়মিত sampling এই মানচিত্র বদলে দেয়। বিচ্ছেদের তারিখকে কোনো ঘটনার timestamp হিসেবে ব্যাখ্যার আগে নমুনার ক্রম ও তারিখ জানানোর নিয়ম লিখুন।
বিশুদ্ধ ও আংশিক কাঠামোগত পরিবর্তনের মধ্যে সচেতনভাবে বাছুন
বিশুদ্ধ কাঠামোগত পরিবর্তন মডেলে \(\beta_j\)-এর প্রতিটি সহগ সেগমেন্টভেদে বদলাতে পারে। এতে intercept ও সব slope পরিবর্তনের সুযোগ থাকে, কিন্তু প্রতিটি সেগমেন্টের জন্য বেশি parameter লাগে। তাই সেগমেন্ট ছোট হলে বা explanatory variable বেশি হলে পরিবর্তন নির্ভুলভাবে অনুমান করা কঠিন হতে পারে। প্রতিটি মডেলকৃত সম্পর্ক নতুন করে নির্ধারিত হতে পারে—এমন প্রশ্নের জন্যই বিশুদ্ধ পরিবর্তন উপযুক্ত।
আংশিক কাঠামোগত পরিবর্তন মডেলে কিছু সহগ সব সেগমেন্টে সাধারণ থাকে, আর কিছু বদলাতে পারে। উদাহরণস্বরূপ, \(\beta_j=(\delta',\gamma_j')'\) লিখি, যেখানে \(\delta\) সব সেগমেন্টে এক এবং \(\gamma_j\) সেগমেন্টভেদে আলাদা। এটি বিষয়গত কোনো সীমাবদ্ধতা প্রকাশ করতে পারে: intercept ও নীতিগত exposure-এর slope বদলাবে, কিন্তু control variable-এর প্রভাব সাধারণ থাকবে। এই সীমাবদ্ধতা fit objective ও পরীক্ষার reference distribution—দুটিই বদলে দেয়। একে নিরীহ সরলীকরণ না ধরে স্পষ্টভাবে জানাতে হবে।
গণনার পদ্ধতিও ভিন্ন। বিশুদ্ধ পরিবর্তনে একটি বিভাজনের residual sum of squares (RSS) হলো স্বাধীন সেগমেন্টগুলোর RSS-এর যোগফল; তাই নির্দিষ্ট বিচ্ছেদ-সংখ্যার জন্য dynamic programming বিভাজন optimize করতে পারে। আংশিক মডেলে সাধারণ সহগগুলো সব সেগমেন্টকে যুক্ত করে। Bai ও Perron-এর বর্ণিত iterative পদ্ধতিতে প্রথমে সাধারণ সহগ স্থির রেখে বিচ্ছেদের তারিখ ও পরিবর্তনশীল সহগ অনুমান করা হয়, পরে বিভাজন স্থির রেখে সাধারণ সহগ হালনাগাদ করা হয়। শুধু additive segment-RSS recurrence দিয়ে সীমাবদ্ধ পুরো মডেলটি সমাধান হয় না। কোন specification নেবেন তা বৈজ্ঞানিক বা forecasting প্রশ্নের ভিত্তিতে ঠিক করুন, যে সংস্করণে বেশি বিচ্ছেদ আসে তার ভিত্তিতে নয়।
সম্ভাব্য তারিখ দেখার আগে সর্বনিম্ন সেগমেন্ট দৈর্ঘ্য ঠিক করুন
অনুসন্ধানে প্রতিটি সেগমেন্টে ন্যূনতমসংখ্যক পর্যবেক্ষণ দরকার। trimming rule খুব ছোট ব্যবধানে অস্থিতিশীল সহগ fit হওয়া ঠেকায়; তবে নমুনার প্রান্তে বা অন্য বিচ্ছেদের খুব কাছে ঘটে যাওয়া বাস্তব পরিবর্তনও বাদ পড়তে পারে। এটি নকশার সিদ্ধান্ত, কোনো সর্বজনীন নিয়ম নয়।
স্পষ্টভাবে কাল্পনিক একটি উদাহরণ ধরা যাক: \(T=240\)টি পর্যবেক্ষণ এবং নির্বাচিত trimming fraction 15%। এতে ন্যূনতম সেগমেন্ট দৈর্ঘ্য \(h=0.15\times240=36\) পর্যবেক্ষণ। বিচ্ছেদের তারিখ যদি আগের সেগমেন্টের শেষ পর্যবেক্ষণ বোঝায়, একটি বিচ্ছেদের ক্ষেত্রে গ্রহণযোগ্য তারিখ \(36\le T_1\le204\)। দুই পাশেই তখন কমপক্ষে 36টি পর্যবেক্ষণ থাকে।
দুটি বিচ্ছেদের ক্ষেত্রে গ্রহণযোগ্য তারিখ-জোড়াকে এই শর্ত মানতে হবে:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
অর্থাৎ \(T_1\le168\); আর \(T_2\)-কে প্রথম বিচ্ছেদের অন্তত 36টি পর্যবেক্ষণ পরে হতে হবে এবং দ্বিতীয়টির পরেও 36টি পর্যবেক্ষণ রাখতে হবে। \((72,156)\) গ্রহণযোগ্য: তিনটি সেগমেন্টে যথাক্রমে 72, 84 ও 84টি পর্যবেক্ষণ আছে। \((80,100)\) গ্রহণযোগ্য নয়, কারণ মাঝের সেগমেন্টে মাত্র 20টি পর্যবেক্ষণ। এই \(h\) দিয়ে 240 পর্যবেক্ষণে সর্বোচ্চ পাঁচটি বিচ্ছেদ বসে: ছয়টি সেগমেন্টে অন্তত \(6\times36=216\) পর্যবেক্ষণ লাগে, সাতটিতে লাগে 252।
এখানে 15% স্পষ্টতই একটি কাল্পনিক নকশা-পছন্দ, কোনো default recommendation নয়। বড় fraction স্বল্পস্থায়ী regime ও নমুনার প্রান্তের কাছের তারিখ বাদ দিতে পারে; ছোট fraction সংক্ষিপ্ত সেগমেন্ট অনুমোদন করে, কিন্তু slope ও দীর্ঘমেয়াদি covariance নির্ভরযোগ্যভাবে অনুমানের জন্য তথ্য কম পড়তে পারে। sampling frequency, explanatory variable-এর সংখ্যা, সম্ভাব্য regime duration এবং inference পদ্ধতি দেখে নিয়ম বেছে নিন। নিয়মটি জানান এবং বিষয়গতভাবে উপযুক্ত হলে কাছাকাছি মানে সিদ্ধান্ত বদলায় কি না দেখান। lag বা missing observation থাকলে implementation-ভেদে কার্যকর নমুনার আকার ও endpoint ভিন্ন হতে পারে, তাই ব্যবহৃত convention লিখুন।
স্থির বিচ্ছেদ-সংখ্যায় global segmentation পেতে dynamic programming ব্যবহার করুন
বিশুদ্ধ পরিবর্তন মডেলে \(m\) স্থির থাকলে তারিখ অনুসন্ধানকে মোট segment RSS কমানোর সমস্যা হিসেবে লেখা যায়:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
তারিখের ক্রম ও ন্যূনতম সেগমেন্ট দৈর্ঘ্যের শর্তসাপেক্ষে। \(\operatorname{SSR}(a,b)\) হলো \(a,\ldots,b\) পর্যবেক্ষণে একটি সেগমেন্ট fit করে পাওয়া সর্বনিম্ন least-squares residual sum of squares। সরল exhaustive search প্রতিটি তারিখ-সমন্বয় পরীক্ষা করে, যার সংখ্যা \(T\) ও \(m\)-এর সঙ্গে দ্রুত বাড়ে।
Dynamic programming সমাধান করা উপ-সমস্যা পুনর্ব্যবহার করে। \(D(r,j)\) যদি 1 থেকে \(j\) পর্যবেক্ষণকে \(r\)টি বৈধ সেগমেন্টে ভাগ করার সর্বনিম্ন RSS হয়, তবে recurrence-এর একটি রূপ হলো:
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
যেখানে বিভাজন বিন্দু \(i\) এমনভাবে সীমাবদ্ধ যে প্রথম \(r-1\)টি ও শেষ সেগমেন্ট—সবই ন্যূনতম দৈর্ঘ্য পূরণ করে। প্রতিটি ধাপে সর্বনিম্ন মানের বিভাজনটি সংরক্ষণ করলে পরে তারিখগুলো পুনরুদ্ধার করা যায়। অনুমোদিত প্রতিটি সেগমেন্ট-সংখ্যার জন্য মডেল ও সীমাবদ্ধতার অধীনে global minimum-RSS বিভাজন পাওয়া যায়; একে একে greedy পদ্ধতিতে বিচ্ছেদ যোগ করা হয় না। Bai ও Perron (2003) এই গণনা এবং বিশুদ্ধ ও আংশিক পরিবর্তন মডেল আলোচনা করেন।
এখানে “global” বলতে বাছা সংখ্যা, explanatory variable, deterministic term, trimming এবং objective-এর শর্তে global বোঝায়। এর মানে মডেল সত্য, নির্বাচিত সংখ্যাই সঠিক, অথবা সব সম্ভাব্য specification-এর মধ্যে বিভাজনটি সর্বোত্তম—এমন নয়। পদ্ধতিটি একাধিক সংখ্যা কার্যকরভাবে তুলনা করতে পারে, কিন্তু \(m\) নির্বাচন আলাদা inference বা model-selection ধাপ।
অনুসন্ধান-সমন্বিত inference বা মানদণ্ড দিয়ে বিচ্ছেদের সংখ্যা বাছুন
প্রার্থী সংখ্যার জন্য সেরা বিভাজন পাওয়ার পর \(m\) বাছার একাধিক উপায় আছে। Sequential \(\sup F(\ell+1\mid\ell)\) পরীক্ষা \(\ell\)টি বিচ্ছেদযুক্ত মডেলের সঙ্গে একটি অতিরিক্ত বিচ্ছেদযুক্ত মডেল তুলনা করে; গ্রহণযোগ্য তারিখগুলোর ওপর supremum statistic ব্যবহার হয়। UDmax বা WDmax-এর মতো double-maximum পরীক্ষা কোনো বিচ্ছেদ নেই—এই null-এর সঙ্গে সর্বোচ্চ নির্দিষ্ট সংখ্যক বিচ্ছেদ পর্যন্ত অজানা সংখ্যার alternative তুলনা করে। BIC-ধরনের information criterion fit-এর উন্নতি ও model complexity-এর penalty তুলনা করে। পদ্ধতিগুলো সম্পর্কিত হলেও একই প্রশ্নের উত্তর দেয় না।
অজানা বিচ্ছেদের তারিখের ওপর সর্বোচ্চ মান নেওয়ার পর সাধারণ F critical value সাধারণত উপযুক্ত নয়। কোনো বিচ্ছেদ নেই—এই null-এর অধীনে প্রার্থী তারিখগুলো alternative-এর মতোভাবে identified নয়; ফলে nonstandard asymptotic distribution হয়। critical value trimming, বিশুদ্ধ না আংশিক পরিবর্তন, explanatory variable এবং error covariance assumptions-এর ওপর নির্ভর করে। Bai ও Perron (1998) একাধিক পরিবর্তনের পরীক্ষা উদ্ভাবন করেন; পরের critical-value গবেষণায় বিভিন্ন trimming ও model setting-এর মান দেওয়া হয়েছে। Andrews (1993) একটি অজানা change point-এর instability test-এর গুরুত্বপূর্ণ ভিত্তি, তবে তার critical value বহু-বিচ্ছেদের পদ্ধতির বিকল্প নয়।
Sequential test ব্যাখ্যা করা সহজ, কিন্তু প্রতিটি ধাপের power ও আগে ঠিক করা সর্বোচ্চ বিচ্ছেদ-সংখ্যার ওপর ফল নির্ভর করতে পারে। Information criterion-এর penalty আলাদা হওয়ায় নির্বাচিত সংখ্যা আলাদা হতে পারে; candidate model-গুলোও কেবল approximation হতে পারে। বেশি বিচ্ছেদ মানেই বাস্তবতার ভালো বর্ণনা নয়: সামান্য fit উন্নতির বিনিময়ে segment coefficient অস্থিতিশীল হতে পারে। পদ্ধতি, সর্বোচ্চ সংখ্যা, trimming, test sequence বা criterion এবং critical-value assumptions জানান। সিদ্ধান্ত গুরুত্বপূর্ণ হলে একটি সংখ্যা নিশ্চিত হিসেবে না দেখিয়ে sensitivity দেখান।
অনুমান করা তারিখকে অনিশ্চিত শর্তসাপেক্ষ অনুমান হিসেবে দেখুন
objective কমায় যে তারিখগুলো, সেগুলো নির্দিষ্ট মডেলের অধীনে point estimate। অর্থনৈতিক সম্পর্ক বদলানোর সঠিক মুহূর্ত তথ্য প্রকাশ করেছে—এভাবে উপস্থাপন করবেন না। নমুনাগত পরিবর্তন, সহগের ছোট পরিবর্তন, কাছাকাছি বিচ্ছেদ, noisy outcome, কম পরিবর্তনশীল explanatory variable এবং দীর্ঘ minimum segment—সবই minimum-এর আশেপাশে objective-কে সমতল করতে পারে। তখন কাছাকাছি একাধিক বিভাজনের fit প্রায় সমান হতে পারে।
Bai ও Perron নির্দিষ্ট শর্তে বিচ্ছেদের তারিখের confidence interval নির্মাণের পদ্ধতি দেন। এসব interval মডেলকৃত তারিখের sampling uncertainty বোঝায়; regression specification সঠিক কি না, কোন variable অন্তর্ভুক্ত হবে, বিচ্ছেদের সংখ্যা বা trimming rule—এসবের সব অনিশ্চয়তা ধরে না। বিচ্ছেদের সংখ্যাই অনিশ্চিত হলে একটি নির্বাচিত সংখ্যার শর্তে পাওয়া সংকীর্ণ তারিখ-interval সামগ্রিক অনিশ্চয়তা কম দেখাতে পারে।
রিপোর্টে তারিখের convention, অনুমান করা observation index, সংশ্লিষ্ট calendar date এবং প্রতিটি বিচ্ছেদের interval আলাদা করে বলুন। interval চওড়া বা পরস্পর overlap করলে তারিখের অবস্থান অনির্দিষ্ট বলে বর্ণনা করুন। ফল দেখার পর chart থেকে একটি তারিখ বেছে নিয়ে সেটিকে স্বাধীনভাবে পূর্বাভাস দেওয়া ঘটনার তারিখ বলবেন না। পরিচিত ঘটনার সঙ্গে অনুমান করা বিচ্ছেদ তুলনা করলে মনে রাখুন, তথ্য দেখার পর ঘটনাটি ও সময়সীমা বেছে নেওয়া হয়ে থাকতে পারে।
Serial dependence ও পরিবর্তনশীল variance অনুযায়ী inference মিলিয়ে নিন
RSS partition একটি fit criterion; পরীক্ষা ও confidence interval বৈধ কি না নির্ভর করে regressor ও error assumptions-এর ওপর। আর্থিক রিগ্রেশনে serial correlation, conditional heteroskedasticity, outlier, পরিবর্তনশীল volatility, overlapping return বা asynchronous observation থাকতে পারে। covariance estimator ও critical value যদি independent, equal-variance error ধরে, অথচ residual dependent বা heteroskedastic হয়, তাহলে অনুমান করা তারিখ বিশ্বাসযোগ্য দেখালেও significance বিভ্রান্তিকর হতে পারে।
Bai–Perron গবেষণায় heteroskedasticity ও serial dependence-এর কিছু রূপসহ আরও বিস্তৃত শর্তে পদ্ধতি আলোচনা করা হয়েছে। তবু নির্দিষ্ট প্রয়োগের সঙ্গে মেলে এমন covariance correction ও reference value ব্যবহার করতে হবে। robust বা HAC covariance estimate omitted dynamics, endogenous regressor, ভুল conditional mean, অথবা অসামঞ্জস্যপূর্ণ সময়-ব্যবধান মেশানো observation calendar ঠিক করতে পারে না। শুধু robust standard error ব্যবহার করলেও RSS objective ডেটার ভালো মডেল হয়ে যায় না।
প্রার্থী সেগমেন্টের ভেতরে ও সেগমেন্টগুলোর মধ্যে residual dependence ও variance pattern পরীক্ষা করুন। error assumption segment-specific variance, serial correlation বা regressor distribution-এর পরিবর্তন অনুমোদন করে কি না এবং নির্বাচিত পরীক্ষার তত্ত্ব এগুলো সমর্থন করে কি না জানান। খুব ছোট সেগমেন্টে robust covariance অনুমান বিশেষভাবে দুর্বল; তাই trimming ও model dimension একসঙ্গে পরিকল্পনা করা দরকার। regression estimate ও covariance assumption-এর পটভূমির জন্য OLS regression নির্দেশিকা দেখুন।
কারণ বা ট্রেডিং-দাবিতে না গিয়ে বিচ্ছেদ বিশ্লেষণ রিপোর্ট করুন
পুনরুৎপাদনযোগ্য রিপোর্টে outcome, সব regressor, transformation, নমুনার সময়কাল ও frequency, intercept ও coefficient restriction, বিশুদ্ধ না আংশিক পরিবর্তন specification, candidate সর্বোচ্চ \(m\), trimming fraction ও minimum length, তারিখের convention, optimization method এবং \(m\) বাছার test বা criterion উল্লেখ করুন। নির্বাচিত বিচ্ছেদ-সংখ্যা, segment অনুযায়ী coefficient, তারিখ ও uncertainty interval, test statistic, covariance treatment এবং critical-value source দিন। অনুসন্ধান থেকে কোন endpoint বা observation বাদ পড়েছে তাও ব্যাখ্যা করুন।
পরিসংখ্যানগতভাবে শনাক্ত বিচ্ছেদ নির্দিষ্ট regression ও তার assumptions-এর অধীনে parameter instability-এর প্রমাণ। এটি কোন ঘটনা পরিবর্তন ঘটিয়েছে তা শনাক্ত করে না, নির্দিষ্ট সংবাদ বা নীতিকে কারণ হিসেবে প্রমাণ করে না, কিংবা বিচ্ছেদের আগে-পরে সহগ ভবিষ্যতেও থাকবে তা দেখায় না। বিচ্ছেদের পেছনে omitted variable, data definition বদল, volatility episode, measurement problem বা বাস্তব অর্থনৈতিক পরিবর্তন থাকতে পারে; regression test একা এই ব্যাখ্যাগুলো আলাদা করতে পারে না।
Quant trading-এ full-sample search প্রতিটি অনুমান করা বিচ্ছেদের আগের ও পরের পর্যবেক্ষণ ব্যবহার করে। নির্বাচিত তারিখটি real time-এ জানা ছিল এমনভাবে trade করলে look-ahead bias হয়। প্রস্তাবিত regime rule chronologicalভাবে মূল্যায়ন করুন এবং প্রতিটি তারিখে পাওয়া তথ্য দিয়েই পুনরায় estimate করুন; spread, fee, market impact, financing, borrow, turnover ও latency ধরুন। fixed-parameter এবং no-trade baseline-এর সঙ্গে তুলনা করুন, এবং সত্যিকার অর্থে পরবর্তী ডেটা validation-এর জন্য রাখুন। বিচ্ছেদ model review বা risk check-এর কারণ হতে পারে, কিন্তু predictive power বা বিনিয়োগযোগ্য edge-এর প্রমাণ নয়।
Bai ও Perron (1998) তাঁদের মূল প্রবন্ধে linear model-এ একাধিক কাঠামোগত পরিবর্তনের পরীক্ষা ও অনুমান উপস্থাপন করেন। তাঁদের ২০০৩ সালের computation প্রবন্ধ dynamic programming ও partial-change procedure ব্যাখ্যা করে; critical-value প্রবন্ধ design অনুযায়ী মান কীভাবে বদলায় তা দেখায়। Andrews-এর অজানা change point বিষয়ক প্রবন্ধ একক বিচ্ছেদের জন্য সম্পর্কিত ভিত্তি। পাশাপাশি আগে নির্ধারিত তারিখের Chow পরীক্ষা ও রিগ্রেশন CUSUM পরীক্ষা তুলনা করুন।
সাধারণ প্রশ্ন
Q1Bai–Perron কি বিচ্ছেদের প্রকৃত সংখ্যা জানায়?
না। পদ্ধতিটি বিভাজন অনুমান করে এবং সম্ভাব্য সংখ্যার মধ্যে বাছতে পরীক্ষা বা criterion দেয়। ফল regression specification, trimming, error assumption, সর্বোচ্চ সংখ্যা ও নির্বাচন-নিয়মের ওপর নির্ভর করে; data-generating process-এ ঠিক এতগুলো বিচ্ছেদ ছিল তা নিশ্চিত করে না।
Q2বিচ্ছেদের তারিখ কি সেই তারিখ যখন কোনো অর্থনৈতিক ঘটনা পরিবর্তন ঘটিয়েছিল?
না। এটি fit করা মডেলের অধীনে parameter instability-এর অনুমান করা অবস্থান, যার সঙ্গে sampling uncertainty আছে। কারণ নির্ধারণে অতিরিক্ত প্রমাণ ও বিকল্প ব্যাখ্যা বাদ দেওয়ার মতো গবেষণা-নকশা দরকার।
Q3অনুমান করা বিচ্ছেদের তারিখ ধরে সরাসরি ট্রেড করতে পারি?
শুধু full-sample-এর retrospective estimate-এর ভিত্তিতে নয়। অনুসন্ধানে candidate বিচ্ছেদের পরের পর্যবেক্ষণও ব্যবহৃত হয়। live rule-এর জন্য chronological evaluation, তখনকার তথ্য, খরচ ও পরবর্তী ডেটায় validation দরকার; বিচ্ছেদ শনাক্ত হওয়া লাভজনক signal প্রমাণ করে না।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
240টি পর্যবেক্ষণের উদাহরণে 15% minimum-segment rule-এর অর্থ কী?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
কল, পুট ও অপশন চেইন থেকে অন্তর্নিহিত অস্থিরতা, গ্রিকস এবং বিড-আস্ক স্প্রেড পর্যন্ত গুরুত্বপূর্ণ শব্দের পরিষ্কার সংজ্ঞা
অপশন শব্দকোষ দেখুন