

MIDAS রিগ্রেশন: মিশ্র-ফ্রিকোয়েন্সি ডেটা ও অস্থিরতার পূর্বাভাস
MIDAS রিগ্রেশন কীভাবে দৈনিক ও সাপ্তাহিক আর্থিক ডেটাকে সংযত ল্যাগ-ওজনে যুক্ত করে, কীভাবে অস্থিরতার পূর্বাভাস তৈরি হয় এবং মিশ্র-ফ্রিকোয়েন্সি মডেল কোথায় বিভ্রান্ত করতে পারে তা জানুন।
এই গাইডেপর্যবেক্ষণের ফ্রিকোয়েন্সির অমিল সামলায় MIDAS
সংক্ষিপ্ত সারাংশ
MIDAS (mixed data sampling) রিগ্রেশন ভিন্ন ফ্রিকোয়েন্সিতে নথিবদ্ধ পর্যবেক্ষণকে যুক্ত করে, কোনো সিরিজকে আগে জোর করে একই ক্যালেন্ডারে না এনে। অল্প কয়েকটি আনুমানিক প্যারামিটার উচ্চ-ফ্রিকোয়েন্সির পর্যবেক্ষণের অতীতকে ওজন দেয়, যা কম-ফ্রিকোয়েন্সির আর্থিক লক্ষ্য পূর্বাভাসে কাজে লাগতে পারে। এই ওজন নির্বাচিত মডেলের অধীনে একটি পূর্বাভাসমূলক ধরন বর্ণনা করে; এটি কারণ-সম্পর্ক বা ট্রেডিং সুবিধা প্রমাণ করে না।
পর্যবেক্ষণের ফ্রিকোয়েন্সির অমিল সামলায় MIDAS
আর্থিক ও অর্থনৈতিক ডেটা একই ঘড়িতে আসে না। অস্থিরতার লক্ষ্য সাপ্তাহিকভাবে মাপা হতে পারে, অথচ সম্ভাব্য পূর্বাভাসক দৈনিক রিটার্ন বা ইন্ট্রাডে realized measure হতে পারে। সামষ্টিক অর্থনৈতিক সিরিজ ত্রৈমাসিক হতে পারে, আর কোনো সম্পদের দাম প্রতিটি ট্রেডিং দিনে দেখা যায়। সাধারণ রিগ্রেশনে লক্ষ্য ও পূর্বাভাসকের প্রতি পর্যবেক্ষণে একটি করে সারি লাগে; তাই পরিচিত মডেল অনুমান করার আগে এই ভিন্ন ক্যালেন্ডার কীভাবে সামলানো হবে তা ঠিক করতে হয়।
একটি উপায় হলো দৈনিক ইনপুটকে সাপ্তাহিক গড় বা যোগফলে একত্র করা। এটি সহজ, তবে প্রতিটি দিনের জন্য নির্দিষ্ট ওজন চাপিয়ে দেয় এবং সপ্তাহের কোন সময়ে পরিবর্তন ঘটেছে তা হারাতে পারে। আরেকটি উপায় হলো ত্রৈমাসিক মানকে দৈনিক সারিতে বারবার বসানো বা ইন্টারপোলেট করা। বারবার বসালে ধীরে বদলানো একটি মানকে অনেক নতুন পর্যবেক্ষণ মনে হতে পারে; ইন্টারপোলেশন এমন মসৃণ পথ তৈরি করতে পারে যা কখনো পর্যবেক্ষিত হয়নি। কোনোটিই নতুন তথ্য তৈরি করে না।
MIDAS ফ্রিকোয়েন্সি যুক্ত করার সরাসরি উপায় দেয়। এটি লক্ষ্যকে তার স্বাভাবিক কম ফ্রিকোয়েন্সিতে রেখে উচ্চ-ফ্রিকোয়েন্সির সিরিজের একটি কাঠামোবদ্ধ ল্যাগ অন্তর্ভুক্ত করে। নামটি mixed data sampling বোঝায়, কোনো একক অস্থিরতা মডেল নয়। গবেষকেরা অস্থিরতার পূর্বাভাসে এবং যেখানে পূর্বাভাসক ফলাফলের চেয়ে সূক্ষ্ম ব্যবধানে মাপা হয় এমন অন্যান্য ক্ষেত্রেও MIDAS রিগ্রেশন ব্যবহার করেন। মূল প্রশ্ন হলো সাম্প্রতিক উচ্চ-ফ্রিকোয়েন্সির ইতিহাসের কতটা ব্যবহার করা হবে এবং ওজন কীভাবে সীমিত করা হবে।
ওজনযুক্ত ল্যাগ বহু পর্যবেক্ষণকে সংক্ষিপ্ত পূর্বাভাসে রূপ দেয়
ধরা যাক, \(y_{t+1}\) হলো কম-ফ্রিকোয়েন্সির লক্ষ্য—যেমন আগামী সপ্তাহের realized variance—যা \(t+1\) সপ্তাহ শেষ হওয়ার পর দেখা যায়। \(x_{t-j}\) হলো সপ্তাহ \(t\)-এর শেষে পূর্বাভাসের সময়ের \(j\)টি ট্রেডিং সেশন আগে পর্যবেক্ষিত দৈনিক পূর্বাভাসক। একটি সহজ MIDAS রিগ্রেশন হলো \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), যেখানে \(K\) দৈনিক ল্যাগের সংখ্যা, \(w_j(\theta)\) অল্প কয়েকটি প্যারামিটার দ্বারা নিয়ন্ত্রিত ওজন এবং \(u_{t+1}\) পূর্বাভাসের ত্রুটি।
ওজনগুলো সাধারণত এমনভাবে স্বাভাবিকীকৃত হয় যাতে \(\sum_{j=1}^{K}w_j(\theta)=1\)। এতে ওজনযুক্ত যোগফলকে ওজনযুক্ত ইতিহাস হিসেবে পড়া সহজ হয়, আর \(b\) ওই সারাংশের সঙ্গে লক্ষ্যের সম্পর্কের শক্তি নিয়ন্ত্রণ করে। এই স্বাভাবিকীকরণ দৈনিক পর্যবেক্ষণগুলোকে স্বাধীন বা সমান তথ্যবহ করে না। এটি ল্যাগের প্রোফাইল নির্ধারণের সুবিধাজনক প্যারামিটারায়ন।
বিশ্লেষক \(x\) হিসেবে দৈনিক বর্গ-রিটার্ন, পরম রিটার্ন, ইন্ট্রাডে রিটার্ন থেকে তৈরি realized-variance পরিমাপ বা পূর্বাভাসের সময়ে পাওয়া অন্য কোনো চলক বেছে নিতে পারেন। ফলাফল \(y\) হতে পারে ভবিষ্যৎ সাপ্তাহিক variance, মাসিক সামষ্টিক অর্থনৈতিক প্রকাশনা বা অন্য কম-ফ্রিকোয়েন্সির লক্ষ্য। লক্ষ্য কীভাবে সংজ্ঞায়িত হয়েছে তার ওপর সহগগুলোর অর্থ নির্ভর করে। realized-variance proxy-র মডেল স্বয়ংক্রিয়ভাবে latent instantaneous variance, option-implied variance বা মূল্য-রিটার্নের মডেল নয়।
MIDAS একটি রিগ্রেশন কাঠামো, সর্বজনীন estimator নয়। প্রতিক্রিয়া level, log বা link function দিয়ে মডেল করা যায়; অনুমান নির্ভর করে নির্বাচিত ওজন-পরিবার ও ত্রুটির অনুমানের ওপর। অ-ঋণাত্মক variance proxy-র সরলরৈখিক রিগ্রেশন লক্ষ্যকে রূপান্তর বা পূর্বাভাসে সীমা আরোপ না করলে ঋণাত্মক fitted value দিতে পারে। মডেলের সুবিধা লক্ষ্যটির সম্ভাব্য মানের পরিসর ও একক যাচাইয়ের প্রয়োজন দূর করে না।
ওজন ফাংশন নমনীয়তার বিনিময়ে স্থিতিশীলতা আনে
অসীমাবদ্ধ distributed-lag রিগ্রেশনে প্রতিটি \(K\)টি দৈনিক ইনপুটের জন্য আলাদা সহগ অনুমান করা হয়। সাপ্তাহিক লক্ষ্যের পর্যবেক্ষণের তুলনায় \(K\) বড় হলে অনুমানগুলো অস্থির ও পরস্পর দৃঢ়ভাবে সম্পর্কিত হতে পারে। MIDAS এর বদলে কম মাত্রার একটি ফাংশন দিয়ে ল্যাগ সহগ নির্ধারণ করে। উদাহরণ হিসেবে exponential-Almon প্রোফাইল \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\)। স্বাভাবিকীকৃত Beta-polynomial প্রোফাইলও প্রচলিত।
এ ধরনের প্রোফাইল সাম্প্রতিক সেশনকে বেশি ওজন দিতে, ধীরে ধীরে ওজন কমাতে বা ল্যাগ-উইন্ডোর মাঝামাঝি অংশকে তুলনামূলক বেশি ওজন দিতে পারে। প্যারামিটারগুলো নির্বাচিত মসৃণ বক্ররেখা বর্ণনা করে; শর্তহীনভাবে প্রতিটি দিনের গুরুত্ব নয়। ডেটায় স্বল্পস্থায়ী প্রতিক্রিয়ার ইঙ্গিত থাকলেও নির্বাচিত ফাংশন যদি দীর্ঘ মসৃণ tail চাপিয়ে দেয়, fitted সহগে সেই সীমাবদ্ধতা ঢুকে যায়। বিপরীতে, অনেকগুলো স্বাধীন দৈনিক সহগ অনুমান করলে স্থিতিশীল গতিবিদ্যার বদলে noise-এ fit হতে পারে।
ওজনের সীমাবদ্ধতাগুলো মডেলের অনুমান। অঋণাত্মক ও স্বাভাবিকীকৃত ওজন variance forecast-কে ওজনযুক্ত গড় হিসেবে ব্যাখ্যা করা সহজ করতে পারে, কিন্তু পরস্পরকে বাতিল করা ধনাত্মক ও ঋণাত্মক ল্যাগ-প্রভাব বাদ দেয়। নমনীয় প্রোফাইল hump বা ঢালের পরিবর্তন ধরতে পারে, তবে অতিরিক্ত shape parameter দুর্বলভাবে শনাক্ত হতে পারে। যুক্তিসঙ্গত কয়েকটি প্রোফাইল তুলনা করুন, কোন ল্যাগগুলো ব্যবহারযোগ্য ছিল তা জানান, এবং ওজন-পরিবার পাল্টালে পূর্বাভাস উল্লেখযোগ্যভাবে বদলায় কি না দেখুন।
সবার জন্য একটিই \(K\) নেই। দীর্ঘ উইন্ডো স্থায়ী তথ্য ধরতে পারে, কিন্তু প্যারামিটার বাড়ায় বা দীর্ঘ আকৃতির প্রোফাইল চাপায়; ছোট উইন্ডো ধীর গতিবিদ্যা বাদ দিতে পারে। অনুমান-পর্বে পাওয়া তথ্য দিয়ে ল্যাগের সংখ্যা ঠিক করা উচিত এবং ভবিষ্যৎ মূল্যায়ন-লক্ষ্য ব্যবহার না করে যাচাই করা উচিত। নমুনার ভেতরের ভালো fit একাই দেখায় না যে ল্যাগ-উইন্ডো পুনরাবৃত্তিযোগ্য সংকেত ধরেছে।
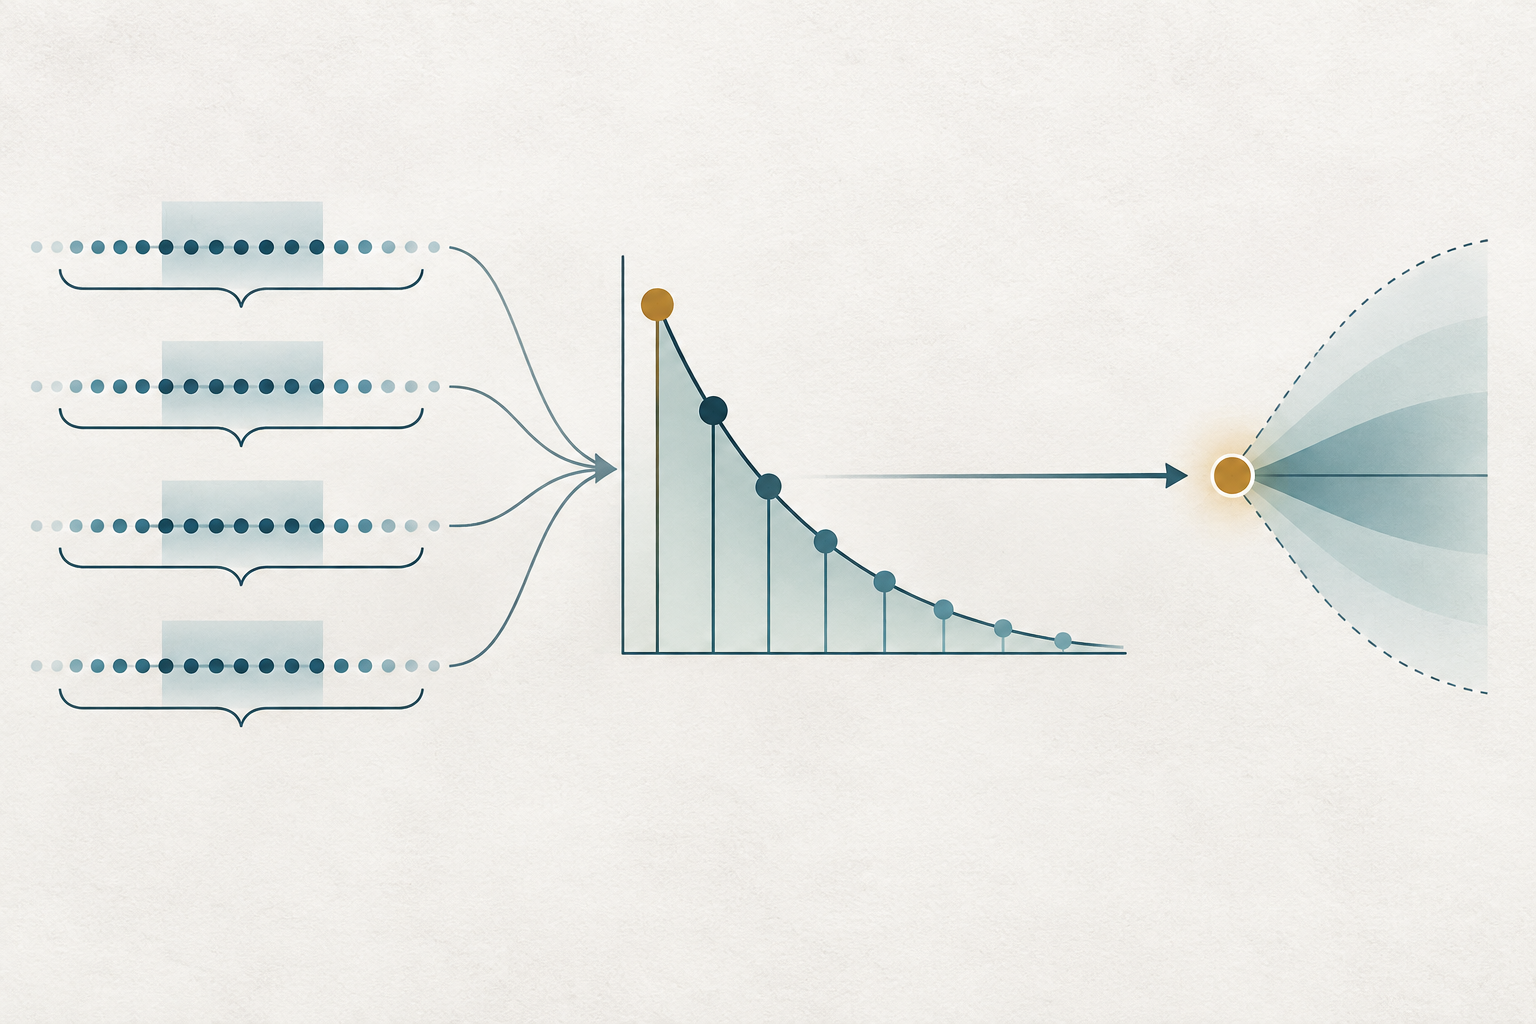
প্রতিটি মান কখন জানা ছিল তার সঙ্গে পূর্বাভাসের সময় মেলান
ফ্রিকোয়েন্সির লেবেল যথেষ্ট নয়; বৈধ পূর্বাভাস নকশা দরকার। ধরা যাক লক্ষ্য হলো আসন্ন পাঁচ-সেশনের সপ্তাহের variance, আর পূর্বাভাস শুক্রবারের বাজার বন্ধের পর দেওয়া হয়। শুক্রবার পর্যন্ত শেষ হওয়া দৈনিক পর্যবেক্ষণ নেওয়া যায়, কিন্তু পরের সপ্তাহের রিটার্ন থেকে হিসাব করা realized-variance পরিসংখ্যান নেওয়া যায় না। লক্ষ্য যদি প্রকাশিত সাপ্তাহিক বা মাসিক পরিসংখ্যান হয়, তবে বর্ণিত সময়কাল শেষ হওয়ার পরও প্রকাশনা আসতে পারে। backtest-এ তখন বাস্তবে জানা মান ব্যবহার করতে হবে, পরবর্তীতে সংশোধিত বা প্রকাশিত মান নয়।
মডেল fit করার আগে পূর্বাভাস-সময়ের একটি সারণি লিখুন: পূর্বাভাস কখন দেওয়া হয়, প্রতিটি পূর্বাভাসকের সর্বশেষ অনুমোদিত timestamp, লক্ষ্য-সময়কাল এবং লক্ষ্য কখন পর্যবেক্ষণযোগ্য হয়। আর্থিক রিটার্নে close-to-close রিটার্ন রাতের ব্যবধান ধরে কি না, কোন বাজার-সেশনকে দিন বলা হচ্ছে, এবং ছুটি বা অনুপস্থিত bar দৈনিক ল্যাগের গণনা কীভাবে বদলায় তা উল্লেখ করুন। পাঁচটি ট্রেডিং সেশন ও সাতটি ক্যালেন্ডার দিন এক ব্যবধান নয়।
প্রকাশনার ক্যালেন্ডারে অসম প্রান্ত থাকে। কোনো তারিখে একটি পূর্বাভাসকের নতুন দৈনিক মান থাকতে পারে, কিন্তু মাসিক সিরিজ তখনও প্রকাশিত হয়নি। পূর্বের মাসিক মান ধরে রাখা বৈধ হতে পারে যদি মডেল সেটিকে পূর্বাভাস-সময়ে জানা পুরোনো তথ্য হিসেবে ধরে। পরে প্রকাশিত তথ্য দিয়ে তখনো অপ্রকাশিত পর্যবেক্ষণ পূরণ করা বৈধ নয়। ঐতিহাসিক সংশোধন আরও সূক্ষ্ম look-ahead সমস্যা তৈরি করতে পারে: বর্তমান ডেটাবেসে এমন সংশোধিত সামষ্টিক সিরিজ থাকতে পারে যা বাস্তবসময়ের পূর্বাভাসক তখন দেখতে পেতেন না।
বিভিন্ন সময়ে বন্ধ হওয়া বাজারে আরও একটি সমন্বয় সমস্যা আছে। দৈনিক equity close ও crypto close ভিন্ন UTC ব্যবধান বোঝাতে পারে; ইন্ট্রাডে অস্থিরতার অনুমানেও পূর্বাভাসের সময়ের পরে শেষ হওয়া bar থাকতে পারে। সময় অঞ্চল রূপান্তর, daylight-saving পরিবর্তন, venue বন্ধ থাকা এবং bar তৈরির নিয়ম তথ্যসেটের অংশ। একই তারিখের সারি একই তথ্য-সীমা পায় ধরে না নিয়ে এসব কীভাবে সামলানো হয়েছে বলুন।
একটি কাল্পনিক উদাহরণ দৈনিক ইনপুট থেকে সাপ্তাহিক পূর্বাভাস তৈরি করে
ধরা যাক লক্ষ্য হলো আগামী সপ্তাহের realized variance এবং পূর্বাভাস শুক্রবারের close-এ দেওয়া হয়। মডেলটি সদ্য শেষ হওয়া সপ্তাহের পাঁচটি দৈনিক realized-variance ইনপুট ব্যবহার করে। সাম্প্রতিক থেকে পুরোনো ক্রমে অনুমান করা ওজন \(0.40, 0.25, 0.16, 0.11, 0.08\), যার যোগফল এক। সংশ্লিষ্ট দৈনিক ইনপুটগুলো—বর্গ-রিটার্নের এককে—\(0.0004, 0.0001, 0.0009, 0.0004, 0.0001\)।
ওজনযুক্ত ইতিহাস হলো \(0.40(0.0004)+0.25(0.0001)+0.16(0.0009)+0.11(0.0004)+0.08(0.0001)=0.000381\)। এই কাল্পনিক fitted মডেলে intercept \(a=0.00012\) এবং slope \(b=0.80\) ধরা যাক। আগামী সপ্তাহের variance forecast হলো \(0.00012+0.80(0.000381)=0.0004248\)। standard-deviation সারাংশ দরকার হলে এর বর্গমূল প্রায় \(0.02061\), অর্থাৎ নির্বাচিত লক্ষ্য-সংজ্ঞা অনুযায়ী সপ্তাহে \(2.06\%\)।
হিসাবটি দেখায় কীভাবে দৈনিক পূর্বাভাসক ভবিষ্যৎ সাপ্তাহিক লক্ষ্যে যুক্ত হয়; মান ও fitted সহগগুলো বানানো। কোনো নির্দিষ্ট দিন পরের সপ্তাহের variance ঘটিয়েছে বা সম্পদের দাম বাড়বে-কমবে—এমন কথা এটি বলে না। সাম্প্রতিক সেশনের ওজনটি নমুনা ও সীমাবদ্ধতার শর্তে নির্দিষ্ট পূর্বাভাস মডেল কীভাবে পর্যবেক্ষিত ইনপুট মেশায় তা জানায়। এটি causal response estimate নয়।
উদাহরণটি এককের প্রশ্নও তোলে। দৈনিক ও সাপ্তাহিক realized variance দুটিই রিটার্নের variance, কিন্তু সঞ্চয়ের সময়কাল আলাদা। slope \(b\), intercept ও লক্ষ্য-নির্মাণ সেই নির্দিষ্ট convention অনুযায়ী শেখা হয়; দৈনিক ইনপুটকে শুধু সাপ্তাহিক variance নামে চালানো যায় না। লক্ষ্য যদি log weekly variance হয়, তবে মডেলের output log এককে হবে এবং conditional log mean-কে exponentiate করলে সাধারণত conditional mean variance পাওয়া যায় না। level-এ ফেরার জন্য পূর্বাভাসের লক্ষ্য স্পষ্ট করতে হয় এবং যথাস্থানে retransformation correction দরকার হতে পারে।
অনুমান নির্ভর করে লক্ষ্য ও ল্যাগের সীমাবদ্ধতার ওপর
ওজনের ভেক্টর নির্দিষ্ট থাকলে regression intercept ও slope-এর ক্ষেত্রে linear। ওজন অজানা nonlinear parameter \(\theta\)-এর ওপর নির্ভর করলে প্রায়ই nonlinear least squares বা সংশ্লিষ্ট likelihood-ভিত্তিক পদ্ধতি ব্যবহৃত হয়। estimator একসঙ্গে ওজনের আকৃতির প্যারামিটার ও regression coefficient খোঁজে, অথবা প্রতিটি সম্ভাব্য আকৃতিতে linear coefficient profile করে বাদ দেয়। প্রাথমিক মান, parameter bound, convergence criterion এবং local optimum-এর সংখ্যা গুরুত্বপূর্ণ হতে পারে; ব্যর্থ convergence বা boundary solution গোপন করা উচিত নয়।
যদি \(y\) অঋণাত্মক অস্থিরতা-পরিমাপ হয়, সাধারণ linear specification বিশেষত নমুনার বাইরে negative fitted value দিতে পারে। বিকল্পের মধ্যে level-কে অঋণাত্মক রাখার সীমাবদ্ধতা, positive link, অথবা লক্ষ্যটির log মডেল করা আছে। এতে estimand ও forecast-এর ব্যাখ্যা বদলে যায়। log-target মডেলে conditional mean log variance পূর্বাভাস করা মানে স্বয়ংক্রিয়ভাবে conditional mean variance পাওয়া নয়; error distribution ও retransformation বিবেচ্য।
নমুনাগত অনিশ্চয়তা লক্ষ্য কীভাবে তৈরি হয়েছে তারও ওপর নির্ভর করে। ইন্ট্রাডে রিটার্ন থেকে তৈরি সাপ্তাহিক realized variance-এ measurement error থাকে এবং microstructure noise, sampling interval, jump ও অনুপস্থিত পর্যবেক্ষণে সংবেদনশীল হতে পারে। সাপ্তাহিক লক্ষ্য-উইন্ডো overlap করলে পাশাপাশি পূর্বাভাস-সময়ের error একই underlying return ভাগ করে। তখন স্বাধীন forecast error ধরে হিসাব করা standard error বা তুলনা অনুপযুক্ত হতে পারে। পূর্বাভাস-দিগন্ত ও dependence structure-এর সঙ্গে মানানসই inference ব্যবহার করুন এবং লক্ষ্য মাপার পদ্ধতি জানান।
প্যারামিটারের স্থিতিশীলতাও গুরুত্বপূর্ণ। অনুমিত weight profile পুরো estimation sample-এর গড়; বাজারের কাঠামো বদলালে curve কোনো বর্তমান regime-ই ভালোভাবে বর্ণনা নাও করতে পারে। expanding ও rolling estimate আলাদা প্রশ্নের উত্তর দেয়: প্রথমটি বেশি ইতিহাস ব্যবহার করে, তবে পুরোনো গতিবিদ্যা রাখে; দ্বিতীয়টি দ্রুত মানিয়ে নেয়, কিন্তু পর্যবেক্ষণ কম এবং estimation noise বেশি। update rule আগে ঠিক করুন এবং chronological evaluation-এ fixed benchmark-এর সঙ্গে তুলনা করুন।
MIDAS, GARCH-MIDAS-এর সঙ্গে সম্পর্কিত, কিন্তু এক নয়
MIDAS নামটি ভিন্নভাবে sampled পর্যবেক্ষণকে weighted lag দিয়ে যুক্ত করার কৌশল বোঝায়। MIDAS regression অতীতের দৈনিক বা ইন্ট্রাডে পরিমাপ থেকে ভবিষ্যৎ realized-volatility লক্ষ্য সরাসরি পূর্বাভাস দিতে পারে। GARCH মডেলের এক-ধাপ conditional-variance recursion এতে থাকতেই হবে এমন নয়।
GARCH-MIDAS আলাদা একটি পরিবার: এতে সাধারণত কম-ফ্রিকোয়েন্সির চলক দ্বারা চালিত ধীর long-run volatility component এবং পুনরাবৃত্তভাবে বদলানো short-run conditional-variance component যুক্ত হয়। দুই উপাদানের parameterization ও অনুমান আলাদা। কোনো গবেষণা বা software package GARCH-MIDAS বললে তার নির্দিষ্ট equation দেখুন: MIDAS weight দীর্ঘমেয়াদি component চালাতে পারে, আর GARCH recursion স্বল্পমেয়াদি shock সামলাতে পারে। নামটুকু দিয়ে লক্ষ্য, latent না realized volatility, বা positivity কীভাবে আরোপ করা হয়েছে বোঝা যায় না।
প্রথম দিকের আর্থিক MIDAS অস্থিরতা-গবেষণা সংক্ষিপ্ত পূর্বাভাস কাঠামোয় বিভিন্ন পূর্বাভাসক, ফ্রিকোয়েন্সি ও lag length তুলনা করে। পরের পদ্ধতিগত কাজ মিশ্র-ফ্রিকোয়েন্সি regression-এর estimation ও testing বৈশিষ্ট্য এবং প্রচলিত temporal aggregation-এর সঙ্গে তুলনা করে। এসব অবদান পদ্ধতির মেকানিক্স সমর্থন করে; MIDAS সবসময় GARCH-কে ছাড়িয়ে যায় বা উচ্চ-ফ্রিকোয়েন্সির পূর্বাভাসক সবসময় উন্নতি আনে—এমন দাবি নয়। ফল নির্ভর করে সম্পদ, নমুনা, লক্ষ্য, পূর্বাভাসক, দিগন্ত ও মূল্যায়ন নকশার ওপর।
প্রশ্ন অনুযায়ী মডেল বাছুন। দৈনিক ইতিহাস দিয়ে ভবিষ্যৎ realized-volatility measure পূর্বাভাস করাই লক্ষ্য হলে direct MIDAS regression স্বাভাবিক প্রার্থী হতে পারে। conditional variance পুনরাবৃত্তভাবে মডেল করতে চাইলে উপযুক্ত GARCH specification তুলনা করুন। দৈনিক আর্থিক লক্ষ্যের সঙ্গে ত্রৈমাসিক macro release যুক্ত করলে release-vintage নিয়ন্ত্রণ দরকার হতে পারে। কাছাকাছি নামের মডেল ভিন্ন প্রশ্নের উত্তর দেয়, তাই performance তুলনার আগে forecast origin, target definition ও information set মেলান।
Measurement error ও নির্বাচন weight curve-কে ছাপিয়ে যেতে পারে
উচ্চ-ফ্রিকোয়েন্সির ডেটা সময়ের বেশি সূক্ষ্মতা দেয়, কিন্তু measurement noise-ও বাড়াতে পারে। খুব ছোট bar-এ bid–ask bounce, price discreteness, stale quote, asynchronous trading ও feed error থাকতে পারে। ক্রমেই ছোট sampling interval-এ squared return যোগ করলেই ভালো realized-variance estimate নিশ্চিত হয় না। পূর্বাভাসের performance দেখার আগেই sampling grid ও cleaning rule ঠিক করুন, এবং যুক্তিসঙ্গত বিকল্পে sensitivity দেখুন।
কতটা শেখা যাবে তা নির্ধারণ করে কম-ফ্রিকোয়েন্সির outcome সংখ্যা, দৈনিক predictor-row-এর আপাত সংখ্যা নয়। সাপ্তাহিক লক্ষ্যের সঙ্গে যুক্ত ১০ বছরের দৈনিক ইনপুটও missing value ও holdout বাদ দেওয়ার আগে মাত্র প্রায় ৫০০টি সাপ্তাহিক outcome দেয়। মসৃণ weight function-এ free daily lag-এর চেয়ে কম coefficient লাগে, কিন্তু নমুনা ছোট হলে, predictor খুব persistent হলে বা lag-গুলো redundant হলে এর আকৃতি দুর্বলভাবে শনাক্ত হতে পারে।
বিভিন্ন high-frequency measure, lag length, weight profile, transformation, market, forecast horizon ও loss পরীক্ষা করে শুধু সেরা ফল জানালে selection bias তৈরি হয়। একই target দিয়ে parameter ও model choice হওয়ায় in-sample fit বিশেষভাবে ঝুঁকিপূর্ণ। পরীক্ষা করা model family নথিভুক্ত রাখুন, primary metric ঠিক করুন এবং পরের chronological holdout বা selection-aware comparison ব্যবহার করুন। একই তারিখে বহু forecast তুললে dependence ও multiplicity ধরুন; প্রতিটিকে আলাদা নিশ্চিতকরণ হিসেবে গণ্য করবেন না।
অনুমিত weight curve causal explanation নয়। উচ্চ-ফ্রিকোয়েন্সির ইনপুট news, liquidity বা market activity-এর proxy হতে পারে; অদেখা কারণ predictor ও ভবিষ্যৎ volatility দুটিকেই চালাতে পারে। পূর্বাভাসের উপযোগিতা স্থিতিশীল timing ও out-of-sample evidence চায়। causal ব্যাখ্যার জন্য MIDAS lag equation-এর বাইরের পৃথক identification design ও অনুমান দরকার।
পূর্বাভাস নিজে লাভজনক ট্রেডিং সিদ্ধান্ত নির্ধারণ করে না
অস্থিরতার পূর্বাভাস risk budget, hedge size বা scenario range জানাতে পারে, কিন্তু return-এর sign বা position-এর দিক নির্ধারণ করে না। সাপ্তাহিক standard deviation-এর পূর্বাভাস \(2.06\%\) প্রতিশ্রুত price move, maximum loss বা option-implied volatility quote নয়। এটি fitted model ও sample-এ নির্বাচিত dispersion measure-এর পূর্বাভাস; বাস্তব return অনেক বড় বা ছোট হতে পারে।
কৌশল নিয়ে গবেষণায় signal time, order time, instrument, exposure rule ও exit আগে নির্ধারণ করুন। প্রতিটি ঐতিহাসিক origin-এ কেবল তখন জানা তথ্য দিয়ে MIDAS parameter পুনরায় অনুমান করুন। আগে থেকে নির্ধারিত benchmark ও target-consistent loss দিয়ে forecast মূল্যায়ন করুন; তারপর spread, fee, funding, borrow, market impact ও turnover বাদ দিয়ে return আলাদাভাবে simulate করুন। variance forecast পরিসংখ্যানগতভাবে ভালো হলেও after-cost return না-ও বাড়তে পারে।
লক্ষ্য ও sampling procedure; predictor-এর সংজ্ঞা ও একক; নিম্ন ও উচ্চ ফ্রিকোয়েন্সি; forecast origin; lag count; weight function ও restriction; estimation window ও update schedule; missing data ও data vintage সামলানো; loss function; benchmark; এবং chronological test date জানান। lag profile বদলালে ফল উল্লেখযোগ্যভাবে পাল্টালে forecast uncertainty বা sensitivity দেখান। প্রাসঙ্গিক ধারণার জন্য realized volatility, volatility clustering ও GARCH, এবং forecast accuracy comparison নির্দেশিকা দেখুন।
প্রধান উৎস হলো Ghysels, Santa-Clara ও Valkanov-এর MIDAS volatility forecasting গবেষণা, Ghysels, Sinko ও Valkanov-এর পদ্ধতিগত পর্যালোচনা ও সম্প্রসারণ, এবং Andreou, Ghysels ও Kourtellos-এর mixed-frequency regression model বিশ্লেষণ। তাদের empirical result সংশ্লিষ্ট নমুনা ও নকশার সঙ্গে বাঁধা; বর্তমান বাজার বা অন্য সম্পদশ্রেণিতে performance-এর নিশ্চয়তা নয়।
সাধারণ প্রশ্ন
Q1MIDAS কি সব ডেটাকে গড় করে এক ফ্রিকোয়েন্সিতে আনে?
না। MIDAS regression লক্ষ্যকে নির্বাচিত ফ্রিকোয়েন্সিতে রেখে উচ্চ-ফ্রিকোয়েন্সির predictor-এর কাঠামোবদ্ধ weighted lag ব্যবহার করে। প্রতিটি সিরিজকে একই row-by-row calendar-এ interpolate করার দরকার নেই।
Q2MIDAS regression কি GARCH-MIDAS-এর সমান?
না। MIDAS হলো mixed-frequency weighted-lag framework। GARCH-MIDAS MIDAS-ধাঁচের long-run component-কে short-run GARCH variance recursion-এর সঙ্গে যুক্ত করে। লক্ষ্য ও component জানতে মডেলের equation পড়ুন।
Q3ভালো MIDAS volatility forecast কি trading signal হিসেবে ব্যবহার করা যায়?
একা নয়। অস্থিরতার পূর্বাভাস নির্বাচিত dispersion measure বর্ণনা করে। কৌশলের জন্য আলাদা directional বা risk rule, বাস্তবসম্মত execution cost এবং chronological after-cost evaluation দরকার।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
MIDAS weight function-এর প্রধান কাজ কী?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
বিস্তারিত গাইড পড়ুনRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
বিস্তারিত গাইড পড়ুন