

Diebold–Mariano পরীক্ষা: দুটি পূর্বাভাসের নির্ভুলতা কীভাবে তুলনা করবেন
Diebold–Mariano পরীক্ষা কীভাবে জোড়া পূর্বাভাসের ক্ষতি তুলনা করে, ওভারল্যাপ করা সময়সীমা সামলায়, এবং কম p-value কেন ট্রেডিং দক্ষতার প্রমাণ নয়—জানুন।
এই গাইডেব্যাকটেস্টে ত্রুটি কম হলেই ভালো পূর্বাভাসের প্রমাণ হয় না
সংক্ষিপ্ত সারাংশ
Diebold–Mariano পরীক্ষা একই বাস্তব ফলাফলের বিপরীতে দুটি পূর্বাভাসের ক্ষতি তুলনা করে। ফল নির্ভর করে ক্ষতি ফাংশন, মূল্যায়ন নমুনা, পূর্বাভাসের সময়সীমা এবং অনিশ্চয়তা নির্ণয়ের পদ্ধতির ওপর। নমুনায় ত্রুটি কম হলেই প্রত্যাশিত নির্ভুলতা বেশি—এমন প্রমাণ হয় না; পূর্বাভাস ভালো হলেও ট্রেডিং কৌশল লাভজনক হবে তা প্রমাণিত হয় না।
ব্যাকটেস্টে ত্রুটি কম হলেই ভালো পূর্বাভাসের প্রমাণ হয় না
ধরা যাক, দুটি মডেল একই তারিখে একই রিটার্ন, অস্থিরতা বা অর্থনৈতিক সূচকের পূর্বাভাস দেয়। মূল্যায়ন নমুনায় মডেল A-এর গড় ত্রুটি মডেল B-এর চেয়ে কম হতে পারে। এতে নমুনায় দেখা ব্যবধানটি বর্ণনা হয়, কিন্তু ব্যবধানটি নির্ভরযোগ্যভাবে আবার দেখা যাবে কি না, নাকি দৈবভাবে নির্বাচিত পরীক্ষার তারিখের কারণে হয়েছে—তা জানা যায় না।
Diebold–Mariano (DM) পরীক্ষা এই তুলনাকে জোড়া সময়-সারিতে রূপ দেয়। প্রতিটি পূর্বাভাস-শুরুর সময়ে এটি দুই পূর্বাভাসকে একই বাস্তব ফলাফলের সঙ্গে তুলনা করে, আগে থেকে নির্বাচিত ক্ষতি ফাংশনে স্কোর দেয়, তারপর ক্ষতি-পার্থক্যের ধারাটি পরীক্ষা করে। জোড়া তুলনা জরুরি: অস্থির বাজারের দিনে দুই মডেলের ক্ষতিই বাড়তে পারে, আর তুলনাটি জানতে চায় সেই একই দিনগুলোতে কোনো একটি মডেলের ক্ষতি সাধারণত কম হয় কি না।
মূল কাঠামো শুধু বর্গ-ত্রুটি বা স্বাভাবিক বণ্টনের পূর্বাভাস-ত্রুটিতে সীমাবদ্ধ নয়। পূর্বাভাসের প্রশ্নের সঙ্গে মিল থাকলে এটি অসমমিত ক্ষতি-সহ বিভিন্ন ক্ষতি ফাংশন তুলনা করতে পারে। তবে প্রতিরক্ষাযোগ্য মূল্যায়ন নকশা এবং গড় ক্ষতি-পার্থক্যের অনিশ্চয়তার অনুমান দরকার। Diebold ও Mariano (1995) সমান পূর্বাভাস-নির্ভুলতার পরীক্ষা উপস্থাপন করেন; Harvey, Leybourne ও Newbold (1997)00719-4) ছোট নমুনার সংশোধন বিশ্লেষণ করেন।
পরিসংখ্যান গণনার আগে একই শর্তের পূর্বাভাস তুলনা করুন
প্রতিটি সারি যেন তুলনাযোগ্য একটি পূর্বাভাস-শুরুর সময় বোঝায়। দুই মডেলকেই একই লক্ষ্য ও সময়সীমার পূর্বাভাস দিতে হবে, এবং সেই শুরুর সময়ে যে তথ্য পাওয়া যেত কেবল সেটিই ব্যবহার করতে হবে। বাস্তব ফলাফল, টাইমস্ট্যাম্প, মুদ্রা বা একক, ডেটার সংস্করণ এবং অনুপস্থিত পর্যবেক্ষণের নিয়ম মিলিয়ে নিন। একটি মডেল যদি আগামী দিনের সমাপনী দর বলে আর অন্যটি পাঁচ দিনের গড় বলে, তাদের ত্রুটি ভিন্ন প্রশ্নের উত্তর দেয়।
ভবিষ্যৎ তথ্য না-দেখা পূর্বাভাস ব্যবহার করুন। কালানুক্রমিক পরীক্ষার নমুনা বা রোলিং ছদ্ম-নমুনার-বাইরের নকশা সাহায্য করতে পারে, কিন্তু একই পরীক্ষার নমুনা বারবার দেখে বৈশিষ্ট্য, সীমামান বা মডেলের রূপভেদ ঠিক করা হলে শুধু নমুনা ভাগ করাই যথেষ্ট নয়। অতীতের প্রতিটি শুরুর সময়ে যে পূর্বাভাস তৈরি হয়েছিল, সেই সময়ের ডেটা ও মডেল সংস্করণসহ সংরক্ষণ করুন। তা না হলে সংশোধিত সামষ্টিক অর্থনৈতিক ডেটা, টিকে থাকার পক্ষপাত সরানোর ফিল্টার বা পরবর্তী কর্পোরেট-অ্যাকশন সমন্বয় মূল্যায়নের ফল পরে বদলে দিতে পারে।
দুই মডেলকে একই পূর্বাভাস-শুরুর সমষ্টিতে মূল্যায়ন করুন। শুধু এক মডেলের জন্য কঠিন তারিখ বাদ দিলে জোড়া তুলনা ভেঙে যায়। পূর্বাভাস না থাকলে সাধারণ নমুনা নির্ধারণ করুন বা অনুপস্থিত পূর্বাভাসের যুক্তিসঙ্গত ব্যবস্থাটি জানান; নীরবে যেন দুই মডেল ভিন্ন বাজার-পর্যায়ের মুখোমুখি না হয়। কোন নমুনায় পছন্দের ফল আসে তা দেখার আগে শুরু ও শেষের তারিখ বেছে নিন।
ক্ষতি ফাংশনই ঠিক করে «আরও নির্ভুল» বলতে কী বোঝায়
t শুরুর সময়ে বাস্তব মান yₜ এবং A ও B মডেলের পূর্বাভাস ŷA,ₜ ও ŷB,ₜ ধরা যাক। ত্রুটিগুলো eA,ₜ = yₜ − ŷA,ₜ এবং eB,ₜ = yₜ − ŷB,ₜ। ক্ষতি ফাংশন L প্রতিটি ত্রুটিকে এমন স্কোরে রূপ দেয় যেখানে কম হলে ভালো। বর্গ-ক্ষতি L(e) = e² বড় ভুলকে বেশি দণ্ড দেয়। পরম-ক্ষতি L(e) = |e| ভুলের আকারের সঙ্গে সরলরৈখিকভাবে বাড়ে। কোয়ান্টাইল পূর্বাভাসে অসমমিত pinball ক্ষতি ব্যবহার করা যেতে পারে, কারণ বেশি ও কম পূর্বাভাসের খরচ আলাদা হতে পারে।
কোন স্কোর বেছে নিলেন তার ওপর কোন মডেল ভালো দেখায় তা বদলাতে পারে। একই এককে দুটি কাল্পনিক ত্রুটি-জোড়া বিবেচনা করুন: A-এর ত্রুটি 0 ও 2, B-এর 1 ও 1। গড় বর্গ-ক্ষতি A-এর 2 এবং B-এর 1, তাই B-এর স্কোর ভালো। পরম-ক্ষতিতে দুটির গড়ই 1। কোনো হিসাবই সব ক্ষেত্রে সঠিক নয়; গুরুত্বপূর্ণ ত্রুটি কোনগুলো, সে বিষয়ে প্রতিটি আলাদা প্রশ্নের উত্তর দেয়।
রিটার্নের শর্তাধীন গড়ের পূর্বাভাসে বর্গ-ত্রুটি কার্যকর হতে পারে, কিন্তু অস্থিরতা পূর্বাভাসে লক্ষ্য-উপযোগী স্কোর দরকার; Value-at-Risk (VaR) পূর্বাভাসে কোয়ান্টাইল ক্ষতি বা ঝুঁকি-নির্দিষ্ট ব্যাকটেস্ট লাগতে পারে। কোন মডেল জিতেছে তা দেখে ক্ষতি ফাংশন বেছে নিলে পরীক্ষাটিই আরেকটি অনুসন্ধান হয়ে যায়। তুলনা দেখার আগে স্কোর ও «ভালো»র দিক নির্ধারণ করুন।
VaR পূর্বাভাস সাধারণ বিন্দু-পূর্বাভাসের বদলে বণ্টনের লেজের কোয়ান্টাইল লক্ষ্য করে। VaR ব্যাকটেস্টিং নির্দেশিকা ব্যাখ্যা করে কীভাবে ব্যতিক্রমের হার ও সময়ক্রমের পরীক্ষা এই আলাদা ঝুঁকি-পূর্বাভাস মূল্যায়ন করে।
জোড়া ক্ষতি-পার্থক্য তৈরি করুন এবং শূন্য অনুমানটি বলুন
কম ক্ষতি ভালো হলে, t সময়ের পার্থক্য এভাবে সংজ্ঞায়িত করুন:
dₜ = L(eA,ₜ) − L(eB,ₜ)
এই চিহ্ন-রীতিতে ধনাত্মক dₜ মানে ঐ শুরুর সময়ে B-এর ক্ষতি কম ছিল; ঋণাত্মক মান A-কে সমর্থন করে। নমুনা গড় d̄ = (1/n) Σ dₜ। শর্তহীন সমান-নির্ভুলতার শূন্য অনুমান E[dₜ] = 0। দ্বিপাক্ষিক বিকল্প অনুমান জিজ্ঞেস করে প্রত্যাশিত ক্ষতি যেকোনো দিকে আলাদা কি না। আগে থেকে নির্ধারিত একপাক্ষিক বিকল্প নির্দিষ্ট কোনো মডেলের প্রত্যাশিত ক্ষতি কম কি না পরীক্ষা করতে পারে।
মূল পরীক্ষার পরিসংখ্যান:
DM = d̄ / √(Ŝd / n)
এখানে Ŝd ক্ষতি-পার্থক্য ধারার দীর্ঘমেয়াদি ভ্যারিয়েন্স নির্ণয় করে; প্রতিটি মডেলের পূর্বাভাস-ত্রুটির ভ্যারিয়েন্স নয়। শূন্য অনুমান এবং উপযুক্ত নিয়মিততার শর্তে পরিসংখ্যানটি আসন্নভাবে মানক স্বাভাবিক বণ্টন অনুসরণ করে। উপরের চিহ্ন-রীতি অনুযায়ী বড় ধনাত্মক মান B-কে এবং বড় ঋণাত্মক মান A-কে সমর্থন করে। p-value নির্দিষ্ট শূন্য অনুমান ও নমুনা-সংক্রান্ত অনুমানের সঙ্গে ডেটা কতটা সামঞ্জস্যপূর্ণ তা মাপে; কোনো মডেল সত্য হওয়ার সম্ভাবনা নয়।
জোড়া তুলনা দুই মডেলের সামগ্রিক ত্রুটির মাত্রার অপ্রাসঙ্গিক পার্থক্য শুধু ততটাই সরায়, যতটা প্রতি-শুরুর পার্থক্যে ধরা পড়ে। এতে ক্ষতির ধারা স্বাধীন হয় না, প্যারামিটার অনুমানের অনিশ্চয়তা নিজে থেকে দূর হয় না, আর বহু লক্ষ্য ও বিন্যাসে অনুসন্ধানের সংশোধনও হয় না। নকশা ও অনিশ্চয়তা নির্ণয়ে এসব সিদ্ধান্ত সামলাতে হবে।
এক-ধাপের উদাহরণ নমুনার ব্যবধান ও প্রমাণকে আলাদা করে
ধরা যাক, এক ধাপের 100টি কাল্পনিক পূর্বাভাস জোড়া আছে। বর্গ শতাংশ-পয়েন্ট এককে A-এর গড় বর্গ-ক্ষতি 0.26 এবং B-এর 0.23। তাই গড় পার্থক্য d̄ = 0.26 − 0.23 = 0.03, যা নমুনায় B-কে সমর্থন করে। উদাহরণ সহজ রাখতে ধরা যাক dₜ-এর আনুমানিক দীর্ঘমেয়াদি ভ্যারিয়েন্স 0.04 এবং পূর্বাভাস-শুরুর সময়গুলোর মধ্যে ধারাবাহিক কোভ্যারিয়েন্স নেই।
গড় পার্থক্যের মানক ত্রুটি √(0.04 / 100) = 0.02। সংশোধনবিহীন পরিসংখ্যান 0.03 / 0.02 = 1.50। h = 1 এবং T = 100 হলে Harvey–Leybourne–Newbold-এর ক্ষুদ্র-নমুনা গুণক √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995। গুণ করলে সংশোধিত পরিসংখ্যান প্রায় 1.49; আনুমানিক t₉₉ রেফারেন্স বণ্টনে দ্বিপাক্ষিক p-value প্রায় 0.14।
B-এর পর্যবেক্ষিত গড় বর্গ-ত্রুটি কম, তবে প্রচলিত তাৎপর্য-স্তরে সমান প্রত্যাশিত নির্ভুলতার বিরুদ্ধে এই উদাহরণ শক্ত প্রমাণ দেয় না। শূন্য অনুমান প্রত্যাখ্যান না করা দুই মডেলের নির্ভুলতা সমান প্রমাণ করে না; প্রত্যাখ্যান করলেও তা বেছে নেওয়া স্কোর, শুরুর সময় এবং অনুমানের ওপর নির্ভর করবে। হানি ও ভ্যারিয়েন্সের মানগুলো হিসাব বোঝানোর কাল্পনিক উপকরণ, বাস্তব গবেষণার ফল নয়।
এর সঙ্গে সংশ্লিষ্ট root mean squared error (RMSE) বা গড় বর্গ-ত্রুটির বর্গমূল প্রায় 0.510 এবং 0.480 শতাংশ-পয়েন্ট; বর্ণনামূলক ব্যবধান 0.030 পয়েন্ট। তবু DM পরিসংখ্যান জোড়া বর্গ-ক্ষতি পার্থক্য ব্যবহার করে; দুই বর্গমূলের পার্থক্যের t-পরীক্ষা এটি নয়।
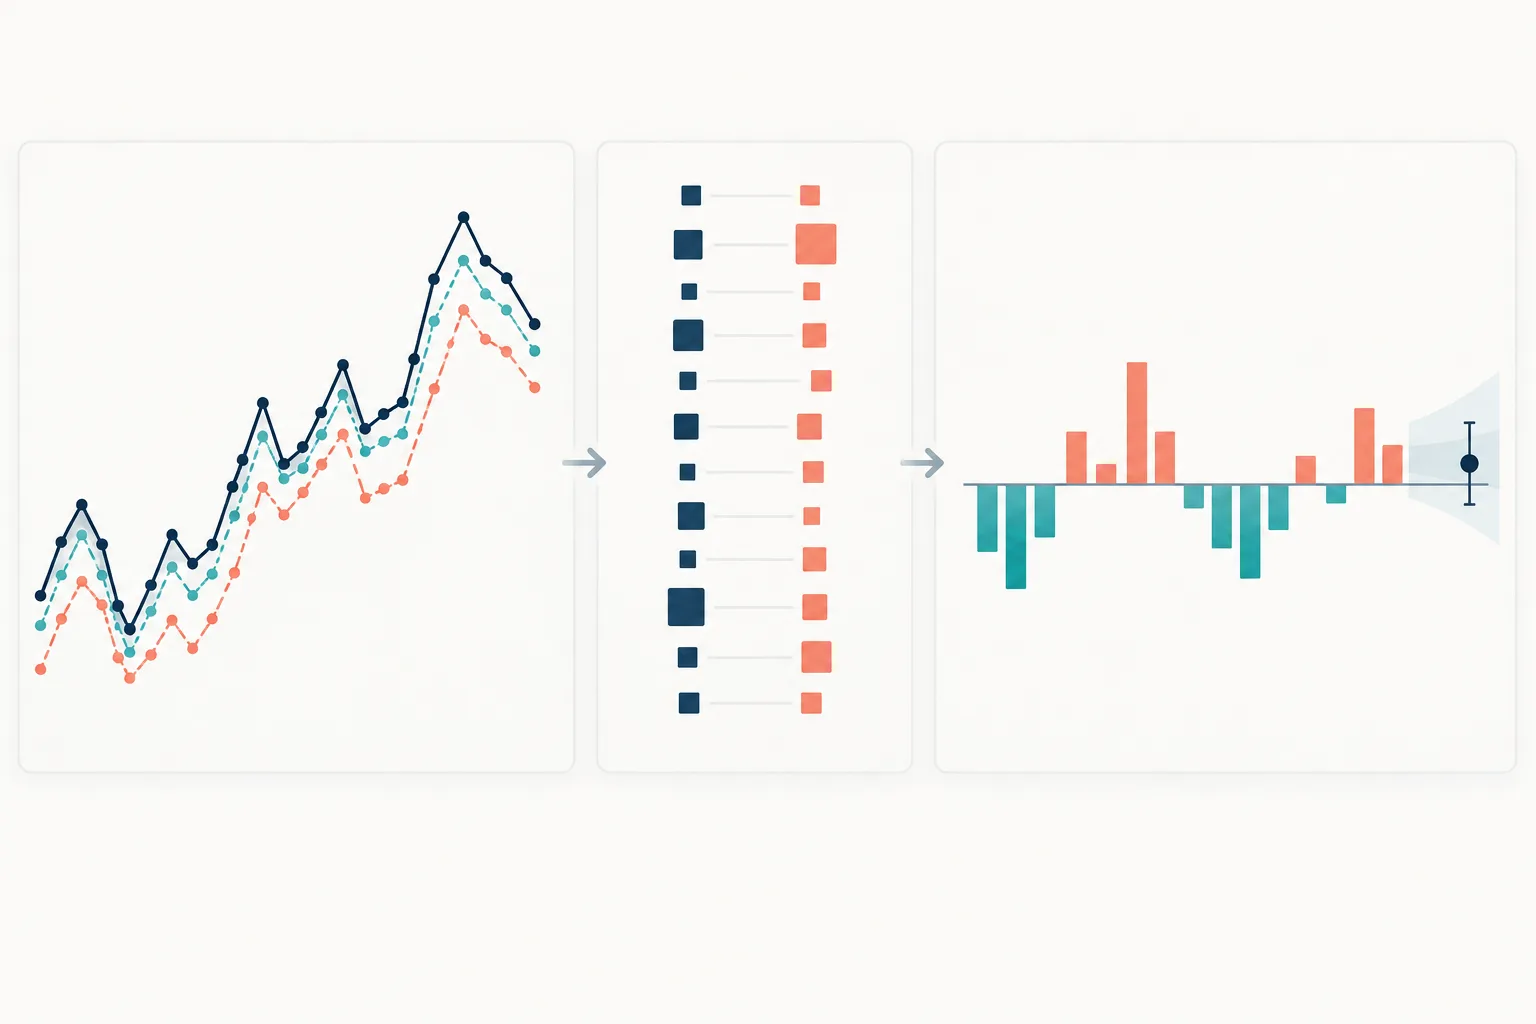
ওভারল্যাপ করা সময়সীমা ক্ষতি-পার্থক্যকে নির্ভরশীল করে
প্রতিদিন পাঁচ দিন পরের পূর্বাভাস দিলে পাশাপাশি দুটি পূর্বাভাস তাদের পাঁচটি লক্ষ্য-দিনের মধ্যে চারটি ভাগ করে। ফলে ত্রুটি, ক্ষতি এবং ক্ষতি-পার্থক্য একসঙ্গে চলতে পারে। 100টি দৈনিক পূর্বাভাস-শুরুকে 100টি স্বাধীন তুলনা ধরলে অনিশ্চয়তা কম করে ধরা হতে পারে এবং পরিসংখ্যানটি প্রকৃতের চেয়ে বড় দেখাতে পারে।
দীর্ঘমেয়াদি ভ্যারিয়েন্স dₜ-এর ধারাবাহিক কোভ্যারিয়েন্স বিবেচনায় নেয়। হেটেরোস্কেডাস্টিসিটি ও অটোকরিলেশনের প্রতি সঙ্গতিপূর্ণ (HAC) একটি প্রচলিত অনুমানের রূপ:
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
এখানে γ̂ₖ হলো k ল্যাগে নমুনা অটোকোভ্যারিয়েন্স, wₖ হলো কার্নেল ওজন, এবং m নির্বাচিত ব্যান্ডউইথ। Newey ও West (1987) ধনাত্মক সেমিডেফিনিট HAC কোভ্যারিয়েন্স অনুমান দেন। প্রাসঙ্গিক অনুমানের অধীনে আদর্শ h-ধাপ পূর্বাভাস ত্রুটিতে ওভারল্যাপ প্রায়ই অন্তত h − 1 ল্যাগ পর্যন্ত নির্ভরতা তৈরি করে; সে ক্ষেত্রে মূল DM কাঠামো একটি ট্রাঙ্কেটেড অনুমান আলোচনা করে। বাস্তব ডেটায় স্থায়ী লক্ষ্য, রোলিং অনুমান বা কৌশল নির্মাণের কারণে নির্ভরতা আরও দীর্ঘ হতে পারে, তাই h − 1 ব্যান্ডউইথ বাছাইয়ের সর্বজনীন নিয়ম নয়।
সময়সীমা, কার্নেল, ব্যান্ডউইথ এবং ছোট-নমুনার কোনো সংশোধন জানিয়ে দিন। পছন্দের p-value পাওয়ার জন্য ব্যান্ডউইথ বেছে না নিয়ে যুক্তিসঙ্গত নির্ভরতা-সেটিংয়ে সিদ্ধান্ত বদলায় কি না দেখান। ওভারল্যাপ এড়াতে পূর্বাভাস-শুরুর সময় যথেষ্ট দূরে রাখলে তা বলুন এবং এতে কোন তথ্য বা নমুনার আকার কমেছে তা ব্যাখ্যা করুন। নির্ভরতা-সচেতন অনিশ্চয়তা পরীক্ষা-প্রক্রিয়ার অংশ, শুধু প্রদর্শনের ঐচ্ছিক সেটিং নয়।
নেস্টেড মডেল ও সময়ে বদলানো পূর্বাভাস দক্ষতার জন্য ভিন্ন প্রশ্ন দরকার
সমান-নির্ভুলতার শূন্য অনুমানের অধীনে পূর্বাভাস দুটি নেস্টেড না হলে সাধারণ DM তুলনা ব্যাখ্যা করা সহজ। বড় মডেলে ছোট বেসলাইন মডেলটি থাকলে অতিরিক্ত অনুমিত সহগগুলো প্রকৃত মান শূন্য হলেও পূর্বাভাসে শব্দ যোগ করতে পারে। এই শূন্য অনুমানে গড় বর্গ-পূর্বাভাস ত্রুটির সাধারণ পার্থক্যের বণ্টন অপ্রমিত হতে পারে। নেস্টেড মডেলের নমুনার-বাইরের MSPE তুলনায় Clark–West সমন্বয়ের মতো পদ্ধতি অনুমান-ত্রুটির এই প্রভাব বিবেচনা করে; প্রতিটি মডেল নকশায় এটি DM-এর সাধারণ বিকল্প নয়। Clark ও West (2007) দেখুন।
সাধারণ DM শূন্য অনুমান মূল্যায়ন নমুনার পুরো সময়ে গড়, শর্তহীন ক্ষতি নিয়ে। এটি সময়ের পরিবর্তন আড়াল করতে পারে: শান্ত সময়ে A এবং অস্থির সময়ে B ভালো করলেও সামগ্রিক গড় কাছাকাছি হতে পারে। পূর্বাভাসের তারিখে জানা তথ্যের ওপর আপেক্ষিক নির্ভুলতা নির্ভর করে কি না জানতে শর্তাধীন পূর্বাভাস-ক্ষমতার পরীক্ষা আগে থেকে নির্ধারিত উপকরণের সঙ্গে ক্ষতি-পার্থক্য ব্যবহার করে। Giacomini ও White (2006) এমন কাঠামো তৈরি করেন। এর অনুমান ও মূল্যায়ন-উইন্ডোর নকশা গুরুত্বপূর্ণ; ফল দেখার পর ইচ্ছেমতো সূচক যোগ করা বৈধ শর্টকাট নয়।
পরীক্ষার পছন্দ তুলনার কাঠামো অনুসরণ করা উচিত: স্বাধীন পূর্বাভাস, নেস্টেড মডেল, বদলানো শর্তাধীন দক্ষতা অথবা অনেক প্রার্থীর মধ্য থেকে বেছে নেওয়া পরিবার—এগুলো একে অন্যের বদলি নয়। শেষ ক্ষেত্রে, White Reality Check ও Hansen SPA নির্দেশিকা বহু ট্রেডিং নিয়মে অনুসন্ধানের পর পরিবার-স্তরের সংশোধন ব্যাখ্যা করে।
পূর্বাভাসের ক্ষতি কম হলেই লাভজনক কৌশল প্রমাণিত হয় না
একটি পূর্বাভাস পরিসংখ্যানগতভাবে বেশি নির্ভুল হলেও নিট ট্রেডিং ফল উন্নত নাও করতে পারে। কৌশলকে পূর্বাভাস থেকে পজিশন নির্ধারণ করতে হয়, কখন ট্রেড হবে ঠিক করতে হয় এবং স্প্রেড, কমিশন, স্লিপেজ, বাজার-প্রভাব, ফান্ডিং, ধার-খরচ ও ঝুঁকি-সীমা সামলাতে হয়। রিটার্নের গড় বর্গ-ত্রুটিতে সামান্য উন্নতি কোনো কার্যকর সিদ্ধান্তে প্রভাব না-ও ফেলতে পারে; আবার গড় ত্রুটি একটু বেশি এমন মডেল নির্দিষ্ট নিয়মে গুরুত্বপূর্ণ লেজ-ঘটনা ভালোভাবে ধরতে পারে।
পূর্বাভাস মূল্যায়ন ও পোর্টফোলিও মূল্যায়নকে আলাদা ধাপ রাখুন। প্রথমে ঘোষিত পূর্বাভাস-কাজের সঙ্গে মেলে এমন লক্ষ্য ও ক্ষতির বিপরীতে পূর্বাভাস পরীক্ষা করুন। এরপর পূর্বাভাস বাছাইয়ে ব্যবহার করা হয়নি এমন ডেটায় সম্পূর্ণ নির্দিষ্ট ট্রেডিং নিয়ম মূল্যায়ন করুন এবং বাস্তবসম্মত সম্পাদন ও অর্থায়নের অনুমান ব্যবহার করুন। পূর্বাভাস পরীক্ষার p-value ব্যাকটেস্ট রিটার্ন, Sharpe ratio বা ভবিষ্যৎ লাভের সম্ভাবনা নয়।
বারবার মডেল, লক্ষ্য, সময়সীমা, ক্ষতি ফাংশন ও নমুনা-উইন্ডো চেষ্টা করলে প্রতিটি DM হিসাব সঠিক হলেও বাছাই-পক্ষপাত তৈরি হয়। পুরো অনুসন্ধান নথিভুক্ত করুন এবং প্রশ্ন যদি হয় বহু প্রার্থীর মধ্যে কোনোটি টিকে কি না, তবে পরিবার-স্তরের পদ্ধতি ব্যবহার করুন। ব্লক-বুটস্ট্র্যাপ নির্দেশিকা আগে থেকে নির্বাচিত পরিসংখ্যানের জন্য নির্ভরতা-সংরক্ষণকারী অনিশ্চয়তা নিয়ে আলোচনা করে; এটি একা অপ্রকাশিত মডেল-অনুসন্ধানের সংশোধন করে না।
অন্য গবেষক যেন বিশ্লেষণ পুনরুৎপাদন করতে পারেন, সে জন্য যথেষ্ট তথ্য দিন
দুটি পূর্বাভাস মডেলের নাম, বেসলাইনের সঙ্গে সম্পর্ক, লক্ষ্য, সময়সীমা, পূর্বাভাস-শুরুর সময়সূচি, মূল্যায়নের তারিখ, তথ্য-সেট, ডেটার সংস্করণ এবং সাধারণ নমুনার নিয়ম জানান। ক্ষতি ফাংশন গাণিতিকভাবে সংজ্ঞায়িত করুন এবং ধনাত্মক dₜ A না B—কাকে সমর্থন করে তা বলুন। n, দুই মডেলের গড় ক্ষতি, d̄, দীর্ঘমেয়াদি ভ্যারিয়েন্সের অনুমান, HAC কার্নেল ও ব্যান্ডউইথ, ছোট-নমুনার সংশোধন, রেফারেন্স বণ্টন, পরীক্ষার দিক এবং p-value রিপোর্ট করুন।
মডেল নেস্টেড কি না, প্যারামিটার কীভাবে অনুমান করা হয়েছে, ফল দেখার আগে না পরে তুলনাটি বেছে নেওয়া হয়েছে এবং অন্য কোন রূপভেদ চেষ্টা করা হয়েছে—তাও জানান। মডেল নির্বাচনে নমুনা ব্যবহার করা হলে পরীক্ষাটিকে অক্ষত নমুনার-বাইরের প্রমাণ না বলে সেই নির্বাচনের অংশ হিসেবে চিহ্নিত করুন। স্পষ্ট প্রতিবেদন পাঠককে দেখায় পরীক্ষাটি ঠিক কী তুলনা করছে এবং কোন অনিশ্চয়তা বা বাছাই-সমস্যা এর বাইরে রয়ে গেছে।
সাধারণ প্রশ্ন
Q1Diebold–Mariano পরীক্ষা কি স্বাভাবিক-বণ্টিত পূর্বাভাস-ত্রুটি ধরে নেয়?
না। কাঠামোটি অ-স্বাভাবিক পূর্বাভাস-ত্রুটি সামলাতে পারে। তবু ক্ষতি-পার্থক্যের যথাযথ ভ্যারিয়েন্স অনুমান এবং রেফারেন্স বণ্টনের জন্য নিয়মিততার শর্ত দরকার।
Q2ভিন্ন সময়সীমার পূর্বাভাস দেয় এমন দুটি মডেল কি তুলনা করতে পারি?
সমমানের পূর্বাভাস-নির্ভুলতার তুলনা হিসেবে নয়। আগে লক্ষ্য ও সময়সীমা মিলিয়ে নিন; তা না হলে মডেল দুটি ভিন্ন পূর্বাভাস-প্রশ্নের উত্তর দেয়।
Q3তাৎপর্যপূর্ণ DM ফল কি ট্রেডিং মডেল বেছে নেওয়ার জন্য যথেষ্ট?
না। এটি নির্দিষ্ট তুলনায় প্রত্যাশিত পূর্বাভাস-ক্ষতি সম্পর্কে প্রমাণ। মডেল-অনুসন্ধান, সিদ্ধান্তের নিয়ম, সম্পাদন ও অর্থায়নের খরচ এবং নমুনার-বাইরের কৌশল-ফলও বিবেচনা করতে হবে। মূল গবেষণা - Diebold ও Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne ও Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini ও White, “Tests of Conditional Predictive Ability” (2006) - Clark ও West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey ও West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
dₜ = L(eA,ₜ) − L(eB,ₜ) হলে, ধনাত্মক নমুনা গড় কোনটিকে সমর্থন করে?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন