

Zmienność zrealizowana metodą pre-averaging: estymator odporny na szum mikrostrukturalny
Dowiedz się, jak pre-averaging wygładza krótkie okna stóp zwrotu wysokiej częstotliwości, koryguje główny wpływ szumu, dobiera długość okna i różni się od TSRV oraz realized kernels.
W tym przewodnikuDlaczego bardzo częste stopy zwrotu mogą zniekształcać pomiar zmian cen
Krótkie podsumowanie
Pre-averaging służy do szacowania zmian cen, gdy bardzo często rejestrowane ceny zawierają szum mikrostrukturalny. Zamiast podnosić do kwadratu każdą surową stopę zwrotu, metoda tworzy nakładające się, ważone sumy sąsiednich stóp zwrotu, podnosi je do kwadratu, a następnie odejmuje składnik odpowiadający głównemu wpływowi szumu. Wynik zależy od kształtu wag, długości okna, schematu próbkowania i założeń dotyczących szumu. Mierzy zmienność w zaobserwowanym przedziale; nie jest prognozą zmienności ani sygnałem transakcyjnym.
Dlaczego bardzo częste stopy zwrotu mogą zniekształcać pomiar zmian cen
Gdyby cena obserwowana była dokładnie ceną efektywną, suma kwadratów śróddziennych stóp zwrotu byłaby naturalnym sposobem szacowania zmienności podczas sesji. Rzeczywiste ceny transakcyjne i kwotowania mogą jednak odzwierciedlać odbijanie się ceny między ofertą kupna i sprzedaży, zaokrąglenia do wielkości ticka, opóźnienia, dyskretność cen lub sposób rejestracji. Przy bardzo krótkim odstępie próbkowania te zjawiska mogą stanowić dużą część każdego kwadratu stopy zwrotu. Dodanie obserwacji może więc zwiększyć udział szumu zamiast jedynie ujawnić więcej ruchu ceny ukrytej.
Pre-averaging rozwiązuje ten problem przez łączenie stóp zwrotu w krótkim lokalnym oknie przed podniesieniem ich do kwadratu. Gładka funkcja wag zaczyna się od zera, przypisuje wagi sąsiednim stopom zwrotu i wraca do zera na końcu okna. Ważona suma działa jak lokalny filtr: szybkie, niezależne błędy obserwacji mogą się częściowo znosić, a szerszy ruch ceny efektywnej może pozostać. Nakładające się okna pozwalają wykorzystać informacje z całego przedziału.
Samo wygładzanie nie czyni estymatora nieobciążonym. Kwadraty przefiltrowanych stóp zwrotu nadal zawierają zmienność wynikającą z szumu, dlatego potrzebny jest składnik korygujący. Jacod, Li, Mykland, Podolskij i Vetter wyprowadzają metodę pre-averaging do szacowania wariancji całkowej przy jawnych założeniach i pokazują, że odpowiednie wersje osiągają tempo zbieżności \(n^{-1/4}\). Ich oryginalny artykuł stanowi podstawę metody; ten przewodnik omawia jej mechanikę, wybory i ograniczenia.
Rozróżnij cenę ukrytą, obserwowaną i wielkość docelową
Niech \(X_{t_i}\) oznacza ukryty efektywny logarytm ceny w chwili obserwacji \(t_i\), a \(Y_{t_i}\) zarejestrowany logarytm ceny:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
gdzie \(\epsilon_{t_i}\) to szum obserwacji. Typowy model bazowy traktuje \(X_t\) jako ciągły semimartyngał z lokalnym tempem wariancji \(\sigma_t^2\). Celem w ustalonym przedziale \([0,T]\) jest wariancja całkowa:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Obserwowana stopa zwrotu ma postać \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Nawet jeśli błędy cen są niezależne między obserwacjami, dwie sąsiednie stopy zwrotu współdzielą błąd jednego punktu końcowego z przeciwnymi znakami. Powoduje to zależność szeregową stóp zwrotu i sprawia, że wariancja zrealizowana obliczona ze wszystkich obserwacji zależy od liczby zaszumionych różnic.
Proste wyjaśnienie teoretyczne zazwyczaj zakłada szum o średniej zero, niezależny w czasie i od procesu ceny efektywnej, oraz odpowiednie skończone momenty. Ułatwia to zrozumienie korekty, ale założenia te nie są gwarantowane dla transakcji, kwotowań ani cen środkowych. Szum może zmieniać się wraz z płynnością i porą dnia, być powiązany z ceną efektywną lub wykazywać zależność szeregową. Trzeba też określić cel: przy skokach wariacja kwadratowa zawiera ich kwadraty, natomiast ciągła wariancja całkowa ich nie zawiera.
Jest to pomiar ex post dla określonej serii cen i przedziału czasu. Nie odtwarza każdej ceny ukrytej, nie wskazuje pojedynczej błędnej transakcji i nie mówi, jaka będzie przyszła zmienność. Przed porównaniem oszacowań określ, czy dane wejściowe to ceny transakcyjne, środki kwotowań czy inna konstrukcja ceny.
Twórz nakładające się stopy zwrotu po wstępnym uśrednieniu
Dla \(n\) zaobserwowanych stóp zwrotu \(r_i=Y_{t_i}-Y_{t_{i-1}}\) wybierz całkowitą długość okna \(k_n\) oraz funkcję wag \(g\) na \([0,1]\). Typowa stopa zwrotu po wstępnym uśrednieniu jest zdefiniowana jako
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Funkcja jest zwykle ciągła, równa zero na obu końcach i dostatecznie gładka dla wyników asymptotycznych. Przykładem trójkątnym jest \(g(u)=\min(u,1-u)\). Ponieważ wagi na końcach okna wynoszą zero, stopa zwrotu na brzegu nie otrzymuje nagle pełnej wagi. To lokalny kształt wag, a nie prognoza czy dopasowany trend.
Każde \(\bar r_i\) łączy sąsiednie stopy zwrotu przed podniesieniem do kwadratu. Ponieważ okna się nakładają, stopy zwrotu po wstępnym uśrednieniu są skorelowane nawet wtedy, gdy surowe stopy nie są. Ta zależność jest częścią zachowania estymatora w próbie, dlatego wielu sum okiennych nie należy traktować jak niezależnych obserwacji. Zakres indeksów i konwencja brzegowa muszą odpowiadać normalizacji wag.
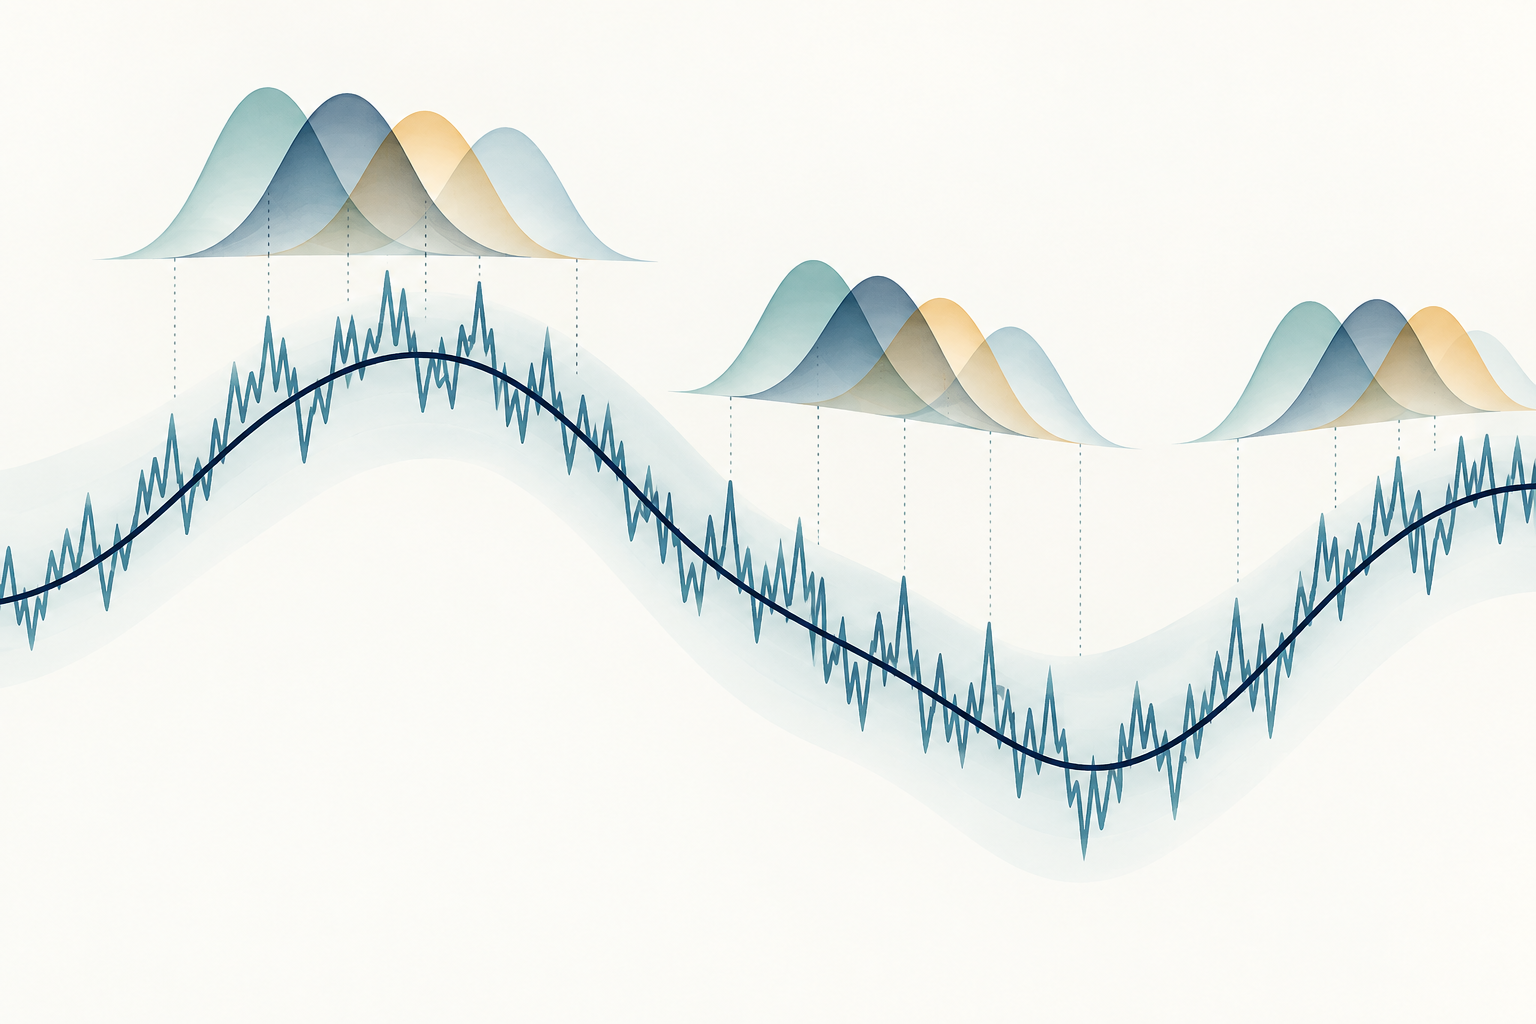
Ilustracja pokazuje gładką ukrytą ścieżkę ceny, poszarpaną ścieżkę obserwowaną oraz kilka nakładających się okien z wagami wygasającymi przy brzegach. Wyjaśnia lokalne łączenie danych; nie jest zapisem cen ani empirycznym wynikiem filtra.
<!-- learn:illustration --> <!-- Koncepcja bez tekstu: gładka ukryta ścieżka ceny obok poszarpanej ścieżki obserwowanej oraz nakładające się, wygasające okna lokalne łączące sąsiednie ruchy. Wyłącznie ilustracja koncepcyjna, nie dane rynkowe, prognoza ani sygnał transakcyjny. -->
Koryguj pozostały wpływ szumu
Pre-averaging ogranicza wpływ szybkich błędów obserwacji, ale kwadraty przefiltrowanych stóp zwrotu nadal zawierają wkład szumu. Typowa postać jednowymiarowego estymatora na regularnej siatce, z asymptotycznymi stałymi normalizacyjnymi, wygląda następująco:
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
gdzie stałe wagowe wynoszą
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
Pierwszy składnik przeskalowuje sumę kwadratów stóp zwrotu po wstępnym uśrednieniu, aby odpowiadała wariancji całkowej. Drugi, w ramach modelu, szacuje i odejmuje główny wkład szumu obserwacyjnego. Nie szacuje każdej realizacji szumu i nie naprawia błędnego pola ceny, znacznika czasu ani wartości odstającej. Wzór dla skończonej próby może używać dyskretnych wersji \(\psi_1,\psi_2\), korekt brzegowych i określonej konwencji indeksowania stóp zwrotu. Należy te szczegóły opisać i stosować konsekwentnie.
Korekta może dać małe lub ujemne oszacowanie w skończonej próbie. Nie oznacza to, że aktywo miało ujemną wariancję fizyczną; oznacza, że w tej próbie wybrana korekta przewyższyła pierwszy składnik. Nie zamieniaj po cichu ujemnego oszacowania na zero. Podaj surowy wynik i ewentualną odrębną regułę obcinania, ponieważ obcinanie zmienia estymator i może wpływać na późniejsze średnie lub wnioskowanie.
Dobierz długość okna do szumu i próby
\(k_n\) kontroluje stopień wygładzania. Jeśli okno jest zbyt krótkie, w przefiltrowanych stopach zwrotu pozostaje więcej szumu wysokiej częstotliwości. Jeśli jest zbyt długie, lokalne ruchy ceny są uśredniane w szerszym czasie i uczestniczy mniej okien, co może zwiększać inne błędy estymacji. Długość okna i funkcja wag działają wspólnie; bez kształtu wag i odstępu próbkowania sama wartość \(k_n\) niewiele mówi.
W klasycznym zrównoważonym schemacie, przy stałym horyzoncie czasu i coraz częstszych \(n\) obserwacjach, długość okna rośnie rzędu \(\sqrt n\), często zapisuje się \(k_n\sim\theta\sqrt n\), gdzie \(\theta\) jest dodatnią stałą strojenia. Przy założeniach z artykułu estymator może zbiegać z szybkością \(n^{1/4}\), czyli z błędem estymacji rzędu \(n^{-1/4}\). Jest to wolniej niż bezszumowe tempo \(n^{1/2}\) i jest tempem optymalnym w bazowym zaszumionym otoczeniu analizowanym przez autorów; nie stanowi gwarancji dla każdego zbioru danych rynkowych.
\(\theta\), funkcja wag i metoda wyboru oparta na danych wpływają na obciążenie i wariancję w skończonej próbie. Automatyczny wybór może zależeć od oszacowań szumu i zmienności, które same są niepewne. Pokaż wrażliwość dla kilku uzasadnionych długości okna, wyjaśnij zegar próbkowania i granice sesji, a okna nie wybieraj dopiero po sprawdzeniu, która wartość wspiera pożądany wniosek.
Mały przykład hipotetyczny
Załóżmy sześć hipotetycznych obserwowanych stóp zwrotu w punktach bazowych:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Używamy wag trójkątnych \(g(u)=\min(u,1-u)\) oraz celowo krótkiego okna \(k=3\). Dwie wewnętrzne wagi siatki wynoszą \(g(1/3)=g(2/3)=1/3\). Aby dokładnie pokazać rachunek na tej małej siatce, definiujemy dyskretne stałe normalizacyjne:
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Przy powyższej konwencji indeksowania istnieje \(n-k+2=5\) nakładających się okien. Każde łączy sąsiednią stopę zwrotu równą \(1\) bp ze stopą równą \(0\) bp, więc \(\bar r_i=(1/3)(1+0)=1/3\) bp, a zatem
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Po zastosowaniu odpowiadającej normalizacji dyskretnej otrzymujemy
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Przykład pozwala sprawdzić rachunek i jednostki; sześć stóp zwrotu i tak krótkie okno nie wystarczają do uzasadnienia przybliżenia asymptotycznego. Wartości dobrano dla przejrzystości. Nie są to dane rynkowe, symulacja procesu szumu ani dowód odzyskania ukrytej wariancji całkowej. Nie obliczamy błędu standardowego ani prognozy.
Poznaj założenia i ich ograniczenia
Standardowe wyprowadzenie zakłada ciągły proces ceny efektywnej obserwowany często z addytywnym szumem oraz spełnienie określonych warunków regularności. Niezależny szum o średniej zero jest użytecznym punktem wyjścia, ale zależność między szumem a ceną, szeregowo skorelowane błędy, zmienny w czasie szum, nieregularne chwile obserwacji lub endogeniczne próbkowanie mogą wymagać zmodyfikowanego estymatora albo teorii dla takiej sytuacji. Aït-Sahalia, Mykland i Zhang badają estymację wariancji całkowej przy zależnym szumie mikrostrukturalnym. Ich praca pokazuje, dlaczego wzoru dla niezależnego szumu nie należy traktować jako uniwersalnego.
Skoki stawiają odrębne pytanie o wielkość docelową. Wariancja kwadratowa obejmuje kwadraty skoków, a ciągła wariancja całkowa nie. Zwykły estymator pre-averaging nie oddziela automatycznie skoków. Odporne na skoki obcinanie lub inna konstrukcja wymaga osobnych założeń i parametrów strojenia. Duża błędna transakcja może też wpływać na kilka nakładających się okien, więc weryfikacja danych i obsługa wartości odstających pozostają konieczne.
Pre-averaging samo w sobie nie rozwiązuje też wszystkich problemów danych wielowymiarowych i asynchronicznych. Christensen, Kinnebrock i Podolskij opracowują metody kowariancji oparte na pre-averaging oraz odporną na szum rozszerzoną metodę Hayashi–Yoshida dla niesynchronicznych obserwacji w swojej pracy. Te konstrukcje uwzględniają dodatkowe kwestie schematu próbkowania. Zastosowanie wzoru jednowymiarowego osobno do każdego aktywa nie synchronizuje automatycznie znaczników czasu i nie gwarantuje poprawnej macierzy kowariancji.
Odróżnij pre-averaging od TSRV i realized kernels
Te estymatory dotyczą powiązanych problemów zmienności wysokiej częstotliwości, ale inaczej organizują informacje. Two-scale realized volatility, czyli TSRV, uśrednia wariancje zrealizowane na przesuniętych, rzadkich siatkach próbkowania, a następnie odejmuje przeskalowane oszacowanie z gęstej siatki, aby skorygować główne obciążenie szumem. Pre-averaging najpierw filtruje krótkie, nakładające się okna stóp zwrotu gładkimi wagami, podnosi przefiltrowane stopy do kwadratu i stosuje pasującą korektę. Oryginalny artykuł o dwóch skalach opisuje tę odrębną konstrukcję.
Realized kernel zaczyna się od sumy kwadratów stóp zwrotu i dodaje ważone autokowariancje stóp dla wielu opóźnień. Pasmo określa najdalsze uwzględnione opóźnienie. Pre-averaging zmienia natomiast lokalne stopy przed podniesieniem ich do kwadratu. Obie metody używają wag i parametrów strojenia, ale ich wzorów, normalizacji ani założeń nie można stosować zamiennie. Przewodnik po realized kernels wyjaśnia konstrukcję opartą na opóźnieniach i wybór pasma.
Metodę dobieraj do danych i potrzebnej wielkości, a nie do nazwy estymatora. Porównaj schemat próbkowania, model szumu, obsługę brzegów, cel przy skokach i zachowanie w skończonej próbie. Asymptotyczna odporność na szum nie gwarantuje, że metoda będzie najlepsza dla mało płynnych aktywów, krótkiej sesji, zmiennego szumu czy nieregularnego strumienia danych. Przewodnik TSRV wyjaśnia jego wybór skali i korekty.
Raportuj pomiar przedziału, nie wniosek transakcyjny
Aby wynik dało się odtworzyć, podaj aktywo i pole ceny, przedział czasu, częstotliwość próbkowania, reguły znaczników czasu i sesji, jednostki stóp zwrotu, funkcję wag, długość okna, normalizację, konwencję brzegową i założenia o szumie. Jeśli estymator służy do wnioskowania, podaj także estymator wariancji lub procedurę przedziału ufności oraz wymagane założenia. Tabela wrażliwości dla uzasadnionych długości okna pokaże, czy wniosek zależy od jednego ustawienia.
Wariancja całkowa mierzy zakończony przedział obserwacji. Jej pierwiastek wyraża skalę zmienności dla tego samego przedziału, ale nie tworzy prognozy. Annualizacja wymaga jawnej konwencji czasowej i również nie jest prognozą. Prognozowanie późniejszego horyzontu wymaga osobnego modelu predykcyjnego i oceny poza próbą. Przewodnik obliczania zmienności zrealizowanej wyjaśnia benchmark oparty na kwadratach stóp zwrotu, a przewodnik wariacji kwadratowej odróżnia zmienność ścieżki od celu w postaci ciągłej wariancji całkowej.
Estymator nie dowodzi, dlaczego cena się zmieniła, nie wskazuje zyskownej strategii ani nie gwarantuje pomiaru ryzyka realizacji zlecenia. Koszty transakcyjne, płynność, skoki, dynamika zmienności i niepewność estymacji pozostają odrębnymi zagadnieniami. Pre-averaging jest narzędziem pomiaru statystycznego, a jego użyteczność zależy od dopasowania jawnych założeń do obserwowanych danych.
Częste pytania
Q1Czy pre-averaging jest tym samym co średnia ruchoma cen?
Nie. Estymator tworzy ważone sumy sąsiednich stóp zwrotu, a następnie podnosi je do kwadratu i koryguje. Uśrednianie poziomów cen i późniejsze obliczanie różnic to inna transformacja o innych wagach i zachowaniu na brzegach.
Q2Czy pre-averaging usuwa cały szum mikrostrukturalny?
Nie. Ogranicza główny wpływ przy określonych założeniach dotyczących szumu i próbkowania. Zależny lub zmienny szum, skoki, wartości odstające i problemy ze znacznikami czasu nadal mogą wpływać na wynik.
Q3Dlaczego oszacowania pre-averaging mogą się różnić?
Mogą różnić się funkcją wag, długością okna, normalizacją dla skończonej próby, polem ceny, regułami brzegowymi lub czyszczeniem danych. Należy raportować te wybory i sprawdzać wrażliwość.
Q4Czy oszacowanie pre-averaging jest prognozą zmienności?
Samo w sobie nie. Mierzy zmienność przedziału użytego do obliczeń. Prognoza późniejszego okresu wymaga osobnego modelu i oceny poza próbą.
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Jaki jest główny cel tworzenia stóp zwrotu po pre-averaging?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie
Słownik opcji
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Czytaj szczegółowy przewodnikQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Czytaj szczegółowy przewodnik