

すべてのオプションガイド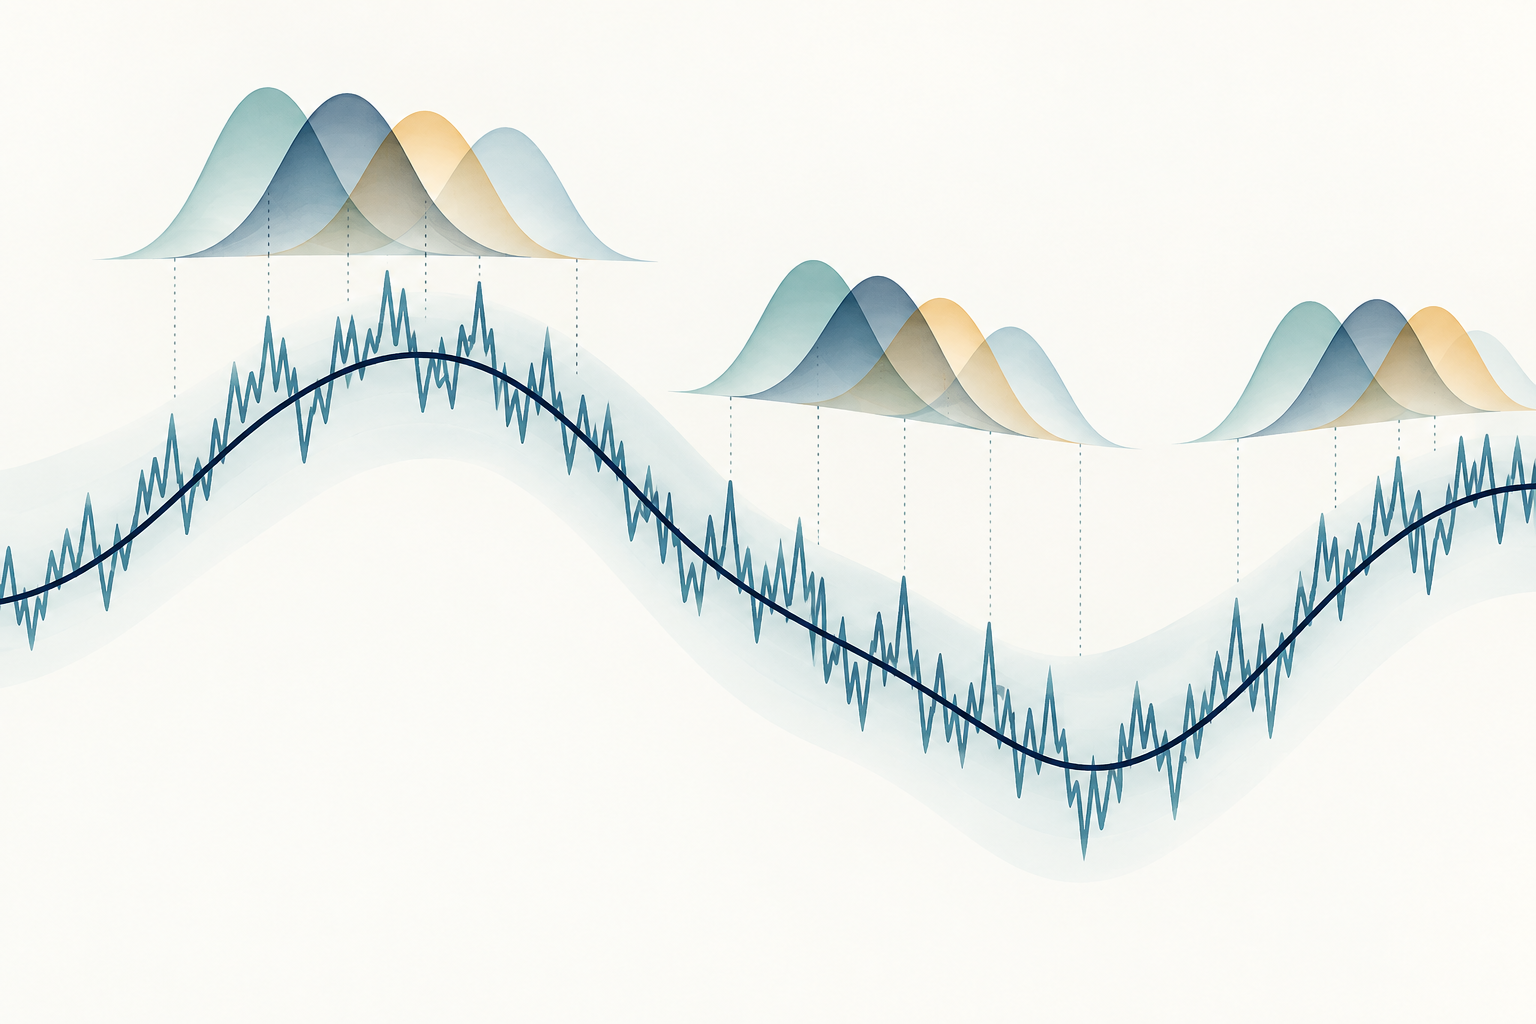
市場マイクロ構造ノイズを含むリターンの事前平均化を示す概念図です。市場データ、予測、売買シグナルではありません。 問題 1 / 3
高頻度価格に含まれる市場マイクロ構造ノイズを考慮した実現ボラティリティの推定16分
事前平均化による実現ボラティリティ:市場マイクロ構造ノイズへの推定法
事前平均化が高頻度リターンの短い窓を平滑化し、ノイズの主要な偏りを補正する仕組み、窓幅の選び方、TSRVや実現カーネルとの違いを解説します。
このガイドの内容高頻度リターンが価格変動を誤って測ることがある理由
短い要約
事前平均化(pre-averaging)は、非常に高い頻度で記録された価格に市場マイクロ構造ノイズが含まれる場合に、価格変動を推定する方法です。生のリターンを一つずつ二乗するのではなく、近接するリターンの重み付き和を重なり合う窓で作り、その二乗値からノイズの主要な寄与を表す項を差し引きます。結果は重みの形、窓幅、サンプリング設計、ノイズの仮定に左右されます。観測区間の変動を測るものであり、ボラティリティ予測や売買シグナルではありません。
高頻度リターンが価格変動を誤って測ることがある理由
観測価格が効率価格そのものなら、日中リターンの二乗和はセッション中の変動を測る自然な方法です。しかし、実際の約定価格や気配値には、買値と売値の間の反転、呼値単位への丸め、遅延、価格の離散性、記録方法の影響が含まれることがあります。サンプリング間隔が極端に短いと、こうした要因が各二乗リターンの大きな部分を占める場合があります。そのため、観測を増やしても潜在価格の動きを詳しく捉えるだけではなく、ノイズの寄与も増える可能性があります。
事前平均化では、二乗する前に短い局所窓の中でリターンを組み合わせます。滑らかな重み関数は窓の始点でゼロから始まり、近くのリターンに重みを付け、窓の終点で再びゼロになります。この加重和は局所フィルターとして働き、速く変動する独立な観測誤差は一部相殺される一方、効率価格のより広い動きは残り得ます。窓を重ねることで、区間全体の情報を利用できます。
潜在価格、観測価格、推定対象を区別する
観測時刻 \(t_i\) における潜在的な効率対数価格を \(X_{t_i}\)、記録された対数価格を \(Y_{t_i}\) とします。
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
ここで \(\epsilon_{t_i}\) は観測ノイズです。よく使われる基本モデルでは、\(X_t\) は局所分散率 \(\sigma_t^2\) を持つ連続半マルチンゲールとします。固定区間 \([0,T]\) における推定対象は積分分散です。
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
観測リターンは \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\) と分解できます。価格誤差が観測間で独立でも、隣り合う二つのリターンは端点の誤差を反対の符号で共有します。そのためリターンに時系列依存が生じ、全観測を使う実現分散はノイズを含む差分の数に敏感になります。
簡単な理論説明では、平均ゼロで、時間方向にも効率価格過程とも独立し、適切な有限モーメントを持つノイズを仮定することが多くあります。この仮定は補正の理由を理解するのに便利ですが、取引価格、気配値、仲値が満たすとは限りません。ノイズは流動性や時刻によって変わり、効率価格と関連したり、時系列相関を持ったりすることがあります。推定対象も明確にしてください。ジャンプがある場合、二次変動にはジャンプの二乗が含まれますが、連続成分の積分分散には含まれません。
これは特定の価格系列と時間区間を対象とする事後的な測定です。各時点の潜在価格を復元したり、個別の誤った約定を特定したり、将来のボラティリティを示したりするものではありません。推定値を比較する際は、取引価格、気配値の仲値、その他どの価格系列を使ったかを明記します。
重なり合う事前平均化リターンを作る
\(n\) 個の観測リターン \(r_i=Y_{t_i}-Y_{t_{i-1}}\) に対し、整数の窓幅 \(k_n\) と、\([0,1]\) 上の重み関数 \(g\) を選びます。よく使われる事前平均化リターンは次のとおりです。
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
重み関数は通常連続で、両端ではゼロになり、漸近結果に必要な滑らかさを満たします。三角形の例は \(g(u)=\min(u,1-u)\) です。窓の両端で重みがゼロなので、端に位置するリターンが突然最大の重みを受けることはありません。これは局所的な重みの形であり、予測や推定トレンドではありません。
各 \(\bar r_i\) は隣り合うリターンを二乗前にまとめます。窓が重なり合うため、生のリターンが独立でも事前平均化リターンは相関します。この依存性は推定量の標本分布に含まれるため、多数の窓和を独立観測として扱ってはいけません。インデックスの範囲と端点の規約も、重みの正規化に合わせる必要があります。
図は滑らかな潜在価格経路、その周囲でぎざぎざと変動する観測経路、端で重みが弱まる複数の重なり合う窓を示します。局所的な集約を説明する図であり、価格データや実証的なフィルター出力ではありません。
<!-- learn:illustration --> <!-- 文字のない概念図:滑らかな潜在価格経路とぎざぎざした観測経路、その近くの動きをまとめる重なり合ったテーパー付き局所窓。概念説明用であり、市場データ、予測、売買シグナルではありません。 -->
残るノイズの寄与を補正する
事前平均化は速い観測誤差の影響を弱めますが、フィルター後のリターンの二乗にはノイズの寄与が残ります。等間隔グリッドで漸近正規化定数を使う一変量推定量の一般的な形は次のとおりです。
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
重みに関する定数は
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du \]
です。第1項は事前平均化したリターンの二乗和を積分分散に対応するスケールへ調整します。第2項はモデルのもとで観測ノイズの主要な寄与を推定して差し引きます。これはノイズの個々の実現値を推定する項ではなく、誤った価格フィールド、タイムスタンプの誤り、外れ値を直すものでもありません。実際の有限標本式では \(\psi_1,\psi_2\) の離散版や端点調整、リターンのインデックス規約が使われることがあります。詳細を記録し、一貫して適用してください。
補正後の推定値は有限標本で小さく、または負になることがあります。資産の物理的な分散が負だったという意味ではなく、その標本では選んだ補正項が第1項を上回ったということです。負の推定値を説明なくゼロに置き換えてはいけません。元の計算値と、別途適用する切り詰め規則があればそれを報告してください。切り詰めは推定量を変え、その後の平均や推論に影響し得ます。
ノイズと標本に合わせて窓幅を選ぶ
\(k_n\) は平滑化の程度を制御します。窓が短すぎると、フィルター後のリターンに高頻度ノイズが多く残ります。長すぎると局所的な価格変動をより広い時間幅で平均し、寄与する窓の数が減るため、別の種類の推定誤差が大きくなり得ます。窓幅と重み関数は一緒に働くため、重みの形とサンプリング間隔なしに \(k_n\) の値だけを解釈することはできません。
固定された時間幅の中で観測数 \(n\) を増やす古典的なバランス設計では、窓幅は \(\sqrt n\) のオーダーで増え、正の調整定数 \(\theta\) を用いて \(k_n\sim\theta\sqrt n\) と書くことがよくあります。論文の仮定のもとでは、推定量の収束率は \(n^{1/4}\)、すなわち推定誤差は \(n^{-1/4}\) のオーダーになり得ます。ノイズがない場合の \(n^{1/2}\) より遅く、著者が検討した基本的なノイズ環境では最適な率ですが、すべての市場データに対する保証ではありません。
\(\theta\)、重み関数、データに基づく選択法は有限標本でのバイアスと分散に影響します。自動選択はノイズやボラティリティの推定値に依存する場合があり、それらにも不確実性があります。妥当な範囲の窓幅に対する感度を示し、サンプリング時計や取引セッションの境界を説明してください。望ましい結論を支持する値が分かってから窓幅を選んではいけません。
小さな仮想計算例
ベーシスポイント単位の、仮想的な観測リターンを6個考えます。
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
三角形重み \(g(u)=\min(u,1-u)\) と、意図的に短くした窓 \(k=3\) を使います。グリッド上の内側の重みは \(g(1/3)=g(2/3)=1/3\) です。この小さなグリッドで計算を明示するため、離散正規化定数を
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3} \]
と定義します。
先ほどのインデックス規約では、重なり合う窓は \(n-k+2=5\) 個です。どの窓も隣り合う \(1\) bp と \(0\) bp のリターンをまとめるので、\(\bar r_i=(1/3)(1+0)=1/3\) bp です。したがって、
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
対応する離散正規化を使うと、
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2 \]
になります。この例は計算と単位の確認用です。リターン6個、窓幅3という小ささでは漸近近似を裏付けられません。数値は計算を明確にするために構成したもので、市場データでも、ノイズ過程のシミュレーションでも、潜在的な積分分散を回復した証拠でもありません。標準誤差や予測値も計算していません。
仮定と、仮定が崩れる場合を理解する
標準的な導出は、連続的な効率価格過程、加法的なノイズ、高頻度の観測、および一定の正則条件を前提にしています。平均ゼロで独立なノイズは出発点として有用ですが、ノイズと価格の依存、系列相関のある誤差、時間変化するノイズ、不規則な観測時刻、内生的なサンプリングには、修正版の推定量やその状況に合わせた理論が必要になる場合があります。Aït-Sahalia、Mykland、Zhangは、依存する市場マイクロ構造ノイズ下での積分ボラティリティ推定を研究しています。この研究は、独立ノイズの式を普遍的なものと見なさない理由を示します。
ジャンプがある場合は、推定対象について別の判断が必要です。二次変動にはジャンプの二乗が含まれますが、連続成分の積分分散には含まれません。一般的な事前平均化推定量がジャンプを自動的に分離するわけではありません。ジャンプに頑健な切り詰めなどを使うなら、別途その仮定と調整値を説明します。大きな異常約定は重なり合う複数の窓に影響するため、データ検証と外れ値処理も必要です。
事前平均化だけで多変量データや非同期データの問題がすべて解決するわけでもありません。Christensen、Kinnebrock、Podolskijは、非同期観測に対する事前平均化共分散法と、ノイズに頑健なHayashi–Yoshida拡張を研究で提案しています。これらは標本設計上の追加課題に対応します。各資産に一変量の式を個別に適用しても、タイムスタンプが自動的に同期するわけではなく、有効な共分散行列が保証されるわけでもありません。
事前平均化をTSRVや実現カーネルと区別する
これらの推定量は関連する高頻度変動の問題を扱いますが、情報の使い方は異なります。Two-scale realized volatility(TSRV)は、ずらした疎なサンプリンググリッドで計算した実現分散を平均し、主要なノイズバイアスを補正するため、細かいグリッドの推定値を一定倍率で差し引きます。一方、事前平均化は短く重なり合うリターン窓を滑らかな重みでフィルターし、フィルター後のリターンを二乗して、それに対応する補正を適用します。二つの時間尺度に関する原論文は別のTSRV構成を説明しています。
実現カーネルはリターン二乗和から出発し、複数ラグにわたるリターン自己共分散を重み付きで加えます。バンド幅が含める最大ラグを決めます。事前平均化は二乗する前に局所リターンを変換します。どちらも重みや調整値を使いますが、式、正規化、仮定を相互に置き換えることはできません。ラグに基づく構成とバンド幅については実現カーネルのガイドを参照してください。
手法の名前ではなく、データと必要な推定対象に合わせて選びます。サンプリング設計、ノイズモデル、端点処理、ジャンプを含む目標、有限標本での挙動を比較してください。漸近的にノイズに頑健でも、流動性の低い資産、短いセッション、変化するノイズ、不規則なデータフィードに最適とは限りません。TSRVのガイドでは、その尺度と補正の選択を説明しています。
区間の測定値を報告し、売買の結論と切り分ける
結果を再現できるように、資産と価格フィールド、時間区間、サンプリング頻度、タイムスタンプとセッションの規則、リターンの単位、重み関数、窓幅、正規化、端点の規約、ノイズの仮定を記載します。推定量を推論に使う場合は、分散推定量または信頼区間の手順と、その前提も示してください。妥当な複数の窓幅に対する感度表があれば、結論が一つの調整値に依存するかを確認できます。
積分分散は、観測が完了した区間を測ります。平方根を取ると同じ区間のボラティリティ尺度になりますが、予測には変わりません。年率換算には明示的な時間規約が必要で、年率換算だけで予測になるわけでもありません。将来区間の予測には、別の予測モデルとアウト・オブ・サンプル評価が必要です。実現ボラティリティの計算ガイドは二乗リターンの基本指標を、二次変動のガイドは経路変動と連続的な積分分散の違いを説明します。
この推定量は価格が動いた理由を証明せず、利益の出る戦略を特定せず、実行可能なリスク測定を保証もしません。取引コスト、流動性、ジャンプ、ボラティリティの動学、推定の不確実性は別の問題です。事前平均化は統計的な測定手段であり、その有用性は明示した仮定が観測データにどの程度合うかに左右されます。
よくある質問
Q1事前平均化は価格に移動平均をかけることと同じですか?
いいえ。この推定量は近接するリターンの加重和を作り、それを二乗して補正します。価格水準を平均してから差分を取る方法は、重みや境界での挙動が異なる別の変換です。
Q2事前平均化ですべての市場マイクロ構造ノイズが除去されますか?
いいえ。明示されたノイズとサンプリングの仮定のもとで、主要な影響を弱めます。依存または変化するノイズ、ジャンプ、外れ値、タイムスタンプの問題は結果に影響し得ます。
Q3事前平均化の推定値が異なるのはなぜですか?
重み関数、窓幅、有限標本正規化、価格フィールド、端点規則、データクリーニングが異なる可能性があります。これらの選択を報告し、感度を調べてください。
Q4事前平均化の推定値はボラティリティ予測ですか?
それだけでは違います。計算対象の区間における変動を測ります。後の期間を予測するには、別のモデルとアウト・オブ・サンプル評価が必要です。
出典
問題を報告
この記事のリンクを含むメールを準備します。送信すると Mark に報告が届きます
クイックチェック
記事を読み終えたら、3問で確認しましょう
問題 01
事前平均化リターンを作る主な目的は何ですか?
答えを選ぶと解説を確認できます
オプション用語集
関連ガイド
高頻度の観測価格にノイズがある状況で価格変動を推定する実現カーネル推定量:市場マイクロ構造ノイズ下でボラティリティを測る実現カーネルがリターンの自己共分散に重みを付け、高頻度価格の変動を推定する仕組みを、Parzenカーネルの例、帯域幅の選び方、実務上の限界とともに解説します。高頻度価格にノイズが含まれるときの積分分散の推定Two-Scale Realized Volatility(TSRV):市場ミクロ構造ノイズ下での分散推定細かい価格グリッドと間引いたグリッドを組み合わせるTSRVの仕組みを、計算例、仮定、限界とともに解説しますボラティリティ測定実現ボラティリティの計算:リターン・期間・年率化実現ボラティリティの式、対数リターンと平均・年率化規則、標本選択がIVとの比較を変える理由を解説します経路の二次変化二次変動:確率経路とボラティリティの接点微小な増分の二乗和がなぜ残り、Itô補正を生み、拡散ボラティリティと実現分散を結ぶのかを解説します高頻度リターンに含まれる連続的な価格変動とまれなジャンプを分けるバイパワー変動:ジャンプに頑健な実現ボラティリティを解説実現バイパワー変動が隣接する絶対リターンから連続的な積分分散を推定する仕組み、RVとBVの差がジャンプ変動を測り得る条件、有限標本と市場マイクロ構造ノイズの影響を解説します。