

すべてのオプションガイド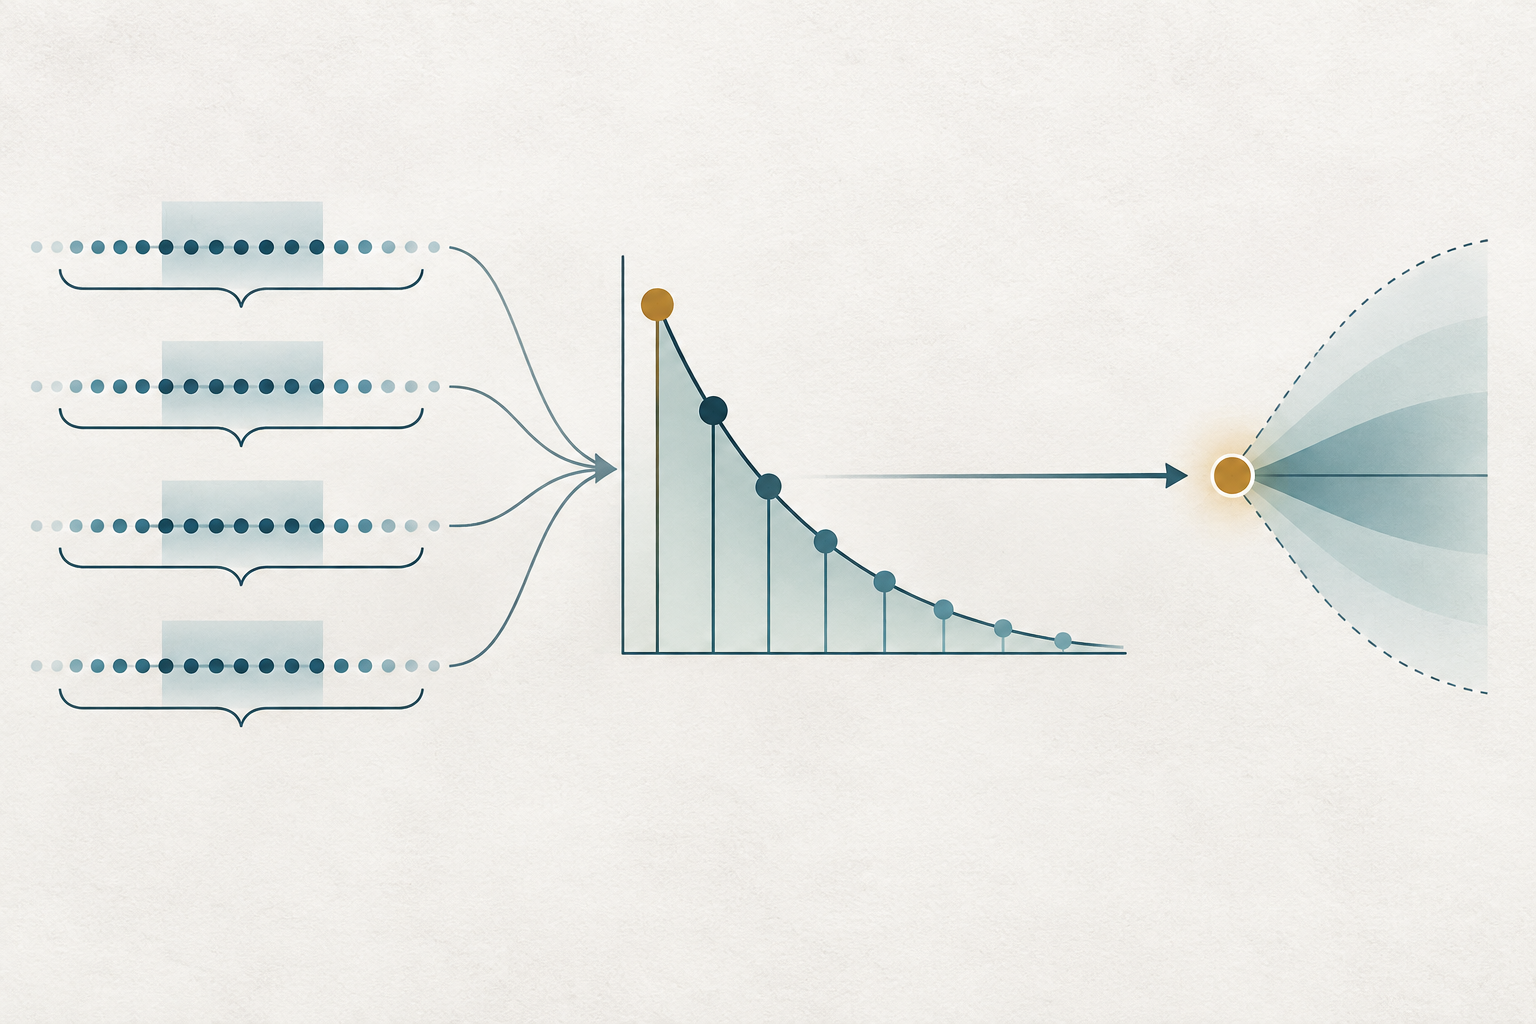
異なる頻度の入力、ラグの重み、低頻度の予測を示す概念図であり、実測データではありません 問題 1 / 3
混合頻度の計量経済学13分
MIDAS回帰とは:混合頻度データとボラティリティ予測
MIDAS回帰が日次と週次の金融データを簡潔なラグ重みで結び付ける仕組み、ボラティリティ予測の作り方、混合頻度モデルの注意点を解説します。
このガイドの内容MIDASは観測頻度のずれに対応する
短い要約
MIDAS(mixed data sampling)回帰は、すべての系列を同じカレンダーに無理にそろえず、異なる頻度で記録された観測値を結び付けます。少数の推定パラメータで高頻度データの過去に重みを付け、低頻度の金融指標を予測できます。この重みが示すのは選んだモデルのもとでの予測パターンであり、因果関係やトレード上の優位性を証明するものではありません。
MIDASは観測頻度のずれに対応する
金融・経済データが同じタイミングで得られるとは限りません。ボラティリティの目的変数は週次で測る一方、候補となる説明変数は日次リターンや日中の実現指標ということがあります。マクロ経済系列は四半期ごとでも、資産価格は取引日ごとに観測されます。通常の回帰では目的変数と説明変数が同じ観測ごとに一行ずつ並ぶため、よく知られたモデルを推定する前に異なるカレンダーの扱いを決める必要があります。
一つの方法は、日次入力を週次の平均や合計に集約することです。簡単ですが、各日に特定の重みを課し、週のどの時点で値が動いたかを失うことがあります。四半期の値を日次の行に繰り返し入力したり、補間したりする方法もあります。繰り返しは、ゆっくり変化する値を大量の新しい観測値のように見せる可能性があります。補間は実際には観測されていない滑らかな経路を作ることがあります。どちらも新しい情報を生みません。
MIDASは頻度を直接結び付ける方法です。目的変数は本来の低い頻度のままにして、高頻度系列の構造化されたラグを含めます。MIDASという名称は混合データサンプリングを指し、特定のボラティリティモデルを指すわけではありません。研究ではボラティリティ予測のほか、結果より細かい間隔で測定された説明変数を使う場面でもMIDAS回帰が使われます。中心となる問いは、直近の高頻度データをどれだけ使い、重みをどう制約するかです。
重み付きラグで多くの観測値を簡潔な予測変数にまとめる
\(y_{t+1}\)を低頻度の目的変数とし、たとえば第\(t+1\)週が終わってから観測される翌週の実現分散とします。\(x_{t-j}\)は、週\(t\)の終わりを予測起点としたとき、そこから\(j\)取引セッション前に観測された日次説明変数です。単純なMIDAS回帰は\(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\)です。ここで\(K\)は日次ラグ数、\(w_j(\theta)\)は少数のパラメータで決まる重み、\(u_{t+1}\)は予測誤差です。
重みは通常、\(\sum_{j=1}^{K}w_j(\theta)=1\)となるように正規化します。これにより加重和を重み付きの履歴として読みやすくし、\(b\)はその要約と目的変数の関係の強さを表します。正規化しても、日次観測値が独立になったり、同じ情報量になったりするわけではありません。ラグの形を表すための便利なパラメータ化です。
説明変数 \(x\) には日次の二乗リターン、絶対リターン、日中リターンから作った実現分散の指標、または予測起点で利用可能な別の変数を選べます。目的変数 \(y\) は将来の週次分散、月次のマクロ経済発表、その他の低頻度指標でも構いません。係数の意味は目的変数の定義によって決まります。実現分散の代理変数を使うモデルが、潜在的な瞬時分散、オプションのインプライド分散、価格リターンまで自動的にモデル化するわけではありません。
MIDASは回帰の枠組みであり、万能の推定量ではありません。応答変数は水準、対数、リンク関数を使ってモデル化でき、推定結果は選択した重みの関数形や誤差の仮定に左右されます。非負の分散代理変数を線形回帰すると、目的変数を変換したり予測値に制約を設けたりしない限り、負の当てはめ値が出ることがあります。モデルの扱いやすさは、目的変数の値域や単位を確認する必要をなくしません。
重み関数は柔軟性と安定性を両立させる
制約のない分布ラグ回帰では、\(K\)個の日次入力それぞれに別の係数を推定します。週次の目的変数の観測数に対して\(K\)が大きいと、推定値が不安定になり、強く相関することがあります。MIDASでは低次元の関数でラグ係数を定義します。例として、指数Almon型のプロファイルは\(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\)です。正規化したBeta多項式プロファイルもよく使われます。
こうしたプロファイルは直近のセッションに大きな重みを付けたり、徐々に減衰させたり、ラグ期間の中ほどを相対的に重くしたりできます。パラメータが表すのは選択した滑らかな曲線であり、各日の重要性を無条件に示すものではありません。データが短期的な反応を示しても、選んだ関数が長く滑らかな尾を強制すれば、推定係数にはその制約が反映されます。一方、日ごとの係数を自由に多く推定すると、安定した動きではなくノイズに当てはまることがあります。
重みの制約はモデルの仮定です。非負で正規化された重みは、分散予測を加重平均として解釈しやすくしますが、正負のラグ効果が相殺する形は除外します。柔軟なプロファイルは山型や傾きの変化を許せますが、形状パラメータが多すぎると識別が弱くなることがあります。妥当な少数の形を比較し、利用可能なラグを明記したうえで、重み関数を変えたとき予測が大きく変わるか確認してください。
すべてに当てはまる\(K\)はありません。長い期間は持続的な情報を捉えられる一方で、パラメータを増やしたり、より長い形を強いたりします。短い期間では緩やかな動きを取り逃すことがあります。ラグ数は推定期間で利用できる情報から選び、将来の評価対象を使わずに検証してください。標本内の当てはまりが良くても、ラグ期間が再現性のあるパターンを捉えたとは限りません。
各データが利用可能になった時点に予測起点を合わせる
頻度のラベルだけでは適切な予測設計になりません。目的変数が次の5取引セッションの分散で、予測を金曜日の取引終了後に出すとします。その金曜日までに確定した日次データは説明変数に使えますが、翌週のリターンから計算した実現分散は使えません。目的変数が公表される週次・月次統計なら、対象期間の終了後に発表されることもあります。バックテストでは、当時実際に利用できた値を使い、後から改定・公表された値を使わないでください。
推定前に予測起点の表を作成します。予測を出す時刻、各説明変数で許される最新の時刻、目的期間、目的変数が観測可能になる時刻を記録します。金融リターンについては、終値間リターンに夜間の時間帯を含むか、どの市場セッションを1日とするか、祝日や欠損バーで日次ラグ数がどう変わるかを明示してください。5取引セッションと暦上の7日間は異なる期間です。
公表カレンダーには不ぞろいな端が生じます。ある日に日次の説明変数は新しい値があっても、月次系列はまだ公表されていないことがあります。モデルが予測起点で既知の古い情報として扱うなら、直近の公表済み月次値を持ち越す方法は有効です。まだ公表されていない観測値を後日の公表値で埋めるのは不適切です。過去データの改定は、現在のデータベースに当時の予測者が見られなかった改定済みマクロ系列が含まれるという、より見つけにくい先読み問題を起こすことがあります。
市場の取引時間がずれている場合も整合性の問題が生じます。日次の株式終値と暗号資産終値は異なるUTCの区間を表すことがあります。日中ボラティリティの推定に予測時刻より後に確定したバーが含まれることもあります。タイムゾーン変換、夏時間の変更、取引所の休場、バーの作成方法はいずれも情報集合の一部です。同じ日付の行が同じ情報締切を共有すると決めつけず、処理方法を明記してください。
仮想例で日次入力から週次予測を作る
目的変数を翌週の実現分散とし、予測は金曜日の終値で出すとします。モデルは直前に終わった週の実現分散を日次で5つ使います。新しい順の推定重みは\(0.40, 0.25, 0.16, 0.11, 0.08\)で、合計は1です。対応する日次入力はリターンの二乗単位で\(0.0004, 0.0001, 0.0009, 0.0004, 0.0001\)です。
重み付きの履歴は\(0.40(0.0004)+0.25(0.0001)+0.16(0.0009)+0.11(0.0004)+0.08(0.0001)=0.000381\)です。この仮想的な当てはめモデルの切片を\(a=0.00012\)、傾きを\(b=0.80\)とすると、翌週の分散予測は\(0.00012+0.80(0.000381)=0.0004248\)です。標準偏差で示す場合は平方根がおよそ\(0.02061\)、選んだ目的変数の定義では対象週に\(2.06\%\)です。
この計算は、日次の説明変数を将来の週次目的変数に結び付ける方法を示しています。値と推定係数は架空です。挙げた日のいずれかが翌週の分散を引き起こした、あるいは資産価格が上昇・下落するという意味ではありません。直近セッションの重みは、標本と制約を前提に、指定した予測モデルが観測値をどう組み合わせるかを表します。因果反応の推定値ではありません。
この例からは単位の問題も分かります。日次と週次の実現分散はいずれもリターンの分散ですが、集計期間が異なります。傾き \(b\)、切片、目的変数の構成はその期間の定義に合わせて推定されます。日次入力をそのまま週次分散と呼び替えることはできません。目的変数が週次分散の対数なら、モデルの出力は対数単位となり、条件付き対数平均を指数変換しても一般には条件付き分散の平均になりません。水準に戻す場合は予測対象を明確にし、必要に応じて逆変換の補正を加えます。
推定方法は目的変数とラグ制約で決まる
重みベクトルが固定なら、回帰は切片と傾きについて線形です。重みが未知の非線形パラメータ\(\theta\)に依存する場合、非線形最小二乗法や関連する尤度ベースの方法がよく使われます。重みの形状パラメータと回帰係数を同時に探索するか、候補ごとに線形係数をプロファイルアウトします。初期値、パラメータの境界、収束基準、局所最適解の数が重要になることがあるため、収束失敗や境界解を隠すべきではありません。
\(y\)が非負のボラティリティ指標なら、通常の線形仕様は特に標本外で負の予測値を出すことがあります。水準予測が非負になる制約、正のリンク関数、目的変数の対数をモデル化する方法などがあります。選択によって推定対象と予測の解釈が変わります。対数目的変数モデルで条件付き対数分散の平均を予測しても、条件付き分散の平均が自動的に得られるわけではありません。誤差分布と逆変換が関係します。
標本の不確実性は目的変数の作り方にも左右されます。日中リターンから作った週次実現分散には測定誤差があり、マイクロストラクチャーノイズ、サンプリング間隔、ジャンプ、欠損値に敏感なことがあります。週次の目的期間が重なると、隣接する予測起点の誤差が同じリターンを共有します。その場合、予測誤差の独立性を仮定した標準誤差や比較は適切でないことがあります。予測期間と誤差の依存構造に合った推論を使い、目的変数の測定方法を報告してください。
パラメータの安定性も課題です。推定された重みの形は推定標本全体の平均です。市場構造が変われば、どの現行レジームにもよく合わないことがあります。拡大型と移動窓型の推定は別の問いに答えます。前者は履歴を多く使いますが古い動きを残し、後者は早く適応する代わりに観測数が少なく推定ノイズが大きくなります。更新ルールを事前に定め、時系列順の評価で固定ベンチマークと比較してください。
MIDASはGARCH-MIDASに関連するが同じではない
MIDASとは、異なる頻度でサンプリングされた観測値を重み付きラグで結び付ける方法です。MIDAS回帰は過去の日次・日中指標から将来の実現ボラティリティを直接予測できます。GARCHモデルにある1期先の条件付き分散の再帰式を必ず含むわけではありません。
GARCH-MIDASは別のモデル群で、低頻度の変数で動くことが多い緩やかな長期ボラティリティ成分と、再帰的に変化する短期の条件付き分散成分を組み合わせます。2つの成分はそれぞれ異なるパラメータ化と仮定を持ちます。論文やソフトウェアがGARCH-MIDASと呼ぶモデルは、具体的な式を確認してください。MIDAS重みが長期成分を決め、GARCH再帰式が短期ショックを扱うことがあります。名称だけでは目的変数、潜在ボラティリティか実現ボラティリティか、正値性の制約方法は分かりません。
初期の金融MIDAS研究は、簡潔な予測枠組みで異なる説明変数、頻度、ラグ長を比較しています。その後の方法論研究は、従来の時間集計との比較を含め、混合頻度回帰モデルの推定・検定特性を検討しています。こうした研究が裏付けるのは仕組みであり、MIDASが常にGARCHを上回る、あるいは高頻度の説明変数が必ず予測を改善するという主張ではありません。結果は資産、標本、目的変数、説明変数、予測期間、評価設計によって異なります。
モデルは問いに合わせて選びます。日次履歴から将来の実現ボラティリティ指標を予測するなら、直接的なMIDAS回帰が候補になります。条件付き分散を再帰的にモデル化するなら、適切なGARCH仕様と比較します。四半期のマクロ発表と日次の金融目的変数を組み合わせる場合、発表時点ごとのデータ版を管理する必要があるかもしれません。似た名前のモデルでも答える問いは異なるため、成績を比べる前に予測起点、目的変数の定義、情報集合をそろえてください。
測定誤差と選択が重み関数を上回ることがある
高頻度データは時間の細かさを増やす一方、測定ノイズも増やすことがあります。短すぎるバーにはビッド・アスクの往復、価格の離散性、古い気配、非同期取引、配信エラーが含まれます。間隔を短くして二乗リターンを足し続けても、実現分散の推定が良くなるとは限りません。予測成績を見る前にサンプリング間隔とクリーニング規則を決め、妥当な代替案への感度を調べてください。
学べる量を制約するのは、日次説明変数の行数が多く見えることではなく、低頻度の結果の数です。週次の目的変数と組み合わせた10年分の日次入力でも、欠損や評価用期間を除く前で週次の結果はおよそ500件です。滑らかな重み関数は日ごとの自由なラグ係数を減らしますが、標本が短い、説明変数の持続性が高い、候補ラグが重複している場合は形状の識別が弱くなります。
複数の高頻度指標、ラグ長、重みの形、変換、銘柄、予測期間、評価損失を試し、最良の結果だけを報告すると選択バイアスが生じます。同じ目的変数がパラメータとモデル選択の両方に使われるため、標本内の当てはまりは特に影響を受けます。試したモデルの範囲を記録し、主指標を決め、後の時系列ホールドアウトか選択を考慮した比較を使ってください。同じ日付の予測を多数比べる場合は、依存性と多重性を考慮し、各結果を独立した確認として扱わないでください。
推定された重み曲線は因果的な説明ではありません。高頻度入力がニュース、流動性、市場活動の代理になっている可能性があり、観測されない要因が説明変数と将来のボラティリティの両方を動かすことがあります。予測の有用性には安定したタイミングと標本外の証拠が必要です。因果的に解釈するには、MIDASのラグ式を超える別の識別設計と仮定が要ります。
予測だけでは利益の出る取引判断にならない
ボラティリティ予測はリスク予算、ヘッジ量、シナリオの範囲に役立ちますが、リターンの符号やポジションの方向は示しません。週次標準偏差の予測\(2.06\%\)は、約束された値動き、最大損失、オプションのインプライド・ボラティリティではありません。推定モデルと標本のもとで選んだばらつきの指標についての予測であり、実現リターンは大幅に上回ることも下回ることもあります。
戦略を調べるなら、シグナル時刻、注文時刻、商品、エクスポージャー規則、手仕舞いを検証前に決めます。各過去の予測起点で、その時点で利用できた情報だけを使ってMIDASパラメータを再推定してください。事前に定めたベンチマークと目的変数に合った損失で予測を評価し、その後スプレッド、手数料、資金調達料、借入、マーケットインパクト、売買回転を差し引いたリターンを別にシミュレーションします。分散予測が統計的に改善しても、コスト控除後のリターンが改善するとは限りません。
目的変数とそのサンプリング方法、説明変数の定義と単位、低頻度と高頻度、予測起点、ラグ数、重み関数と制約、推定期間と更新日程、欠損値とデータ版の扱い、損失関数、ベンチマーク、時系列順のテスト日を報告してください。ラグ形状の選択で結果が大きく変わるなら、予測の不確実性や感度も示します。関連する基礎は実現ボラティリティ、ボラティリティ・クラスタリングとGARCH、予測精度の比較で確認できます。
主な一次資料は、Ghysels、Santa-Clara、ValkanovによるMIDASボラティリティ予測の研究、Ghysels、Sinko、Valkanovによる方法論のレビューと拡張、Andreou、Ghysels、Kourtellosによる混合頻度回帰モデルの分析です。実証結果は各研究の標本と設計に限られ、現在の市場や別の資産クラスでの成績を保証しません。
よくある質問
Q1MIDASはすべてのデータを一つの頻度に平均するという意味ですか?
いいえ。MIDAS回帰は目的変数を選んだ頻度のままにし、高頻度の説明変数に構造化された重み付きラグを使います。すべての系列を共通の行単位のカレンダーに補間する必要はありません。
Q2MIDAS回帰とGARCH-MIDASは同じですか?
いいえ。MIDASは混合頻度の重み付きラグの枠組みです。GARCH-MIDASはMIDAS型の長期成分と短期のGARCH分散再帰を組み合わせます。目的変数や成分はモデルの式で確認してください。
Q3MIDASのボラティリティ予測が改善すれば売買シグナルにできますか?
それだけではできません。ボラティリティ予測が表すのは選んだばらつきの指標です。戦略には別に定めた方向またはリスクのルール、現実的な執行コスト、時系列順のコスト控除後評価が必要です。
出典
問題を報告
この記事のリンクを含むメールを準備します。送信すると Mark に報告が届きます
クイックチェック
記事を読み終えたら、3問で確認しましょう
問題 01
MIDASの重み関数の主な役割は何ですか?
答えを選ぶと解説を確認できます
オプション用語集
関連ガイド
ボラティリティの動学ボラティリティ・クラスタリングとGARCH静かな相場と荒い相場が続く理由、GARCHが条件付き分散を更新する仕組み、予測をオプションへ使う際の限界を解説しますボラティリティ測定実現ボラティリティの計算:リターン・期間・年率化実現ボラティリティの式、対数リターンと平均・年率化規則、標本選択がIVとの比較を変える理由を解説します予測精度の評価Diebold–Mariano検定:2つの予測精度を比較する方法Diebold–Mariano検定によるペア予測損失の比較、重複する予測期間の扱い、低いp値が売買スキルの証明にならない理由を解説します。二変数が一緒に動いても原因を特定できない理由金融における相関関係と因果関係統計的関連と因果効果を区別し、交絡、逆因果、選択、介入、Granger因果性、非定常性、見せかけの回帰、金融の研究設計を学びます一つの回帰係数が実際に比較するものOLS回帰係数と仮定最小二乗目的、条件付き係数、残差、外生性、多重共線性、等分散性を整理し、金融回帰を適切に解釈する基準を説明します