

すべてのオプションガイド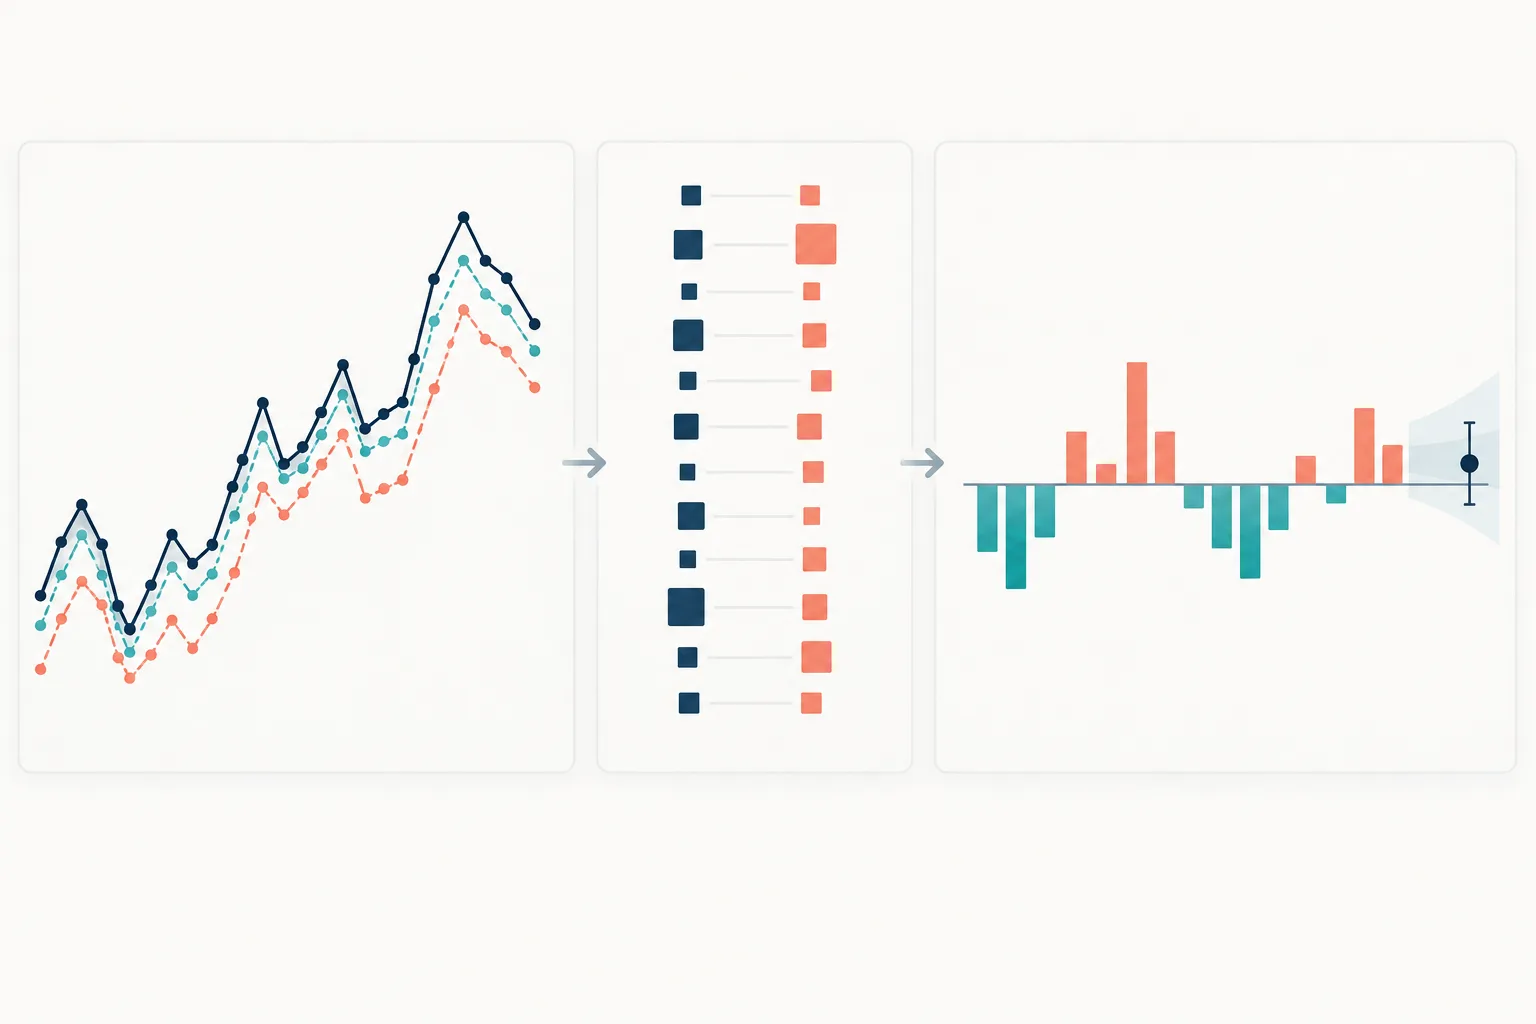
同じ実現経路に対する2つの予測と、ペアになった損失差のまとめ方を示す概念図です。市場データや実証検定の結果ではありません。 問題 1 / 3
予測精度の評価読了約14分
Diebold–Mariano検定:2つの予測精度を比較する方法
Diebold–Mariano検定によるペア予測損失の比較、重複する予測期間の扱い、低いp値が売買スキルの証明にならない理由を解説します。
このガイドの内容バックテスト誤差が小さくても、予測の優位性はまだ示されません
短い要約
Diebold–Mariano検定は、同じ実現値に対する2つの予測の損失差を調べて精度を比較します。結果は損失関数、評価標本、予測期間、不確実性の推定方法に左右されます。標本内の誤差が小さいだけで期待精度が高いとは限らず、予測精度の向上も収益性のある売買戦略を意味しません。
バックテスト誤差が小さくても、予測の優位性はまだ示されません
2つのモデルが同じ日付について、同じリターン、ボラティリティ、経済指標などを予測するとします。評価標本ではモデルAの平均誤差がモデルBより小さいかもしれません。これは標本内で観測された差を表しますが、Aの精度が安定して高いのか、たまたま検証対象になった日付による通常の変動なのかは分かりません。
Diebold–Mariano(DM)検定は、この比較をペアになった時系列として扱います。各予測起点で2つの予測を同じ実現値と照合し、事前に決めた損失関数で採点したうえで、損失差の系列を調べます。ペアにすることが重要です。市場が大きく動いた日は両モデルの損失が増えることがありますが、この比較は同じ日の損失でどちらが小さくなりやすいかを問います。
原論文の枠組みは二乗誤差や正規分布の予測誤差に限定されません。予測したい内容と整合するなら、非対称なものを含む複数の損失関数を比較できます。ただし、評価設計に根拠があり、平均損失差の不確実性を推定する必要があります。DieboldとMariano(1995)は予測精度が等しいかを検定する枠組みを示し、Harvey、Leybourne、Newbold(1997)00719-4)は小標本向けの修正を検討しています。
統計量を計算する前に比較条件をそろえます
各行は比較可能な1つの予測起点を表すようにします。2つのモデルは同じ目的変数と予測期間を対象にし、それぞれの起点で利用できた情報だけから予測する必要があります。損失を比較する前に実現値、時刻、通貨や単位、データの版、欠測値の扱いをそろえます。一方が翌日の終値、もう一方が5日間の平均を予測しているなら、誤差は別の問いに答えています。
将来情報を参照していない予測を使います。時系列順のホールドアウトやローリング方式の疑似標本外評価は有効ですが、同じホールドアウトを使って特徴量、閾値、モデル候補を何度も調整した場合、分割だけでは十分ではありません。各過去時点で実際に作成された予測と、それに使ったデータおよびモデルの版を保存します。改訂後のマクロデータ、生存者バイアスを除くフィルター、将来の企業行動に基づく修正値を使うと、評価が事後的に変わる可能性があります。
2つのモデルは同じ予測起点の集合で評価します。一方のモデルだけ難しい日を除外すると、ペア比較が崩れます。予測が欠けている場合は共通標本を定めるか、欠測の扱いに根拠を示します。モデルごとに異なる市場局面を比較する状態を、説明なく作ってはいけません。どの期間なら望ましい結論になるかを確認する前に、開始日と終了日を決めます。
「精度が高い」の意味は損失関数で決まります
予測起点tの実現値をyₜ、モデルAとBの予測をŷA,ₜ、ŷB,ₜとします。誤差はeA,ₜ = yₜ − ŷA,ₜ、eB,ₜ = yₜ − ŷB,ₜです。損失関数Lは誤差をスコアに変換し、値が小さいほど良いとします。二乗損失L(e) = e²は大きな誤差に重いペナルティを与えます。絶対損失L(e) = |e|は誤差の大きさに比例して増えます。分位点予測では、過小予測と過大予測のコストが異なるため、非対称なピンボール損失を使うことがあります。
選んだスコアによって、優れて見えるモデルが変わることがあります。同じ単位で測った仮想的な誤差の組を比べます。モデルAの誤差が0と2、モデルBが1と1なら、二乗損失による平均損失はそれぞれ2と1なので、Bの方が低くなります。絶対損失では両方とも平均1です。どちらか一方が常に正しいわけではありません。それぞれ、どの誤差を重視するかという違う問いに答えます。
リターン予測では、条件付き平均を予測する場合に二乗誤差が役立つことがあります。ボラティリティ予測には目的に合わせたスコアが必要で、Value-at-Risk予測には分位点スコアまたはリスク専用のバックテストが適しています。どちらのモデルが勝ったかを見てから損失関数を選ぶと、検定が追加の探索になってしまいます。比較結果を見る前に、スコアと「良い」の向きを決めておきます。
VaR予測は通常の点予測ではなく、損失分布の裾にある分位点を対象にします。VaRバックテストのガイドでは、別個のリスク予測について例外の頻度と発生タイミングを調べる方法を説明します。
ペアの損失差を作り、帰無仮説を明記します
値が低いほど良い損失関数について、期間tの差を次のように定義します。
dₜ = L(eA,ₜ) − L(eB,ₜ)
この符号規約では、dₜが正ならAの損失が大きく、その予測起点ではBの損失が小さいことを意味します。負ならAに有利です。標本平均はd̄ = (1/n) Σ dₜです。無条件の予測精度が等しいという帰無仮説はE[dₜ] = 0です。両側の対立仮説は期待損失がどちらかの方向に異なるかを問い、事前に定めた片側の対立仮説なら特定のモデルの期待損失が小さいかを検定します。
基本となる統計量は次のとおりです。
DM = d̄ / √(Ŝd / n)
Ŝdは片方のモデルの予測誤差の分散だけではなく、損失差系列の長期分散を推定します。帰無仮説の下で適切な正則条件が成り立てば、この統計量は漸近的に標準正規分布に従います。上記の符号規約では、大きな正の値はB、大きな負の値はAを支持します。p値は、指定した帰無仮説と標本抽出の仮定にデータがどの程度整合するかを表します。どちらかのモデルが真である確率ではありません。
ペア比較によって、2つのモデル全体の誤差規模の違いを無関係な要因として取り除けるのは、起点ごとの損失差がその違いを捉える範囲までです。損失差系列が独立になるわけではなく、パラメータ推定の不確実性が自動的に消えるわけでもありません。多数の目的変数や仕様を試した探索も補正されません。これらは評価設計と不確実性計算で扱います。
1期先の例で標本差と証拠を区別します
ペアになった仮想の1期先予測が100件あるとします。二乗パーセントポイント単位で、モデルAの平均二乗損失は0.26、モデルBは0.23です。平均損失差はd̄ = 0.26 − 0.23 = 0.03で、標本ではBが有利です。単純な計算例として、dₜの推定長期分散を0.04とし、予測起点間に系列共分散がないと仮定します。
平均差の推定標準誤差は√(0.04 / 100) = 0.02です。補正前の統計量は0.03 / 0.02 = 1.50です。h = 1、T = 100の場合、Harvey–Leybourne–Newboldの小標本補正係数は√[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995です。これを掛けると補正後の統計量は約1.49となり、近似的なt₉₉を参照分布に使うと両側p値は約0.14です。
Bの観測平均二乗誤差は低いものの、この例は通常の有意水準で期待精度が等しいという仮説を棄却する強い証拠にはなりません。棄却できなかったからといって両モデルの精度が等しいと証明されたわけではありません。棄却できた場合も、選んだスコア、予測起点、仮定に条件付きの結果です。分散とすべての損失の値は計算を説明するための仮定であり、実証結果ではありません。
平均二乗損失の平方根にあたる二乗平均平方根誤差(RMSE)は、Aが約0.510、Bが約0.480パーセントポイントで、記述上の差は0.030です。ただしDM統計量が検定するのはペアになった二乗損失の差であり、2つの平方根の差に対するt検定ではありません。
重複する予測期間では損失差に依存が生じます
5日先予測を毎日発表すると、隣り合う予測は5つの目標日のうち4日を共有します。そのため、予測誤差、損失、損失差が連動する可能性があります。毎日の予測起点100件を独立した比較として扱うと、不確実性を過小評価し、統計量が実際より大きく見えることがあります。
長期分散はdₜの系列共分散を考慮します。一般的な不均一分散・自己相関に頑健な(HAC)推定量は次の形です。
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
ここでγ̂ₖはラグkにおけるdの標本自己共分散、wₖはカーネル重み、mは選択した帯域幅です。NeweyとWest(1987)は正の半定値を保証するHAC共分散推定量を示しています。関連する仮定の下で理想的なh期先予測誤差に重複がある場合、依存は少なくともh − 1ラグまで生じることがあり、原論文のDM枠組みもそのケースの打ち切り推定量を論じています。実データでは、持続性の高い目的変数、ローリング推定、戦略の構築によって依存がさらに長く続くことがあります。したがってh − 1は普遍的な帯域幅の規則ではありません。
予測期間、カーネル、帯域幅、小標本補正の有無を明記します。好みのp値になる帯域幅を選ぶのではなく、妥当な依存性の設定で結論が変わるかを示します。評価起点を離して重複を避ける場合は、その選択と、失われる情報や標本数を説明します。依存を考慮した不確実性は表示上の任意項目ではなく検定の一部です。
入れ子モデルや時間変化する予測力には別の問いが必要です
等精度の帰無仮説の下でモデルが入れ子でない場合、通常のDM比較は解釈しやすくなります。大きなモデルが小さなベンチマークを含むと、追加係数の真値がゼロであっても、推定された係数が予測にノイズを加えることがあります。その帰無仮説では平均二乗予測誤差の差が標準的でない分布を持つ場合があります。入れ子モデルの標本外MSPE比較には、この推定ノイズの影響を調整するClark–West法などがありますが、あらゆるモデル設計でDMを置き換える汎用法ではありません。ClarkとWest(2007)を参照してください。
通常のDM帰無仮説は、評価標本全体における無条件の平均損失を対象にします。時期ごとの違いは平均に隠れることがあります。たとえばAは落ち着いた局面で優れ、Bはボラティリティが高い局面で優れていても、全期間の平均は似ているかもしれません。予測時点で分かっていた情報によって相対的な精度が変わるかを知りたい場合、条件付き予測能力の検定では損失差と事前に指定した操作変数を組み合わせます。GiacominiとWhite(2006)がこの枠組みを示しています。仮定と評価期間の設計が重要なので、結果を見た後で任意の指標を加える方法は適切ではありません。
検定は比較の構造に合わせて選びます。独立した予測、入れ子モデル、条件付き精度の時間変化、多数候補から選んだモデルは、互いに置き換えられるケースではありません。最後のケースについては、White Reality CheckとHansen SPAのガイドで、多数の売買ルールを探索した後のファミリー単位の補正を説明します。
予測損失が小さくても収益性のある戦略とは限りません
予測が統計的により正確でも、ネットの売買成績が改善するとは限りません。戦略では予測をポジションに変換し、取引時点を決め、スプレッド、手数料、スリッページ、市場インパクト、資金調達、借入、リスク制限を考慮する必要があります。リターンの平均二乗誤差がわずかに改善しても意思決定に役立たない場合があります。一方、平均誤差が少し大きいモデルでも、特定のルールで重要なテール事象をよりよく捉えるかもしれません。
予測評価とポートフォリオ評価は別の段階にします。まず、宣言した予測課題に合う目的変数と損失で予測を評価します。次に、予測の選択には使っていないデータで、売買ルールを完全に定めて評価し、現実的な約定と資金調達の前提を使います。予測検定のp値はバックテスト収益、シャープレシオ、将来の利益確率ではありません。
モデル、目的変数、予測期間、損失関数、標本期間を何度も試すと、各DM計算が正しくても選択バイアスが生じます。探索した候補全体を記録し、問題が「探索した中に残る候補があるか」であれば、ファミリー全体を扱う方法を使います。ブロックブートストラップのガイドでは、事前に決めた統計量について時系列依存を保った不確実性を評価しますが、記録されていないモデル探索を自動的に補正するものではありません。
別の研究者が再現できるよう十分な詳細を報告します
2つの予測モデル、ベンチマークとの関係、目的変数、予測期間、予測起点の間隔、評価日、情報集合、データの版、共通標本の規則を明記します。損失関数を数式で定義し、dₜが正のときにAとBのどちらが有利かを説明します。n、各モデルの平均損失、d̄、長期分散の推定方法、HACカーネルと帯域幅、小標本補正、参照分布、検定方向、p値も報告します。
さらに、モデルが入れ子かどうか、パラメータの推定方法、結果を確認する前後のどちらで比較対象を選んだか、他に試した仕様も示します。モデル選択に使った標本で検定した場合は、手付かずの標本外証拠と呼ばず、選択過程の一部として記載します。明確な報告があれば、何を比較し、どの不確実性や選択上の問題が対象外なのかを読者が確認できます。
よくある質問
Q1Diebold–Mariano検定では予測誤差の正規分布を仮定しますか?
いいえ。正規分布でない予測誤差も枠組みの対象になります。ただし、損失差の分散を適切に推定し、参照分布を支える正則条件が必要です。
Q2異なる予測期間の2つのモデルを比較できますか?
同条件の精度比較としてはできません。先に目的変数と予測期間をそろえてください。そうしなければ、それぞれのモデルが異なる予測の問いに答えることになります。
Q3DM検定が有意なら、それだけで売買モデルを選べますか?
いいえ。特定の比較における期待予測損失についての証拠です。モデル探索、意思決定ルール、約定コスト、資金調達、標本外での戦略成績は別に検討する必要があります。 主な研究論文 - Diebold and Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne, Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini and White, “Tests of Conditional Predictive Ability” (2006) - Clark and West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey and West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
出典
問題を報告
この記事のリンクを含むメールを準備します。送信すると Mark に報告が届きます
クイックチェック
記事を読み終えたら、3問で確認しましょう
問題 01
dₜ = L(eA,ₜ) − L(eB,ₜ)と定義した場合、標本平均が正ならどちらが有利ですか?
答えを選ぶと解説を確認できます
オプション用語集
関連ガイド
バックテストのデータスヌーピング補正トレーディング規則のWhite Reality CheckとHansen SPA検定WhiteのReality CheckとHansenのSPA検定を比較し、探索した規則群、帰無仮説、ブートストラップの考え方と解釈上の限界を説明します。戦略成績の不確実性ブロック・ブートストラップで戦略リターンの信頼区間を推定する時系列依存を保つブロック・ブートストラップの仕組みを解説。移動ブロック法と定常ブートストラップ、信頼区間、シャープ比率差の共同再標本化、ブロック長の選び方を確認します。VaR例外の頻度と発生時点を検証VaRバックテスト:Kupiec検定とChristoffersen検定を解説KupiecのPOF検定とChristoffersenの条件付きカバレッジ検定がVaR例外をどう評価するか、250日例と非棄却が正確さの証明ではない理由を解説します。オプションの仕組みオプションの割当てとは?ショート・オプションに満期日前または満期日に株式の受渡し・買付義務が生じる仕組みを説明します許容契約数はリスク予算とは別ですオプションの建玉制限と行使制限の違い上場オプションの建玉制限と行使制限の違い、同一方向での集計や報告が重要な理由、証拠金や買付余力だけでは許容数量を示せない理由を解説します