

すべてのオプションガイド
目立つラグパターンのない残差と、同じずれで繰り返し整列する残差を対比した概念図であり、実測データや検定結果ではありません 問題 1 / 3
複数ラグの残差自己相関をまとめて検定する14分で読めます
時系列の自己相関を検定するLjung–Box検定
Ljung–BoxのQ統計量が残差自己相関を組み合わせる仕組み、ラグと自由度の選び方、金融リターンについて検定から分からないことを解説します
このガイドの内容Ljung–Box検定が調べること
短い要約
Ljung–Box検定は、選んだラグまでの自己相関が同時にゼロと整合するかを調べます。モデル残差に適用すると、その範囲に残る線形依存を確認できますが、独立性、正規性、モデルの正しさ、または取引可能なリターン予測を証明するものではありません。
Ljung–Box検定が調べること
標本自己相関の図には複数ラグの依存が見えることがありますが、多数の棒を個別に読むと多重検定の問題が生じます。Ljung–Box検定は最初の \(h\) 個の標本自己相関を一つのポートマントー統計量にまとめます。帰無仮説は、ラグ1から \(h\) までの母自己相関がすべてゼロであることです。対立仮説は、そのうち少なくとも一つがゼロでないことです。
BoxとPierceは、当てはめた時系列モデル全体の適合度を調べる検定を開発しました。LjungとBoxは有限標本での近似を改善するため統計量を修正しました。「ポートマントー」とは、一つの統計量で複数ラグの相関をまとめることを指します。時系列依存のあらゆる種類を検定するという意味ではありません。
リターン系列なら、過去の符号付きリターンに線形の系列依存が残るかを問うことがあります。ARMAモデルを当てはめた場合は、通常、指定したラグ構造をモデルで説明した後に残差自己相関が残るかを調べます。関連はありますが別の用途なので、結果を解釈する前にどの系列を検定したのかを明確にしてください。
Box–Pierce統計量とLjung–Box統計量を計算する
ラグ \(k\) の標本自己相関を \(\hat\rho_k\)、計算に使う観測数を \(n\)、検定する最大ラグを \(h\) とします。Box–Pierce統計量は次のとおりです。
\[ Q_{BP}=n\sum_{k=1}^{h}\hat\rho_k^2. \]
Ljung–Box調整では、各ラグで利用できる標本数に応じた重みを付けます。
\[ Q_{LB}=n(n+2)\sum_{k=1}^{h}\frac{\hat\rho_k^2}{n-k}. \]
相関を二乗するため、正負どちらの自己相関も統計量を大きくします。この調整では、同じ大きさの相関でも利用できる組が少ないラグをより重く扱います。大標本では二つの統計量が近づくことがよくあります。元の研究では小標本近似が改善したため、有限標本ではLjung–Boxがよく使われます。
ホワイトノイズの帰無仮説と必要な正則条件のもとで、\(Q_{LB}\) をカイ二乗分布と比較します。動的パラメーターを当てはめていない生系列では、通常、基準自由度に \(h\) を使います。推定したARMA(\(p,q\))モデルの残差では、正である場合に \(h-p-q\) とするのが一般的です。この補正は残差の動学を当てはめるために使ったパラメーターを反映します。あらゆる回帰の全係数を差し引くという普遍的な規則ではありません。積分・季節・制約付き、または特殊なモデルでは別の慣例が必要な場合があります。実際の残差検定とソフトウェアの定義に合う自由度を使います。たとえば、ARMA(2,2)の残差を \(h=4\) まで検定すると、一般的な補正では自由度がゼロになります。通常のカイ二乗比較は使えません。自由度ゼロの基準を無理に使うのではなく、より長いラグ範囲を事前に決めるか、そのモデル用の診断を選びます。ラグ範囲を選んだ理由も報告してください。
仮想の残差計算を確認する
当てはめたモデルに残差が \(n=250\) 個あり、事前に決めた5ラグの自己相関が \(0.10, 0.05, -0.08, 0.02, -0.04\) だったとします。Box–Pierceでは、まず二乗して合計します。
\[ 0.10^2+0.05^2+(-0.08)^2+0.02^2+(-0.04)^2=0.0209. \]
すると \(Q_{BP}=250(0.0209)=5.225\) です。Ljung–Boxの重みを適用すると
\[ Q_{LB}=250(252)\left(\frac{0.0100}{249}+\frac{0.0025}{248}+\frac{0.0064}{247}+\frac{0.0004}{246}+\frac{0.0016}{245}\right)\approx 5.31. \]
この計算だけではp値は得られません。ARMA(1,1)を当てはめた残差なら、一般的な基準自由度は \(h-p-q=5-1-1=3\) です。モデルを当てはめていない系列なら、別の帰無仮説のもとで自由度5を使う場合があります。自由度の選択で上側確率は変わります。ここにある数値は計算例のための仮想値であり、市場データやモデルの実測結果ではありません。
統計量が小さい場合、選んだ参照分布のもとで観測された二乗自己相関が特に大きくないことを意味します。相関が正確にゼロだと証明するものではありません。統計量が大きければ、選んだ水準で集合全体が帰無仮説と整合しにくいことを示します。一つの値を原因診断として扱わず、どのラグやモデルの特徴が結果に関係したかを調べてください。
有利な結果を見る前にラグ範囲を決める
上限ラグ \(h\) によって検定の問いが決まります。短いラグだけを数個検定すると、遅い依存や日次データの週次パターンを見落とすことがあります。ラグを多数に広げると、弱くノイズの多い推定を含み、特定の短期パターンに対する検出力が落ちたり、少数の長期相関に結果が左右されたりします。大きな \(h\) ではARMA補正後の自由度も減ります。
標本頻度、既知のカレンダー構造、モデルの目的、残差から取り除きたい依存に基づいてラグを選びます。日次市場データでは、取引セッションのラグと暦日のラグが一致しないことがあります。日中データには時刻帯や夜間の影響があります。季節モデルでは季節ラグや専用の季節診断が必要な場合があり、一般的な一つの上限では構造を隠すことがあります。
複数の \(h\)、変換、資産、モデル次数を試し、最小のp値だけ報告すると、表示された有意性は検索を反映しません。診断を読む前にラグ範囲と判断規則を定めるか、より広い検索を推論計画に反映してください。
自己相関図を共同統計量と合わせて読む
自己相関図には、\(\pm1.96/\sqrt{n}\) のような個別ラグ用の近似帯がよく表示されます。単純なホワイトノイズモデルでは個々の標本相関を確認する参考になりますが、全ラグを同時に覆う95%帯ではありません。多くの棒を個別に見ると、偶然に少なくとも一つが帯を越える確率が高まります。Ljung–Box検定は代わりに、事前指定した集合について結合統計量の参照分布を使い、一つの同時の問いを検定します。
共同統計量は、比較的大きな自己相関が一つある場合にも、控えめな相関が複数ある場合にも大きくなります。検定後にラグごとの項 \(n(n+2)\hat\rho_k^2/(n-k)\) とACF図を確認してください。経験則の帯を越えた棒一つが、そのまま有意なポートマントー結果を意味するわけではありません。各棒がそれぞれの帯内にあっても、共同統計量が有意でない保証にはなりません。
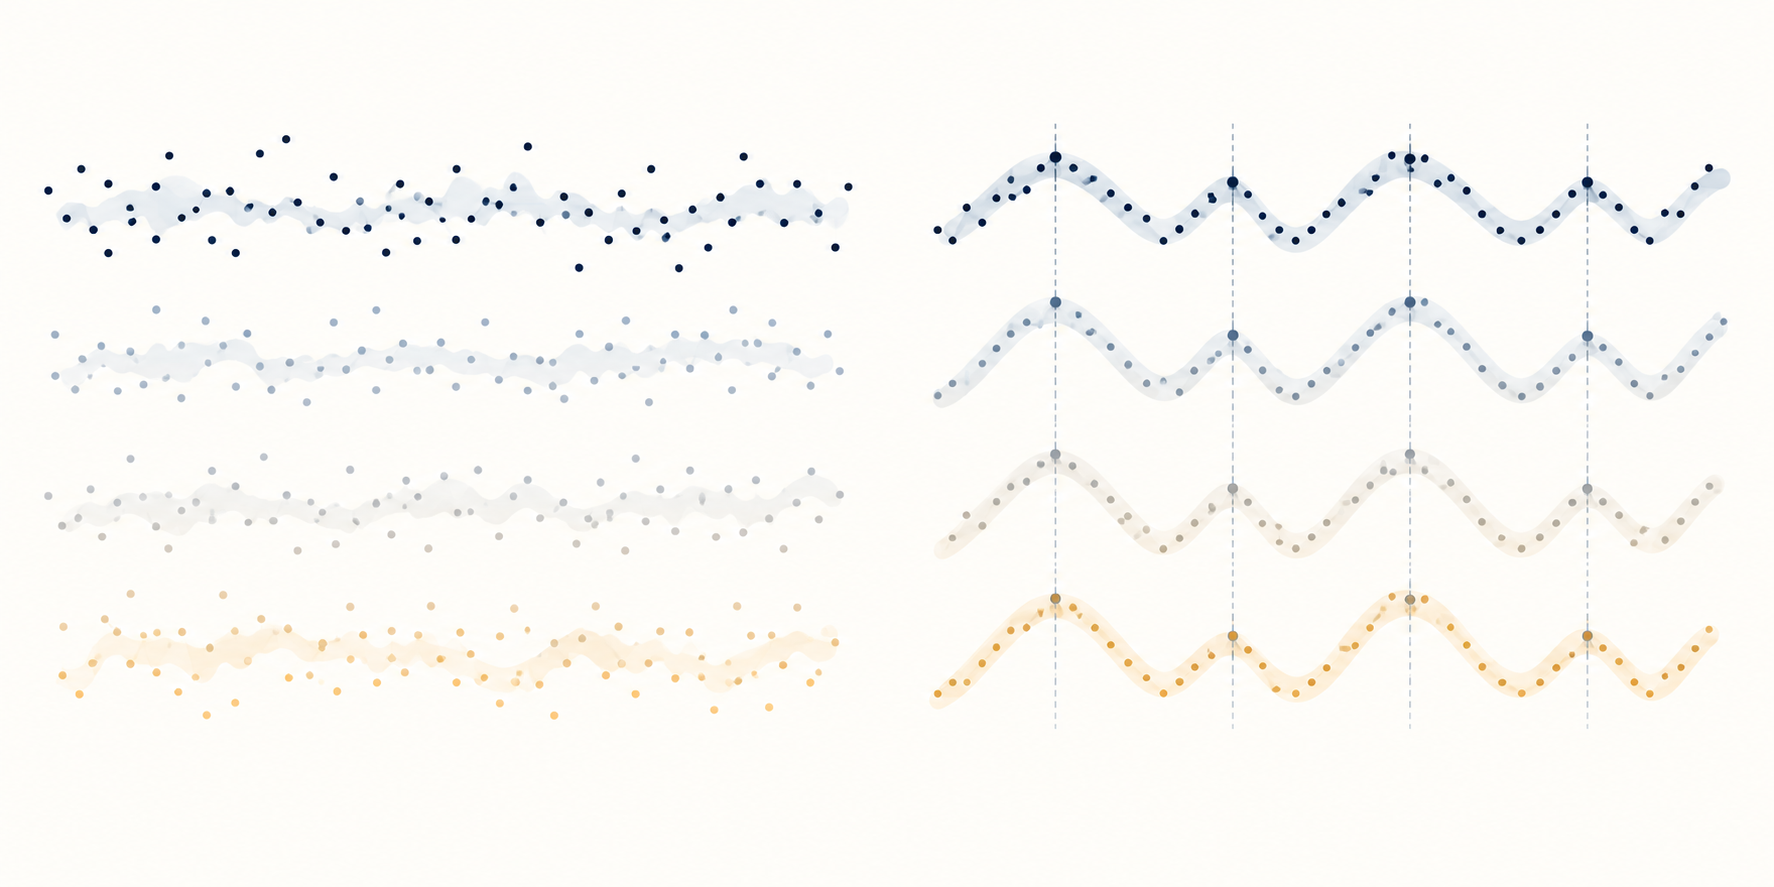
*概念図は、残差に目立つラグパターンがない場合と、複数のずれで繰り返し整列する場合を比較しています。実際の市場データではありません。*
生リターン、モデル残差、二乗残差を区別する
符号付きリターンに検定を適用すると、ラグ \(h\) までの線形自己相関が同時にゼロかを問います。適合残差に適用すると、選んだモデルが同様の線形依存を残したかを問います。棄却は平均の仕様、タイミング、市場カレンダー、残差図を確認するきっかけになりますが、欠けた項を特定するものではありません。
リターン期間の重なりが依存性を作っていないか確認する
基礎となる1期間リターンが無相関でも、観測値の定義によって自己相関が生じることがあります。たとえば、5セッションのローリングリターンと次の5セッションのローリングリターンは、日次リターンを4つ共有します。この重なりが隣接観測を機械的に結び付けます。Ljung–Boxがこのように構成された系列の自己相関ゼロを正しく棄却しても、重複しない日次リターンが予測可能だったことにはなりません。
観測値が日次リターン、複数日のローリングリターン、または重複する結果変数のモデル残差のどれかを示します。取引セッションのカレンダー、終値の時刻、夜間の区間を経済的な問いに合わせてください。重複期間が必要なら、その構成に合う推論と参照分布を使い、単独の取引優位性の証拠と解釈しないでください。
符号付きリターンの自己相関が小さくても、ボラティリティ・クラスタリングは起こりえます。残差を二乗すると問いが変わり、二乗または絶対値を標準化した残差の自己相関は、リターンの尺度に依存関係がある可能性を示します。McLeodとLiはARMA適合後の非線形依存を診断する方法として、二乗残差の自己相関を研究しました。これも診断であり、一つのボラティリティモデルを証明するものではありません。ARCH-LMガイドはARCH型依存により焦点を当てた検定を、GARCHガイドは条件付き分散モデルを説明します。
パラメーター推定後は参照分布を確認する
単純なカイ二乗近似は、モデル、残差の作り方、標本サイズ、パラメーター推定の設定に依存します。先にARMAモデルを当てはめた場合、残差自己相関は直接観測されたイノベーション間の相関ではなく推定値です。一般的な自由度補正は実用的な漸近上の慣例であり、すべての仕様における有限標本の厳密な保証ではありません。
小標本、大きなラグ範囲、互いに打ち消し合うAR・MA根、外れ値、条件付き不均一分散、当てはめたモデル族の外にある系列依存は、近似の信頼性を下げます。棄却は平均モデルの誤指定、データ品質の問題、不適切な参照分布を反映する場合があります。非棄却は検出力不足や、関心のある依存を含まないラグ選択の結果かもしれません。
複雑または非標準のモデルでは、適合方法に合う参照分布を持つ診断を使うか、推定段階を繰り返す妥当なブートストラップで較正を調べます。依存や変動分散が問題なのに、残差を独立同分布として再標本化すれば有効になるとは限りません。再標本化の方法を説明し、モデル選択と最終評価を分けてください。
棄却は売買ではなく診断のきっかけとして読む
棄却されたら自己相関関数、必要に応じて偏自己相関、残差の時間配置、\(Q_{LB}\) に対する各ラグの寄与を確認します。パターンが短命か、季節的か、平均項の欠落によるものか、二乗残差に集中しているかを検討します。モデル変更は説明可能な仕様上の問いに基づき、選択に使っていないデータで評価してください。
取引ルールでは、標本内の予測可能性は執行可能な優位性を意味しません。次の時点の予測は注文前に利用可能で、時系列順のホールドアウトで維持され、ビッド・アスク・スプレッド、インパクト、手数料、資金調達、借株、回転率を考慮する必要があります。Ljung–Box検定は戦略の純利益を検定せず、棄却が標本外で続くとも証明しません。
観測の定義と数、検定系列、変換、上限ラグ、個別自己相関または図、検定の種類、参照自由度、統計量、p値、有意水準を報告します。金融リターンなら、取引セッション、欠測、重複期間、適合した条件付き分散をどう扱ったかを記載します。読者が検定で分かったことと未解決のことを区別できます。
BoxとPierceの1970年論文は残差自己相関をまとめる統計量を提示します。LjungとBoxの1978年論文は有限標本向けの修正を提案します。McLeodとLiの1983年論文は二乗残差の自己相関を扱います。NISTのBox–Ljung資料は統計量と残差自由度の調整をまとめています。関連診断は分散比検定、ARCH-LM、GARCHボラティリティ・クラスタリングのガイドを参照してください。
よくある質問
Q1有意でないLjung–Box結果は残差がホワイトノイズだと証明しますか?
いいえ。選んだラグの自己相関が、その水準で共同帰無仮説を棄却するほど大きくなかったことを意味します。他のラグ、非線形依存、ボラティリティ・クラスタリング、検出力不足が残る場合があります。
Q2当てはめたARMA残差にはどの自由度を使いますか?
正であれば、ARMA(\(p,q\))残差の検定には一般に \(h-p-q\) を使います。ただし特殊モデルや季節モデルでは規則が異なる場合があります。実際のモデルと実装に合う参照分布を選んでください。
Q3Ljung–Boxで利益の出るリターンパターンを見つけられますか?
いいえ。選んだラグまでの自己相関を同時に診断する検定です。予測や取引を主張するには、事前に決めたリアルタイム規則、時系列順の標本外証拠、現実的な執行コストが必要です。 ---
出典
問題を報告
この記事のリンクを含むメールを準備します。送信すると Mark に報告が届きます
クイックチェック
記事を読み終えたら、3問で確認しましょう
問題 01
ラグ h までのLjung–Box検定の帰無仮説は何ですか?
答えを選ぶと解説を確認できます
オプション用語集
関連ガイド
金融時系列の診断ARCH LM検定とは?金融モデル残差のボラティリティ・クラスタリングを診断ARCH LM検定で残差の二乗にラグ依存があるかを調べる方法、次数qの選び方、検定結果から言えることと言えないことを解説します。ボラティリティの動学ボラティリティ・クラスタリングとGARCH静かな相場と荒い相場が続く理由、GARCHが条件付き分散を更新する仕組み、予測をオプションへ使う際の限界を解説しますリターン分散が時間とともにどう増えるかを検定する分散比検定:ランダムウォーク、期間と取引分散比が1期間と複数期間のリターンをどう比較するか、1を上回る・下回る値が何を示唆するか、なぜ取引の優位性を証明しないかを解説します。新しい観測値に応じてペアのヘッジ推定値を更新するカルマンフィルターのヘッジ比率:ペアトレードの動的回帰状態空間回帰が変化するヘッジ比率を更新する仕組み、過程ノイズが応答性を調整する方法、フィルター済みスプレッドにも標本外検証が必要な理由を解説しますオプションの基礎イン・ザ・マネー、アット・ザ・マネー、アウト・オブ・ザ・マネーとは?権利行使価格と原資産価格の関係、コールとプットで意味が反対になる理由を説明します