Estimar la volatilidad realizada teniendo en cuenta el ruido de los precios de alta frecuencia16 min de lectura
Volatilidad realizada con prepromediación: un estimador frente al ruido de microestructura
Aprende cómo la prepromediación suaviza ventanas breves de rendimientos de alta frecuencia, corrige el principal sesgo por ruido, ajusta la longitud de ventana y se diferencia de TSRV y los kernels realizados.
En esta guíaPor qué los rendimientos muy frecuentes pueden distorsionar la variación de precios
Resumen breve
La prepromediación estima la variación de precios cuando los precios registrados con mucha frecuencia contienen ruido de microestructura. En lugar de elevar al cuadrado cada rendimiento bruto, forma sumas ponderadas y superpuestas de rendimientos cercanos, las eleva al cuadrado y resta un término correspondiente al principal efecto del ruido. El resultado depende de la forma de los pesos, la longitud de la ventana, el diseño muestral y los supuestos sobre el ruido. Mide la variación de un intervalo observado; no es una previsión de volatilidad ni una señal de trading.
Por qué los rendimientos muy frecuentes pueden distorsionar la variación de precios
Si el precio observado coincidiera con el precio eficiente, sumar los rendimientos intradía al cuadrado sería una forma natural de estimar la variación durante la sesión. Sin embargo, los precios de transacción y las cotizaciones pueden reflejar el rebote entre oferta y demanda, el redondeo al tamaño mínimo de tick, la latencia, la discreción de precios o las reglas de registro. Cuando el intervalo de muestreo es extremadamente corto, esos efectos pueden representar una parte importante de cada rendimiento al cuadrado. Añadir observaciones puede aumentar el componente de ruido en vez de limitarse a revelar más movimiento del precio latente.
La prepromediación aborda el problema combinando rendimientos en una ventana local breve antes de elevarlos al cuadrado. Una función de pesos suave parte de cero, pondera los rendimientos vecinos y vuelve a cero en el borde de la ventana. La suma ponderada actúa como un filtro local: los errores de observación rápidos e independientes pueden compensarse parcialmente, mientras que puede conservarse el movimiento más amplio del precio eficiente. Las ventanas superpuestas permiten utilizar información a lo largo de todo el intervalo.
Suavizar no basta para que un estimador sea insesgado. Los rendimientos filtrados al cuadrado siguen conteniendo variación causada por el ruido, por lo que hace falta un término de corrección. Jacod, Li, Mykland, Podolskij y Vetter derivan un método de prepromediación para estimar la volatilidad integrada bajo supuestos explícitos y muestran que ciertas versiones alcanzan la tasa de convergencia \(n^{-1/4}\). El artículo original fundamenta el método; esta guía explica su mecánica, sus decisiones y sus límites.
Separar el precio latente, el observado y la magnitud objetivo
Sea \(X_{t_i}\) el logaritmo del precio eficiente latente en el momento de observación \(t_i\), y sea \(Y_{t_i}\) el logaritmo del precio registrado:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
donde \(\epsilon_{t_i}\) representa el ruido de observación. Un modelo básico habitual trata \(X_t\) como una semimartingala continua con tasa local de varianza \(\sigma_t^2\). La magnitud que se busca en un intervalo fijo \([0,T]\) es la varianza integrada:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
El rendimiento observado se descompone como \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Aunque los errores de precio sean independientes entre observaciones, dos rendimientos contiguos comparten el error de un extremo con signos opuestos. Esto introduce dependencia serial en los rendimientos y hace que la varianza realizada con todas las observaciones sea sensible al número de diferencias ruidosas.
La explicación teórica sencilla suele suponer ruido de media cero, independiente a lo largo del tiempo y del proceso de precio eficiente, además de momentos finitos adecuados. Estos supuestos ayudan a entender la corrección, pero no están garantizados para transacciones, cotizaciones o precios medios. El ruido puede cambiar con la liquidez y la hora del día, relacionarse con el precio eficiente o mostrar dependencia serial. También hay que precisar el objetivo: con saltos, la variación cuadrática incluye sus cuadrados; la varianza integrada continua no.
Se trata de una medición ex post para una serie de precios y un intervalo determinados. No reconstruye cada precio latente, no identifica qué operación individual fue errónea ni indica cuál será la volatilidad futura. Antes de comparar estimaciones, especifica si usas precios de transacción, puntos medios de cotización u otra construcción.
Formar rendimientos prepromediados y superpuestos
Para \(n\) rendimientos observados \(r_i=Y_{t_i}-Y_{t_{i-1}}\), se eligen una longitud entera de ventana \(k_n\) y una función de pesos \(g\) en \([0,1]\). Una forma habitual de rendimiento prepromediado es
Por lo general, la función es continua, vale cero en ambos extremos y tiene la suavidad requerida por los resultados asintóticos. Un ejemplo triangular es \(g(u)=\min(u,1-u)\). Como los pesos son cero en los extremos, el rendimiento del borde no recibe de pronto el peso máximo. La forma define pesos locales; no es una previsión ni una tendencia estimada.
Cada \(\bar r_i\) agrupa rendimientos contiguos antes de elevarlos al cuadrado. Como las ventanas se superponen, los rendimientos prepromediados están correlacionados incluso si los rendimientos brutos no lo estuvieran. Esa dependencia forma parte del comportamiento muestral del estimador: no hay que tratar las muchas sumas de ventana como observaciones independientes. El rango de índices y la convención de los extremos deben concordar con la normalización de los pesos.
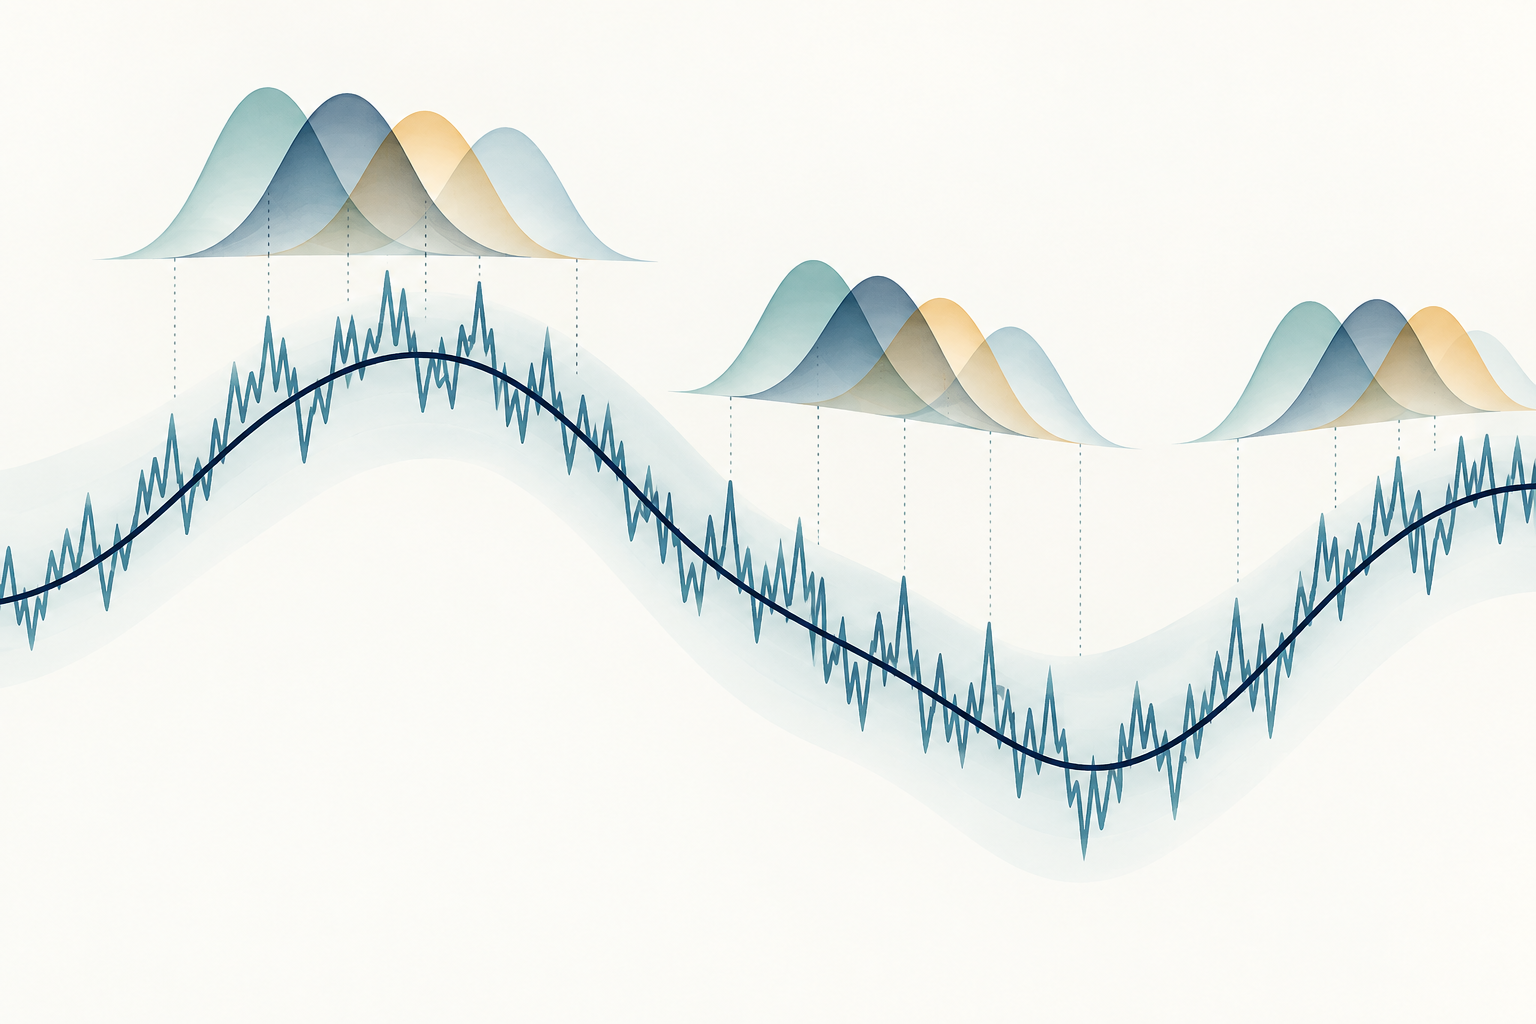
La figura muestra una trayectoria latente suave, otra observada y dentada y varias ventanas superpuestas con pesos que se atenúan. Ilustra la agrupación local; no es una serie de precios ni la salida empírica de un filtro.
<!-- learn:illustration --> <!-- Concepto sin texto: una trayectoria latente de precios suave junto a otra observada e irregular, con ventanas locales superpuestas y atenuadas que agrupan movimientos vecinos. Es conceptual, no son datos de mercado, un pronóstico ni una señal de trading. -->
Ilustración conceptual del prepromediado de rendimientos con ruido de microestructura. No son datos de mercado, un pronóstico ni una señal de trading.
Corregir la contribución de ruido que permanece
La prepromediación reduce la influencia de los errores de observación rápidos, pero los rendimientos filtrados al cuadrado aún contienen ruido. Una forma común del estimador univariante en una rejilla regular, con constantes de normalización asintóticas, es
El primer término reescala la suma de rendimientos prepromediados al cuadrado para aproximarla a la varianza integrada. El segundo estima y resta, bajo el modelo, la principal contribución del ruido de observación. No estima cada realización del ruido ni corrige un campo de precios equivocado, una marca de tiempo errónea o un valor atípico. La fórmula de muestra finita puede usar versiones discretas de \(\psi_1\) y \(\psi_2\), ajustes en los extremos y una convención concreta para los índices. Hay que describir esos detalles y mantenerlos coherentes.
La corrección puede dejar una estimación pequeña o negativa en una muestra finita. Eso no significa que el activo tuviera varianza física negativa; significa que la corrección elegida superó el primer término en esa muestra. No cambies silenciosamente una estimación negativa por cero. Informa el cálculo bruto y cualquier regla separada de truncamiento, porque truncar modifica el estimador y puede afectar promedios o inferencia posteriores.
Elegir la longitud de ventana según el ruido y la muestra
\(k_n\) controla cuánto se suavizan los rendimientos. Si la ventana es demasiado corta, queda más ruido de alta frecuencia en los rendimientos filtrados. Si es demasiado larga, se promedian movimientos locales del precio a lo largo de más tiempo y participan menos ventanas, lo que puede aumentar otros errores de estimación. La longitud de la ventana y la función de pesos trabajan conjuntamente; \(k_n\) no se interpreta sin la forma de los pesos y el intervalo de muestreo.
En el diseño equilibrado clásico, con un horizonte temporal fijo y \(n\) observaciones cada vez más frecuentes, la ventana crece en el orden de \(\sqrt n\), normalmente escrito \(k_n\sim\theta\sqrt n\), donde \(\theta\) es una constante positiva de ajuste. Bajo los supuestos del artículo, el estimador puede converger a tasa \(n^{1/4}\), es decir, con un error de estimación del orden de \(n^{-1/4}\). Es más lento que la tasa \(n^{1/2}\) sin ruido y es óptimo en el entorno básico con ruido que estudian los autores; no es una garantía para cualquier conjunto de datos de mercado.
\(\theta\), la función de pesos y el método de selección basado en datos influyen en el sesgo y la varianza de muestras finitas. Una regla automática puede depender de estimaciones de ruido y volatilidad que también son inciertas. Muestra la sensibilidad a varias ventanas defendibles, explica el reloj de muestreo y los límites de la sesión, y no elijas la ventana después de ver qué valor favorece la conclusión deseada.
Un pequeño cálculo hipotético
Supongamos seis rendimientos observados hipotéticos, expresados en puntos básicos:
Usamos un peso triangular \(g(u)=\min(u,1-u)\) y una ventana intencionadamente corta \(k=3\). Los dos pesos interiores de la rejilla son \(g(1/3)=g(2/3)=1/3\). Para mostrar exactamente la aritmética en esta pequeña rejilla, definimos las constantes discretas de normalización
Con la convención de índices anterior hay \(n-k+2=5\) ventanas superpuestas. Cada una combina un rendimiento vecino de \(1\) bp con otro de \(0\) bp, por lo que \(\bar r_i=(1/3)(1+0)=1/3\) bp y
El ejemplo permite comprobar la aritmética y las unidades; seis rendimientos y una ventana tan breve no bastan para respaldar la aproximación asintótica. Los valores se construyeron para que el cálculo sea transparente. No son datos de mercado, una simulación de un proceso de ruido ni prueba de que se haya recuperado la varianza integrada latente. No se calcula error estándar ni previsión.
Entender los supuestos y cuándo pueden fallar
La derivación estándar supone un precio eficiente continuo observado con frecuencia y contaminado por ruido aditivo, además de ciertas condiciones de regularidad. El ruido centrado e independiente es un punto de partida útil, pero la dependencia entre ruido y precio, errores correlacionados, ruido variable en el tiempo, observaciones irregulares o muestreo endógeno pueden exigir otro estimador o una teoría adaptada. Aït-Sahalia, Mykland y Zhang estudian la estimación de volatilidad integrada con ruido de microestructura dependiente. Su artículo ayuda a entender por qué la fórmula para ruido independiente no es universal.
Los saltos plantean otra decisión sobre el objetivo. La variación cuadrática incluye los cuadrados de los saltos; la varianza integrada continua no. El estimador habitual de prepromediación no separa los saltos automáticamente. Una truncación robusta a saltos u otra construcción requiere sus propios supuestos y parámetros. Una operación atípica grande también puede afectar varias ventanas superpuestas, por lo que siguen siendo necesarios la validación de datos y el tratamiento de valores extremos.
La prepromediación tampoco resuelve por sí sola los datos multivariantes o asíncronos. Christensen, Kinnebrock y Podolskij desarrollan métodos de covarianza con prepromediación y una extensión de Hayashi–Yoshida robusta al ruido para observaciones no sincrónicas en su estudio. Esas construcciones abordan dificultades adicionales del diseño muestral. Aplicar una fórmula univariante a cada activo no sincroniza automáticamente las marcas de tiempo ni garantiza una matriz de covarianza válida.
Diferenciar la prepromediación de TSRV y los kernels realizados
Los estimadores abordan problemas relacionados de variación de alta frecuencia, pero organizan la información de forma distinta. Two-scale realized volatility, o TSRV, promedia las varianzas realizadas en rejillas de muestreo más dispersas y desplazadas, y resta una versión escalada de la varianza de la rejilla fina para corregir el principal sesgo por ruido. La prepromediación, en cambio, filtra primero ventanas breves y superpuestas de rendimientos con pesos suaves, eleva al cuadrado los rendimientos filtrados y aplica una corrección correspondiente. El artículo original de dos escalas presenta esa otra construcción.
Un kernel realizado parte de la suma de rendimientos al cuadrado y añade autocovarianzas ponderadas de rendimientos a varios rezagos. El ancho de banda controla hasta qué rezago se llega. La prepromediación modifica los rendimientos locales antes de elevarlos al cuadrado. Ambos métodos usan pesos y parámetros de ajuste, pero sus fórmulas, normalizaciones y supuestos no son intercambiables. Consulta la guía de kernels realizados para conocer su construcción basada en rezagos y el ancho de banda.
La elección debe depender de los datos y de la cantidad que se necesita, no del nombre del estimador. Compara el diseño de muestreo, el modelo de ruido, el tratamiento de los extremos, el objetivo con saltos y el comportamiento en muestras finitas. La robustez asintótica al ruido no garantiza que sea el método más adecuado para activos poco líquidos, sesiones breves, ruido cambiante o flujos de datos irregulares. La guía de TSRV explica las decisiones de escala y corrección de ese método.
Informar la medida del intervalo sin convertirla en una conclusión de trading
Para que el resultado sea reproducible, especifica el activo y el campo de precios, el intervalo, la frecuencia de muestreo, las reglas de marcas de tiempo y sesiones, las unidades de rendimiento, la función de pesos, la longitud de ventana, la normalización, la convención de extremos y los supuestos sobre el ruido. Si el estimador se usa para inferencia, informa también el estimador de varianza o el procedimiento del intervalo de confianza y sus supuestos. Una tabla de sensibilidad con ventanas razonables permite ver si la conclusión depende de un solo ajuste.
La varianza integrada mide el intervalo observado ya concluido. Su raíz cuadrada expresa una escala de volatilidad para ese mismo intervalo, pero no la convierte en previsión. La anualización requiere una convención temporal explícita y tampoco crea un pronóstico. Predecir un horizonte futuro requiere un modelo separado y una evaluación fuera de muestra. La guía de cálculo de la volatilidad realizada explica el benchmark basado en rendimientos al cuadrado, y la guía de variación cuadrática distingue la variación de la trayectoria del objetivo continuo de varianza integrada.
El estimador no demuestra por qué se movió el precio, no identifica una estrategia rentable ni garantiza que mida el riesgo de ejecución. Los costes de transacción, la liquidez, los saltos, la dinámica de volatilidad y la incertidumbre de estimación son cuestiones distintas. La prepromediación es una herramienta estadística de medición cuya utilidad depende de que sus supuestos explícitos encajen con los datos observados.
Preguntas frecuentes
Q1¿La prepromediación equivale a calcular un promedio móvil de los precios?
No. El estimador forma sumas ponderadas de rendimientos cercanos y después las eleva al cuadrado y las corrige. Promediar niveles de precios y diferenciarlos es otra transformación, con pesos y efectos de borde distintos.
Q2¿La prepromediación elimina todo el ruido de microestructura?
No. Reduce el efecto principal bajo supuestos especificados sobre ruido y muestreo. El ruido dependiente o cambiante, los saltos, los valores atípicos y los problemas de marcas de tiempo aún pueden afectar el resultado.
Q3¿Por qué pueden diferir dos estimaciones con prepromediación?
Pueden cambiar la función de pesos, la longitud de ventana, la normalización de muestra finita, el campo de precios, las reglas de extremos o la limpieza de datos. Hay que informar esas decisiones y analizar su sensibilidad.
Q4¿Una estimación con prepromediación es una previsión de volatilidad?
No por sí sola. Mide la variación del intervalo usado para calcularla. Predecir un periodo posterior requiere un modelo separado y una evaluación fuera de muestra.