

Hayashi–Yoshida सहप्रसरण अनुमानक: असमकालिक कीमतों की व्याख्या
जानें कि अलग-अलग समय पर देखी गई परिसंपत्ति कीमतों के लिए Hayashi–Yoshida अनुमानक overlapping return intervals से समाकलित सहप्रसरण कैसे मापता है और इसकी सीमाएँ कहाँ हैं।
इस गाइड मेंकारोबार की घड़ियाँ अलग हों तो परिसंपत्ति कीमतों का सहप्रसरण मापना कठिन क्यों होता है
संक्षिप्त सारांश
Hayashi–Yoshida (HY) अनुमानक दो ऐसी price series का समाकलित सहप्रसरण मापता है जिनके observations अलग-अलग समय पर आते हैं। यह return increments को तब गुणा करता है जब उनके समय-अंतराल एक-दूसरे पर चढ़ते हैं, इसलिए एक परिसंपत्ति की कीमत को दूसरी के timestamps पर पहले interpolate करने की जरूरत नहीं होती। अपने पारंपरिक रूप में HY diffusion model के अंतर्गत असमकालिक नमूनाकरण की समस्या संभालता है; यह market microstructure noise नहीं हटाता और न ही सहप्रसरण अनुमान को पूर्वानुमान बनाता है।
कारोबार की घड़ियाँ अलग हों तो परिसंपत्ति कीमतों का सहप्रसरण मापना कठिन क्यों होता है
दो परिसंपत्तियों का कारोबार बाजार के एक ही समय में हो सकता है, फिर भी उनकी trade या quote update अलग-अलग क्षणों पर आते हैं। किसी liquid stock में बार-बार price print हो सकती हैं, जबकि कम सक्रिय stock में कुछ समय तक नया trade या quote न आए। तब दोनों की देखी गई कीमतें अलग-अलग समय-grid पर होती हैं। लक्ष्य उसी समय का साझा उतार-चढ़ाव हो सकता है, पर देखे गए दो returns के हर जोड़े का एक ही अवधि को ढकना जरूरी नहीं।
एक सामान्य विकल्प दोनों series को नियमित घड़ी पर रखकर हर परिसंपत्ति की आखिरी देखी गई कीमत आगे ले जाना है। इससे aligned return columns बनते हैं, लेकिन आगे ले जाई गई अपरिवर्तित कीमत latent price का नया स्वतंत्र observation नहीं होती। इससे शून्य returns और बाद में देर से दर्ज हुई भरपाई वाली चालें बन सकती हैं, जो मापे गए सह-गति को बिगाड़ती हैं। Epps ने दिखाया कि measurement interval छोटा होने पर stock-return correlation घट सकता है; असमकालिक observations इसका एक महत्वपूर्ण कारण हैं, हालांकि market data के अन्य प्रभाव भी होते हैं। छोटे interval में दिखने वाले इस pattern को आमतौर पर Epps effect कहते हैं (Epps, 1979)।
Hayashi और Yoshida ने ऐसा अनुमानक प्रस्तावित किया जो पहले interpolation rule चुनने के बजाय मूल असमकालिक increments पर काम करता है। उनके मूल अध्ययन ने high-frequency sampling conditions के तहत diffusion prices के लिए consistency स्थापित की (Hayashi & Yoshida, 2005); बाद के शोध ने सामान्य असमकालिक sampling scheme में asymptotic normality निकाली (Hayashi & Yoshida, 2008)। मूल विचार बताना सरल है, पर इसे गलत लगाना आसान है: increments को उनके overlapping time intervals से मिलाएँ, केवल पास-पास के timestamps से नहीं।
गणना से पहले सहप्रसरण का लक्ष्य तय करें
मान लें कि साझा horizon \([0,T]\) में दो परिसंपत्तियों के latent efficient log prices \(X_t\) और \(Y_t\) हैं। एक सरल सतत diffusion model में
\[ dX_t=\mu^X_t\,dt+\sigma^X_t\,dW^X_t,\qquad dY_t=\mu^Y_t\,dt+\sigma^Y_t\,dW^Y_t, \]
जहाँ तात्कालिक Brownian correlation \(d[W^X,W^Y]_t=\rho_t\,dt\) है। लक्ष्य समाकलित सह-परिवर्तन है:
\[ [X,Y]_T=\int_0^T \sigma^X_t\sigma^Y_t\rho_t\,dt. \]
यह चुनी गई observation window पर जमा होने वाली path quantity है। यह स्थिर price levels का covariance नहीं और अपने आप correlation भी नहीं है। इसकी इकाई दोनों returns की इकाइयों का गुणनफल है: यदि log returns को percentage points में व्यक्त किया जाए, तो अनुमान की इकाई square percentage points होगी। Realized volatility की गणना गाइड एक-चर के squared-return measure को समझाती है, और वित्त में quadratic variation गाइड उस path quantity को समझाती है जिसे multivariate realized covariance विस्तारित करता है।
लक्ष्य धनात्मक या ऋणात्मक हो सकता है। धनात्मक समाकलित सह-परिवर्तन का अर्थ है कि एक ही window के price increments के cross-products में समान चिह्न अधिक रहे; ऋणात्मक मान का अर्थ है कि विपरीत चिह्न वाले products हावी रहे। इनमें से कोई भी चिह्न अकेले यह साबित नहीं करता कि परिसंपत्तियाँ साथ क्यों चलीं, एक ने दूसरी को चलाया या कोई portfolio rule लाभदायक होगी।
पिछली कीमत से synchronization अनुमान को क्यों बिगाड़ सकता है
सामान्य realized covariance निकालने के लिए विश्लेषक नियमित clock time चुनकर हर परिसंपत्ति की नवीनतम उपलब्ध कीमत ले सकता है। यह सुविधाजनक है, पर परिणाम grid की चौड़ाई और interpolation convention पर निर्भर हो सकता है। जब कीमत पुरानी हो, grid के कई observations में वही quote दोहरती है। बाद का update फिर ऐसी एक return की तरह दिख सकता है जो दूसरी परिसंपत्ति की paired return से अधिक समय ढकती है।
इससे contemporaneous covariance दिखावटी lead–lag terms में जा सकता है या grid को अधिक महीन करने पर शून्य की ओर दब सकता है। Epps का empirical result बताता है कि measurement interval घटने पर observed co-movement बदलता है; बाद के शोध दिखाते हैं कि asynchronous sampling और noisy observed prices होने पर previous-tick covariance में bias हो सकता है। इसलिए high-frequency पर observed correlation घटना एक जाँचने योग्य pattern है, यह प्रमाण नहीं कि asynchronous timing ही एकमात्र कारण है।
HY हर observed return का अपना interval रखकर synchronization का एक खास चुनाव टालता है। इससे timestamps की गुणवत्ता महत्वहीन नहीं हो जाती: दोनों series के लिए साझा घड़ी, सही session boundaries और horizon के आरंभ तथा अंत का स्पष्ट नियम चाहिए। यह noisy transaction prices, खराब quotes या अलग-अलग trading sessions के मिश्रण को भी ठीक नहीं करता।
अवलोकन-अंतराल overlap करें तो returns को गुणा करें
मान लें कि परिसंपत्ति \(X\) को \(0=t_0<t_1<\cdots<t_n=T\) और परिसंपत्ति \(Y\) को \(0=s_0<s_1<\cdots<s_m=T\) समय पर देखा गया। देखे गए log-return increments हैं:
\[ \Delta X_i=X_{t_i}-X_{t_{i-1}},\qquad \Delta Y_j=Y_{s_j}-Y_{s_{j-1}}. \]
हर return को उसका समय-अंतराल दें: \(I_i=(t_{i-1},t_i]\) और \(J_j=(s_{j-1},s_j]\)। HY अनुमानक है:
\[ \widehat{[X,Y]}^{HY}_T =\sum_{i=1}^{n}\sum_{j=1}^{m} \Delta X_i\,\Delta Y_j\, \mathbf{1}\{|I_i\cap J_j|>0\}. \]
Indicator तभी cross-product शामिल करता है जब दोनों return intervals का overlap धनात्मक अवधि का हो। केवल साझा endpoint होना धनात्मक अवधि का overlap नहीं है। एक increment दूसरी परिसंपत्ति के एक से अधिक increments से overlap कर सकता है; हर ऐसा cross-product एक बार शामिल होता है। तरीका कीमतों को आगे नहीं ले जाता और किसी return को काल्पनिक छोटे returns में नहीं बाँटता।
पारंपरिक continuous-diffusion setup में, पर्याप्त छोटे observation intervals और उचित sampling conditions के साथ, अधिकतम interval length घटने पर यह sum integrated covariation की ओर जाता है। मूल परिणाम असमकालिक observations के लिए है और मानता है कि observed prices में raw tick data का सामान्य microstructure noise नहीं है।
<!-- learn:illustration -->
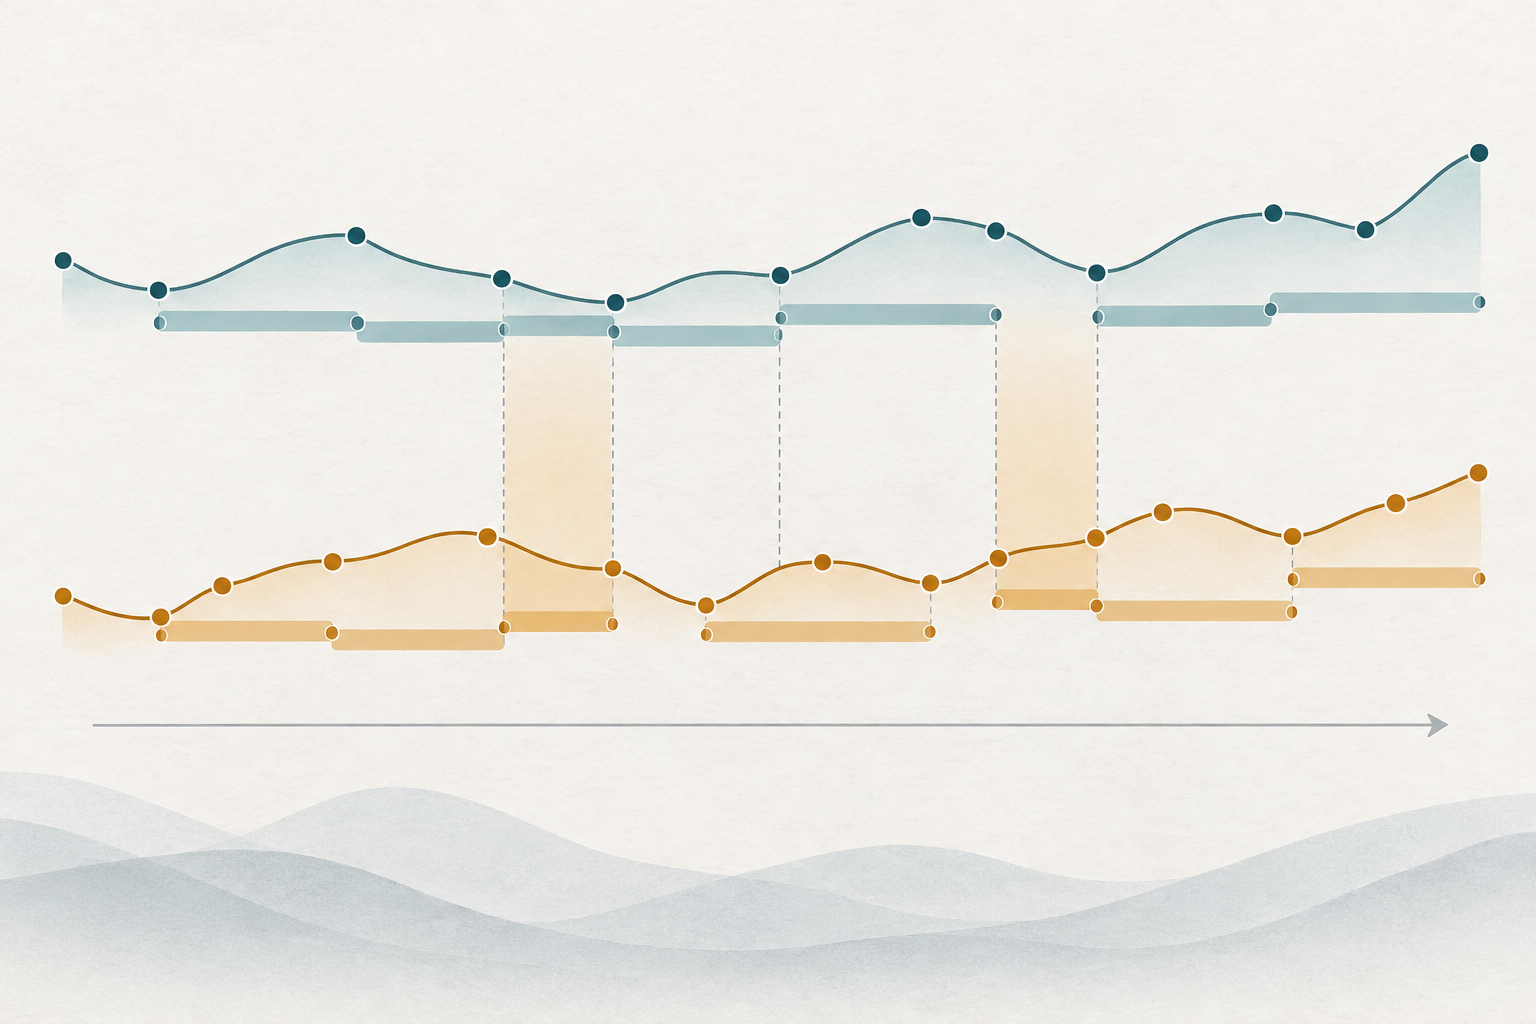
एक छोटा काल्पनिक overlap calculation दोहराएँ
मान लें कि दो परिसंपत्तियों को समान पाँच-unit session में देखा गया। तालिका काल्पनिक log returns को percentage points में और हर return द्वारा ढके interval को दिखाती है। Observation times अलग-अलग हैं, इसलिए सभी interval endpoints एक जैसे नहीं हैं।
| X का समय-अंतराल | प्रतिफल | Y का समय-अंतराल | प्रतिफल | अतिव्यापन गुणनफल |
|---|---|---|---|---|
| \((0,1.8]\) | \(+0.40\%\) | \((0,1.0]\) | \(+0.30\%\) | \(+0.12\ \mathrm{pp}^2\) |
| \((0,1.8]\) | \(+0.40\%\) | \((1.0,2.4]\) | \(+0.50\%\) | \(+0.20\ \mathrm{pp}^2\) |
| \((1.8,3.2]\) | \(+0.20\%\) | \((1.0,2.4]\) | \(+0.50\%\) | \(+0.10\ \mathrm{pp}^2\) |
| \((1.8,3.2]\) | \(+0.20\%\) | \((2.4,3.9]\) | \(-0.20\%\) | \(-0.04\ \mathrm{pp}^2\) |
| \((3.2,5]\) | \(-0.10\%\) | \((2.4,3.9]\) | \(-0.20\%\) | \(+0.02\ \mathrm{pp}^2\) |
| \((3.2,5]\) | \(-0.10\%\) | \((3.9,5]\) | \(+0.10\%\) | \(-0.01\ \mathrm{pp}^2\) |
उदाहरण के लिए, \(X\) का पहला interval \(Y\) के पहले interval से 0 से 1.0 तक और दूसरे से 1.0 से 1.8 तक overlap करता है, इसलिए दोनों cross-products जुड़ते हैं। अगला \(X\) return, \(Y\) के दूसरे return से 1.8 से 2.4 तक और तीसरे से 2.4 से 3.2 तक overlap करता है। \(X\) के अंतिम दो overlaps का योगदान \(0.02-0.01\ \mathrm{pp}^2\) है। छह शामिल products का योग है:
\[ \widehat{[X,Y]}^{HY}_T =0.12+0.20+0.10-0.04+0.02-0.01 =0.39\ \mathrm{pp}^2. \]
एक percentage point decimal-return इकाइयों में \(0.01\) है, इसलिए \(0.39\ \mathrm{pp}^2=3.9\times10^{-5}\) decimal log-return squared इकाइयों में। ये इनपुट केवल गणना को दोहराने योग्य बनाने के लिए काल्पनिक हैं; ये देखी गई कीमतें या market data नहीं हैं। नतीजा इस window के लिए cumulative covariance estimate है, प्रतिशत return, correlation या market observation नहीं।
चिह्न और माप समझें, covariance को trading signal न बनाएँ
उदाहरण में धनात्मक योग बताता है कि overlap intervals के positive-positive और negative-negative products, negative products से अधिक थे। इसका अर्थ यह नहीं कि किसी asset में 0.39% वृद्धि हुई या उनकी चालों का 39% साझा था। Covariance return units, window की अवधि और गतिविधि के साथ scale करता है; बड़ा आंकड़ा अलग इकाई या horizon को दर्शा सकता है, अधिक standardized dependence को नहीं।
Correlation की कोई इकाई नहीं होती और इसके लिए covariance को volatility estimates से scale करना पड़ता है। अलग-अलग sampling या अलग-अलग estimation से मिले variance terms का साधारण अनुपात अपने आप वैध correlation estimate नहीं होता। सीमित नमूने में यह अनुपात \([-1,1]\) से बाहर भी जा सकता है। Integrated covariance अकेले common news, कीमतों के देर से समायोजन, साझा exposure या अन्य mechanisms में भेद नहीं करता।
Portfolio application में asset weights, horizon, return units और covariance convention बताएं। धनात्मक HY estimate को खरीद संकेत और ऋणात्मक को hedge निर्देश न मानें। Forex pair correlation गाइड बताती है कि correlation और shared exposure की सावधानी से व्याख्या क्यों जरूरी है। ऐतिहासिक realized measure चुनी हुई data window का सार देती है; यह अगली return का पूर्वानुमान नहीं करती और न यह सुनिश्चित करती है कि hedge भविष्य का नुकसान भर देगा।
पारंपरिक HY की sampling और price assumptions जानें
क्लासिक अनुमानक diffusion-जैसी कीमतों के लिए बनाया गया था जिन्हें अलग-अलग, असमकालिक समय पर देखा जाता है। व्यावहारिक approximation के लिए पर्याप्त observations चाहिए, ताकि हर series का सबसे बड़ा gap analysis window की तुलना में छोटा हो। लंबे no-trade gap बहुत-सी संभावित चालों को ढकने वाले बड़े returns छोड़ते हैं; formula फिर भी निकाला जा सकता है, पर fine-sampling approximation कमजोर हो सकती है।
देखी गई transaction prices में bid–ask bounce, price discreteness, stale quotes, latency और अन्य measurement effects हो सकते हैं। HY का overlap rule timing mismatch संभालता है; यह price errors नहीं हटाता। Griffin और Oomen ने asynchronous sampling और iid microstructure noise के साथ realized covariance, lead–lag adjustments और HY के गुणों का अध्ययन किया। उनके परिणाम में finite-sample relative performance noise और correlation conditions पर निर्भर थी (Griffin & Oomen, 2011)। इसलिए plain HY को सामान्य रूप से noise-robust बताना उचित नहीं।
Model को विश्वसनीय common horizon भी चाहिए। यदि एक market दूसरे से पहले बंद हो जाए, तो समान calendar window समान सक्रिय trading period का प्रतिनिधित्व नहीं कर सकती। Time-zone conversion, daylight-saving change, auction prints, corporate actions, missing intervals और outlier filtering overlap set बदल सकते हैं। Timestamps को केवल administrative detail न मानकर इन निर्णयों को दर्ज करें।
बिंदु-अनुमान से अलग सांख्यिकीय निष्कर्ष और शोर-प्रबंधन चुनें
Point estimate confidence interval नहीं है। Hayashi और Yoshida ने बाद में सामान्य असमकालिक sampling scheme के अंतर्गत asymptotic normality स्थापित की, लेकिन लागू standard error के लिए feasible variance estimator और sampling design के अनुरूप assumptions चाहिए। Sparse या बहुत असमान observations से uncertainty बड़ी हो सकती है, भले overlap sum स्थिर दिखे।
Noisy high-frequency prices के लिए ऐसा तरीका अपनाएँ जो noise और asynchronicity दोनों के लिए बनाया गया हो, या noise सीमित करने वाले sampling और preprocessing rule को उचित ठहराएँ। Christensen, Kinnebrock और Podolskij ने noisy diffusion models में asynchronous data के लिए pre-averaging covariance estimators बनाए, जिनमें pre-averaged HY-जैसा estimator शामिल है जिसे raw prices को पहले align किए बिना लागू किया जा सकता है (Christensen et al., 2010)। Barndorff-Nielsen और सहलेखकों के multivariate realized kernels noise और nonsynchronous trading के अंतर्गत covariation को लक्ष्य करते हैं और positive-semidefinite covariance estimate देने के लिए बनाए गए हैं (Barndorff-Nielsen et al., 2011)। Realized-kernel estimator गाइड इस विकल्प को विस्तार से समझाती है।
जब portfolio optimizer या risk system को सुसंगत covariance matrix चाहिए, तब यह matrix property महत्वपूर्ण है। अलग-अलग overlap sets पर निकाले गए pairwise HY estimates से बनी matrix के positive-semidefinite होने की गारंटी नहीं होती। Eigenvalue बदलकर इसे चुपचाप “ठीक” न करें; projection, shrinkage या वैकल्पिक estimator को अलग modeling step के रूप में रिपोर्ट करें। Noise-robust estimates में भी tuning choices और assumptions होते हैं; वे हर market-data defect को अपने आप ठीक नहीं करते।
पुनरुत्पादित estimate और उसकी सीमाएँ रिपोर्ट करें
उपयोगी report में बताएं कि दोनों price series trade, quote या midpoint हैं; साझा clock और session; \([0,T]\) का आरंभ और अंत; return transformation; overlap convention; sampling gaps का सार; और इस्तेमाल किया गया estimator। Covariance units और window दिखाएँ। Stale observations, outliers, jumps, auctions, market closures और microstructure noise को कैसे संभाला, यह दर्ज करें। Input असमकालिक हों तो बताएं कि raw intervals इस्तेमाल किए या prices को पहले synchronize किया।
Integrated covariance को आदतन rate या annualized संख्या में न बदलें। यदि window estimate को rate या annualized value में बदलते हैं, तो time-scaling assumption तथा overnight periods और market closures का व्यवहार स्पष्ट करें। Correlation estimate करने पर denominator के variance estimators बताएं और जाँचें कि परिणामी matrix आवश्यक constraints मानती है। ये reporting choices interpretation को उतना ही प्रभावित करते हैं जितना overlap formula।
Hayashi–Yoshida estimator का लाभ यह है कि वह synchronized कीमतें गढ़े बिना असमकालिक intervals के cross-products को सीधे और दोहराने योग्य ढंग से जोड़ता है। इसकी पारंपरिक guarantee उपयुक्त noise-free diffusion framework और पर्याप्त सघन sampling पर निर्भर है। यह causality स्थापित नहीं करता, microstructure noise हल नहीं करता और भरोसेमंद hedge या trading rule की गारंटी नहीं देता।
आम सवाल
Q1क्या HY estimator के लिए दोनों परिसंपत्तियों का एक ही क्षण पर trade होना जरूरी है?
नहीं। इसे समय के अंतर को संभालने के लिए बनाया गया है। Observation timestamp अलग होने पर भी return intervals overlap करें तो यह उन्हें गुणा करता है।
Q2क्या HY noisy transaction prices पर सीधे काम करता है?
पारंपरिक अनुमानक diffusion model के अंतर्गत असमकालिक sampling संभालता है, हर तरह का microstructure noise नहीं। Bid–ask bounce, discrete prices, stale quotes और ऐसे प्रभावों के लिए अलग noise-robust method या सावधानी से उचित ठहराई sampling procedure चाहिए हो सकती है।
Q3क्या HY estimate correlation है?
नहीं। यह integrated covariance estimate करता है, जिसकी इकाई दोनों return units का गुणनफल है। Correlation के लिए volatility scaling चाहिए, और asynchronous inputs से निकले finite-sample estimates correlation-matrix constraints का पालन न करें।
Q4क्या धनात्मक HY estimate को trading signal की तरह इस्तेमाल कर सकते हैं?
अपने आप नहीं। यह ऐतिहासिक window के cross-products का सार है; यह causality नहीं दिखाता, भविष्य का co-movement नहीं बताता और execution costs या बदलते risk को शामिल नहीं करता।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
पारंपरिक Hayashi–Yoshida sum में कौन-से return pairs आते हैं?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
विस्तृत गाइड पढ़ेंQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
विस्तृत गाइड पढ़ेंIV rankThe current IV's position between a lookback-period low and high; one outlier can distort it, so it should not be read as a standalone signal.
विस्तृत गाइड पढ़ें