

Estimateur de Roll du spread bid-ask : formule, exemple et limites
Découvrez comment l’estimateur de Roll déduit un spread bid-ask effectif de l’autocovariance négative des rendements, avec un calcul hypothétique et les limites de ses hypothèses
Dans ce guideCe que l’estimateur de Roll cherche à mesurer
Bref résumé
L’estimateur de Roll déduit un spread bid-ask effectif impliqué par le modèle à partir de la covariance négative entre les rendements de prix de transaction consécutifs. Il nécessite des prix de transaction plutôt que l’historique des cotations, mais son résultat dépend d’hypothèses sur le prix efficient, le sens des transactions, l’échantillonnage et la stabilité du spread.
Ce que l’estimateur de Roll cherche à mesurer
Le spread coté correspond au prix ask moins le prix bid à un instant donné. Le spread effectif résume plutôt le coût réellement supporté par les transactions exécutées par rapport au prix moyen au même moment. L’estimateur de Roll est un indicateur de basse fréquence de ce spread effectif : il utilise la covariance sérielle des variations observées des prix de transaction pour déduire l’écart de prix susceptible d’avoir provoqué des retournements à court terme.
Son intérêt tient au peu de données nécessaires. Si des prix de transaction fiables sont disponibles, mais pas les cotations historiques bid et ask ni les indicateurs du sens de la transaction, l’estimateur reste calculable. Il peut donc être utile pour des comparaisons historiques et sur des marchés dont les archives de cotations sont incomplètes. Il ne reconstitue toutefois pas le carnet d’ordres, n’identifie pas le côté de chaque transaction et n’indique pas au trader le spread actuellement disponible. L’article original de Roll établit cette mesure dans le cadre d’un marché efficient et précise que la grandeur estimée est un spread effectif, pas nécessairement le spread coté affiché (Roll, 1984).
Cette estimation n’est pas non plus une mesure complète des coûts de transaction. Elle ne comprend ni les commissions, ni l’impact de marché d’un ordre particulier, ni le coût d’attente, ni les quantités non exécutées, ni les mouvements de prix après l’observation. Considérez-la comme un résumé historique, fondé sur un modèle, du comportement des prix de transaction, et non comme une cotation exécutable ou un modèle complet des coûts de backtest.
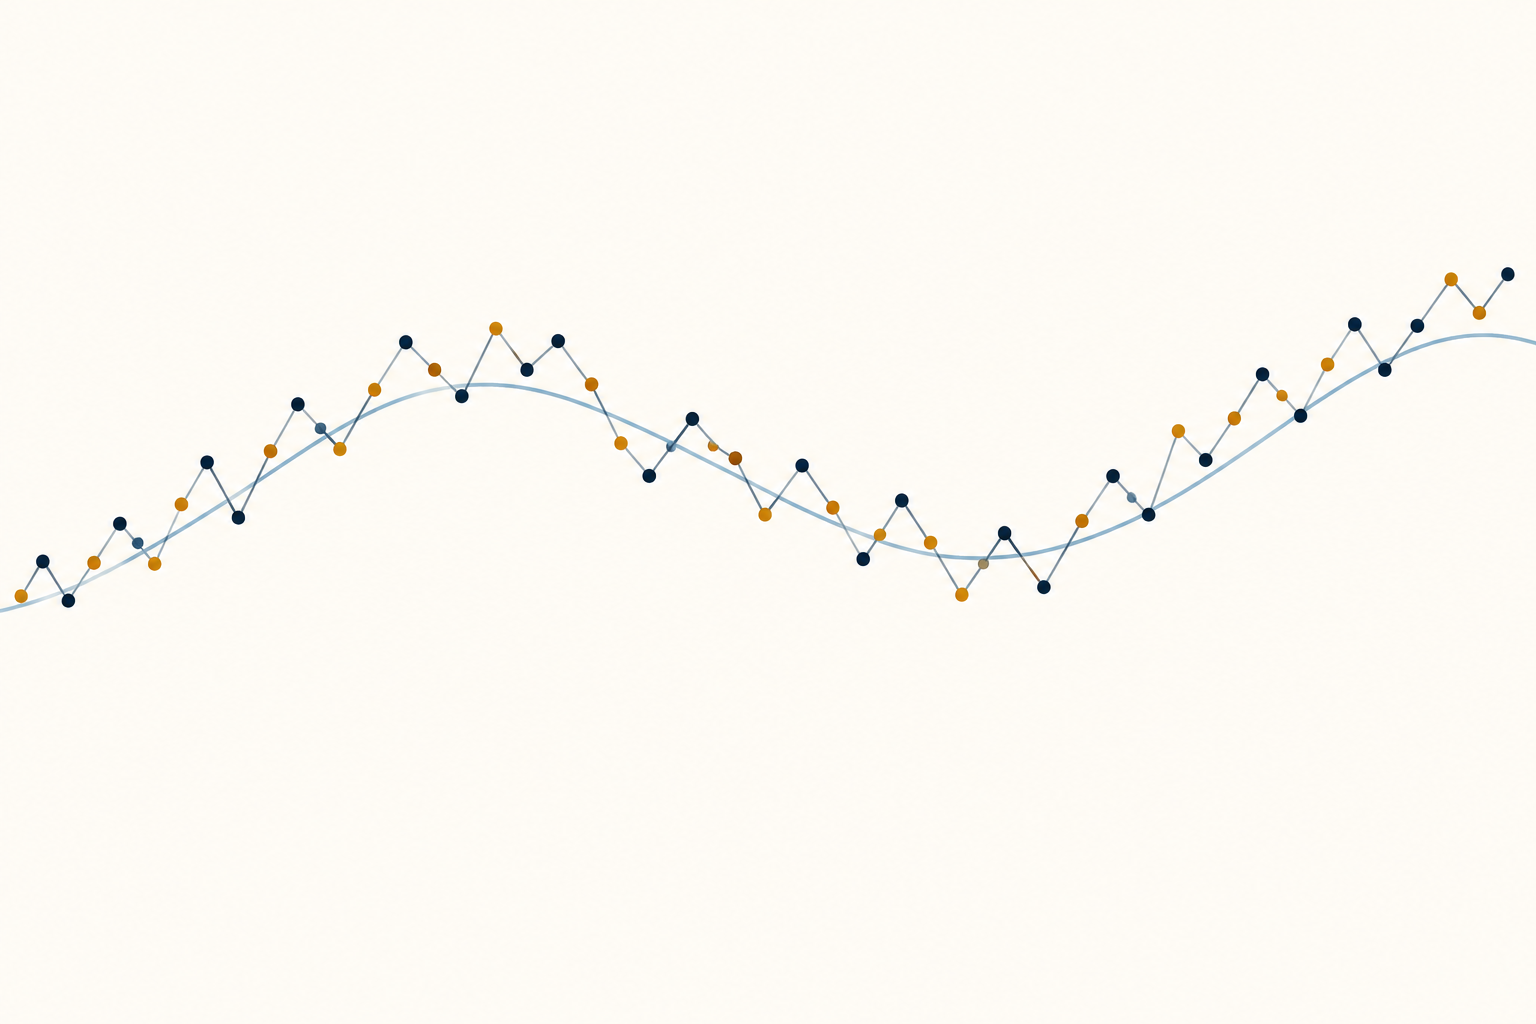
Le rebond bid-ask génère une covariance négative
Soit \(x_t\) le logarithme du prix de transaction, \(m_t\) le logarithme de la valeur non observée autour de laquelle se situent les prix bid et ask, et \(s\) le spread effectif complet en unités de prix logarithmiques. Dans le modèle simple et symétrique,
\[ x_t=m_t+\frac{s}{2}q_t, \]
où \(q_t=+1\) désigne une transaction initiée par l’acheteur au prix ask et \(q_t=-1\) une transaction initiée par le vendeur au prix bid. Le rendement observé est donc
\[ r_t=\Delta x_t=\Delta m_t+\frac{s}{2}(q_t-q_{t-1}). \]
Supposons que les signes des transactions soient indépendants et que \(+1\) et \(-1\) soient équiprobables, que les innovations de la valeur efficiente n’aient aucune covariance sérielle et que le spread reste constant pendant l’échantillon. Lorsqu’une transaction passe d’un côté du marché à l’autre, le prix de transaction traverse le spread même si la valeur sous-jacente change à peine. Un achat au prix ask suivi d’une vente au prix bid produit un rendement négatif, puis un retournement positif, ou la séquence inverse. Si deux transactions consécutives ont lieu du même côté, la composante du spread entre ces observations peut être nulle.
Sous ces hypothèses, la composante du spread fait évoluer les rendements consécutifs en moyenne dans des directions opposées :
\[ \operatorname{Cov}(r_t,r_{t-1})=-\frac{s^2}{4}. \]
En isolant \(s\), on obtient la formule de Roll. Ce profil de covariance découle du modèle lorsque ses hypothèses sont respectées ; il ne prouve pas que chaque retournement de prix observé soit dû au spread bid-ask.
<!-- Illustration placement: after section 3; text-free conceptual comparison of a smooth underlying value path with transaction prices alternating above and below it. No labels, axes, or values. -->
Utilisez la covariance de premier ordre, pas l’autocorrélation
Notons la covariance de premier ordre \(C_1=\operatorname{Cov}(r_t,r_{t-1})\). Pour un échantillon de \(T\) rendements, une convention courante de calcul sur l’échantillon est
\[ \widehat C_1=\frac{1}{T-1}\sum_{t=2}^{T}(r_t-\bar r)(r_{t-1}-\bar r), \]
où \(\bar r\) est la moyenne de l’échantillon. Si \(\widehat C_1<0\), l’estimateur par substitution est
\[ \widehat s_{\text{Roll}}=2\sqrt{-\widehat C_1}. \]
Le résultat a les mêmes unités que les rendements utilisés pour calculer la covariance. Si \(r_t\) est un rendement logarithmique, \(\widehat s\) est un spread proportionnel ou en unités de prix logarithmiques. Si l’entrée est une variation de prix en dollars plutôt qu’un rendement, l’estimation est exprimée en unités de prix. Précisez la transformation, l’intervalle d’échantillonnage et la convention de covariance avant de comparer des estimations entre actifs ou périodes.
Roll met l’accent sur la covariance plutôt que sur la corrélation. La corrélation divise par la variance inconditionnelle du rendement, qui inclut les variations dues aux nouvelles informations incorporées dans la valeur efficiente. Cette variance liée aux nouvelles peut changer même si le mécanisme du spread reste identique. Dans le modèle, la covariance non normalisée est directement reliée au spread au carré ; la remplacer par une autocorrélation modifie l’estimateur et son interprétation. Si une étude utilise des logarithmes de prix, des rendements redimensionnés ou un autre dénominateur, elle doit préciser cette convention.
Un calcul hypothétique transforme −1.44 bp² en une estimation de 2.4 bp
Supposons qu’un échantillon hypothétique de rendements logarithmiques de prix de transaction soit exprimé en points de base et que sa covariance d’échantillon de premier ordre, après retrait de la moyenne, soit de \(-1.44\,\text{bp}^2\). L’estimation est alors
\[ \widehat s_{\text{Roll}}=2\sqrt{-(-1.44)}=2\sqrt{1.44}=2(1.20)=2.40\,\text{bp}. \]
Dans le cadre du modèle, il s’agit d’une estimation du spread proportionnel complet de \(2.40\) points de base, soit \(0.024\%\). Pour un prix moyen hypothétique de \(\$100\), la conversion approximative en dollars pour un spread faible est
\[ \$100\times 0.00024=\$0.024 \]
par action pour le spread complet. La moitié, soit environ \(\$0.012\) par action, correspond à la distance entre le prix moyen et l’un des côtés. Si les cotations restaient inchangées et qu’un trader achetait 1 000 actions au prix ask avant de les vendre au prix bid, l’écart de prix correspondant au spread complet serait d’environ \(\$24\), hors commissions, autres frais, mouvement des prix et impact de marché. Ce sont des conversions illustratives, pas des cotations observées ni un coût d’exécution garanti.
Le calcul ne montre pas si \(\$100\) était un prix moyen auquel il était possible d’exécuter une transaction, quelle quantité était disponible ni à quel prix un ordre aurait été exécuté. Une estimation de Roll peut réduire un échantillon historique à une statistique unique et masquer les différences selon l’heure, la taille de l’ordre ou l’état du marché. Ne comparez pas l’estimation au spread actuellement affiché si l’actif, l’intervalle et la définition du spread ne correspondent pas.
La variation du spread et des fenêtres d’échantillonnage change la grandeur estimée
Supposer que \(s\) est constant est une simplification. Roll étudie aussi un spread qui varie dans le temps et établit, dans le modèle, un lien avec la moyenne des spreads au carré. Dans ce cas, appliquer la formule de la racine carrée correspond généralement à un spread égal à la racine de la moyenne des carrés (RMS), et non nécessairement au spread moyen arithmétique. Quelques observations de spreads larges peuvent donc peser de façon disproportionnée dans l’estimation, puisque le spread intervient au carré.
L’article original présente aussi un résultat dont la portée peut sembler plus large qu’elle ne l’est : sous les hypothèses du modèle, la covariance attendue induite par le spread ne dépend pas de la longueur d’un intervalle d’observation non chevauchant. Cela ne garantit pas que les estimations empiriques quotidiennes, hebdomadaires et intrajournalières coïncident. Les signes des transactions réelles peuvent persister entre les observations, certains intervalles ne comportent aucune transaction et les conditions de spread évoluent. Changer l’intervalle modifie également la transaction qui devient le prix d’échantillon et la quantité de bruit informationnel intégrée à chaque rendement.
Choisissez la règle d’échantillonnage avant d’examiner le résultat. Par exemple, comparez des prix de transaction échantillonnés de manière cohérente au lieu de mélanger les transactions officielles de clôture, les marques de prix moyen et les derniers prix devenus obsolètes. Précisez si les rendements couvrent le temps calendaire ou les séances de négociation, comment les jours fériés et les périodes sans transactions sont traités, et si les opérations sur titres ou les changements d’échéance des contrats ont été ajustés. Un intervalle différent constitue un autre plan empirique, même si la formule reste la même.
Une covariance positive rend l’estimation de base indéfinie
La racine carrée est réelle uniquement si la covariance de l’échantillon est négative. Si \(\widehat C_1=0\), le calcul par substitution renvoie zéro ; si \(\widehat C_1>0\), la formule de base est indéfinie. Une covariance d’échantillon nulle ou positive ne prouve pas que le spread réel soit nul. Elle peut refléter le bruit d’échantillonnage, la persistance du sens des transactions, la discrétisation des prix, la dépendance sérielle des rendements de la valeur efficiente ou un spread trop faible pour être distingué du bruit dans un échantillon court.
Certaines applications empiriques remplacent une covariance positive par zéro avant de calculer la racine carrée. D’autres prennent la valeur absolue ou ne rapportent que les fenêtres où la covariance est négative. Ces choix permettent d’obtenir un nombre, mais ce sont des règles supplémentaires, et non des conséquences de l’équation de Roll. Indiquez combien d’estimations étaient indéfinies, à quelle fréquence l’estimation a été mise à zéro et si les exclusions ont modifié l’échantillon. Prendre silencieusement la valeur absolue peut transformer une covariance contraire au modèle en estimation positive du spread.
Les petits échantillons posent un autre problème. La covariance elle-même est estimée avec une erreur, puis transformée par une racine carrée. Harris analyse les propriétés en échantillon fini sous le modèle de Roll et montre que le bruit peut produire des covariances positives et que la transformation non linéaire peut entraîner un biais important (Harris, 1990). Indiquez la longueur de l’échantillon avec l’estimation ponctuelle et sa sensibilité à des changements raisonnables de fenêtre ; ne donnez pas une précision que les données de prix ne justifient pas.
La persistance des signes de transaction ou des variations du prix efficient peut invalider le modèle
La dérivation simple exige davantage qu’une covariance négative. Elle suppose que les transactions initiées par les acheteurs et les vendeurs sont indépendantes et équiprobables ; que le spread est symétrique autour d’une valeur efficiente ; que les innovations de cette valeur n’ont pas de covariance sérielle ; et que le processus d’échantillonnage représente le mécanisme des prix de transaction. Le fractionnement des ordres au marché et la gestion des stocks peuvent rendre les signes de transaction persistants. Si les achats arrivent par séries, les rendements de transaction peuvent conserver une composante positive liée au spread et la covariance négative être plus faible que prévu par le modèle.
La trajectoire du prix moyen peut également présenter une dépendance sérielle. Momentum, retournement, prix obsolètes, observations asynchrones ou ajustements programmés peuvent créer une covariance positive ou négative des rendements sans variation correspondante du spread effectif. La discrétisation des prix et les effets de taille de tick peuvent aussi générer leurs propres retournements. Ces effets n’ont pas besoin de dominer l’échantillon pour compter : l’estimateur déduit le spread d’un seul moment, et tout autre processus influençant ce moment peut donc brouiller le résultat.
Les variations temporelles distinguent aussi la moyenne de l’échantillon d’une caractéristique stable du marché. Le spread peut s’élargir autour des nouvelles, à l’ouverture et à la clôture, pendant les périodes de faible activité ou en situation de tension. Une estimation sur toute la période peut masquer ces épisodes ; les fenêtres courtes peuvent, à l’inverse, être trop bruitées pour estimer la covariance. Examinez la série temporelle et précisez la définition de la fenêtre. Une covariance sérielle négative est compatible avec le rebond bid-ask dans le modèle, mais ne constitue pas une décomposition causale de tous les mouvements de prix à court terme.
Les données de cotation et les autres estimateurs de basse fréquence répondent à des questions différentes
Si des données fiables de cotation et de transaction sont disponibles, il est possible de calculer directement le spread effectif en comparant chaque prix de transaction au prix moyen simultané et en tenant compte du sens de la transaction. Il faut pour cela des observations synchronisées et nettoyées ainsi qu’une règle claire pour les cotations verrouillées, croisées, obsolètes ou hors séquence. Cette méthode mesure les transactions observées dans le jeu de données considéré, tandis que Roll déduit le spread de la covariance sérielle des prix de transaction. Le guide de classification du sens des transactions explique pourquoi les signes des transactions peuvent eux aussi nécessiter une règle d’estimation.
D’autres méthodes de basse fréquence reposent sur des informations et des hypothèses différentes. Hasbrouck propose un estimateur par échantillonneur de Gibbs à partir des cours de clôture quotidiens, plutôt que de s’appuyer uniquement sur la transformation par substitution de Roll (Hasbrouck, 2009). Corwin et Schultz utilisent les plus hauts et les plus bas quotidiens pour construire un estimateur de spread sans dépendre de la même dynamique du sens des transactions (Corwin and Schultz, 2012). Ces méthodes ne rendent pas le spread coté observable à partir de n’importe quelle série de prix ; chacune a ses propres hypothèses et son propre périmètre de validation.
La question pratique détermine la mesure à retenir. Pour comparer historiquement des marchés avec peu de données de cotation, un proxy de basse fréquence peut être utile si son taux d’échec et ses hypothèses sont indiqués. Avant de passer un ordre, vérifiez les cours bid et ask actuels, la profondeur du marché et la taille de l’ordre. Le guide du spread et du slippage sur futures distingue le spread coté des écarts d’exécution réalisés, tandis que le guide de la liquidité des ETF explique pourquoi le volume seul ne décrit pas la liquidité exécutable.
Présentez les hypothèses et ne placez pas l’estimation dans la colonne des signaux
Un rapport reproductible doit préciser si les observations sont des transactions, des cours de clôture officiels ou un autre proxy de prix de transaction ; si l’entrée correspond à des variations de prix ou à des rendements logarithmiques ; l’intervalle d’échantillonnage, le nombre d’observations, le dénominateur de la covariance et le traitement des covariances nulles ou positives. Précisez aussi l’univers d’actifs, la période, les ajustements liés aux opérations sur titres et aux changements d’échéance de contrat, les filtres de données, et si le spread est présenté en unités de prix, en pourcentage ou en points de base. Si la stabilité du spread paraît peu plausible, présentez les estimations sur des sous-périodes définies à l’avance plutôt que de sélectionner la fenêtre à la covariance la plus négative.
Une estimation de Roll est un proxy historique des coûts de transaction dans le cadre d’un modèle. Elle ne révèle pas la cotation du jour, ne garantit pas le prix d’exécution, ne mesure pas le coût total d’une stratégie et ne prédit pas le rendement suivant. L’évaluation d’un backtest nécessite toujours un modèle de coûts et d’exécution tenant compte de la taille de l’ordre, des commissions, de l’impact de marché, des exécutions partielles et du timing. Un spread estimé plus faible ne prouve pas à lui seul l’existence d’un avantage exploitable. Pour une vue plus large de la volatilité observée à différentes fréquences d’échantillonnage, consultez le guide sur la volatilité réalisée.
Questions fréquentes
Q1L’estimateur de Roll a-t-il besoin des cotations bid et ask historiques ?
Non. La version de base utilise les prix de transaction et la covariance de leurs rendements consécutifs. Elle peut donc être utilisée lorsque l’historique des cotations n’est pas disponible, mais l’estimation reste fondée sur un modèle et ne reconstitue pas la cotation réelle à chaque instant.
Q2Une autocovariance positive signifie-t-elle que le spread est nul ?
Non. La formule de base est indéfinie lorsque la covariance de l’échantillon est positive. Une convention qui tronque l’estimation à zéro ne prouve pas que le spread réel est nul ; indiquez la règle et la part des échantillons concernés.
Q3Peut-on utiliser l’estimation de Roll comme coût de spread dans un backtest en direct ?
Pas à elle seule. C’est un proxy historique reposant sur des hypothèses précises. Un backtest exige toujours des hypothèses de coûts et d’exécution adaptées à la place de marché, à la taille de l’ordre, au timing, aux commissions et au mode d’exécution.
Sources et lectures complémentaires
Signaler un problème
Nous préparons un e-mail avec le lien de cet article. Mark ne reçoit le signalement qu’après son envoi
Vérification rapide
Guide terminé ? Vérifiez vos acquis avec 3 questions
Question 01
Quelle donnée l’estimateur de Roll de base utilise-t-il pour déduire le spread ?
Choisissez une réponse pour voir l'explication
Glossaire des options
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Lire le guide approfondiHedging errorThe difference between a hedge portfolio and its target option value or P&L, caused by discrete rebalancing, jumps, model misspecification, costs, or liquidity.
Lire le guide approfondi