

Fama–MacBeth রিগ্রেশন: দুই ধাপে ঝুঁকি প্রিমিয়াম
সময়-সিরিজে beta নির্ণয় থেকে তারিখভিত্তিক cross-sectional risk price এবং সময়ের গড় পর্যন্ত Fama–MacBeth পদ্ধতি অনুসরণ করুন; standard error, Shanken adjustment ও HAC inference-এর পার্থক্য বুঝুন।
এই গাইডেসময়-সিরিজ beta নয়, exposure-এর মূল্য নির্ণয়
সংক্ষিপ্ত সারাংশ
Fama–MacBeth পদ্ধতিতে প্রতিটি পরীক্ষাধীন সম্পদের factor exposure তার সময়-সিরিজ থেকে অনুমান করা হয়। এরপর প্রতিটি তারিখে সম্পদগুলোর রিটার্নকে ওই অনুমান করা exposure-এর ওপর cross-sectionally রিগ্রেস করে risk-price slope বের করা হয়, এবং তারিখভিত্তিক slope-গুলোর সময়ের গড় নেওয়া হয়। এই slope-গুলোর সময়-সিরিজ থেকেই প্রচলিত অনিশ্চয়তা হিসাব করা হয়। তবে দ্বিতীয় ধাপের standard error অনুমান করা beta, serial dependence বা ভুলভাবে নির্দিষ্ট pricing model-কে স্বয়ংক্রিয়ভাবে বিবেচনা করে না। গড় risk price তাৎপর্যপূর্ণ হওয়া কোনো ট্রেডের লাভের হিসাব নয়।
সময়-সিরিজ beta নয়, exposure-এর মূল্য নির্ণয়
Factor beta ও factor risk price ভিন্ন প্রশ্নের উত্তর দেয়। প্রথম ধাপের সময়-সিরিজ রিগ্রেশনে কোনো সম্পদের রিটার্ন factor-এর সঙ্গে কীভাবে চলেছে, beta তা বর্ণনা করে। দ্বিতীয় ধাপের cross-section-এ অনুমান করা beta ভিন্ন এমন সম্পদগুলোর রিটার্ন কীভাবে আলাদা, তা risk-price coefficient—প্রায়ই \(\lambda\) লেখা হয়—বর্ণনা করে। Fama–MacBeth পদ্ধতিতে প্রতিটি তারিখের risk price নির্ণয় করে পরে সময়ের ওপর তার সারাংশ নেওয়া হয়।
নির্বাচিত কিছু শেয়ার বা পোর্টফোলিওর গড় রিটার্নের সঙ্গে প্রস্তাবিত risk factor-এর exposure যুক্ত কি না—গবেষণার প্রশ্ন এমন হলে এই নকশা কাজে লাগে। এটি সম্পদ মূল্যায়নের পরিসংখ্যানগত পদ্ধতি, কারণগত নকশা নয়। তৎকালীন তথ্য ব্যবহার করে বাস্তবে লেনদেন করা যেত এমন পোর্টফোলিওও এটি নিজে থেকে নির্দিষ্ট করে না।
Fama ও MacBeth-এর মূল গবেষণায় NYSE শেয়ারের জন্য ঝুঁকি-রিটার্নের পুনরাবৃত্ত cross-sectional regression ব্যবহার করা হয়েছিল। পরে Fama ও French-এর পরীক্ষাসহ বিভিন্ন গবেষণায় মাসভিত্তিক cross-sectional slope-কে গড় risk price অনুমান ও পরীক্ষার পরিচিত পদ্ধতিতে পরিণত করা হয়। পদ্ধতিটিকে পরস্পর-সংযুক্ত দুটি estimation problem হিসেবে বোঝা ভালো; প্রতিটি ধাপের অনুমান আলাদা।
প্রথম ধাপ: প্রতিটি পরীক্ষাধীন সম্পদের exposure অনুমান
প্রতিটি সম্পদ বা পরীক্ষাধীন পোর্টফোলিও \(i\)-এর জন্য এমন সময়-সিরিজ রিগ্রেশন অনুমান করুন:
\[ r^{e}_{i,t} = \alpha_i + \boldsymbol{\beta}_i^\top \mathbf{f}_t + \varepsilon_{i,t}, \]
যেখানে \(r^{e}_{i,t}\) সম্পদের excess return, \(\mathbf{f}_t\) হলো তারিখ \(t\)-এর factor-return vector, আর \(\boldsymbol{\beta}_i\) হলো exposure vector। অনুমান করা \(\hat{\boldsymbol{\beta}}_i\) দ্বিতীয় ধাপে explanatory variable হয়। শুধু market factor থাকলে একটি beta থাকে; একাধিক factor থাকলে প্রতিটির জন্য একটি estimated loading থাকে।
Slope অনুমানের জন্য প্রথম ধাপে factor-গুলোর পর্যাপ্ত সময়গত পরিবর্তন দরকার। দীর্ঘ window বেশি observation দিতে পারে, তবে ভিন্ন market regime-কে একসঙ্গে মিশিয়ে ফেলতে পারে। ছোট window সাম্প্রতিক exposure ধরতে পারে, কিন্তু beta অনুমানকে noisy রাখে। Return frequency, sample date, factor construction, missing-data rule, intercept-এর ব্যবহার এবং estimation window জানান।
সব beta-ই পুরো sample-এ অনুমান করতে হবে—এমন সার্বজনীন নির্দেশনা এটি নয়। অতীতভিত্তিক asset-pricing test-এ full-sample beta গবেষণাধীন নমুনাটিকে বর্ণনা করতে পারে। কিন্তু ঐতিহাসিক trading simulation-এ ভবিষ্যতের observation ব্যবহার করে beta অনুমান করলে তথ্য ফাঁস হবে। সেই ক্ষেত্রে প্রতিটি simulated decision-এর আগে উপলভ্য তথ্য দিয়ে point-in-time beta অনুমান করতে হবে।
দ্বিতীয় ধাপ: প্রতিটি তারিখের cross-section-এ exposure-এর মূল্য নির্ণয়
প্রতিটি তারিখ \(t\)-এ সেই তারিখের পরীক্ষাধীন সম্পদগুলোর return-কে প্রথম ধাপের beta-র ওপর রিগ্রেস করুন:
\[ r^{e}_{i,t} = \lambda_{0,t} + \hat{\boldsymbol{\beta}}_i^\top \boldsymbol{\lambda}_t + \eta_{i,t}. \]
\(\boldsymbol{\lambda}_t\)-তে তারিখভিত্তিক risk price থাকে। একটি factor থাকলে cross-sectional slope \(\lambda_t\) ওই তারিখে estimated beta এক একক ভিন্ন হওয়ার সঙ্গে সম্পর্কিত return difference মাপে। \(\lambda_{0,t}\) আলাদা cross-sectional intercept। এটি মুক্তভাবে অনুমান করা হবে, সীমাবদ্ধ থাকবে, নাকি zero-beta asset-এর return হিসেবে ব্যাখ্যা হবে—তা পরীক্ষাধীন model এবং raw না excess return ব্যবহৃত হচ্ছে তার ওপর নির্ভর করে।
দ্বিতীয় রিগ্রেশনটি একটি তারিখে সম্পদের মধ্যকার cross-section; এটি আরেকটি time-series regression নয়। এর fit নির্ভর করে পরীক্ষাধীন সম্পদের সংখ্যা ও গঠন, তাদের estimated beta-র বিস্তার এবং beta-গুলোর পারস্পরিক correlation-এর ওপর। সম্পদের beta-তে পার্থক্য সামান্য হলে risk price আলাদা করে শনাক্ত করার মতো cross-sectional তথ্যও অল্প থাকে। প্রায় একই exposure-সম্পন্ন অনেক সম্পদ যোগ করলেই অনুপস্থিত exposure variation তৈরি হয় না।
এই রিগ্রেশন বারবার চালালে \(\hat{\boldsymbol{\lambda}}_1,\ldots,\hat{\boldsymbol{\lambda}}_T\) risk-price time series পাওয়া যায়। factor \(k\)-এর Fama–MacBeth estimate হলো সময়ের গড়:
\[ \bar{\lambda}_k = \frac{1}{T}\sum_{t=1}^{T}\hat{\lambda}_{k,t}. \]
গড়ের return unit ও frequency দ্বিতীয় ধাপের return-এর মতোই। Cross-section-এ weighting, অনুপস্থিত তারিখ বা asset universe বদলে গেলে এই গড় কী বোঝায় তা বদলাতে পারে; তাই সেসব পছন্দ জানাতে হবে।
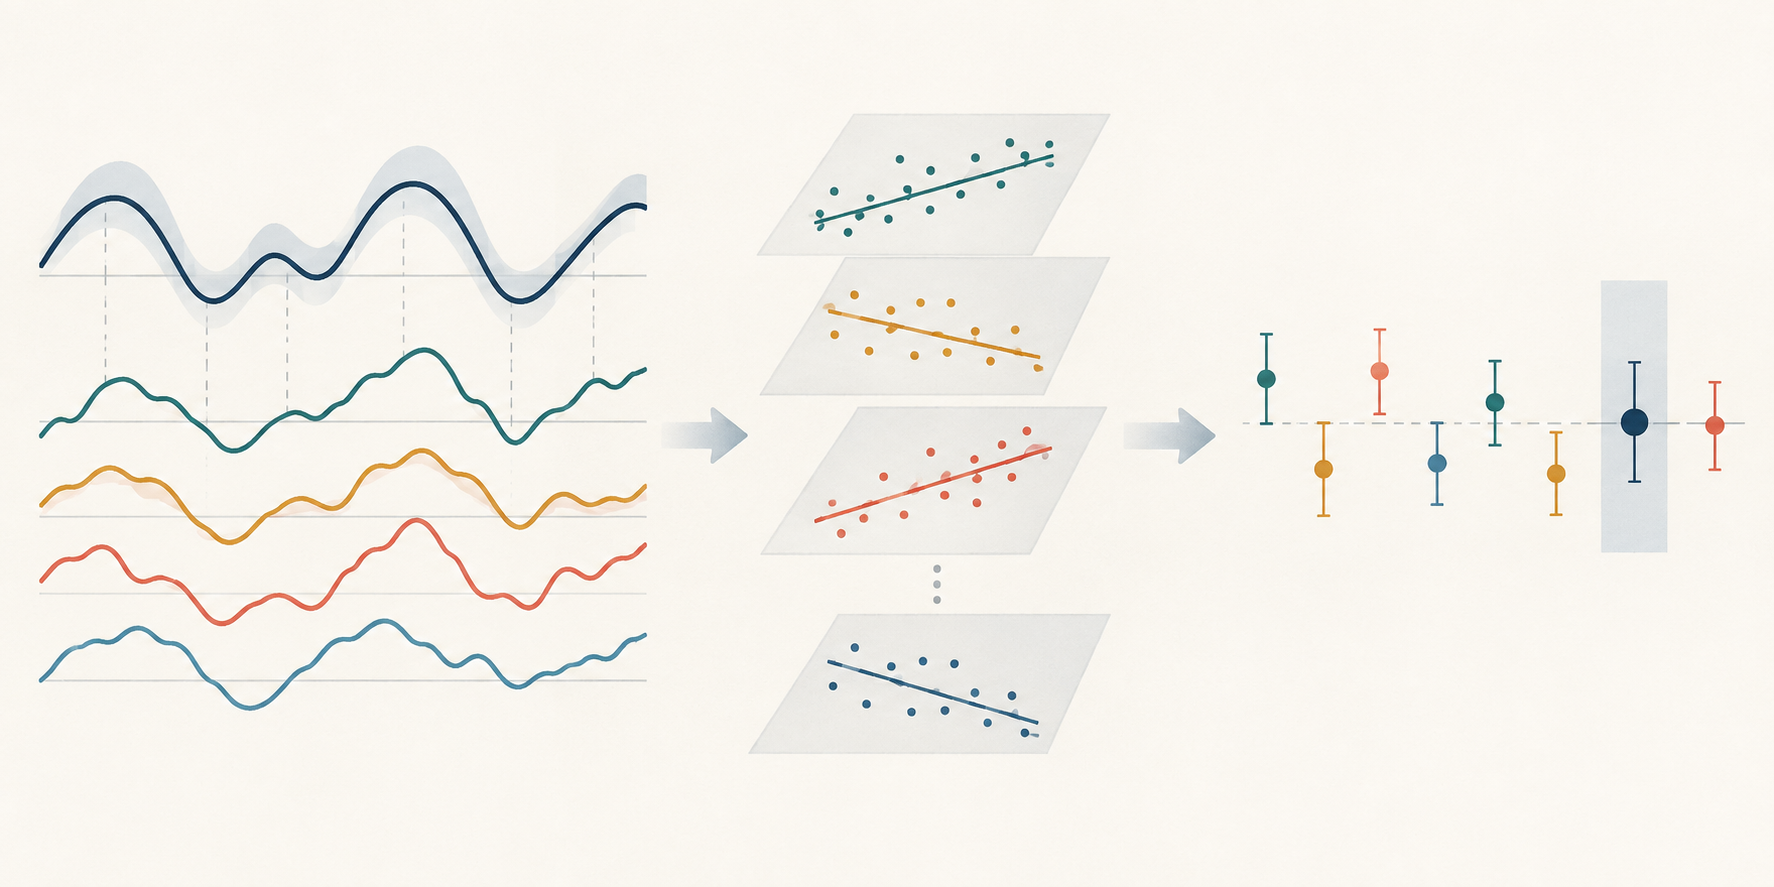
উদাহরণে এক মাস ও সময়ের গড় আলাদা করে দেখা
ধরা যাক, তিনটি পরীক্ষাধীন পোর্টফোলিওর প্রথম ধাপে অনুমান করা market beta হলো \(0.5\), \(1.0\), ও \(1.5\)। একটি কাল্পনিক মাসে তাদের excess return যথাক্রমে \(0.3\%\), \(0.8\%\), ও \(1.3\%\)। এই তিনটি বিন্দু নিচের সরলরেখায় পড়ে:
\[ r^{e}_{i,t} = -0.2\% + 1.0\%\times\hat{\beta}_{i}. \]
সেই মাসের estimated slope হলো beta-র প্রতি এককে 1.0 percentage point, আর intercept \(-0.2\%\)। এটি ইচ্ছাকৃতভাবে ছোট ও নিখুঁত fit-সহ একটি উদাহরণ; এতে market beta-র মূল্য নির্ধারিত হয় প্রমাণিত হয় না, আর তিনটি বিন্দু কার্যকর empirical test-ও দেয় না।
এবার ছয়টি আলাদা মাসে দ্বিতীয় ধাপের slope যদি beta-র প্রতি এককে \(0.8\%\), \(-0.4\%\), \(1.0\%\), \(-0.2\%\), \(0.6\%\), ও \(0.0\%\) হয়, তাদের arithmetic mean:
\[ (0.8 - 0.4 + 1.0 - 0.2 + 0.6 + 0.0)/6 = 0.3\%\text{ প্রতি মাসে}. \]
প্রথম মাসের slope চূড়ান্ত Fama–MacBeth estimate নয়; ছয়টি তারিখভিত্তিক slope-এর গড়ই estimate। ঋণাত্মক মাসগুলোও হিসাবের অংশ। শুধু ধনাত্মক মাস বাছলে estimand বদলে যায় এবং নতুন selection step যোগ হয়। বানানো সংখ্যাগুলো শুধু হিসাব দেখায়; এগুলো বাজারের ফল বা factor return পূর্বাভাস দেয়—এমন দাবি নয়।
প্রচলিত standard error-এ inference-এর মাত্রা হলো সময়
সবচেয়ে সরল হিসাবে \(T\) মাসিক slope-এর sample standard deviation \(s_\lambda\)-কে \(\sqrt{T}\) দিয়ে ভাগ করা হয়:
\[ \operatorname{SE}(\bar{\lambda}) = \frac{s_\lambda}{\sqrt{T}}. \]
সংশ্লিষ্ট t-statistic-এ গড় estimated slope-কে এই standard error দিয়ে ভাগ করা হয়। গড় risk price-এর অনিশ্চয়তা অনুমানের পুনরাবৃত্ত মাত্রা হলো সময়। সম্পদের সংখ্যা \(N\) প্রতিটি মাসের cross-section কত ভালোভাবে slope অনুমান করতে পারে তা নির্ধারণ করে; সময়ের গড়ের standard error-এ এটি \(T\)-এর বিকল্প নয়।
উপরের ছয়টি illustrative slope-এর sample standard deviation মাসে প্রায় 0.576 percentage point। একে \(\sqrt{6}\) দিয়ে ভাগ করলে প্রচলিত standard error প্রায় 0.235 percentage point; \(0.3/0.235\) প্রায় 1.28। নির্ভরযোগ্য তাৎপর্য যাচাইয়ের জন্য ছয়টি observation অনেক কম। হিসাবটি শুধু দেখায়, ধনাত্মক গড় আর নির্ভুলভাবে অনুমান করা গড় এক কথা নয়।
প্রচলিত standard error slope time series-এর কিছু শর্তের ওপরও নির্ভর করে। অনুমানগুলো serially dependent হলে স্বাধীন পর্যবেক্ষণ ধরে নেওয়া standard error অনিশ্চয়তা ভুলভাবে জানাতে পারে। নমুনা ছোট হলে বা asset mix বদলালে asymptotic t-statistic বিশেষভাবে ভঙ্গুর হতে পারে। শুধু cross-sectional asset count নয়, \(\lambda_t\) series-এর দৈর্ঘ্য ও frequency জানান।
Fama–MacBeth ও pooled OLS-এর point estimate সবসময় আলাদা নয়
“Fama–MacBeth” ও “pooled panel regression”-কে প্রায়ই এমনভাবে তুলনা করা হয় যেন তাদের slope আলাদা হবেই। একটি গুরুত্বপূর্ণ বিশেষ ক্ষেত্রে তা নয়: প্রতিটি তারিখে একই সম্পদ থাকলে, beta regressor সময়ের সঙ্গে স্থির থাকলে, এবং প্রতিটি মাসিক cross-section-এ একই ordinary least-squares design ব্যবহার করলে, তারিখভিত্তিক OLS coefficient-এর গড় pooled OLS-এর common-slope coefficient-এর সমান হয়। দুই পদ্ধতিই একই balanced cross-sectional regression-এর সারাংশ দেয়।
তারিখভেদে asset set বা weight বদলালে, beta সময়ে বদলালে, panel unbalanced হলে, control আলাদা হলে বা pooled model অতিরিক্ত সীমা আরোপ করলে এই সমতা নাও থাকতে পারে। তখন দুই পদ্ধতি তারিখ বা observation-কে আলাদাভাবে weight দিতে পারে এবং নমুনা নিয়ে ভিন্ন প্রশ্নের উত্তর দিতে পারে। শুধু পদ্ধতির নাম দেখে বাছবেন না; design matrix, weighting scheme ও লক্ষ্য coefficient নির্দিষ্ট করুন।
Point estimate একই হলেও অনিশ্চয়তার হিসাব আলাদা হতে পারে। Fama–MacBeth inference cross-sectional slope-এর সময়গত variation ব্যবহার করে। Pooled regression-এর জন্য panel error structure-এর সঙ্গে মেলে এমন covariance estimator দরকার। তারিখ বা সম্পদ ধরে clustering, two-way covariance estimate কিংবা time-series HAC estimate ভিন্ন অনুমানের ওপর নির্ভর করে; মডেলকে pooled বা Fama–MacBeth বললেই কোনোটি সঠিক হয়ে যায় না।
Estimated beta ও HAC অনিশ্চয়তার আলাদা উৎস সামলায়
দ্বিতীয় ধাপে \(\hat{\boldsymbol{\beta}}_i\)-কে জানা ধরে নেওয়া হয়, যদিও তা প্রথম ধাপের estimated regression থেকে এসেছে। Generated regressor-এর error risk-price estimate ও তার অনিশ্চয়তাকে প্রভাবিত করতে পারে। নির্দিষ্ট asset-pricing setup-এ beta-pricing inference-এর জন্য Shanken-এর বিশ্লেষণ একটি adjustment নির্ণয় করে; এটি এমন কোনো universal multiplier নয় যা সব two-pass design ঠিক করে দেয়। পরবর্তী গবেষণায় ভিন্ন শর্তে large-sample আচরণ ও বিকল্প estimator পরীক্ষা করা হয়েছে। কোন correction বা inference পদ্ধতি ব্যবহার করেছেন এবং কেন তার অনুমান প্রযোজ্য তা জানান।
\(\hat{\lambda}_{k,t}\)-এর serial correlation আলাদা সমস্যা। যেমন, overlap করা বহু-মাসের return-এ পাশাপাশি তারিখের slope একই return observation ভাগ করে নিতে পারে। Newey–West covariance estimate-এর মতো heteroskedasticity-and-autocorrelation-consistent estimator নির্বাচিত lag window পর্যন্ত serial dependence বিবেচনা করে সময়ের গড়ের estimated variance সামলায়। এটি প্রথম ধাপের beta-estimation error দ্বিতীয় ধাপে যোগ করে না, ভুল factor specification ঠিক করে না এবং look-ahead bias দূর করে না। উল্টোদিকে, Shanken adjustment lambda series-এর dependence পরীক্ষা করার বিকল্পও নয়।
Jagannathan ও Wang এবং Shanken ও Zhou নির্দিষ্ট model ও sampling condition-এ beta-pricing procedure-এর বৈশিষ্ট্য বিশ্লেষণ করেন। তাঁদের ফলাফল সাধারণ Fama–MacBeth standard error সবসময় কম বা সবসময় বৈধ—এমন blanket rule পুনরাবৃত্তির বদলে বাস্তবে ব্যবহৃত two-pass design বর্ণনা করার কারণ দেয়। Beta একবার নাকি নিয়মিত update হয়, lambda series-এর dependence কীভাবে সামলানো হয়, generated-beta correction আছে কি না এবং সে পছন্দ প্রশ্নটির সঙ্গে কেন মেলে—জানান।
তাৎপর্যপূর্ণ গড় risk price ট্রেডিং লাভের অনুমান নয়
ধনাত্মক এবং শূন্য থেকে পরিসংখ্যানগতভাবে পৃথক গড় \(\lambda\) বোঝায় যে নির্বাচিত পরীক্ষাধীন সম্পদ, factor definition, beta estimate ও inference পদ্ধতির অধীনে, নমুনায় বেশি estimated exposure-সম্পন্ন সম্পদের গড় return বেশি ছিল। এতে প্রমাণ হয় না যে বিনিয়োগকারী খরচ বাদে ওই spread পেতেন, factor-টি return-এর কারণগত উৎস, কিংবা pricing model সঠিক।
Factor set, sample period, portfolio construction, beta window, test asset বা weighting বদলালে ফল বদলাতে পারে। অনেক factor, sample cut ও specification খুঁজলে multiple-testing সমস্যা তৈরি হয়। একটি estimated risk price পরীক্ষা করলেও সব সম্পদের যৌথ pricing error-কে সারাংশে ধরা হয় না। ফলটি conditional association, model-based pricing test, না out-of-sample forecast—স্পষ্ট করুন; এগুলোকে একই অর্থে ব্যবহার করবেন না।
বাস্তব বা simulated strategy-তে exposure ও portfolio weight শুধু তখনকার উপলভ্য তথ্য দিয়ে তৈরি করতে হবে। কার্যকর entry price, turnover, trading cost, financing, capacity এবং rebalancing rule-ও দরকার। Factor beta হলো exposure estimate; গড় \(\lambda\) এমন পোর্টফোলিওর return নয়, যা স্বয়ংক্রিয়ভাবে ওই beta premium পায়। আশপাশের ধারণার জন্য factor loading ও factor model নির্দেশিকা, robust standard error ও HAC নির্দেশিকা, এবং rank information coefficient নির্দেশিকা দেখুন।
পুনরুৎপাদনের উপযোগী করে নকশা প্রতিবেদন করুন
ব্যাখ্যাযোগ্য ফলে পরীক্ষাধীন সম্পদ, factor return, ব্যবহার করলে risk-free series, return unit, তারিখের frequency এবং sample period চিহ্নিত থাকবে। প্রতিটি beta কীভাবে অনুমান করা হয়েছে, প্রথম ধাপের window দ্বিতীয় ধাপের test period-এর সঙ্গে মেলে কি না, প্রতিটি তারিখে কোন সম্পদ আছে, missing return ও membership change কীভাবে সামলানো হয়েছে, cross-section-এ weighting আছে কি না, এবং intercept রাখা বা সীমাবদ্ধ করা হয়েছে কি না—তাও জানান।
Inference-এর জন্য তারিখভিত্তিক slope-এর মোট সংখ্যা \(T\), তাদের time-series mean ও dispersion, standard-error estimator, থাকলে HAC bandwidth, beta estimation correction এবং finite-sample choice জানান। t-statistic-এর পাশাপাশি beta-র বিস্তার ও cross-sectional fit দেখান; সম্পদের সংখ্যা বেশি হলেই প্রায় অভিন্ন exposure-এর সমস্যা মেটে না। যুক্তিসংগত বিকল্প window, factor definition ও test-asset construction তুলনা করুন, তবে কেবল যে সংস্করণে p-value সবচেয়ে কম সেটি বাছবেন না।
মূল পদ্ধতি ও তার প্রয়োগ উদাহরণ, আধুনিক সব dataset তাদের অনুমান পূরণ করে—এ নিশ্চয়তা নয়। নকশার ভিন্ন অংশ নিয়ে আলোচনা করে Fama ও MacBeth-এর ১৯৭৩ সালের গবেষণা, Fama ও French-এর ১৯৯২ সালের cross-sectional test, Shanken-এর beta-pricing বিশ্লেষণ, Jagannathan ও Wang-এর asymptotic বিশ্লেষণ, Shanken ও Zhou-এর beta-pricing estimator তুলনা, এবং Newey ও West-এর HAC covariance পদ্ধতি আলাদা আলাদা বিষয় সামলায়। রিপোর্ট করা coefficient-এর পাশাপাশি সংশ্লিষ্ট অনুমানও পড়ুন।
সাধারণ প্রশ্ন
Q1Fama–MacBeth রিগ্রেশন কি causal test?
না। নির্বাচিত pricing model ও test-asset design-এর অধীনে এটি estimated exposure এবং return-এর সম্পর্ক অনুমান করে। কারণগত ব্যাখ্যার জন্য আলাদা identification argument দরকার।
Q2আরও বেশি সম্পদ যোগ করলে কি risk-price estimate সবসময় নির্ভুল হয়?
না। বেশি সম্পদ একটি তারিখের cross-section উন্নত করতে পারে, কিন্তু নির্ভুলতা নির্ভর করে beta-গুলোর পার্থক্য কত, সেগুলো কত ভালো অনুমান করা হয়েছে এবং গড়ে কতটি তারিখ আছে তার ওপরও।
Q3কখন HAC standard error ব্যবহার করব?
তারিখভিত্তিক risk-price series-এ heteroskedasticity বা serial dependence থাকতে পারে—যেমন overlapping return-এ—তখন এটি বিবেচনা করুন। Lag window জানান এবং মনে রাখুন, HAC প্রথম ধাপের beta-estimation error সংশোধন করে না।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
প্রচলিত দুই-ধাপ পদ্ধতিতে তারিখ t-তে দ্বিতীয় ধাপের slope কী অনুমান করে?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
A model decomposing asset returns into exposure to a small set of common factors and an asset-specific residual.
বিস্তারিত গাইড পড়ুনHeteroskedasticityVariation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
বিস্তারিত গাইড পড়ুনStochastic discount factorA random variable that weights future payoffs by time and state value to produce today's price; asset returns satisfy its pricing moment condition.
বিস্তারিত গাইড পড়ুন