

Ước lượng Biến động Thực hiện bằng Pre-Averaging
Tìm hiểu cách pre-averaging làm mượt các cửa sổ lợi suất ngắn, hiệu chỉnh độ chệch nhiễu chính, chọn độ dài cửa sổ và khác với TSRV cùng realized kernel.
Trong hướng dẫn nàyVì sao lợi suất quá thường xuyên có thể làm sai lệch biến động giá
Tóm tắt ngắn
Pre-averaging dùng để ước lượng biến động giá khi giá được ghi nhận rất thường xuyên có chứa nhiễu vi cấu trúc. Thay vì bình phương từng lợi suất thô, phương pháp này tạo các tổng có trọng số từ những lợi suất lân cận trong các cửa sổ chồng lấn, rồi trừ đi một thành phần hiệu chỉnh cho đóng góp nhiễu chính. Kết quả phụ thuộc vào dạng trọng số, độ dài cửa sổ, thiết kế lấy mẫu và giả định về nhiễu. Đây là phép đo biến động trong một khoảng đã quan sát, không phải dự báo biến động hay tín hiệu giao dịch.
Vì sao lợi suất quá thường xuyên có thể làm sai lệch biến động giá
Nếu giá quan sát chỉ là giá hiệu quả và không có yếu tố nào khác, tổng bình phương lợi suất trong ngày sẽ là một ước lượng tự nhiên cho biến động trong phiên. Giá giao dịch và báo giá thực tế còn phản ánh hiện tượng bid–ask bounce, làm tròn theo bước giá, độ trễ, giá rời rạc và cách ghi nhận dữ liệu. Khi khoảng lấy mẫu cực ngắn, các yếu tố đó có thể chiếm phần lớn mỗi lợi suất bình phương. Thêm quan sát khi ấy có thể làm tăng đóng góp của nhiễu thay vì chỉ hé lộ thêm chuyển động giá nền.
Pre-averaging xử lý vấn đề bằng cách kết hợp lợi suất trong một cửa sổ cục bộ ngắn trước khi bình phương. Hàm trọng số trơn tăng từ 0, gán trọng số cho các lợi suất lân cận rồi giảm về 0 ở biên cửa sổ. Tổng có trọng số hoạt động như một bộ lọc cục bộ: sai số quan sát độc lập và biến động nhanh có thể triệt tiêu một phần, trong khi chuyển động rộng hơn của giá hiệu quả vẫn có thể được giữ lại. Các cửa sổ chồng lấn giúp sử dụng thông tin trên toàn khoảng thời gian.
Làm trơn không tự nó khiến ước lượng không chệch. Nhiễu sau lọc vẫn đóng góp vào biến động, vì vậy cần một số hạng hiệu chỉnh. Jacod, Li, Mykland, Podolskij và Vetter xây dựng phương pháp pre-averaging cho biến động tích phân dưới các giả định rõ ràng và chỉ ra những phiên bản thích hợp đạt tốc độ hội tụ \(n^{-1/4}\). Bài báo gốc đặt nền tảng cho phương pháp; bài hướng dẫn này tập trung vào cách tính, lựa chọn và giới hạn.
Tách biệt giá ẩn, giá được ghi nhận và đại lượng mục tiêu
Gọi \(X_{t_i}\) là log giá hiệu quả ẩn tại thời điểm quan sát \(t_i\), còn \(Y_{t_i}\) là log giá được ghi nhận:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
trong đó \(\epsilon_{t_i}\) là nhiễu quan sát. Một mô hình cơ sở phổ biến xem \(X_t\) là bán martingale liên tục với phương sai cục bộ \(\sigma_t^2\). Mục tiêu trên khoảng cố định \([0,T]\) là phương sai tích phân:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Lợi suất quan sát được phân rã thành \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Dù sai số giá độc lập giữa các quan sát, sai số của hai lợi suất liền kề vẫn dùng chung sai số tại một đầu mút với dấu ngược nhau. Điều đó tạo phụ thuộc chuỗi trong lợi suất và khiến phương sai thực hiện tính từ mọi quan sát nhạy với số lượng gia số có nhiễu.
Mô tả lý thuyết đơn giản thường giả định nhiễu có trung bình bằng 0, độc lập theo thời gian và độc lập với quá trình giá hiệu quả, đồng thời có các moment hữu hạn phù hợp. Những giả định này giúp giải thích ước lượng nhưng không được đảm bảo với giao dịch, báo giá hoặc giá trung bình. Nhiễu có thể thay đổi theo thanh khoản và thời điểm trong ngày, phụ thuộc vào giá hiệu quả hoặc có tương quan chuỗi. Đại lượng mục tiêu cũng quan trọng: khi có bước nhảy, biến động bậc hai bao gồm bình phương bước nhảy, còn phương sai tích phân liên tục thì không.
Đây là phép đo hậu nghiệm cho chuỗi giá và khoảng thời gian xác định. Nó không khôi phục từng giá ẩn, xác định bản ghi đơn lẻ nào bị sai hay cho biết biến động tương lai. Trước khi so sánh các ước lượng, hãy nêu rõ đầu vào là giá giao dịch, trung điểm báo giá hay một cách xây dựng khác.
Tạo lợi suất pre-averaged chồng lấn
Với \(n\) lợi suất quan sát \(r_i=Y_{t_i}-Y_{t_{i-1}}\), chọn độ dài cửa sổ nguyên \(k_n\) và hàm trọng số \(g\) trên \([0,1]\). Một định nghĩa chuẩn của lợi suất pre-averaged là
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Hàm thường liên tục, bằng 0 ở cả hai đầu và đủ trơn cho các kết quả tiệm cận. Ví dụ trọng số tam giác là \(g(u)=\min(u,1-u)\). Vì trọng số tại hai đầu bằng 0, lợi suất ở biên cửa sổ không đột ngột nhận trọng số tối đa. Dạng trọng số tạo nên một bộ lọc cục bộ, không phải dự báo hay xu hướng được khớp.
Mỗi \(\bar r_i\) gộp lợi suất lân cận trước khi bình phương. Do các cửa sổ chồng lấn, lợi suất pre-averaged có tương quan ngay cả khi lợi suất thô không tương quan. Sự phụ thuộc đó là một phần trong hành vi mẫu của ước lượng; không được xem nhiều tổng cửa sổ như các quan sát độc lập. Phạm vi chỉ số cửa sổ và quy ước xử lý đầu mút phải khớp với cách chuẩn hóa trọng số.
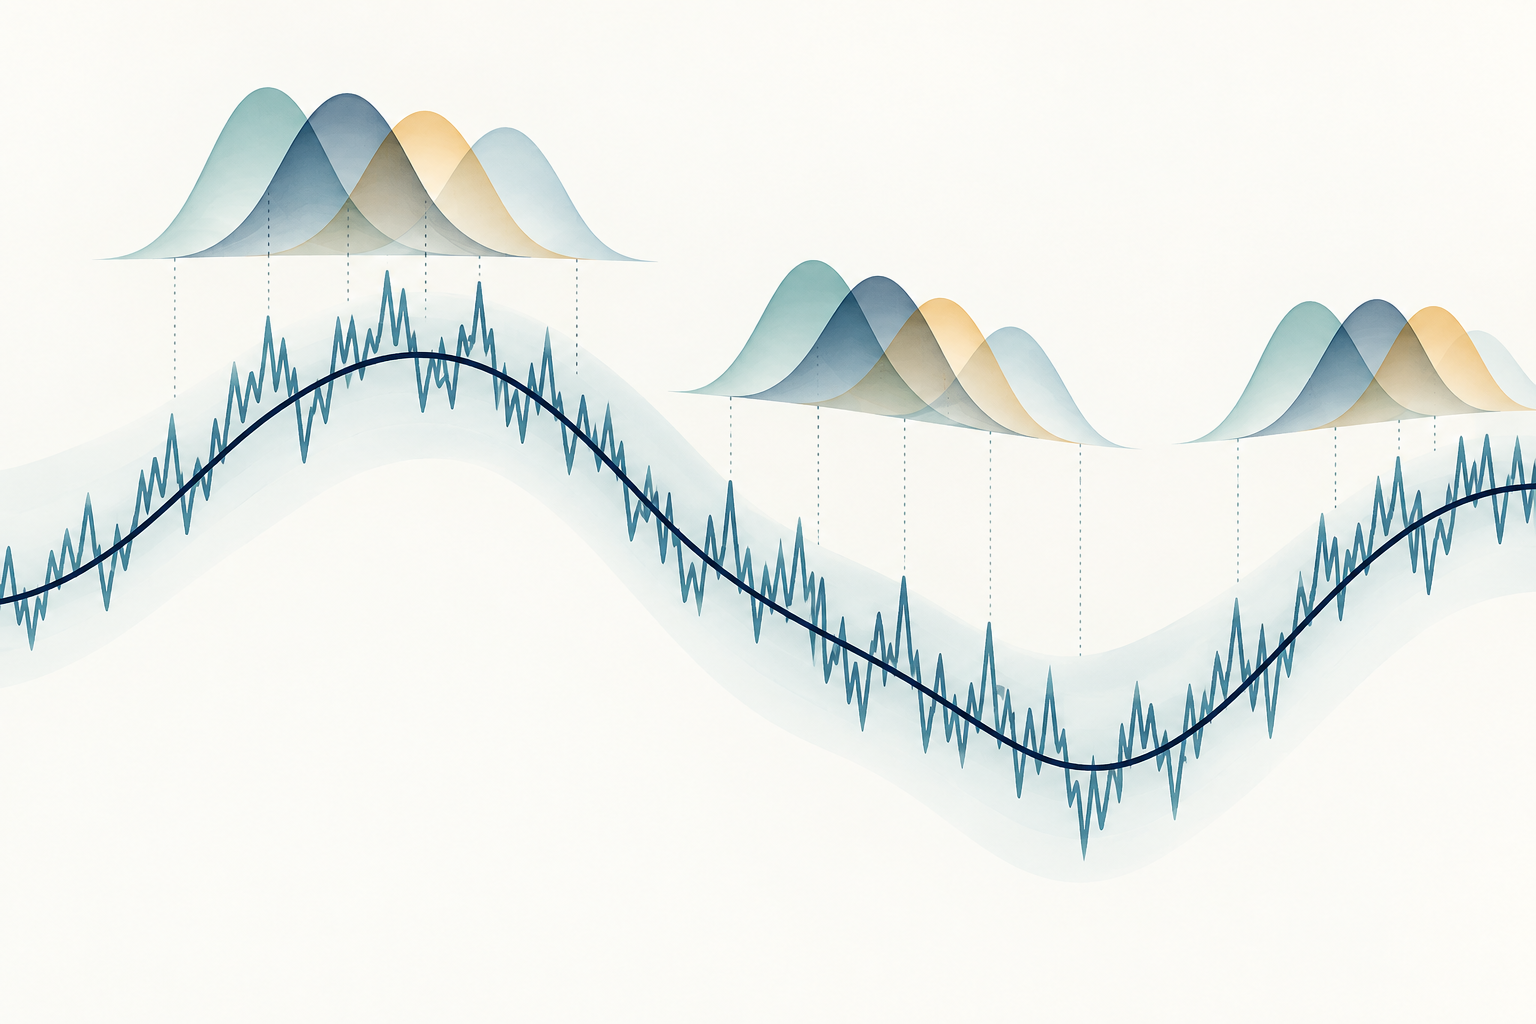
Hình minh họa cho thấy một đường giá ẩn trơn, một đường quan sát gồ ghề và các cửa sổ chồng lấn có trọng số giảm dần ở hai đầu. Đây là sơ đồ giải thích việc gộp cục bộ, không phải chuỗi giá mẫu hay kết quả lọc thực nghiệm.
<!-- learn:illustration --> <!-- Ý tưởng không chữ: đường giá ẩn trơn bên cạnh đường quan sát gồ ghề, cùng các cửa sổ cục bộ chồng lấn và thuôn trọng số ở hai đầu để gộp những chuyển động lân cận. Chỉ mang tính khái niệm; không phải dữ liệu thị trường, dự báo hay tín hiệu giao dịch. -->
Hiệu chỉnh phần nhiễu còn lại
Pre-averaging làm giảm ảnh hưởng của sai số quan sát nhanh, nhưng bình phương lợi suất đã lọc vẫn còn thành phần nhiễu. Trên lưới đều, một dạng phổ biến của ước lượng đơn biến với các hằng số chuẩn hóa tiệm cận là
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
trong đó các hằng số trọng số là
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
Số hạng thứ nhất điều chỉnh thang đo của tổng bình phương lợi suất pre-averaged để hướng tới phương sai tích phân. Số hạng thứ hai ước lượng rồi trừ đi đóng góp chính của nhiễu quan sát dưới mô hình. Nó không ước lượng mọi lần thực hiện nhiễu và không thể sửa trường giá sai, dấu thời gian lỗi hay ngoại lệ. Công thức mẫu hữu hạn chính xác có thể dùng phiên bản rời rạc của \(\psi_1,\psi_2\), hiệu chỉnh đầu mút và quy ước chỉ số lợi suất riêng. Cần báo cáo và áp dụng nhất quán các chi tiết đó.
Hiệu chỉnh có thể khiến ước lượng mẫu hữu hạn nhỏ hoặc âm. Điều đó không có nghĩa tài sản có phương sai vật lý âm; nó có nghĩa phần hiệu chỉnh được chọn lớn hơn số hạng thứ nhất trong mẫu đó. Không âm thầm đặt ước lượng âm về 0. Hãy báo cáo phép tính ban đầu và mọi quy tắc cắt ngưỡng riêng, vì cắt ngưỡng làm thay đổi ước lượng và có thể ảnh hưởng đến trung bình hoặc suy luận tiếp theo.
Chọn độ dài cửa sổ theo nhiễu và cỡ mẫu
Cửa sổ \(k_n\) quyết định mức độ làm trơn. Nếu quá ngắn, lợi suất đã lọc còn nhiều nhiễu tần suất cao hơn. Nếu quá dài, biến động giá cục bộ bị lấy trung bình trên khoảng thời gian rộng hơn và số cửa sổ đóng góp giảm, làm tăng các dạng sai số ước lượng khác. Trọng số và độ dài cửa sổ phối hợp với nhau; không thể diễn giải \(k_n\) nếu thiếu hàm trọng số và khoảng lấy mẫu.
Trong thiết kế cân bằng cổ điển với khoảng thời gian cố định và \(n\) quan sát ngày càng dày, độ dài cửa sổ tăng theo bậc \(\sqrt n\), thường viết \(k_n\sim\theta\sqrt n\) với hằng số điều chỉnh dương \(\theta\). Dưới các giả định của bài báo, ước lượng có thể hội tụ với tốc độ \(n^{1/4}\), tương ứng sai số bậc \(n^{-1/4}\). Tốc độ này chậm hơn \(n^{1/2}\) khi không có nhiễu và là tốc độ tối ưu trong bối cảnh nhiễu cơ sở mà các tác giả nghiên cứu; đây không phải bảo đảm cho mọi bộ dữ liệu thị trường.
\(\theta\), hàm trọng số và thủ tục lựa chọn dựa trên dữ liệu ảnh hưởng đến độ chệch và phương sai mẫu hữu hạn. Lựa chọn tự động có thể phụ thuộc vào các ước lượng nhiễu và biến động vốn đã không chắc chắn. Hãy trình bày độ nhạy với một số cửa sổ hợp lý, giải thích đồng hồ lấy mẫu và ranh giới phiên, đồng thời tránh chọn cửa sổ sau khi biết kết quả nào ủng hộ kết luận mong muốn.
Một phép tính giả định nhỏ
Xét sáu lợi suất quan sát giả định, tính bằng điểm cơ bản:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Dùng trọng số tam giác \(g(u)=\min(u,1-u)\) và cửa sổ ngắn có chủ ý \(k=3\). Hai trọng số lưới bên trong khác 0 là \(g(1/3)=g(2/3)=1/3\). Để minh họa số học trên lưới hữu hạn, đặt
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Theo quy ước chỉ số trên, có \(n-k+2=5\) cửa sổ chồng lấn. Mỗi cửa sổ gộp lợi suất lân cận \(1\) bp và \(0\) bp, nên \(\bar r_i=(1/3)(1+0)=1/3\) bp và
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Dùng chuẩn hóa lưới hữu hạn tương ứng, ta được
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Ví dụ kiểm tra số học và đơn vị; sáu lợi suất cùng cửa sổ ba quan sát quá nhỏ để hỗ trợ xấp xỉ tiệm cận. Các giá trị được chọn để phép tính rõ ràng, không phải dữ liệu thị trường, quá trình nhiễu mô phỏng hay bằng chứng rằng ước lượng khôi phục được phương sai tích phân ẩn. Không tính sai số chuẩn hoặc dự báo.
Nắm rõ các giả định của phép hiệu chỉnh
Phép suy dẫn tiêu chuẩn dành cho quá trình giá hiệu quả liên tục được quan sát thường xuyên với nhiễu cộng và các điều kiện chính quy. Nhiễu độc lập, trung bình 0 là điểm khởi đầu hữu ích, nhưng phụ thuộc giữa nhiễu và giá, sai số tự tương quan, nhiễu thay đổi theo thời gian, thời điểm quan sát không đều hoặc lấy mẫu nội sinh có thể đòi hỏi ước lượng đã sửa đổi hay lý thuyết riêng. Aït-Sahalia, Mykland và Zhang nghiên cứu ước lượng biến động tích phân dưới nhiễu vi cấu trúc phụ thuộc; bài báo của họ giải thích vì sao công thức nhiễu iid không phổ quát.
Bước nhảy đặt ra một câu hỏi riêng về đại lượng mục tiêu. Nếu quan tâm đến biến động bậc hai, bình phương bước nhảy thuộc đại lượng đó; nếu mục tiêu là phương sai tích phân liên tục thì không. Ước lượng pre-averaging thông thường không tự tách bước nhảy. Cắt ngưỡng chống bước nhảy hay cấu trúc khác cần giả định và tham số riêng. Một bản ghi cực đoan cũng có thể ảnh hưởng đến nhiều cửa sổ chồng lấn, nên vẫn cần xác thực dữ liệu và xử lý ngoại lệ.
Pre-averaging cũng không tự giải quyết toàn bộ vấn đề dữ liệu đa biến hoặc không đồng bộ. Christensen, Kinnebrock và Podolskij phát triển phương pháp hiệp phương sai pre-averaging và phần mở rộng Hayashi–Yoshida chống nhiễu cho quan sát không đồng bộ trong nghiên cứu của họ. Các cấu trúc đó xử lý thêm vấn đề thiết kế dữ liệu. Áp dụng công thức đơn biến riêng cho từng tài sản không tự đồng bộ hóa dấu thời gian hay bảo đảm ma trận hiệp phương sai hợp lệ.
Phân biệt pre-averaging với TSRV và realized kernel
Các ước lượng này xử lý những vấn đề biến động tần suất cao có liên quan nhưng tổ chức thông tin khác nhau. Two-scale realized volatility (TSRV) lấy trung bình các ước lượng trên những lưới lấy mẫu thưa được dịch chuyển, rồi trừ một ước lượng lưới dày đã điều chỉnh tỷ lệ để sửa độ chệch nhiễu chính. Pre-averaging thì lọc các cửa sổ lợi suất ngắn chồng lấn bằng trọng số trơn, bình phương lợi suất đã lọc và áp dụng hiệu chỉnh tương ứng. Bài báo gốc về two-scale trình bày cấu trúc riêng đó.
Realized kernel bắt đầu từ tổng bình phương lợi suất và cộng thêm các tự hiệp phương sai lợi suất có trọng số ở nhiều độ trễ. Băng thông kiểm soát phạm vi độ trễ. Ngược lại, pre-averaging thay đổi lợi suất cục bộ trước khi bình phương. Cả hai dùng trọng số và tham số điều chỉnh, nhưng công thức, chuẩn hóa và giả định không thể thay thế cho nhau. Hướng dẫn realized kernel giải thích cấu trúc theo độ trễ và băng thông.
Hãy chọn phương pháp theo dữ liệu và đại lượng cần đo, không theo tên gọi. So sánh thiết kế lấy mẫu, mô hình nhiễu, cách xử lý đầu mút, mục tiêu khi có bước nhảy và hành vi mẫu hữu hạn. Tính vững tiệm cận không bảo đảm phương pháp phù hợp nhất với tài sản giao dịch thưa, phiên ngắn, nhiễu thay đổi hoặc luồng dữ liệu bất quy tắc. Hướng dẫn two-scale trình bày lựa chọn thang đo và hiệu chỉnh của phương pháp đó.
Báo cáo phép đo trong khoảng, không đưa ra kết luận giao dịch
Để có thể tái lập kết quả, hãy nêu tài sản và trường giá đầu vào, khoảng thời gian, tần suất lấy mẫu, quy tắc dấu thời gian và phiên, đơn vị lợi suất, hàm trọng số, độ dài cửa sổ, chuẩn hóa, quy ước đầu mút và giả định nhiễu. Nếu dùng ước lượng để suy luận, cần báo cáo ước lượng phương sai hoặc phương pháp khoảng tin cậy cùng các giả định liên quan. Bảng độ nhạy qua các cửa sổ hợp lý có thể cho biết kết luận có phụ thuộc vào một lựa chọn điều chỉnh hay không.
Phương sai tích phân đo khoảng quan sát đã kết thúc. Căn bậc hai biểu diễn thang biến động cho chính khoảng đó; quy đổi năm bổ sung quy ước thời gian nhưng không biến con số thành dự báo. Dự báo một chân trời sau này cần mô hình dự báo riêng và đánh giá ngoài mẫu. Hướng dẫn tính biến động thực hiện giải thích chuẩn tổng bình phương lợi suất cơ bản; hướng dẫn biến động bậc hai phân biệt biến động đường đi với mục tiêu phương sai tích phân liên tục.
Ước lượng không xác định vì sao giá biến động, không chứng minh chiến lược có lãi và không bảo đảm phép đo rủi ro có thể thực thi. Chi phí giao dịch, thanh khoản, bước nhảy, động lực biến động và bất định của ước lượng vẫn là các vấn đề riêng. Pre-averaging là công cụ đo lường thống kê; giá trị của nó phụ thuộc vào mức độ phù hợp giữa giả định và dữ liệu quan sát.
Câu hỏi thường gặp
Q1Pre-averaging có giống lấy trung bình trượt của giá không?
Không. Ước lượng tạo các tổng có trọng số từ lợi suất lân cận, sau đó bình phương và hiệu chỉnh. Lấy trung bình mức giá rồi tính sai phân là phép biến đổi khác với trọng số và hành vi biên khác.
Q2Pre-averaging có loại bỏ mọi nhiễu vi cấu trúc không?
Không. Phương pháp giảm tác động chính dưới các giả định nhất định về nhiễu và lấy mẫu. Nhiễu phụ thuộc hoặc thay đổi, bước nhảy, ngoại lệ và lỗi dấu thời gian vẫn có thể ảnh hưởng đến kết quả.
Q3Vì sao hai ước lượng pre-averaging có thể khác nhau?
Chúng có thể dùng hàm trọng số, độ dài cửa sổ, chuẩn hóa mẫu hữu hạn, trường giá, quy tắc đầu mút hoặc quy trình làm sạch khác nhau. Cần báo cáo và kiểm tra độ nhạy của các lựa chọn này.
Q4Ước lượng pre-averaging có phải dự báo biến động không?
Không. Tự nó chỉ đo biến động trong khoảng dùng để tính. Dự báo cần mô hình riêng và đánh giá ngoài mẫu.
Nguồn và tài liệu đọc thêm
Báo lỗi
Chúng tôi sẽ soạn email kèm liên kết bài viết này. Mark chỉ nhận được báo cáo sau khi bạn gửi email
Kiểm tra nhanh
Đọc xong hướng dẫn? Hãy kiểm tra với 3 câu hỏi
Câu hỏi 01
Mục đích chính của việc tạo lợi suất pre-averaged là gì?
Chọn một đáp án để xem giải thích
Bảng thuật ngữ quyền chọn
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Đọc hướng dẫn chuyên sâuQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Đọc hướng dẫn chuyên sâu