

การทดสอบ Quandt–Andrews: sup-Wald สำหรับวันที่เกิดจุดเปลี่ยนที่ไม่ทราบ
เรียนรู้ว่า sup-Wald ของ Quandt–Andrews ค้นหาจุดเปลี่ยนหนึ่งจุดที่ไม่ทราบในสมการถดถอยอย่างไร เหตุใดการตัดช่วงปลายจึงสำคัญ และเหตุใดการแจกแจงภายใต้สมมติฐานศูนย์จึงไม่ใช่ F distribution แบบปกติ
ในคู่มือนี้วันที่เกิดจุดเปลี่ยนที่ไม่ทราบทำให้คำถามเปลี่ยนไป
สรุปสั้น
วิธี Quandt–Andrews ทดสอบว่าสัมประสิทธิ์ของสมการถดถอยคงที่หรือไม่ เมื่อไม่ทราบวันที่เกิดจุดเปลี่ยนหนึ่งจุด วิธีนี้คำนวณสถิติสำหรับทุกวันที่อนุญาต แล้วเลือกค่าสูงสุด เนื่องจากวันที่ถูกเลือกผ่านการค้นหาและไม่สามารถระบุได้ภายใต้สมมติฐานศูนย์ที่ไม่มีจุดเปลี่ยน ค่าสูงสุดจึงไม่ได้มีการแจกแจง F ปกติของวันที่กำหนดไว้ล่วงหน้า
วันที่เกิดจุดเปลี่ยนที่ไม่ทราบทำให้คำถามเปลี่ยนไป
Chow test ตอบคำถามที่เจาะจงว่า สัมประสิทธิ์ของสมการถดถอยเปลี่ยน ณ วันที่เลือกไว้ก่อนดูผลทดสอบหรือไม่ ในงานการเงินและเศรษฐศาสตร์มหภาคหลายกรณี ไม่มีวันที่เดียวที่มีเหตุผลเพียงพอให้กำหนดไว้ล่วงหน้า การลองหลายวันแล้วรายงานผล Chow ที่มีนัยสำคัญที่สุดทำให้การเลือกวันกลายเป็นส่วนหนึ่งของการทดสอบ ค่า critical value ปกติสำหรับวันเดียวจึงไม่รวมผลของการค้นหา
ขั้นตอนสอง regime ของ Quandt และกรอบ asymptotic ในภายหลังของ Andrews แก้ปัญหานี้ด้วยการประเมินสถิติบนชุดวันที่เกิดจุดเปลี่ยนที่เป็นไปได้ ใน linear regression ที่ใช้จริง ค่าสูงสุดมักเรียก Quandt likelihood-ratio (QLR), sup-F หรือ sup-Wald โดยขึ้นกับสถิติที่คำนวณจริงและวิธีจัดการ covariance Andrews พัฒนาการทดสอบ sup-Wald, LM และแบบคล้าย LR สำหรับแบบจำลองพาราเมตริกที่กว้างกว่าและมี change point ที่ไม่ทราบ (Quandt, 1960; Andrews, 1993)
ขอบเขตในบทความนี้ตั้งใจให้แคบ: ทดสอบความเป็นไปได้ของการเปลี่ยนแปลงหนึ่งครั้งในความสัมพันธ์ของสมการถดถอยที่ระบุไว้ โดยไม่ทราบวันที่ การทดสอบนี้ไม่ได้ประมาณจำนวนจุดเปลี่ยนที่ไม่ทราบ ไม่อธิบายสาเหตุของการเปลี่ยนแปลง และไม่ระบุโอกาสในการซื้อขาย คู่มือ Bai–Perron กล่าวถึงปัญหาอีกแบบ คือการสร้างแบบจำลองจุดเปลี่ยนที่ไม่ทราบหลายจุด
ระบุสมการถดถอยที่มีจุดเปลี่ยนหนึ่งจุดและข้อจำกัดที่ทดสอบ
สมมติว่าตัวอย่างที่เรียงตามลำดับมีข้อมูล (t=1,ldots,T) ตัวแปรผลลัพธ์ (y_t) และเวกเตอร์ตัวแปรอธิบาย (x_t) แบบจำลอง pure one-break คือ
yₜ = xₜ′β₁ + uₜ, t ≤ k yₜ = xₜ′β₂ + uₜ, t > k
โดย (k) คือข้อมูลลำดับสุดท้ายของ regime แรก ภายใต้สมมติฐานศูนย์ที่ไม่มีจุดเปลี่ยน เวกเตอร์สัมประสิทธิ์ที่ทดสอบเท่ากัน คือ (H₀: β₁ = β₂) ส่วนสมมติฐานทางเลือกของการเปลี่ยนหนึ่งครั้งระบุว่าทั้งสองเวกเตอร์ต่างกันในวันที่อนุญาตอย่างน้อยหนึ่งวัน แบบจำลอง partial-change อาจกำหนดล่วงหน้าให้เปลี่ยนได้เฉพาะสัมประสิทธิ์บางตัว ซึ่งทำให้จำนวนข้อจำกัดและการแจกแจงอ้างอิงเปลี่ยนไป ระบุให้ชัดว่าสัมประสิทธิ์ใดเปลี่ยนได้
แบบจำลองต้องมีลำดับข้อมูลที่ทำให้วันที่เกิดจุดเปลี่ยนมีความหมาย สำหรับผลตอบแทนรายวัน (k) มักเป็นดัชนี session การซื้อขาย ไม่ใช่วันปฏิทินโดยอัตโนมัติ ข้อมูลที่หายไป วันหยุด ตลาดที่เวลาไม่ตรงกัน การ roll สัญญา และการเปลี่ยนนิยามตัวแปรเป้าหมายล้วนเปลี่ยนความหมายของ “ก่อน” และ “หลัง” กำหนดตัวอย่างและเกณฑ์วันที่ก่อนตีความ split ที่เลือกเป็นเหตุการณ์
การปฏิเสธสมมติฐานศูนย์เป็นหลักฐานคัดค้านแบบจำลองสัมประสิทธิ์คงที่ที่ระบุไว้ และสนับสนุนทางเลือกบางแบบที่มีจุดเปลี่ยนหนึ่งจุดภายในช่วงที่ค้นหา ไม่ได้พิสูจน์ว่าประกาศใดเป็นสาเหตุ ตัวแปรอธิบายเป็น exogenous หรือสัมประสิทธิ์หลังจุดเปลี่ยนจะคงอยู่ หาก conditional mean, พลวัตของ error หรือกระบวนการวัดระบุผิด การทดสอบอาจตอบสนองต่อ model misspecification แทนการเปลี่ยนพารามิเตอร์ที่ชัดเจน
ตัดวันที่ตัวอย่างบริเวณปลายช่วงและประมาณค่าทั้งสองด้านของ split
วันที่ตัวอย่างใกล้ปลายช่วงใดช่วงหนึ่งทำให้มีข้อมูลน้อยเกินไปสำหรับประมาณค่าด้านหนึ่งอย่างน่าเชื่อถือ สัดส่วนการตัดช่วง (\varepsilon) ใช้ตัดปลายเหล่านี้และค้นหาเฉพาะ break fraction (lambda=k/T) ในช่วงที่กำหนดไว้ล่วงหน้า เช่น ([\varepsilon,1-\varepsilon]) ในตัวอย่างแบบไม่ต่อเนื่อง โปรแกรมจะแปลงช่วงดังกล่าวเป็นจำนวนเต็ม และกำหนดให้แต่ละ segment มีข้อมูลเพียงพอและเมทริกซ์ตัวแปรอธิบายมี rank เต็ม รายงานเกณฑ์ที่ใช้จริง รวมถึงว่า (k) หมายถึงข้อมูลสุดท้ายก่อนจุดเปลี่ยนหรือข้อมูลแรกหลังจุดเปลี่ยน
สำหรับทุก (k) ที่อนุญาต ให้ประมาณแบบจำลอง null แบบ pooled และแบบจำลองสอง regime ที่สอดคล้องกัน แล้วคำนวณสถิติสำหรับข้อจำกัดของการเปลี่ยนสัมประสิทธิ์ ในกรณี classical OLS ที่ error เป็นอิสระและ homoskedastic และใช้ชุดตัวแปรอธิบายเดียวกัน สามารถเขียนสถิติผ่านการลดลงของ residual sum of squares ได้ หาก error เป็น normal สถิติสำหรับวันที่กำหนดไว้ล่วงหน้าหนึ่งวันมีการแจกแจงอ้างอิง F แบบ exact ในตัวอย่างจำกัด หากไม่เป็น normal จะสรุปคุณสมบัติ exact นี้ไม่ได้ ส่วน Wald version ประเมินผลต่างของสัมประสิทธิ์ที่ประมาณได้เทียบกับ covariance ที่ประมาณได้ เมื่อมี heteroskedasticity หรือ serial dependence ต้องใช้ robust covariance และวิธีอ้างอิงที่สอดคล้องกัน การเปลี่ยนแค่ standard error ไม่ทำให้ critical value F ปกติใช้ได้หลังค้นหาวันที่
การตัดช่วงเป็นส่วนหนึ่งของการออกแบบการทดสอบ ไม่ใช่ค่าตั้งที่เป็นเพียงรูปลักษณ์ การตัดช่วงมากขึ้นทำให้ค้นหาสั้นลงและหลีกเลี่ยง regime ขนาดเล็กมาก แต่ตัดจุดเปลี่ยนขนาดใหญ่ที่อยู่ใกล้ปลายช่วงออก การตัดน้อยลงทำให้รับ candidate เหล่านั้น แต่การประมาณในตัวอย่างจำกัดและ asymptotic approximation เปราะบางขึ้น เลือกช่วงตามขนาดตัวอย่าง มิติของแบบจำลอง และคำถามหลักก่อนตรวจว่าค่าสถิติสูงสุดอยู่ตรงไหน
<!-- learn:illustration -->
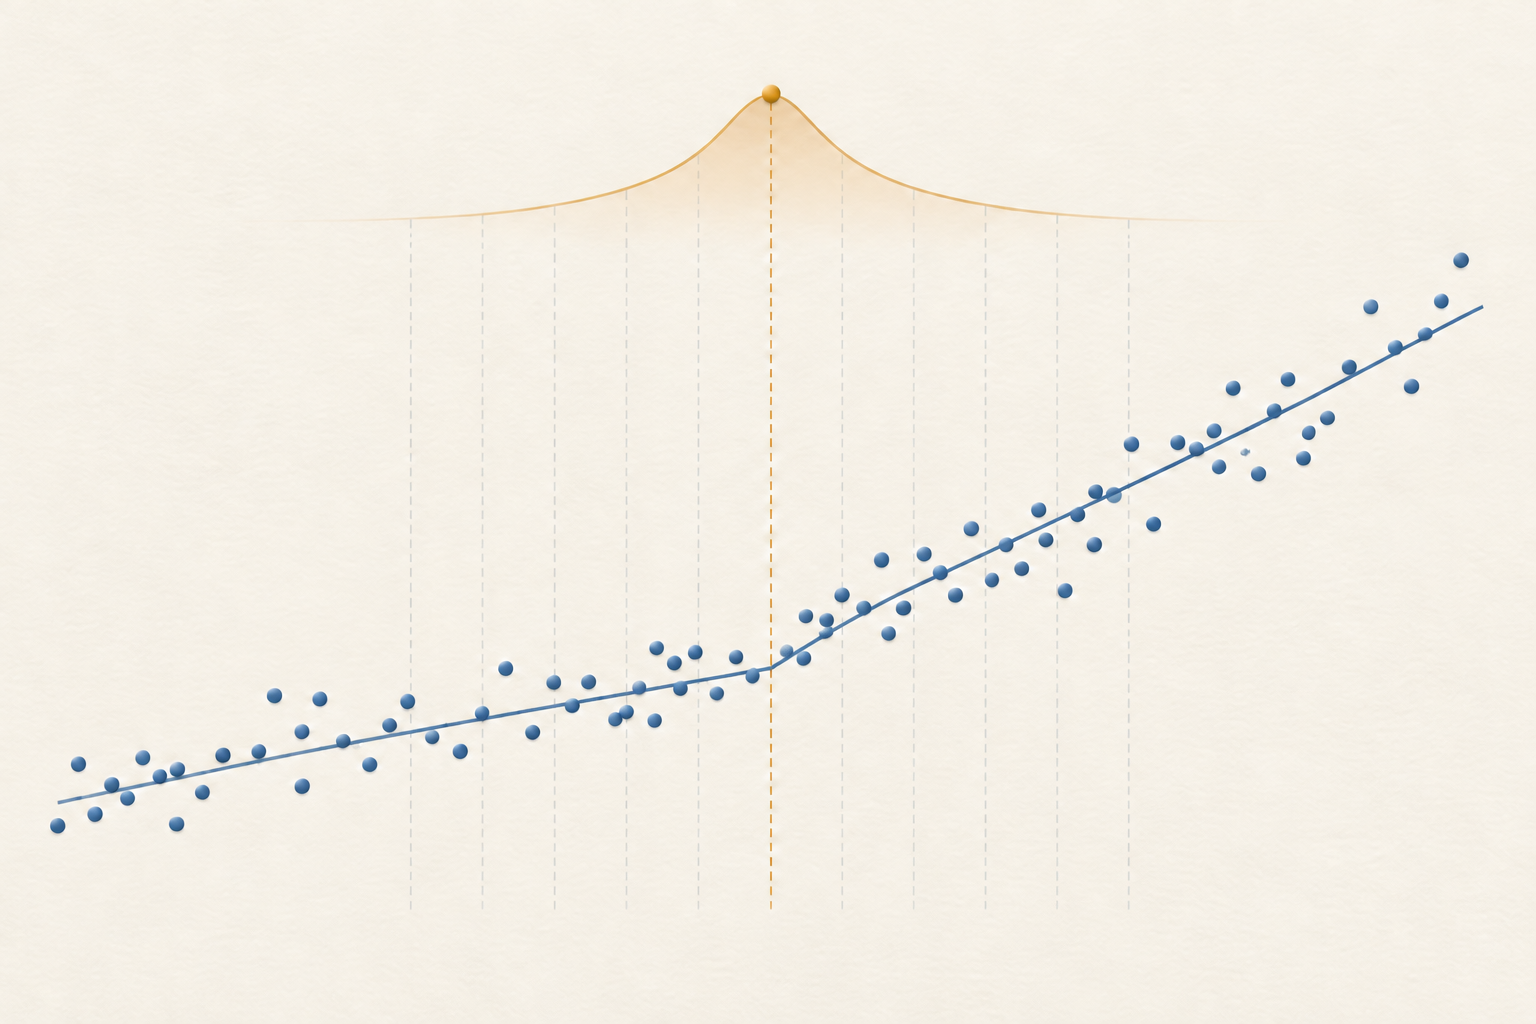
sup-Wald statistic คือค่าสูงสุดของสถิติในวันที่เป็น candidate
สำหรับวันที่ candidate (k) ให้ (W(k)) เป็น Wald statistic ของข้อจำกัดสัมประสิทธิ์ที่กำหนดไว้ sup-Wald statistic สำหรับจุดเปลี่ยนหนึ่งจุดคือ
supW = max{k ∈ K} W(k)
โดย (K) คือชุดวันที่อนุญาตหลังตัดช่วง ในการใช้ linear regression แบบคลาสสิก มักหาค่าสูงสุดของ Chow F ในแต่ละ candidate แล้วรายงานเป็น sup-F หรือ QLR ค่า maximizer (hat{k}=argmax_{kin K} W(k)) คือวันที่ให้สถิติสูงสุดในการค้นหานี้ เป็นค่าประมาณที่ถูกเลือก ไม่ใช่ช่วงความเชื่อมั่นหรือเวลาที่เกิดการเปลี่ยนแปลงทางเศรษฐกิจอย่างแม่นยำ
คำเรียกเหล่านี้เกี่ยวข้องกันแต่ใช้แทนกันไม่ได้เสมอไป Chow F แบบ homoskedastic ทั่วไป ณ วันที่กำหนด อาจมีการแจกแจง F แบบ exact ในตัวอย่างจำกัดภายใต้สมมติฐานของมัน ส่วนค่าสูงสุดข้ามวัน asymptotic sup-Wald ที่ใช้ robust covariance และ likelihood-ratio statistic ไม่จำเป็นต้องได้ค่าหรือ critical value เหมือนกัน รายงานสถิติที่คำนวณจริง ตัวประมาณ covariance กฎการตัดช่วง และแหล่งที่มาของ critical value แทนการพึ่งชื่อ “QLR” อย่างเดียว
สถิติของ candidate date พึ่งพากันมาก เพราะ split ที่อยู่ใกล้กันใช้ข้อมูลเกือบชุดเดิม การทดสอบนี้ไม่เท่ากับเลือก p-value ของวันที่ต่ำสุด คูณจำนวนวัน หรือถือว่าแต่ละวันเป็นการทดสอบอิสระ ต้องใช้ null distribution ที่คำนึงถึงการค้นหาค่าสูงสุด
ค่าสูงสุดที่ค้นพบมี null distribution แบบ nonstandard
ภายใต้สมมติฐานศูนย์ที่ไม่มีจุดเปลี่ยน จะไม่มีวันที่จริงให้ประมาณ พารามิเตอร์วันที่ปรากฏภายใต้สมมติฐานทางเลือกแต่หายไปภายใต้ null ดังนั้นเหตุผล regularity ปกติของ Wald หรือ F test สำหรับวันที่กำหนดไว้ล่วงหน้าจึงใช้ไม่ได้ การหาค่าสูงสุดข้าม candidate dates ทำให้เกิด asymptotic distribution แบบ nonstandard การเทียบค่าสูงสุดกับ F cutoff ทั่วไปจึงมักประเมินหลักฐานคัดค้านเสถียรภาพสูงเกินไป
Andrews หา asymptotic distribution และ critical value สำหรับการทดสอบ sup-Wald, LM และแบบคล้าย LR โดยปลายช่วง trimming และจำนวนข้อจำกัดที่ทดสอบเป็นตัวกำหนดช่วงค้นหา (1993) ค่าที่เหมาะสมยังขึ้นกับแบบจำลองและสมมติฐาน covariance ใช้ตาราง โปรแกรม หรือค่าประมาณที่ตรงกับการทดสอบนั้น อย่านำ critical value จากสัดส่วน trimming หรือจำนวนข้อจำกัดอื่นมาใช้ Andrews ตีพิมพ์ corrigendum ภายหลัง เพราะ critical value บางค่าของ sup test ที่มีแปดข้อจำกัดต่ำเกินไป กรณีนี้จึงต้องใช้ตารางที่แก้ไขแล้ว (corrigendum ปี 2003) Hansen เสนอค่าประมาณเชิงตัวเลขของ asymptotic p-value สำหรับการทดสอบ structural change (1997)
Andrews และ Ploberger ยังพัฒนาการทดสอบแบบ average และ exponential สำหรับ nuisance parameter ที่มีอยู่เฉพาะภายใต้สมมติฐานทางเลือก (1994) วิธีเหล่านี้เกี่ยวข้องและคำนึงถึงการค้นหา แต่ไม่ใช่ชื่อเรียกอื่นของ sup-Wald หากใช้ bootstrap หรือการปรับเทียบสำหรับตัวอย่างจำกัดแบบอื่น ให้อธิบายรูปแบบการสุ่มซ้ำและแสดงว่าสร้างโครงสร้าง null และการค้นหาแบบเดิมได้ bootstrap ทั่วไปไม่ได้แก้ปัญหาการเลือกวันที่หรือ dependence โดยอัตโนมัติ
ตัวอย่างข้อมูล 12 จุดทำให้ตรวจสอบ trimming และค่าสูงสุดได้
พิจารณา regression แบบ hypothetical ที่เล็กโดยตั้งใจและมี intercept อย่างเดียว โดยมีข้อมูล
y = [0, 1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 3]
มีข้อมูล (T=12) จุด กำหนด (\varepsilon=0.25) เพื่อประกอบตัวอย่าง แต่ละ segment จึงต้องมีอย่างน้อย 3 จุด และวันที่สุดท้ายก่อน break ที่เป็น candidate คือ (k=3,ldots,9) นี่เป็นตัวอย่างคำนวณการค้นหา ไม่ใช่คำแนะนำเรื่อง trimming หรือชุดข้อมูลสำหรับอนุมาน
ค่าเฉลี่ย pooled คือ (23/12) และ residual sum of squares ของแบบจำลอง pooled คือ
RSS₀ = Σ yₜ² − (Σ yₜ)²/12 = 59 − 529/12 = 179/12
ที่ candidate (k=6) segment แรกมีผลรวมและผลรวมกำลังสองเท่ากับ 5 ทั้งคู่ จึงมี residual sum of squares (5−5²/6=5/6) segment ที่สองมีค่า 3 จำนวนหกค่า ทำให้ residual sum of squares เท่ากับศูนย์ ดังนั้น (RSS₁(6)=5/6) เมื่อมีข้อจำกัดหนึ่งข้อและประมาณ intercept ของสอง segment สถิติสำหรับวันที่กำหนดคือ
F(6) = [(RSS₀ − RSS₁(6))/1] / [RSS₁(6)/(12−2)] = 169
คำนวณแบบเดียวกันกับ candidate ทั้งเจ็ดได้ค่า F โดยประมาณ (7.21, 12.10, 25.28, 169.00, 20.71, 8.94, 4.59) ตามลำดับ (k=3,ldots,9) ดังนั้น sup-F คือค่าสูงสุด 169 ที่ (k=6) การคำนวณนี้ตรวจว่า candidate ใดให้ค่าสูงสุดในลำดับที่สร้างขึ้น ไม่ได้ให้ p-value เนื่องจากค้นหาวันที่ ค่า 169 ต้องเปรียบเทียบกับ nonstandard critical value ที่คำนึงถึงการค้นหาและตรงกับแบบทดสอบ ไม่ใช่การแจกแจง F ปกติสำหรับวันที่กำหนด
ตีความการปฏิเสธและการไม่ปฏิเสธภายในขอบเขตของการออกแบบ
การปฏิเสธหมายความว่า ณ ระดับนัยสำคัญที่เลือก ภายใต้สมมติฐานและ critical value ของการทดสอบ null ที่สัมประสิทธิ์คงที่ไม่สอดคล้องกับสถิติสูงสุดที่พบในช่วงที่อนุญาต ไม่ได้ยืนยันว่ามีจุดเปลี่ยนเพียงจุดเดียวและระบุเวลาได้แม่นยำ Candidate date ที่ติดกันอาจมีค่าสถิติใกล้กัน และจุดสูงสุดที่เห็นอาจเลื่อนเมื่อเปลี่ยนปลายตัวอย่าง trimming ตัวแปรอธิบาย หรือ covariance method รายงานรูปแบบของ candidate statistic หรือวิเคราะห์ความไม่แน่นอนของวันที่ แทนการนำ (hat{k}) เสนอเป็นเวลาที่แน่นอน
การไม่ปฏิเสธไม่ได้ยืนยันสัมประสิทธิ์คงที่ การทดสอบอาจมี power ต่ำต่อการเปลี่ยนแปลงเล็กน้อย การเปลี่ยนใกล้ปลายช่วงที่ถูก trim หรือการเปลี่ยนในสัมประสิทธิ์ที่ไม่ได้อยู่ในข้อจำกัดที่ทดสอบ การทดสอบจุดเปลี่ยนเดียวอาจไม่พบหลายการเปลี่ยนแปลงที่หักล้างกันบางส่วน ในทางกลับกัน outlier ความแปรปรวนที่เปลี่ยนไป พลวัตที่ตกหล่น นิยามข้อมูลที่เปลี่ยน หรือการค้นหาสเปกซ้ำหลายครั้งก็สร้างหลักฐานความไม่เสถียรได้ การทดสอบตอบคำถามทางสถิติที่มีขอบเขต ไม่ได้ระบุสาเหตุ
วันที่ประมาณได้ถูกเลือกจากข้อมูลชุดเดียวกับที่ใช้ทดสอบ อย่านำไปปฏิบัติเสมือนเป็น event date ที่กำหนดไว้ล่วงหน้าเพื่อทดสอบนัยสำคัญครั้งที่สองแบบไม่ปรับค่า แล้วอ้างว่าเป็นการยืนยันอิสระ หากวันที่นั้นนำไปสู่การปรับ forecast หรือกฎซื้อขาย ให้ระบุกฎและประเมินกับข้อมูลภายหลัง ค่า sup ในตัวอย่างเดิมไม่ได้พิสูจน์ว่าระบอบหลัง break จะคงอยู่หรือมีมูลค่าทางเศรษฐกิจ
แยกคำถามของ Chow, CUSUM และ Bai–Perron
| วิธี | คำถามหลัก | สิ่งที่วิธีนี้ไม่ได้ทำ |
|---|---|---|
| Chow test | สัมประสิทธิ์ต่างกันหรือไม่ ณ วันที่กำหนดไว้ล่วงหน้า? | ค้นหาวันที่ไม่ทราบโดยยังใช้การแจกแจงอ้างอิงสำหรับวันเดียว |
| [Quandt–Andrews sup test](#) | มีหลักฐานของจุดเปลี่ยนหนึ่งจุดในวันใดวันหนึ่งภายในช่วงที่ trim หรือไม่? | เลือกจำนวนจุดเปลี่ยนที่ไม่ทราบหรืออธิบายสาเหตุ |
| Regression CUSUM | เส้นทาง recursive residuals ที่เรียงลำดับขัดกับความคงที่ของสัมประสิทธิ์หรือไม่? | คืนวันที่ของ one-break ที่ถูกเลือกโดยตัวมันเอง |
| Bai–Perron | แบบจำลองหลาย break ได้รับการสนับสนุนให้มีกี่จุดและวันใด? | แทนที่การกำหนดแบบจำลองและการเลือกของ one-break test |
Hidden Markov หรือ regime-switching model ตั้งคำถามอีกแบบว่า จะอธิบายข้อมูลด้วย latent state ที่เปลี่ยนซ้ำตาม transition probability ได้หรือไม่ การทดสอบจุดเปลี่ยนที่ไม่ทราบหนึ่งจุดพิจารณา split ก่อน/หลังที่คงอยู่เพียงครั้งเดียวในช่วงที่ค้นหา วิธีเหล่านี้ใช้ประกอบกันได้ แต่สมมติฐานและผลลัพธ์ไม่เหมือนกัน ดูคู่มือ regime switching
รายงานการค้นหาเพื่อให้นักวิเคราะห์คนอื่นทำซ้ำได้
ระบุตัวแปรผลลัพธ์และตัวแปรอธิบาย แบบจำลองเป็น pure หรือ partial change ข้อจำกัดสัมประสิทธิ์ที่ทดสอบ วันและลำดับของตัวอย่าง และเกณฑ์กำหนด break date รายงาน (T) จำนวนข้อจำกัด trimming fraction หรือ candidate set ที่แน่นอน ขนาด segment ขั้นต่ำ และสถิติที่เลือกเป็น sup-Wald, sup-F/QLR, sup-LM หรือวิธีอื่น ระบุ covariance estimator วิธีหา critical value หรือ p-value และการปรับแก้ finite-sample ที่ใช้
แสดงสถิติตาม candidate date และรายงานวันที่ที่ให้ค่าสูงสุดเป็นตำแหน่งที่เลือก พร้อมข้อมูลความไม่แน่นอนหรือ sensitivity เท่าที่มี อธิบายว่าแบบจำลองและการออกแบบทดสอบกำหนดไว้ก่อนหรือไม่ จัดการข้อมูลที่หายไปและข้อมูลแบบ real-time อย่างไร และตรวจ sample หรือตัวแปรอธิบายทางเลือกใดบ้าง หากวิเคราะห์เพื่อพยากรณ์ ให้ค้นหา break เฉพาะใน training sample และประเมินแบบจำลองที่แก้ไขกับข้อมูลหลังจากนั้นที่ยังไม่เคยใช้
นัยสำคัญทางสถิติของการทดสอบ unknown-break ไม่ได้ระบุสาเหตุของเหตุการณ์หรือพิสูจน์ว่ามี regime ที่ทำกำไรได้ ผลที่ไม่มีนัยสำคัญก็ไม่ได้รับรองความเสถียร ข้อสรุปที่ปกป้องได้จำกัดอยู่ที่ one-break alternative ช่วงวันที่ที่ trim สมการถดถอย ตัวอย่าง และวิธีอนุมานที่คำนึงถึงการค้นหาตามที่ระบุไว้
คำถามที่พบบ่อย
Q1Quandt–Andrews test เป็นแค่ Chow test ที่ทำซ้ำหลายวันหรือไม่?
คำนวณสถิติที่เกี่ยวข้องตาม candidate date แต่ inference ต้องคำนึงถึงการเลือกค่าสูงสุด การรายงานผล Chow ปกติที่สูงที่สุดพร้อม p-value สำหรับวันเดียวละเลยการค้นหา และโดยทั่วไปใช้ null distribution ที่ไม่ถูกต้อง
Q2วันที่ที่ให้ค่าสถิติสูงสุดระบุหรือไม่ว่าเหตุการณ์ทางเศรษฐกิจทำให้เกิด break เมื่อใด?
ไม่ใช่ เป็น candidate date ที่ได้ค่าสถิติสูงสุดในตัวอย่างและช่วงที่ trim ที่เลือก ไม่ใช่เวลาที่บอกเหตุและผลหรือ confidence interval วันที่ใกล้เคียงและตัวเลือกในการออกแบบอาจให้ผลคล้ายกัน
Q3การปฏิเสธหมายความว่ามีจุดเปลี่ยนเกิดขึ้นหนึ่งครั้งพอดีหรือไม่?
ไม่ใช่ การปฏิเสธ null ที่ระบุว่าสัมประสิทธิ์คงที่เพื่อสนับสนุน alternative แบบ one-break บางแบบในช่วงค้นหา หลายการเปลี่ยนแปลง outlier ความแปรปรวนที่เปลี่ยน หรือ model misspecification ก็สร้างหลักฐานความไม่เสถียรได้ การประมาณหลาย break เป็นอีกงานหนึ่ง
Q4นำ sup-Wald maximum ไปเทียบกับตาราง F ปกติได้ไหม?
โดยทั่วไปไม่ได้ ใช้ critical value หรือ p-value ที่ตรงกับ sup statistic, trimming, จำนวน restriction, model และสมมติฐาน covariance การแจกแจง F ปกติใช้กับ test ที่กำหนดวันไว้ล่วงหน้าภายใต้สมมติฐานของมัน ไม่ได้ใช้กับค่าสูงสุดหลังค้นหาโดยอัตโนมัติ งานวิจัยหลัก - Quandt, “Tests of the Hypothesis That a Linear Regression System Obeys Two Separate Regimes” (1960) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point” (1993) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point: A Corrigendum” (2003) - Hansen, “Approximate Asymptotic P Values for Structural-Change Tests” (1997) - Andrews and Ploberger, “Optimal Tests When a Nuisance Parameter Is Present Only Under the Alternative” (1994) - Chow, “Tests of Equality Between Sets of Coefficients in Two Linear Regressions” (1960) - Bai and Perron, “Estimating and Testing Linear Models with Multiple Structural Changes” (1998) - Brown, Durbin, and Evans, “Techniques for Testing the Constancy of Regression Relationships over Time” (1975)
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
เมื่อไม่ทราบ break date การทดสอบ Quandt–Andrews sup-Wald ทำอะไร?
เลือกคำตอบเพื่อดูคำอธิบาย
อภิธานศัพท์ออปชัน
A model generating observations from finite discrete latent states with Markov transition probabilities and state-dependent emissions.
อ่านคู่มือฉบับละเอียดAt the moneyA call or put whose strike is near the underlying price; it has little intrinsic value and often substantial sensitivity to time and volatility.
อ่านคู่มือฉบับละเอียด