

Test Quandta–Andrewsa: sup-Wald dla nieznanej daty zmiany
Dowiedz się, jak test sup-Wald Quandta–Andrewsa wyszukuje jedną nieznaną zmianę w regresji, dlaczego trimming ma znaczenie i czemu rozkład zerowy nie jest zwykłym rozkładem F
W tym przewodnikuNieznana data zmiany zmienia pytanie
Krótkie podsumowanie
Podejście Quandta–Andrewsa sprawdza, czy współczynniki regresji pozostają stałe, gdy data jednej zmiany jest nieznana. Oblicza statystykę dla każdej dopuszczalnej daty i wybiera największą wartość. Ponieważ data jest wybierana w drodze przeszukiwania i nie jest identyfikowana przy prawdziwej hipotezie zerowej o braku zmiany, maksimum nie ma zwykłego rozkładu F dla ustalonej daty.
Nieznana data zmiany zmienia pytanie
Test Chow odpowiada na konkretne pytanie: czy współczynniki regresji zmieniły się w dacie wybranej przed sprawdzeniem wyników testu? W wielu zastosowaniach finansowych i makroekonomicznych trudno z góry uzasadnić jedną datę. Sprawdzenie wielu dat i zgłoszenie najbardziej istotnego wyniku Chow sprawia, że wybór daty staje się częścią testu. Zwykłe wartości krytyczne dla jednej daty pomijają wtedy przeszukiwanie.
Procedura dwóch reżimów Quandta i późniejszy asymptotyczny schemat Andrewsa rozwiązują ten problem, oceniając statystykę dla zbioru możliwych dat zmian. W stosowanej regresji liniowej takie maksimum nazywa się zwykle testem ilorazu wiarygodności Quandta (QLR), sup-F lub sup-Wald, zależnie od dokładnej statystyki i sposobu uwzględnienia kowariancji. Andrews opracował testy sup-Wald, LM i zbliżone do LR dla szerszych modeli parametrycznych z nieznanym punktem zmiany (Quandt, 1960; Andrews, 1993).
Cel jest tu celowo wąski: sprawdzić jedną możliwą zmianę w określonej relacji regresyjnej, której data jest nieznana. Test nie szacuje nieznanej liczby zmian, nie wyjaśnia ich przyczyny ani nie identyfikuje okazji handlowej. Przewodnik Bai–Perrona omawia odrębny problem modelowania wielu nieznanych dat zmian.
Określ regresję z jedną zmianą i testowane ograniczenia
Załóżmy, że uporządkowana próba zawiera obserwacje (t=1,ldots,T), zmienną wynikową (y_t) i wektor regresorów (x_t). Model z jedną czystą zmianą ma postać
yₜ = xₜ′β₁ + uₜ, t ≤ k yₜ = xₜ′β₂ + uₜ, t > k
gdzie (k) jest ostatnią obserwacją pierwszego reżimu. Przy hipotezie zerowej o braku zmiany testowane wektory współczynników są równe: (H₀: β₁ = β₂). Alternatywa jednej zmiany zakłada różnicę dla co najmniej jednej dopuszczalnej daty. Model częściowej zmiany może z góry ograniczać zmianę do wybranego podzbioru współczynników; zmienia to liczbę ograniczeń i rozkład odniesienia. Wskaż, które współczynniki mogą się zmieniać.
Potrzebny jest porządek, który nadaje dacie zmiany znaczenie. Dla dziennych stóp zwrotu (k) jest zwykle indeksem sesji giełdowej, a nie automatycznie dniem kalendarzowym. Brakujące obserwacje, święta, niesynchroniczne rynki, rolowanie kontraktów i zmiany definicji zmiennej docelowej mogą zmienić znaczenie „przed” i „po”. Przed interpretacją wybranego podziału jako zdarzenia określ próbę i konwencję dat.
Odrzucenie jest dowodem przeciw wskazanemu modelowi stałych współczynników na rzecz pewnej alternatywy z jedną zmianą w przeszukiwanym zakresie. Nie dowodzi, że zmianę spowodował konkretny komunikat, że regresory są egzogeniczne ani że współczynniki po zmianie będą trwałe. Jeśli błędnie określono średnią warunkową, dynamikę błędów lub proces pomiaru, test może reagować na tę błędną specyfikację zamiast na czystą zmianę parametrów.
Przytnij kandydackie daty i dopasuj obie strony podziału
Data bliska końcowi próby pozostawia zbyt mało obserwacji, by wiarygodnie oszacować jedną ze stron. Ułamek przycięcia (\varepsilon) wyklucza te końce i ogranicza wyszukiwanie do udziałów zmiany (lambda=k/T) w określonym wcześniej przedziale, na przykład ([\varepsilon,1-\varepsilon]). W próbie dyskretnej implementacje przeliczają ten przedział na daty całkowite oraz wymagają odpowiedniej liczby obserwacji i pełnego rzędu macierzy regresorów w obu segmentach. Podaj dokładną konwencję, w tym czy (k) oznacza ostatnią obserwację przed zmianą, czy pierwszą po niej.
Dla każdego dopuszczalnego (k) dopasuj łączny model zerowy i odpowiadający mu model dwóch reżimów, a następnie oblicz statystykę dla ograniczeń dotyczących zmiany współczynników. W klasycznym OLS z niezależnymi, homoskedastycznymi błędami i wspólnym zestawem regresorów można ją wyrazić przez spadek sumy kwadratów reszt. Przy błędach normalnych statystyka dla jednej daty ustalonej z góry ma dokładny rozkład odniesienia F w skończonej próbie; bez normalności ta dokładna własność nie wynika. Wersja Walda ocenia różnicę oszacowanych współczynników względem oszacowanej kowariancji. Przy heteroskedastyczności lub zależności szeregowej potrzebna jest odporna kowariancja i zgodna metoda odniesienia; sama zmiana błędu standardowego nie sprawia, że zwykła wartość krytyczna F jest poprawna po przeszukaniu dat.
Przycięcie jest elementem projektu testu, a nie kosmetycznym ustawieniem. Większe przycięcie skraca wyszukiwanie i unika bardzo małych reżimów, ale wyklucza duże zmiany blisko końców próby. Mniejsze przycięcie dopuszcza takie daty, lecz osłabia wiarygodność przybliżeń asymptotycznych i estymacji w skończonej próbie. Wybierz zakres na podstawie wielkości próby, wymiaru modelu i pytania badawczego, zanim sprawdzisz położenie maksimum statystyki.
<!-- learn:illustration -->
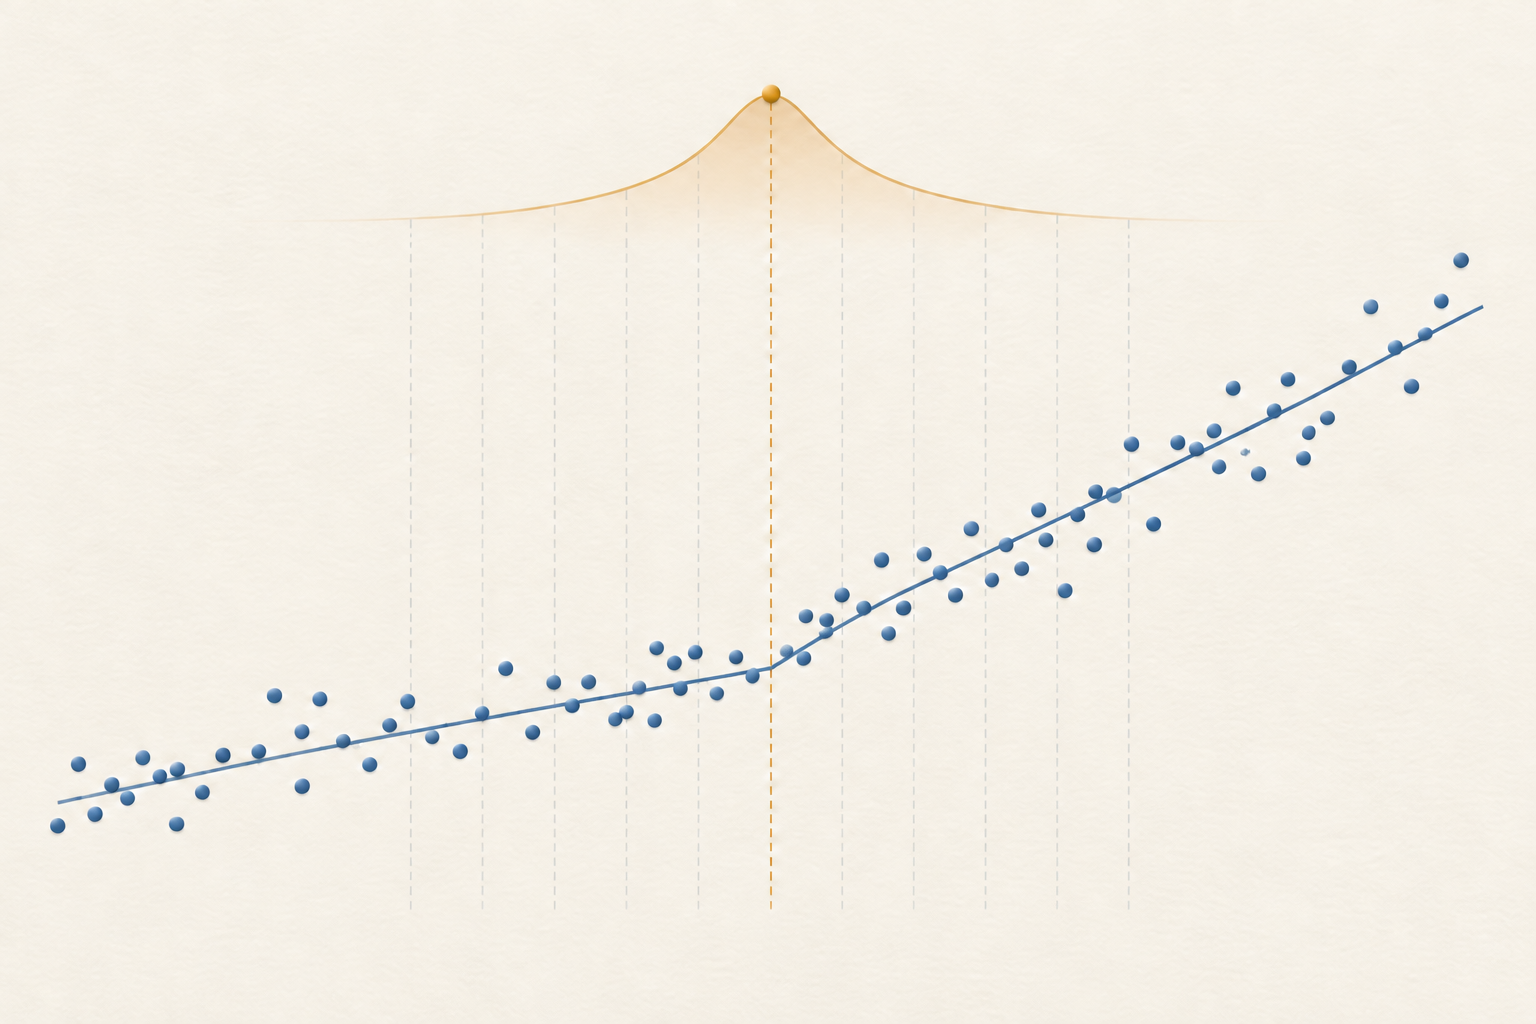
Statystyka sup-Wald to największa statystyka dla daty kandydującej
Niech (W(k)) oznacza statystykę Walda dla określonych ograniczeń współczynników przy dacie kandydującej (k). Statystyka sup-Wald dla jednej zmiany wynosi
supW = max{k ∈ K} W(k)
gdzie (K) jest zbiorem dopuszczalnych dat po przycięciu. W klasycznym zastosowaniu regresji liniowej maksymalizuje się często kandydackie statystyki Chow F i raportuje jako sup-F lub QLR. Maksymalizator (hat{k}=argmax_{kin K} W(k)) to data dająca największą statystykę w tym przeszukiwaniu. Jest wybranym oszacowaniem, a nie przedziałem ufności ani precyzyjnym znacznikiem czasu zmiany gospodarczej.
Nazwy są powiązane, ale nie zawsze zamienne. Zwykły homoskedastyczny test Chow F dla ustalonej daty może przy swoich założeniach mieć dokładny rozkład F w skończonej próbie. Maksimum po datach, asymptotyczna statystyka sup-Wald z odporną kowariancją i statystyka ilorazu wiarygodności nie muszą mieć identycznych wartości w skończonej próbie ani tych samych wartości krytycznych. Podaj faktycznie obliczoną statystykę, estymator kowariancji, regułę przycięcia i źródło wartości krytycznych, zamiast polegać wyłącznie na nazwie „QLR”.
Statystyki dla kandydackich dat są silnie zależne, ponieważ sąsiednie podziały wykorzystują prawie te same obserwacje. Test nie jest równoważny wybraniu najmniejszego p-value dla ustalonej daty, pomnożeniu go przez liczbę dat ani traktowaniu każdej daty jako niezależnego testu. Rozkład zerowy musi uwzględniać proces maksimum.
Przeszukane maksimum ma niestandardowy rozkład zerowy
Przy hipotezie zerowej o braku zmiany nie istnieje prawdziwa data zmiany do oszacowania. Parametr daty występuje przy alternatywie, ale znika pod zerem, więc zwykłe argumenty regularności dla jednego testu Walda lub F z datą ustaloną z góry nie mają zastosowania. Maksymalizacja po datach kandydujących prowadzi zatem do niestandardowego rozkładu asymptotycznego. Porównanie maksimum ze standardowym progiem F zwykle zawyża dowody przeciw stabilności.
Andrews wyprowadza rozkłady asymptotyczne i wartości krytyczne dla testów sup-Wald, LM oraz podobnych do LR; końce przyciętego przedziału i liczba testowanych ograniczeń opisują zakres wyszukiwania (1993). Właściwe wartości zależą też od modelu i założeń kowariancji. Użyj tabeli, implementacji lub przybliżenia dopasowanego do konkretnego testu; nie przenoś wartości krytycznej z innego ułamka przycięcia lub liczby ograniczeń. Andrews opublikował później korektę, ponieważ niektóre podane wartości krytyczne testów sup dla ośmiu ograniczeń były zbyt małe; w tym przypadku należy użyć poprawionej tabeli (korekta z 2003 r.). Hansen podaje numeryczne przybliżenia asymptotycznych wartości p dla testów zmian strukturalnych (1997).
Andrews i Ploberger wyprowadzają również testy średnie i wykładnicze dla parametrów zakłócających występujących wyłącznie przy alternatywie (1994). To pokrewne procedury uwzględniające przeszukiwanie, a nie inne nazwy sup-Wald. Jeśli używasz bootstrapu lub innej kalibracji dla skończonej próby, opisz schemat losowania i pokaż, że odtwarza strukturę zerową i to samo przeszukiwanie; ogólny bootstrap nie rozwiązuje automatycznie problemu wyboru daty ani zależności.
Przykład z dwunastoma obserwacjami pozwala sprawdzić przycięcie i maksimum
Rozważ celowo małą, hipotetyczną regresję wyłącznie ze stałą i obserwacjami
y = [0, 1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 3]
Jest (T=12) obserwacji. Dla ilustracji przyjmijmy (\varepsilon=0.25), tak by każdy segment miał co najmniej trzy obserwacje, a kandydackie ostatnie daty przed zmianą to (k=3,ldots,9). To przykład rachunku przeszukiwania, a nie zalecana wartość przycięcia ani próba do wnioskowania.
Średnia łączna wynosi (23/12), a suma kwadratów reszt modelu łącznego to
RSS₀ = Σ yₜ² − (Σ yₜ)²/12 = 59 − 529/12 = 179/12
Dla kandydata (k=6) suma i suma kwadratów w pierwszym segmencie wynoszą po 5, więc jego suma kwadratów reszt to (5−5²/6=5/6). Drugi segment zawiera sześć wartości równych 3, dlatego jego suma kwadratów reszt wynosi zero. Zatem (RSS₁(6)=5/6). Przy jednym ograniczeniu i dwóch szacowanych stałych segmentowych statystyka dla ustalonej daty wynosi
F(6) = [(RSS₀ − RSS₁(6))/1] / [RSS₁(6)/(12−2)] = 169
Ten sam rachunek dla wszystkich siedmiu kandydatów daje przybliżone wartości F: (7.21, 12.10, 25.28, 169.00, 20.71, 8.94, 4.59), kolejno dla (k=3,ldots,9). Sup-F to maksimum 169 przy (k=6). Obliczenie wskazuje kandydata maksymalizującego skonstruowany ciąg, ale nie podaje wartości p. Ponieważ datę wyszukiwano, wartość 169 trzeba porównać z niestandardową wartością krytyczną uwzględniającą przeszukiwanie i dopasowaną do projektu, a nie ze zwykłym rozkładem F dla ustalonej daty.
Interpretuj odrzucenie i brak odrzucenia w granicach projektu
Odrzucenie oznacza, że przy wybranym poziomie istotności, założeniach testu i wartościach krytycznych hipoteza zerowa o stałych współczynnikach nie jest zgodna z największą statystyką znalezioną w dopuszczalnym zakresie. Nie dowodzi to jednego precyzyjnie ustalonego przełomu. Sąsiednie daty kandydujące mogą mieć podobne statystyki, a widoczny szczyt może się przesunąć po zmianie końca próby, przycięcia, regresorów lub metody kowariancji. Pokaż profil statystyk dla kandydatów albo właściwą analizę niepewności daty, zamiast przedstawiać (hat{k}) jako dokładny moment.
Brak odrzucenia nie potwierdza stabilności współczynników. Test może mieć małą moc dla niewielkiej zmiany, zmiany blisko przyciętego końca lub zmiany dotyczącej współczynnika poza testowanymi ograniczeniami. Test jednej zmiany może też nie wykryć kilku częściowo znoszących się zmian. Z drugiej strony wartości odstające, zmiana wariancji, pominięta dynamika, zmiana definicji danych lub wielokrotne przeszukiwanie specyfikacji mogą wytworzyć dowody niestabilności. Test odpowiada na ograniczone pytanie statystyczne, a nie wskazuje przyczyny.
Data jest wybierana z tych samych danych co test. Nie traktuj jej jak daty zdarzenia określonej wcześniej w drugim, nieskorygowanym teście istotności, a potem nie twierdź, że uzyskano niezależne potwierdzenie. Jeśli data ma kierować aktualizacją prognozy lub regułą handlową, określ tę regułę i oceń ją na późniejszych danych; statystyka sup w próbie nie dowodzi trwałości po zmianie ani wartości ekonomicznej.
Rozróżnij pytania testów Chow, CUSUM i Bai–Perrona
| Metoda | Główne pytanie | Czego nie robi |
|---|---|---|
| Test Chow | Czy współczynniki różnią się w dacie ustalonej z góry? | Nie przeszukuje nieznanych dat przy zachowaniu rozkładu odniesienia dla jednej daty |
| [Test sup Quandta–Andrewsa](#) | Czy w przyciętym zakresie istnieje dowód jednej zmiany w jakiejś dacie? | Nie wybiera nieznanej liczby zmian ani nie wyjaśnia ich przyczyny |
| CUSUM regresji | Czy uporządkowana ścieżka reszt rekurencyjnych jest sprzeczna ze stabilnością współczynników? | Samodzielnie nie zwraca wybranej daty jednej zmiany |
| Bai–Perron | Ile zmian i jakie daty wspiera model wielu zmian? | Nie zastępuje specyfikacji i wyborów selekcyjnych testu jednej zmiany |
Model Hidden Markov lub przełączania reżimów stawia inne pytanie: czy obserwacje można opisać za pomocą stanów ukrytych, które mogą wielokrotnie zmieniać się zgodnie z prawdopodobieństwami przejścia. Test jednej nieznanej zmiany rozważa jeden trwały podział przed/po w swoim zakresie. Metody mogą się uzupełniać, ale ich założenia i wyniki nie są zamienne; zobacz przewodnik po przełączaniu reżimów.
Opisz przeszukiwanie, aby inny analityk mógł je odtworzyć
Podaj zmienną wynikową i regresory, informację o zmianie czystej lub częściowej, testowane ograniczenia współczynników, daty i kolejność próby oraz konwencję daty zmiany. Podaj (T), liczbę ograniczeń, ułamek przycięcia lub dokładny zbiór dat kandydackich, minimalną wielkość segmentu oraz informację, czy wybrana statystyka to sup-Wald, sup-F/QLR, sup-LM czy inna procedura. Uwzględnij estymator kowariancji, metodę wyznaczania wartości krytycznych lub p-value oraz zastosowane poprawki dla skończonej próby.
Pokaż statystykę dla kolejnych dat kandydujących i podaj datę maksymalizującą jako wybraną lokalizację, wraz z informacją o niepewności lub wrażliwości, jeśli jest dostępna. Wyjaśnij, czy model i projekt testu ustalono wcześniej, jak potraktowano brakujące obserwacje i dane dostępne w czasie rzeczywistym oraz jakie alternatywne próby lub regresory sprawdzono. Jeśli analiza służy prognozowaniu, wyszukiwanie zmian pozostaw w próbie treningowej, a zmodyfikowany model oceń na późniejszych, wcześniej niewykorzystanych danych.
Istotność statystyczna testu nieznanej zmiany nie identyfikuje przyczyny zdarzenia ani nie dowodzi zyskownego reżimu. Wynik nieistotny nie potwierdza stabilności. Uzasadniony wniosek ogranicza się do określonej alternatywy jednej zmiany, przyciętego zakresu dat, regresji, próby i metody wnioskowania uwzględniającej przeszukiwanie.
Częste pytania
Q1Czy test Quandta–Andrewsa to tylko test Chow powtarzany dla wielu dat?
Oblicza pokrewną statystykę dla dat kandydujących, ale wnioskowanie musi uwzględniać wybór maksimum. Podanie największego zwykłego wyniku Chow wraz z wartością p dla ustalonej daty ignoruje przeszukiwanie i zwykle opiera się na niewłaściwym rozkładzie zerowym.
Q2Czy data maksymalizująca statystykę wskazuje, kiedy zdarzenie gospodarcze spowodowało zmianę?
Nie. To data kandydująca z największą statystyką w wybranej próbie i przyciętym zakresie. Nie jest przyczynowym znacznikiem czasu ani przedziałem ufności; sąsiednie daty i wybory projektowe mogą dać podobne wyniki.
Q3Czy odrzucenie oznacza, że wystąpiła dokładnie jedna zmiana?
Nie. Odrzuca określoną hipotezę zerową o stałych współczynnikach na rzecz pewnej alternatywy jednej zmiany w przeszukiwanym zakresie. Dowody niestabilności mogą też wynikać z wielu zmian, wartości odstających, zmian wariancji lub błędnej specyfikacji; estymacja wielu zmian to odrębne zadanie.
Q4Czy mogę porównać maksimum sup-Wald ze zwykłą tabelą F?
Zasadniczo nie. Użyj wartości krytycznych lub p-value zgodnych ze statystyką sup, przycięciem, liczbą ograniczeń, modelem i założeniami kowariancji. Zwykły rozkład F dotyczy testu dla daty ustalonej z góry i przy jego założeniach, a nie automatycznie przeszukanego maksimum. Badania źródłowe - Quandt, “Tests of the Hypothesis That a Linear Regression System Obeys Two Separate Regimes” (1960) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point” (1993) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point: A Corrigendum” (2003) - Hansen, “Approximate Asymptotic P Values for Structural-Change Tests” (1997) - Andrews and Ploberger, “Optimal Tests When a Nuisance Parameter Is Present Only Under the Alternative” (1994) - Chow, “Tests of Equality Between Sets of Coefficients in Two Linear Regressions” (1960) - Bai and Perron, “Estimating and Testing Linear Models with Multiple Structural Changes” (1998) - Brown, Durbin, and Evans, “Techniques for Testing the Constancy of Regression Relationships over Time” (1975)
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Co robi test sup-Wald Quandta–Andrewsa, gdy data zmiany jest nieznana?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie
Słownik opcji
A model generating observations from finite discrete latent states with Markov transition probabilities and state-dependent emissions.
Czytaj szczegółowy przewodnikAt the moneyA call or put whose strike is near the underlying price; it has little intrinsic value and often substantial sensitivity to time and volatility.
Czytaj szczegółowy przewodnik