

Testy Bai–Perrona wielu zmian strukturalnych w regresji
Dowiedz się, jak metody Bai–Perrona wyszukują nieznaną liczbę i daty zmian w regresji, jak działają przycinanie próby i wartości krytyczne oraz czego nie dowodzą same oszacowania.
W tym przewodnikuJakie pytanie stawia test regresji z wieloma zmianami
Krótkie podsumowanie
Metody Bai–Perrona wspólnie szacują daty zmian w regresji dla ustalonej liczby zmian. Następnie testy lub kryteria wyboru modelu oceniają, ile zmian wspierają dane. Daty i liczba zależą od regresji, minimalnej długości segmentu, założeń o błędach oraz procedury wyszukiwania; same w sobie nie wskazują przyczyny ani przewagi w tradingu.
Jakie pytanie stawia test regresji z wieloma zmianami
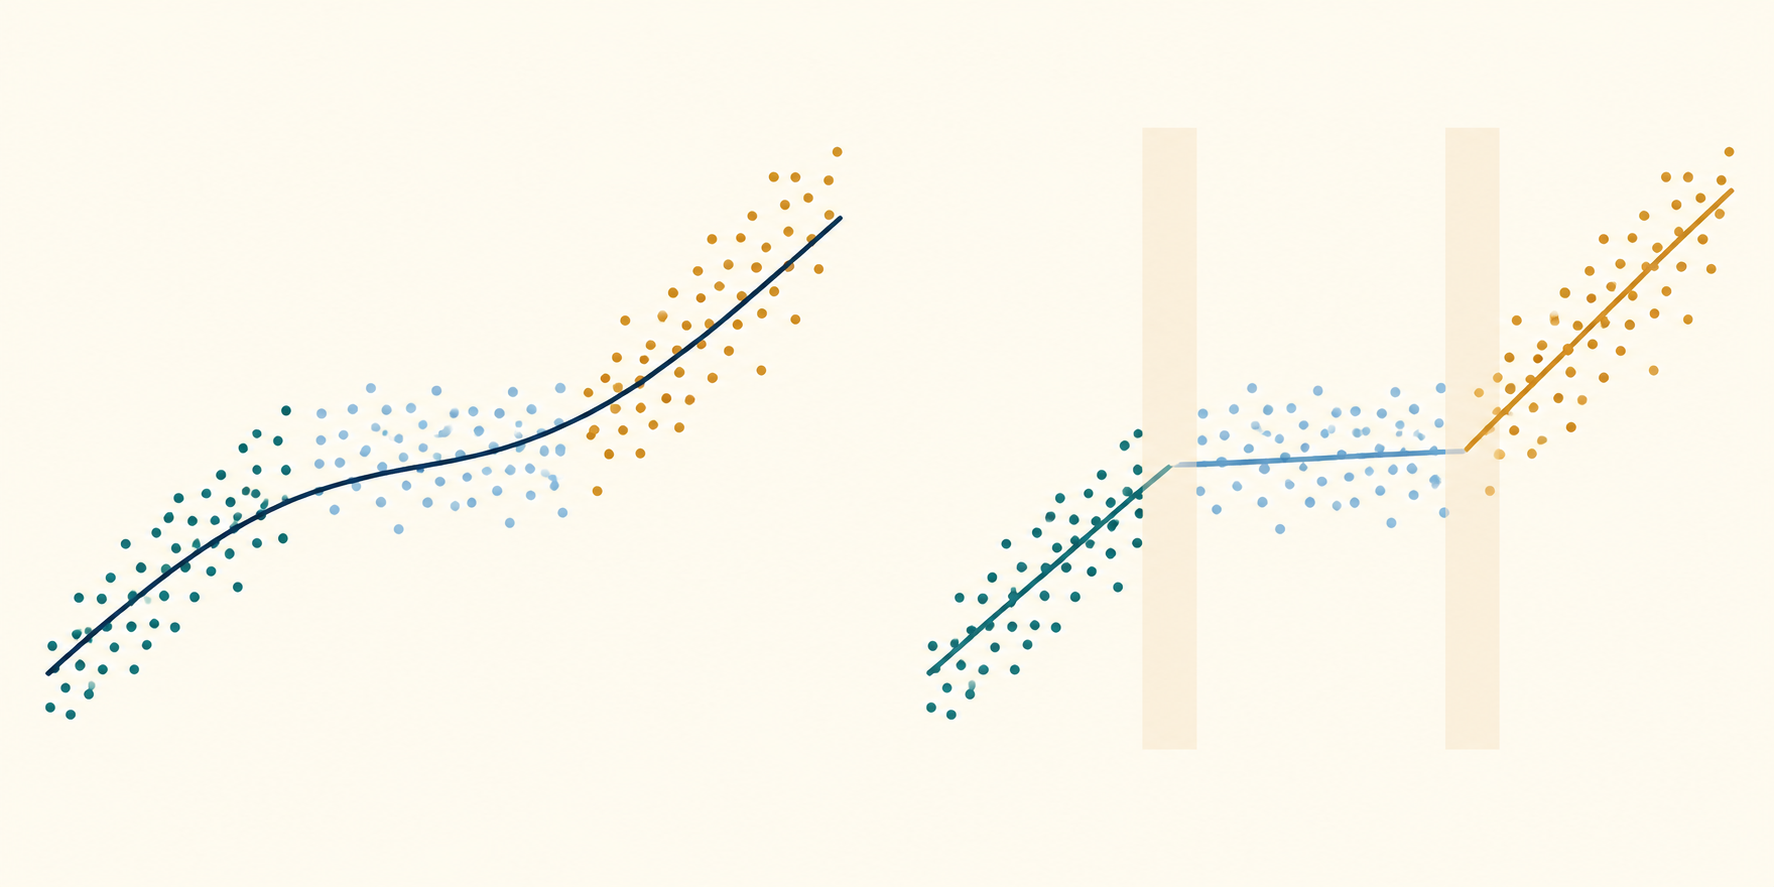
Zmiana strukturalna w regresji oznacza, że co najmniej jeden współczynnik mógł zmienić się w nieznanym punkcie próby. Jedno oszacowanie dla całej próby może to ukryć: jeśli relacja między stopą zwrotu a ryzykiem jest dodatnia w jednym okresie, a później słabnie lub odwraca się, średni współczynnik może nie opisywać dobrze żadnego z tych okresów. Metody Bai–Perrona ujmują ten problem jako jawną procedurę wyszukiwania podziałów obserwacji.
Kluczowa różnica względem testu Chow dotyczy tego, czy datę ustalono z góry. Test Chow porównuje podpróby po obu stronach wskazanej daty. Sprawdzenie wielu dat i podanie największej zwykłej statystyki Chow nie zachowuje standardowego rozkładu odniesienia pojedynczego testu. Testy Bai–Perrona uwzględniają wyszukiwanie dat kandydujących i mogą oceniać więcej niż jedną zmianę. Przypadek daty ustalonej z góry opisuje przewodnik po teście Chow.
Trzeba je odróżnić także od regresyjnego CUSUM. CUSUM bada uporządkowaną w czasie ścieżkę reszt rekurencyjnych pod kątem dowodów przeciw stabilności, ale sam nie zwraca wybranego zestawu wielu dat zmian. Bai–Perron szacuje natomiast podział w ramach jawnego modelu regresji odcinkowej. Żadna z tych metod nie wyjaśnia, dlaczego relacja się zmieniła. Diagnostykę opartą na ścieżce reszt omawia przewodnik po regresyjnym CUSUM.
Zapisz regresję z nieznanymi datami i liczbą zmian
Załóżmy, że mamy \(T\) obserwacji i \(m\) zmian w całkowitych datach \(T_1<\cdots<T_m\). Przyjmijmy \(T_0=0\) i \(T_{m+1}=T\), a segment \(j\) zdefiniujmy jako obserwacje \(T_{j-1}+1,\ldots,T_j\). W modelu z czystą zmianą strukturalną:
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Tutaj \(y_t\) to zmienna wynikowa, \(x_t\) to wektor uwzględnionych zmiennych objaśniających, \(\beta_j\) to wektor współczynników w segmencie \(j\), a \(u_t\) to składnik błędu. Nieznane są nie tylko współczynniki: jeśli projekt badania ich z góry nie ustala, trzeba również oszacować lub wybrać daty i liczbę \(m\). Model zakłada ponadto sensowną kolejność obserwacji i stabilny wektor współczynników wewnątrz każdego segmentu przy przyjętej specyfikacji.
W przykładzie finansowym \(y_t\) może oznaczać stopę zwrotu portfela, a \(x_t\) może obejmować stopę zwrotu rynku, zmianę stóp procentowych lub miarę zmienności. Wykryta zmiana oznacza, że w próbie i według zastosowanej procedury odcinkowa liniowa wartość oczekiwana warunkowa jest lepiej dopasowana. Nie oznacza to, że wskazane zdarzenie zmieniło współczynnik, zmienna objaśniająca jest egzogeniczna ani że relacja pozostanie stabilna poza próbą.
Warto odróżnić datę obserwacji od daty kalendarzowej. Jeśli dane to dzienne sesje giełdowe, zmiana między sesją 120. a 121. nie musi odpowiadać jednemu dniowi kalendarzowemu; święta, brakujące notowania i nieregularne odstępy wpływają na to przyporządkowanie. Zanim potraktujesz datę zmiany jak znacznik czasu zdarzenia, określ kolejność próby i konwencję raportowania dat.
Świadomie wybierz czystą albo częściową zmianę strukturalną
W modelu z czystą zmianą strukturalną każdy współczynnik w \(\beta_j\) może zmieniać się między segmentami. Pozwala to na zmianę wyrazu wolnego i wszystkich nachyleń, ale wymaga większej liczby parametrów specyficznych dla segmentów. Dlatego precyzyjne oszacowanie zmian może być trudne przy krótkich segmentach lub dużej liczbie zmiennych objaśniających. Czysta zmiana jest właściwa tylko wtedy, gdy pytanie dopuszcza ponowne ustalenie każdej modelowanej relacji.
W modelu z częściową zmianą strukturalną niektóre współczynniki są wspólne, a inne mogą się zmieniać. Przykładowo zapiszmy \(\beta_j=(\delta',\gamma_j')'\), gdzie \(\delta\) jest wspólne dla segmentów, a \(\gamma_j\) zależy od segmentu. Może to wyrażać merytoryczne ograniczenie: wyraz wolny i nachylenie dla ekspozycji na politykę mogą się zmieniać, ale efekt zmiennej kontrolnej pozostaje wspólny. Ograniczenie zmienia zarówno funkcję celu dopasowania, jak i rozkład odniesienia testu. Należy je jawnie opisać, a nie traktować jako nieszkodliwego uproszczenia.
Inny jest także sposób obliczeń. Przy czystej zmianie suma kwadratów reszt (RSS) dla podziału jest sumą niezależnych RSS segmentów, więc programowanie dynamiczne może optymalizować podział przy ustalonej liczbie zmian. W modelu częściowym wspólne współczynniki łączą wszystkie segmenty. Bai i Perron opisują procedurę iteracyjną: najpierw szacuje się daty i zmienne współczynniki przy ustalonych współczynnikach wspólnych, a potem aktualizuje się współczynniki wspólne dla danego podziału. Sama prosta addytywna rekurencja RSS segmentów nie rozwiązuje całego ograniczonego problemu. Specyfikację dobierz do pytania naukowego lub prognostycznego, a nie do tego, która wersja wskazuje więcej zmian.
Ustal minimalną długość segmentu przed przeglądaniem dat kandydujących
Wyszukiwanie wymaga minimalnej liczby obserwacji w każdym segmencie. Reguła przycinania zapobiega dopasowywaniu bardzo krótkich przedziałów, które mogłyby dawać niestabilne współczynniki, ale wyklucza też rzeczywiste zmiany zbyt bliskie końcowi próby lub innemu punktowi zmiany. To element projektu badania, a nie uniwersalne prawo.
Rozważmy wyraźnie hipotetyczny przykład z \(T=240\) obserwacjami i wybranym udziałem przycinania równym 15%. Daje to \(h=0{,}15\times240=36\) obserwacji jako minimalną długość każdego segmentu. Jeśli data zmiany oznacza ostatnią obserwację wcześniejszego segmentu, przy jednej zmianie dopuszczalne daty to \(36\le T_1\le204\). Po obu stronach pozostaje wtedy co najmniej 36 obserwacji.
Przy dwóch zmianach dopuszczalne pary dat muszą spełniać:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Zatem \(T_1\le168\), a \(T_2\) musi wypadać co najmniej 36 obserwacji po pierwszej zmianie i pozostawiać 36 obserwacji po drugiej. Para \((72,156)\) jest dopuszczalna: trzy segmenty mają odpowiednio 72, 84 i 84 obserwacje. Para \((80,100)\) nie jest dopuszczalna, ponieważ środkowy segment ma tylko 20 obserwacji. Przy takim \(h\) w 240 obserwacjach może wystąpić najwyżej pięć zmian: sześć segmentów wymaga co najmniej \(6\times36=216\) obserwacji, a siedem — 252.
Wartość 15% jest tu jawnie hipotetyczną decyzją projektową, a nie domyślną rekomendacją. Większy udział może wykluczyć krótkotrwałe reżimy i daty bliskie granicom próby; mniejszy dopuszcza krótkie segmenty, ale może pozostawić zbyt mało informacji do wiarygodnego oszacowania nachyleń i długookresowych wielkości kowariancji. Wybierz regułę na podstawie częstotliwości próbkowania, liczby zmiennych objaśniających, prawdopodobnego czasu trwania reżimu i metody wnioskowania. Podaj ją w raporcie i, jeśli ma to uzasadnienie merytoryczne, pokaż, czy wnioski zmieniają się przy zbliżonych wartościach. Przy opóźnieniach lub brakujących obserwacjach implementacje mogą inaczej definiować efektywną liczebność próby i końce zakresu, dlatego opisz faktycznie zastosowaną konwencję.
Użyj programowania dynamicznego do znalezienia globalnego podziału przy ustalonej liczbie zmian
W modelu z czystą zmianą i ustalonym \(m\) wyszukiwanie dat można zapisać jako minimalizację łącznej RSS segmentów:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
przy ograniczeniach kolejności dat i minimalnej długości segmentu. \(\operatorname{SSR}(a,b)\) to najmniejsza suma kwadratów reszt z estymacji najmniejszych kwadratów dla jednego segmentu obejmującego obserwacje \(a,\ldots,b\). Naiwne przeszukanie sprawdza każdą kombinację dat, których liczba szybko rośnie wraz z \(T\) i \(m\).
Programowanie dynamiczne ponownie wykorzystuje rozwiązania podproblemów. Jeśli \(D(r,j)\) oznacza najmniejszą RSS dla podziału obserwacji od 1 do \(j\) na \(r\) dopuszczalnych segmentów, jedną z postaci rekurencji jest:
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
gdzie punkt podziału \(i\) jest ograniczony tak, aby każdy z pierwszych \(r-1\) segmentów i ostatni segment spełniały minimalną długość. Zachowanie punktu podziału minimalizującego wartość na każdym etapie pozwala odtworzyć daty. Dla każdej dopuszczalnej liczby segmentów algorytm znajduje podział o globalnie najmniejszej RSS przy określonym modelu i ograniczeniach, zamiast zachłannie dodawać zmiany po jednej. Bai i Perron (2003) opisują te obliczenia oraz modele czystej i częściowej zmiany.
„Globalny” oznacza tu warunkowy względem wybranej liczby, zmiennych objaśniających, składników deterministycznych, przycinania i funkcji celu. Nie oznacza, że model statystyczny jest prawdziwy, wybrana liczba jest poprawna ani że podział jest optymalny spośród wszystkich możliwych specyfikacji. Procedura może efektywnie porównywać kilka liczb, ale wybór \(m\) jest odrębnym etapem wnioskowania lub selekcji modelu.
Wybierz liczbę zmian za pomocą wnioskowania uwzględniającego wyszukiwanie lub kryteriów
Po obliczeniu najlepszych podziałów dla liczb kandydujących można wybrać \(m\) na kilka sposobów. Sekwencyjny test \(\sup F(\ell+1\mid\ell)\) porównuje model z \(\ell\) zmianami z modelem zawierającym jedną dodatkową zmianę, używając supremum statystyki dla dopuszczalnych dat. Testy podwójnego maksimum, takie jak UDmax lub WDmax, weryfikują brak zmian wobec alternatywy z nieznaną liczbą zmian do określonego maksimum. Kryteria informacyjne, w tym warianty BIC, zestawiają poprawę dopasowania z karą za złożoność. Metody te odpowiadają na powiązane, lecz nie identyczne pytania.
Zwykła wartość krytyczna rozkładu F zazwyczaj nie jest odpowiednia po maksymalizacji względem nieznanych dat zmian. Pod hipotezą zerową o braku zmian daty kandydackie nie są zidentyfikowane w taki sam sposób jak pod alternatywą, co prowadzi do niestandardowych rozkładów asymptotycznych. Wartości krytyczne zależą między innymi od przycinania, zmiany czystej lub częściowej, zmiennych objaśniających i założeń o kowariancji błędów. Bai i Perron (1998) wyprowadzają testy wielu zmian; ich późniejsza praca o wartościach krytycznych podaje wartości dla różnych reguł przycinania i specyfikacji modeli. Andrews (1993) przedstawia ważne wyniki testów niestabilności z jednym nieznanym punktem zmiany, ale jego wartości krytyczne nie zastępują procedury dla wielu zmian.
Testy sekwencyjne są łatwe do interpretacji, lecz ich wyniki mogą zależeć od mocy testu na każdym etapie i ustalonej wcześniej maksymalnej liczby zmian. Kryteria informacyjne mogą wybrać różne liczby ze względu na odmienne kary; wszystkie modele kandydujące mogą też być tylko przybliżeniami. Więcej zmian nie musi oznaczać bardziej realistycznego opisu: niewielka poprawa dopasowania może wiązać się z niestabilnymi współczynnikami segmentów. Podaj metodę, maksimum, przycinanie, sekwencję testów lub kryterium oraz założenia dotyczące odpowiednich wartości krytycznych. Jeśli wybór ma istotne znaczenie, pokaż analizę wrażliwości zamiast przedstawiać jedną liczbę jako pewnik.
Traktuj oszacowane daty jako niepewne estymaty warunkowe
Daty minimalizujące kryterium są estymatami punktowymi przy określonym modelu. Nie przedstawiaj ich tak, jakby dane wskazywały dokładną chwilę zmiany relacji ekonomicznej. Zmienność próby, mała zmiana współczynnika, blisko położone zmiany, zaszumiony wynik, niewielka zmienność regresorów i duża minimalna długość segmentu mogą spłaszczyć funkcję celu w pobliżu minimum. Kilka sąsiednich podziałów może wtedy dopasowywać się niemal równie dobrze.
Bai i Perron opracowują przedziały ufności dla dat zmian przy określonych założeniach. Opisują one niepewność próbkowania dla modelowanych dat, lecz nie obejmują całej niepewności co do poprawności specyfikacji regresji, wyboru zmiennych, liczby zmian ani reguły przycinania. Jeżeli niepewna jest również liczba zmian, wąski przedział daty obliczony warunkowo względem jednej wybranej liczby może zaniżać ogólną niepewność.
W raporcie rozróżnij konwencję datowania, oszacowany indeks obserwacji, odpowiadającą mu datę kalendarzową i przedział dla każdej zmiany. Jeśli przedziały są szerokie lub się pokrywają, opisz lokalizację jako słabo określoną. Nie wybieraj daty z wykresu po obejrzeniu wyniku, a następnie nie przedstawiaj jej jako niezależnie przewidzianego momentu zdarzenia. Porównując zmianę z konkretnym zdarzeniem, uwzględnij, że zdarzenie i okno mogły zostać wybrane po obejrzeniu danych.
Dopasuj wnioskowanie do zależności szeregowej i zmiennej wariancji
Podział według RSS jest kryterium dopasowania; poprawność testów i przedziałów ufności zależy od założeń o regresorach i błędach. Regresje finansowe często zawierają autokorelację, warunkową heteroskedastyczność, wartości odstające, zmienną zmienność, nakładające się stopy zwrotu lub asynchroniczne obserwacje. Jeżeli estymator kowariancji i wartości krytyczne zakładają niezależne błędy o jednakowej wariancji, a reszty są zależne lub heteroskedastyczne, podana istotność może wprowadzać w błąd nawet wtedy, gdy oszacowane daty wydają się wiarygodne.
Prace Bai–Perrona opisują procedury w bardziej ogólnych warunkach, obejmujących pewne postaci heteroskedastyczności i zależności szeregowej. Nadal trzeba jednak dobrać korektę kowariancji i wartości odniesienia do konkretnego zastosowania. Odporne lub HAC oszacowanie kowariancji nie naprawia pominiętej dynamiki, endogenicznego regresora, błędnie określonej średniej warunkowej ani kalendarza obserwacji łączącego nieporównywalne odstępy. Sam odporny błąd standardowy nie zmienia też funkcji celu RSS w lepszy model danych.
Sprawdź zależność reszt i wzorce wariancji wewnątrz segmentów kandydujących oraz między nimi. Opisz, czy założenia o błędach dopuszczają wariancje różne między segmentami, korelację szeregową lub zmiany rozkładu regresorów, i czy teoria wybranego testu obejmuje te przypadki. W bardzo krótkich segmentach odporne szacowanie kowariancji jest szczególnie kruche, dlatego przycinanie i wymiar modelu należy planować łącznie. Podstawowe informacje o estymacji regresji i założeniach kowariancji zawiera przewodnik po regresji OLS.
Raportuj analizę zmian bez formułowania twierdzeń przyczynowych ani tradingowych
Raport umożliwiający odtworzenie analizy podaje zmienną wynikową, wszystkie regresory, transformacje, okres i częstotliwość próby, wyraz wolny i ograniczenia współczynników, specyfikację czystej lub częściowej zmiany, maksymalną liczbę kandydacką \(m\), udział przycinania i minimalną długość, konwencję datowania, metodę optymalizacji oraz test lub kryterium wyboru \(m\). Uwzględnia wybraną liczbę zmian, współczynniki dla segmentów, daty i przedziały niepewności, statystyki testów, sposób traktowania kowariancji i źródło wartości krytycznych. Wyjaśnia również, które końcowe obserwacje wykluczono z wyszukiwania.
Statystycznie wykryta zmiana stanowi dowód niestabilności parametrów w określonej regresji i przy jej założeniach. Nie wskazuje zdarzenia, które ją spowodowało, nie dowodzi, że odpowiada za nią konkretna informacja lub decyzja polityczna, ani że współczynniki sprzed lub po zmianie utrzymają się w przyszłości. Zmiana może odzwierciedlać pominiętą zmienną, zmienioną definicję danych, epizod zmienności, błąd pomiaru lub rzeczywistą zmianę gospodarczą; sam test regresji nie rozróżnia tych wyjaśnień.
W tradingu ilościowym wyszukiwanie w całej próbie wykorzystuje obserwacje z obu stron każdej oszacowanej zmiany. Handel tak, jakby wybrana data była znana w czasie rzeczywistym, wprowadza obciążenie informacją z przyszłości. Proponowaną regułę reżimu oceniaj chronologicznie, szacuj ponownie wyłącznie na podstawie informacji dostępnych w danym momencie i uwzględnij spread, prowizje, wpływ rynkowy, finansowanie, pożyczanie, obrót i opóźnienia. Porównaj ją z prostymi punktami odniesienia o stałych parametrach oraz strategią bez transakcji, a do walidacji zachowaj rzeczywiście późniejsze dane. Zmiana może skłonić do przeglądu modelu lub ryzyka, ale nie dowodzi mocy prognostycznej ani przewagi inwestycyjnej.
Bai i Perron (1998) przedstawiają testy i estymację wielu zmian strukturalnych w modelach liniowych w swoim oryginalnym artykule. Ich artykuł obliczeniowy z 2003 r. wyjaśnia programowanie dynamiczne i modele zmian częściowych, a artykuł o wartościach krytycznych opisuje ich zależność od projektu badania. Artykuł Andrewsa o nieznanych punktach zmiany stanowi pokrewną podstawę dla pojedynczej zmiany. Jako sąsiednie diagnostyki porównaj test Chow z datą ustaloną z góry z regresyjnym testem CUSUM.
Częste pytania
Q1Czy Bai–Perron podaje prawdziwą liczbę zmian?
Nie. Metoda szacuje podziały i dostarcza testów lub kryteriów wyboru spośród liczb kandydujących. Wynik zależy od specyfikacji regresji, przycinania, założeń o błędach, maksymalnej liczby oraz reguły wyboru; nie dowodzi, że proces generujący dane zawierał dokładnie tyle zmian.
Q2Czy data zmiany jest datą, w której zdarzenie gospodarcze spowodowało zmianę?
Nie. To obarczone niepewnością próbkowania oszacowanie miejsca niestabilności parametrów w dopasowanym modelu. Ustalenie przyczyny wymaga dodatkowych dowodów i projektu badania wykluczającego konkurencyjne wyjaśnienia.
Q3Czy mogę bezpośrednio handlować na podstawie oszacowanych dat zmian?
Nie na podstawie samego retrospektywnego oszacowania dla całej próby. Wyszukiwanie wykorzystuje także obserwacje po danej zmianie kandydującej. Reguła działająca na żywo wymaga oceny chronologicznej, informacji dostępnych w danym momencie, uwzględnienia kosztów i późniejszej walidacji; wykryta zmiana nie dowodzi istnienia zyskownego sygnału.
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Co oznacza minimalna długość segmentu równa 15% w przykładzie z 240 obserwacjami?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie