

Pre-averaging voor gerealiseerde volatiliteit: een schatter voor microstructuurruis
Lees hoe pre-averaging korte hoogfrequente rendementsvensters afvlakt, de belangrijkste ruisbias corrigeert, de vensterlengte afstemt en verschilt van TSRV en realized kernels.
In deze gidsWaarom zeer frequente rendementen prijsvariatie verkeerd kunnen meten
Korte samenvatting
Pre-averaging schat prijsveranderingen wanneer zeer frequent vastgelegde prijzen microstructuurruis bevatten. In plaats van elk ruw rendement afzonderlijk te kwadrateren, maakt de methode overlappende, gewogen sommen van naburige rendementen, kwadrateert die en trekt vervolgens een term af voor de belangrijkste ruisbijdrage. De uitkomst hangt af van de gewichten, vensterlengte, steekproefopzet en aannames over de ruis. De methode meet variatie in een waargenomen interval; het is geen volatiliteitsverwachting of handelssignaal.
Waarom zeer frequente rendementen prijsvariatie verkeerd kunnen meten
Als de waargenomen prijs gelijk was aan de efficiënte prijs, zou de som van gekwadrateerde intradayrendementen een natuurlijke schatter zijn voor de variatie tijdens de sessie. Werkelijke transactieprijzen en quotes kunnen echter worden beïnvloed door bid-ask-bounce, afronding op de tickgrootte, vertraging, discrete prijsstappen of registratieregels. Bij een extreem kort steekproefinterval kunnen die effecten een groot deel van elk gekwadrateerd rendement vormen. Meer waarnemingen kunnen dan de ruisbijdrage vergroten in plaats van alleen meer beweging van de latente prijs zichtbaar te maken.
Pre-averaging pakt dit aan door rendementen in een kort lokaal venster te combineren voordat ze worden gekwadrateerd. Een gladde gewichtsfunctie begint bij nul, geeft gewicht aan naburige rendementen en loopt aan het venstereinde weer terug naar nul. De gewogen som werkt als een lokaal filter: snelle, onafhankelijke waarnemingsfouten kunnen elkaar deels opheffen, terwijl bredere beweging van de efficiënte prijs behouden kan blijven. Overlappende vensters benutten informatie over het hele interval.
Afvlakken alleen maakt een schatter niet onvertekend. Ook de gekwadrateerde gefilterde rendementen bevatten variatie door ruis, dus is een correctieterm nodig. Jacod, Li, Mykland, Podolskij en Vetter leiden onder expliciete aannames een pre-averagingmethode af voor geïntegreerde volatiliteit en laten zien dat geschikte varianten de convergentiesnelheid \(n^{-1/4}\) bereiken. Hun oorspronkelijke artikel vormt de basis; deze gids behandelt de werking, keuzes en beperkingen.
Scheid de latente prijs, waargenomen prijs en doelgrootheid
Noem \(X_{t_i}\) de latente efficiënte logprijs op waarnemingstijdstip \(t_i\), en \(Y_{t_i}\) de geregistreerde logprijs:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
waar \(\epsilon_{t_i}\) de waarnemingsruis is. Een veelgebruikt basismodel behandelt \(X_t\) als een continu semimartingaal met lokale variantiesnelheid \(\sigma_t^2\). De doelgrootheid over een vast interval \([0,T]\) is de geïntegreerde variantie:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Het waargenomen rendement kan worden geschreven als \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Zelfs als prijsfouten onafhankelijk zijn tussen waarnemingen, delen twee aangrenzende rendementen één eindpuntfout met tegengesteld teken. Daardoor ontstaat seriële afhankelijkheid in de rendementen en wordt de gerealiseerde variantie op basis van alle waarnemingen gevoelig voor het aantal ruisbevattende verschillen.
Een eenvoudige theoretische uitleg veronderstelt meestal ruis met gemiddelde nul die onafhankelijk is door de tijd en van het efficiënte-prijsproces, met geschikte eindige momenten. Dat maakt de correctie begrijpelijk, maar de aannames gelden niet vanzelfsprekend voor transacties, quotes of middenprijzen. Ruis kan veranderen met liquiditeit en tijdstip, samenhangen met de efficiënte prijs of serieel afhankelijk zijn. Ook de doelgrootheid moet duidelijk zijn: bij sprongen bevat de kwadratische variatie hun kwadraten, terwijl de continue geïntegreerde variantie dat niet doet.
Dit is een meting achteraf voor een bepaalde prijsreeks en periode. De methode reconstrueert niet elke latente prijs, wijst geen afzonderlijke foutieve transactie aan en vertelt niets over toekomstige volatiliteit. Vermeld daarom of de invoer transactieprijzen, middenprijzen van quotes of een andere prijsconstructie gebruikt.
Bouw overlappende pre-averaged rendementen
Kies voor \(n\) waargenomen rendementen \(r_i=Y_{t_i}-Y_{t_{i-1}}\) een gehele vensterlengte \(k_n\) en een gewichtsfunctie \(g\) op \([0,1]\). Een gangbaar pre-averaged rendement is
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
De functie is gewoonlijk continu, is nul aan beide uiteinden en is voldoende glad voor de asymptotische resultaten. Een driehoekig voorbeeld is \(g(u)=\min(u,1-u)\). Omdat de gewichten aan de vensterranden nul zijn, krijgen rendementen aan de rand niet plotseling het volle gewicht. Dit beschrijft lokale weging, geen verwachting of geschatte trend.
Elke \(\bar r_i\) combineert aangrenzende rendementen voordat die worden gekwadrateerd. Doordat de vensters overlappen, zijn de pre-averaged rendementen onderling gecorreleerd, zelfs als de ruwe rendementen dat niet zijn. Die afhankelijkheid hoort bij het steekproefgedrag van de schatter; behandel de vele venstersommen dus niet als onafhankelijke waarnemingen. De indexreeks en eindpuntconventie moeten passen bij de normalisatie van de gewichten.
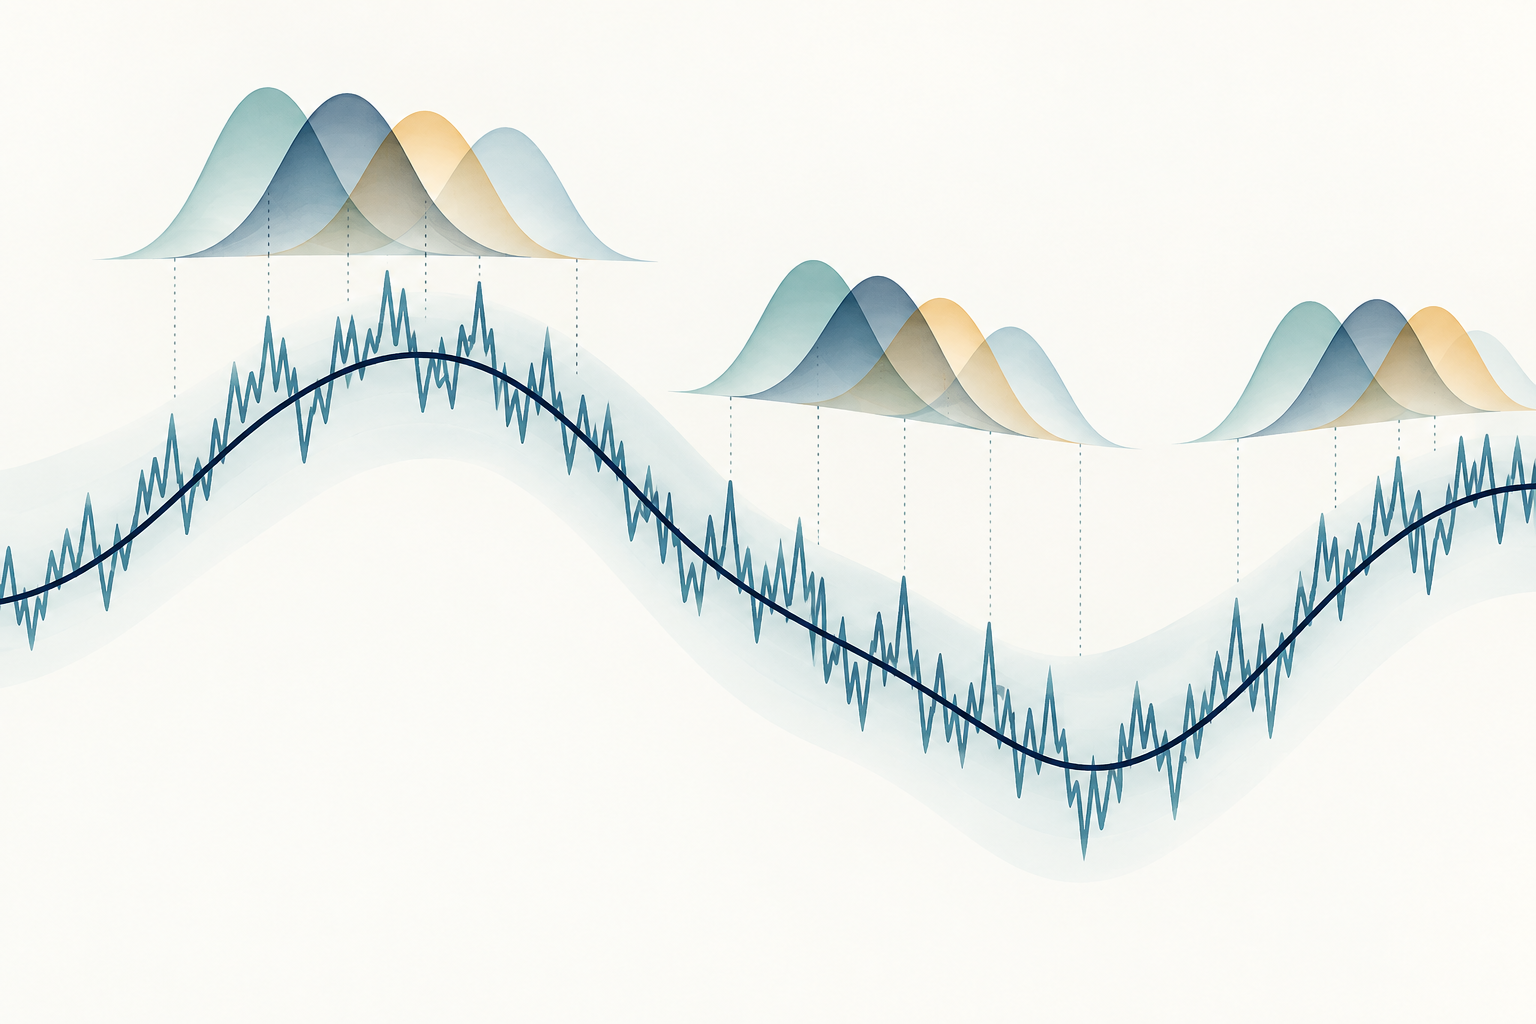
De afbeelding toont een glad latent prijspad, een grillig waargenomen pad en meerdere overlappende vensters met aflopende gewichten. De figuur licht de lokale samenvoeging toe; het is geen prijsregistratie of empirische filteruitkomst.
<!-- learn:illustration --> <!-- Tekstloos concept: een glad latent prijspad naast een grillig waargenomen pad, met overlappende lokale vensters die naburige bewegingen samenvoegen en aan de uiteinden aflopen. Conceptueel, geen marktdata, voorspelling of handelssignaal. -->
Corrigeer de resterende ruisbijdrage
Pre-averaging vermindert de invloed van snelle waarnemingsfouten, maar de gekwadrateerde gefilterde rendementen bevatten nog steeds een ruisbijdrage. Een gangbare vorm van de univariate schatter op een regelmatig raster, met asymptotische normalisatieconstanten, is
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
waar de gewichtsconstanten zijn
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
De eerste term schaalt de som van gekwadrateerde pre-averaged rendementen naar de geïntegreerde variantie. De tweede schat en trekt onder het model de belangrijkste bijdrage van waarnemingsruis af. De term schat niet elke ruisrealisatie afzonderlijk en herstelt geen verkeerd prijsveld, tijdstempelfout of uitschieter. Een formule voor een eindige steekproef kan discrete versies van \(\psi_1\) en \(\psi_2\), eindpuntcorrecties en een specifieke indexconventie gebruiken. Beschrijf die keuzes en pas ze consequent toe.
De correctie kan in een eindige steekproef een kleine of negatieve schatting opleveren. Dat betekent niet dat een activum een negatieve fysieke variantie had, maar dat de gekozen correctie in die steekproef groter was dan de eerste term. Vervang een negatieve schatting niet stilzwijgend door nul. Rapporteer de ruwe berekening en elke afzonderlijke afkapregel, want afkappen verandert de schatter en kan verdere gemiddelden of inferentie beïnvloeden.
Stem de vensterlengte af op ruis en steekproef
\(k_n\) bepaalt hoeveel afvlakking plaatsvindt. Is het venster te kort, dan blijft meer hoogfrequente ruis in de gefilterde rendementen over. Is het te lang, dan worden lokale prijsbewegingen over een langere periode gemiddeld en dragen minder vensters bij, wat andere schattingsfouten kan vergroten. Vensterlengte en gewichtsfunctie werken samen; \(k_n\) zegt op zichzelf weinig zonder de gewichten en het steekproefinterval.
In het klassieke gebalanceerde ontwerp groeit het venster bij een vaste tijdsduur en steeds frequenter wordende \(n\) waarnemingen in de orde van \(\sqrt n\), vaak geschreven als \(k_n\sim\theta\sqrt n\), met een positieve afstemmingsconstante \(\theta\). Onder de aannames van het artikel kan de schatter convergeren met snelheid \(n^{1/4}\), dus met een schattingsfout van orde \(n^{-1/4}\). Dat is langzamer dan de ruisvrije snelheid \(n^{1/2}\) en optimaal in de basale lawaaierige situatie die de auteurs onderzoeken; het is geen garantie voor elk marktgegevensbestand.
\(\theta\), de gewichtsfunctie en een datagestuurde selectiemethode beïnvloeden bias en variantie in eindige steekproeven. Een automatische keuze kan afhangen van ruis- en volatiliteitsschattingen die zelf onzeker zijn. Toon gevoeligheid voor enkele verdedigbare vensterinstellingen, beschrijf de steekproefklok en sessiegrenzen en kies het venster niet pas nadat bekend is welke waarde de gewenste conclusie ondersteunt.
Een kleine hypothetische berekening
Neem zes hypothetische waargenomen rendementen in basispunten:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Gebruik een driehoekig gewicht \(g(u)=\min(u,1-u)\) en een bewust kort venster \(k=3\). De twee binnenste rastergewichten zijn \(g(1/3)=g(2/3)=1/3\). Om de rekenstappen op dit kleine raster precies te tonen, definiëren we discrete normalisatieconstanten:
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Volgens de indexconventie hierboven zijn er \(n-k+2=5\) overlappende vensters. Elk combineert een naburig rendement van \(1\) bp met een rendement van \(0\) bp. Daardoor is \(\bar r_i=(1/3)(1+0)=1/3\) bp en
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Met de bijbehorende discrete normalisatie volgt
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Dit voorbeeld controleert de rekenstappen en eenheden; zes rendementen en zo’n kort venster zijn onvoldoende voor een asymptotische benadering. De waarden zijn gekozen om de berekening helder te maken. Het zijn geen marktdata, simulatie van een ruisproces of bewijs dat de latente geïntegreerde variantie is teruggewonnen. Er wordt geen standaardfout of verwachting berekend.
Begrijp de aannames en wanneer ze niet gelden
De standaardafleiding gaat uit van een continu efficiënt prijspad dat vaak wordt waargenomen met additieve ruis, naast regulariteitsvoorwaarden. Gecentreerde onafhankelijke ruis is een nuttig vertrekpunt, maar afhankelijkheid tussen ruis en prijs, serieel gecorreleerde fouten, tijdvariërende ruis, onregelmatige waarnemingstijden of endogene steekproeftrekking kunnen een aangepaste schatter of theorie voor die situatie vereisen. Aït-Sahalia, Mykland en Zhang onderzoeken de schatting van geïntegreerde volatiliteit bij afhankelijke microstructuurruis. Hun studie laat zien waarom de formule voor onafhankelijke ruis niet universeel is.
Sprongen stellen een afzonderlijke vraag over de doelgrootheid. Kwadratische variatie bevat de kwadraten van sprongen; continue geïntegreerde variantie niet. Een gewone pre-averagingsschatter scheidt sprongen niet automatisch af. Voor sprongrobuuste afkapping of een andere constructie zijn eigen aannames en afstemmingsparameters nodig. Een grote foutieve print kan ook meerdere overlappende vensters beïnvloeden, zodat gegevensvalidatie en behandeling van uitschieters nodig blijven.
Pre-averaging lost evenmin op zichzelf alle problemen met multivariate of asynchrone data op. Christensen, Kinnebrock en Podolskij ontwikkelen pre-averagingcovariantiemethoden en een ruisrobuuste Hayashi–Yoshida-uitbreiding voor niet-synchrone waarnemingen in hun studie. Die constructies behandelen extra kwesties rond de steekproefopzet. Een univariate formule afzonderlijk op elk activum toepassen synchroniseert tijdstempels niet automatisch en garandeert geen geldige covariantiematrix.
Onderscheid pre-averaging van TSRV en realized kernels
Deze schatters behandelen verwante problemen met hoogfrequente variatie, maar ordenen de informatie anders. Two-scale realized volatility, of TSRV, middelt gerealiseerde varianties van verschoven, schaarse steekproefrasters en trekt daarna een geschaalde schatting van het fijne raster af om de belangrijkste ruisbias te corrigeren. Pre-averaging filtert eerst korte overlappende rendementsvensters met gladde gewichten, kwadrateert de gefilterde rendementen en past een bijbehorende correctie toe. Het oorspronkelijke artikel over twee tijdschalen beschrijft die andere constructie.
Een realized kernel begint bij de som van gekwadrateerde rendementen en voegt gewogen rendementautocovarianties op meerdere vertragingen toe. De bandbreedte bepaalt welke maximale vertraging wordt meegenomen. Pre-averaging verandert juist lokale rendementen voordat ze worden gekwadrateerd. Beide gebruiken gewichten en afstemmingsparameters, maar formules, normalisaties en aannames zijn niet onderling uitwisselbaar. De gids over realized kernels behandelt de laggebaseerde constructie en bandbreedte.
Kies op basis van de gegevens en de benodigde grootheid, niet op basis van de naam van de schatter. Vergelijk steekproefontwerp, ruismodel, eindpuntbehandeling, doel bij sprongen en gedrag in eindige steekproeven. Asymptotische robuustheid tegen ruis garandeert niet dat de methode het beste past bij illiquide activa, korte sessies, veranderende ruis of onregelmatige datastromen. De TSRV-gids legt de schaal- en correctiekeuzes van die methode uit.
Rapporteer de intervalmeting zonder er een handelsconclusie van te maken
Vermeld voor reproduceerbaarheid het activum en prijsveld, het tijdsinterval, de samplingfrequentie, tijdstempel- en sessieregels, rendementeenheden, gewichtsfunctie, vensterlengte, normalisatie, eindpuntconventie en ruisaannames. Als de schatter voor inferentie wordt gebruikt, rapporteer dan ook de variantieschatter of betrouwbaarheidsmethode en de bijbehorende aannames. Een gevoeligheidstabel voor redelijke vensterinstellingen laat zien of de conclusie van één afstemming afhangt.
Geïntegreerde variantie meet een afgerond waarnemingsinterval. De vierkantswortel drukt deze uit als volatiliteitsschaal voor datzelfde interval, maar maakt er geen voorspelling van. Annualiseren vereist een expliciete tijdsconventie en levert evenmin een verwachting op. Een later tijdvak voorspellen vraagt om een apart voorspelmodel en out-of-sample-evaluatie. De gids voor berekening van gerealiseerde volatiliteit behandelt de benchmark met gekwadrateerde rendementen; de gids over kwadratische variatie maakt onderscheid tussen padvariatie en het doel van continue geïntegreerde variantie.
De schatting bewijst niet waarom de prijs bewoog, identificeert geen winstgevende strategie en garandeert geen meetbaar uitvoeringsrisico. Transactiekosten, liquiditeit, sprongen, volatiliteitsdynamiek en schattingsonzekerheid blijven afzonderlijke vragen. Pre-averaging is een statistisch meetinstrument; de bruikbaarheid hangt af van de aansluiting tussen de expliciete aannames en de waargenomen gegevens.
Veelgestelde vragen
Q1Is pre-averaging hetzelfde als een voortschrijdend gemiddelde van prijzen nemen?
Nee. De schatter vormt gewogen sommen van naburige rendementen en kwadrateert en corrigeert die daarna. Prijsniveaus middelen en vervolgens verschillen nemen is een andere transformatie met andere gewichten en randeffecten.
Q2Verwijdert pre-averaging alle microstructuurruis?
Nee. Onder bepaalde aannames over ruis en sampling vermindert het de belangrijkste invloed. Afhankelijke of veranderende ruis, sprongen, uitschieters en tijdstempelproblemen kunnen de uitkomst nog steeds beïnvloeden.
Q3Waarom kunnen pre-averagingschattingen verschillen?
De gewichtsfunctie, vensterlengte, eindige-steekproefnormalisatie, prijsveld, eindpuntregels of gegevensopschoning kunnen verschillen. Rapporteer die keuzes en onderzoek de gevoeligheid.
Q4Is een pre-averagingschatting een volatiliteitsverwachting?
Niet op zichzelf. Zij meet de variatie in het interval waarvoor de berekening is gemaakt. Een latere periode voorspellen vereist een apart model en out-of-sample-evaluatie.
Bronnen en verder lezen
Probleem melden
We bereiden een e-mail met de link naar dit artikel voor. Mark ontvangt je melding pas nadat je die verstuurt
Snelle check
De gids gelezen? Test jezelf met 3 vragen
Vraag 01
Wat is het hoofddoel van pre-averaged rendementen?
Kies een antwoord om de uitleg te zien
Optiewoordenlijst
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Lees de uitgebreide gidsQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Lees de uitgebreide gids