

प्रतिगमन में कई संरचनात्मक बदलावों के लिए Bai–Perron परीक्षण
जानें कि Bai–Perron विधियाँ प्रतिगमन बदलावों की अज्ञात संख्या और तारीखें कैसे खोजती हैं, trimming और critical values कैसे काम करते हैं, और अनुमान क्या सिद्ध नहीं करते।
इस गाइड मेंकई बदलावों वाला प्रतिगमन परीक्षण क्या पूछता है
संक्षिप्त सारांश
Bai–Perron विधियाँ तय की गई बदलाव-संख्या के लिए प्रतिगमन की बदलाव-तारीखों का संयुक्त अनुमान लगाती हैं। इसके बाद परीक्षण या model-selection मानदंड देखते हैं कि डेटा कितने बदलावों का समर्थन करता है। तारीखें और संख्या प्रतिगमन, न्यूनतम segment लंबाई, error assumptions और खोज-प्रक्रिया पर निर्भर करती हैं; वे किसी कारण या trading लाभ की पहचान नहीं करतीं।
कई बदलावों वाला प्रतिगमन परीक्षण क्या पूछता है
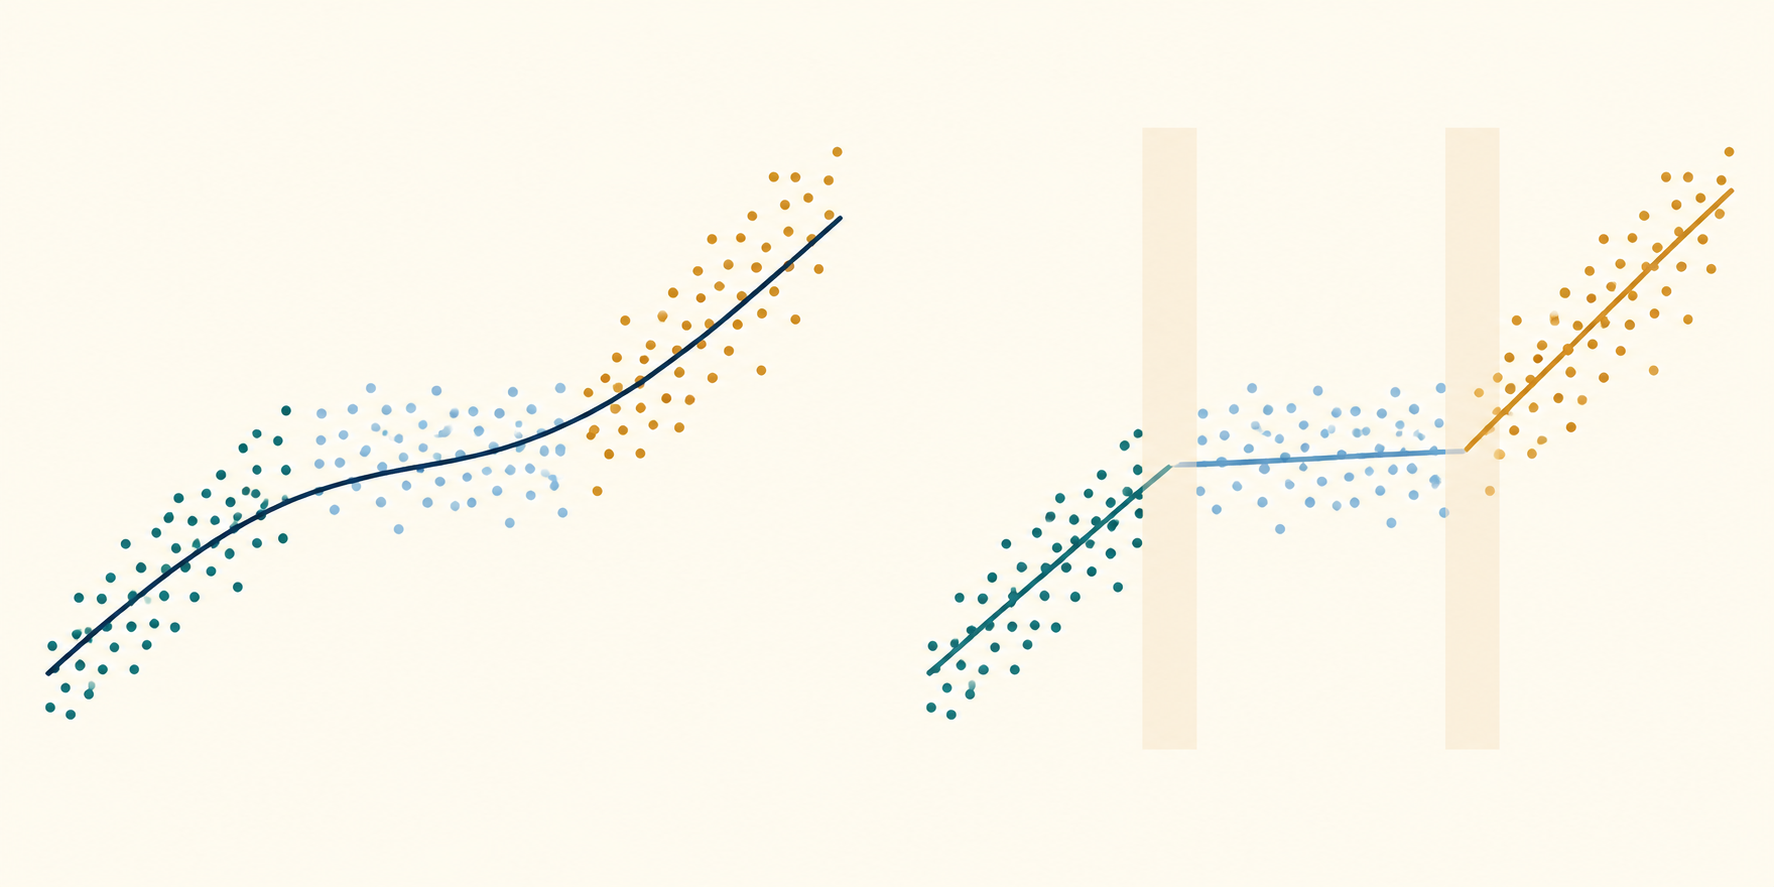
प्रतिगमन में संरचनात्मक बदलाव का अर्थ है कि नमूने के किसी अज्ञात बिंदु पर एक या अधिक coefficients बदल गए हो सकते हैं। पूरे नमूने के लिए एक अनुमान इसे छिपा सकता है: यदि return और risk का संबंध एक अवधि में सकारात्मक हो और बाद में कमजोर या उलट जाए, तो औसत coefficient शायद दोनों में से किसी अवधि का सही वर्णन न करे। Bai–Perron विधियाँ इस प्रश्न को observations के संभावित विभाजनों की स्पष्ट खोज के रूप में रखती हैं।
Chow test से मुख्य अंतर यह है कि तारीख पहले से तय थी या नहीं। Chow test दी गई तारीख के दोनों ओर के subsamples की तुलना करता है। कई तारीखें आज़माकर सबसे बड़ा सामान्य Chow statistic बताने से एक पूर्वनिर्धारित test का प्रचलित reference distribution बरकरार नहीं रहता। Bai–Perron tests संभावित तारीखों की खोज को ध्यान में रखते हैं और एक से अधिक बदलाव जाँच सकते हैं। पहले से तय तारीख वाले मामले के लिए Chow test मार्गदर्शिका देखें।
इसे regression CUSUM से भी अलग समझें। CUSUM समय-क्रम में recursive residuals के path की जाँच करता है कि स्थिरता के विरुद्ध प्रमाण है या नहीं, लेकिन अपने आप कई चुनी हुई बदलाव-तारीखें नहीं देता। Bai–Perron स्पष्ट piecewise-regression model के अंतर्गत partition का अनुमान लगाता है। कोई भी विधि यह नहीं बताती कि संबंध क्यों बदला। Residual-path diagnostic के लिए regression CUSUM मार्गदर्शिका देखें।
अज्ञात तारीखों और बदलावों की अज्ञात संख्या वाला प्रतिगमन लिखें
मान लें कि \(T\) observations और पूर्णांक तारीखों \(T_1<\cdots<T_m\) पर \(m\) बदलाव हैं। \(T_0=0\), \(T_{m+1}=T\) रखें और segment \(j\) को observations \(T_{j-1}+1,\ldots,T_j\) के रूप में परिभाषित करें। शुद्ध संरचनात्मक बदलाव वाले model में,
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
यहाँ \(y_t\) परिणाम है, \(x_t\) शामिल regressors का vector, \(\beta_j\) segment \(j\) का coefficient vector और \(u_t\) error है। अज्ञात केवल coefficient values नहीं हैं: design में पहले से तय न किए गए हों तो बदलाव की तारीखों और संख्या \(m\) का भी अनुमान या चयन करना होगा। Model यह भी मानता है कि observations का क्रम अर्थपूर्ण है और चुनी गई specification के अनुसार हर segment में coefficient vector स्थिर है।
वित्तीय उदाहरण में \(y_t\) portfolio return हो सकता है और \(x_t\) में market return, interest-rate change या volatility measure शामिल हो सकता है। बदलाव मिलने का अर्थ है कि चुनी गई प्रक्रिया के अनुसार नमूने के भीतर segment-wise linear conditional mean बेहतर fit हुआ। इससे यह सिद्ध नहीं होता कि किसी नामित घटना ने coefficient बदला, explanatory variable exogenous है, या नमूने के बाहर भी संबंध स्थिर रहेगा।
Observation date और calendar date में अंतर रखें। यदि observations दैनिक trading sessions हैं, तो session 120 और 121 के बीच का बदलाव ज़रूरी नहीं कि एक कैलेंडर दिन की market movement हो; छुट्टियाँ, missing quotes और अनियमित sampling इस mapping को बदलते हैं। बदलाव को किसी घटना का timestamp मानने से पहले sample ordering और तारीख बताने की परंपरा स्पष्ट करें।
शुद्ध और आंशिक संरचनात्मक बदलाव में सोच-समझकर चुनाव करें
शुद्ध संरचनात्मक बदलाव वाले model में \(\beta_j\) का हर coefficient segment के अनुसार बदल सकता है। इससे intercept और सभी slopes बदल सकते हैं, लेकिन segment-specific parameters अधिक होते हैं। Segment छोटे हों या regressors अधिक हों तो बदलावों का सटीक अनुमान कठिन हो सकता है। शुद्ध बदलाव तभी उचित है जब प्रश्न में हर modeled relationship को फिर से तय होने की अनुमति हो।
आंशिक संरचनात्मक बदलाव वाले model में कुछ coefficients सभी segments के लिए समान रहते हैं और कुछ बदल सकते हैं। उदाहरण के लिए, \(\beta_j=(\delta',\gamma_j')'\) लिखें, जहाँ \(\delta\) सभी segments में साझा है और \(\gamma_j\) segment-specific है। यह कोई ठोस modeling restriction दर्शा सकता है: intercept और policy exposure का slope बदलने दें, लेकिन control variable का प्रभाव समान रखें। यह restriction fit objective और test के reference distribution—दोनों को बदलती है; इसे स्पष्ट लिखें, हानिरहित सरलीकरण न मानें।
गणना भी अलग है। शुद्ध बदलाव में किसी partition का residual sum of squares (RSS) स्वतंत्र segment RSS का योग होता है, इसलिए तय बदलाव-संख्या के लिए dynamic programming partition को optimize कर सकता है। आंशिक model में common coefficients सभी segments को जोड़ते हैं। Bai और Perron की iterative प्रक्रिया में पहले common coefficients को स्थिर रखकर बदलाव-तारीखें और बदलने वाले coefficients का अनुमान लगाया जाता है; फिर दिए गए partition पर common coefficients अपडेट होते हैं। केवल additive segment-RSS recurrence पूरा प्रतिबंधित model jointly हल नहीं करती। Specification को वैज्ञानिक या forecasting प्रश्न के आधार पर चुनें, उस विकल्प के आधार पर नहीं जो अधिक बदलाव दिखाता है।
संभावित तारीखें देखने से पहले न्यूनतम segment लंबाई तय करें
खोज के लिए हर segment में observations की न्यूनतम संख्या तय करनी होती है। यह trimming rule बेहद छोटे intervals को fit करने से रोकता है, जिनसे coefficients अस्थिर हो सकते हैं; लेकिन sample के किनारे या दूसरी break के पास होने वाले वास्तविक बदलाव भी इससे बाहर हो सकते हैं। यह design का हिस्सा है, कोई सार्वभौमिक नियम नहीं।
एक स्पष्ट रूप से काल्पनिक उदाहरण लें: \(T=240\) observations और चुना हुआ trimming fraction 15%। इससे हर segment की न्यूनतम लंबाई \(h=0.15\times240=36\) observations होती है। यदि break date पहले segment की अंतिम observation को बताती है, तो एक बदलाव के लिए admissible तारीखें \(36\le T_1\le204\) हैं। दोनों ओर कम से कम 36 observations रहती हैं।
दो बदलावों के लिए admissible तारीख-जोड़ी को यह शर्त पूरी करनी होगी:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
अर्थात \(T_1\le168\); \(T_2\) पहली break के कम से कम 36 observations बाद हो और दूसरी break के बाद भी 36 observations छोड़े। \((72,156)\) admissible है: इसके तीन segments में 72, 84 और 84 observations हैं। \((80,100)\) admissible नहीं है, क्योंकि बीच वाले segment में केवल 20 observations हैं। इस \(h\) के साथ 240 observations में अधिकतम पाँच बदलाव आ सकते हैं: छह segments के लिए कम से कम \(6\times36=216\) observations चाहिए, जबकि सात के लिए 252।
यहाँ 15% स्पष्ट रूप से एक काल्पनिक design choice है, default recommendation नहीं। बड़ा fraction छोटे समय के regimes और sample boundaries के पास की तारीखें बाहर कर सकता है; छोटा fraction छोटे segments की अनुमति देता है, पर slopes और long-run covariance quantities विश्वसनीय रूप से estimate करने के लिए पर्याप्त जानकारी न छोड़े। Sampling frequency, regressors की संख्या, plausible regime duration और inference method देखकर नियम चुनें। इसे report करें और जहाँ अर्थपूर्ण हो, दिखाएँ कि पास के trimming values पर निष्कर्ष बदलते हैं या नहीं। Lags या missing observations होने पर implementations effective sample size और endpoints अलग तरह से परिभाषित कर सकती हैं; इस्तेमाल किया गया convention दर्ज करें।
तय बदलाव-संख्या के लिए global segmentation पाने में dynamic programming का उपयोग करें
शुद्ध बदलाव वाले model में \(m\) तय हो तो तारीख-खोज को कुल segment RSS कम करने के रूप में लिखा जा सकता है:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
तारीखों के क्रम और न्यूनतम segment लंबाई की शर्तों के अधीन। \(\operatorname{SSR}(a,b)\) observations \(a,\ldots,b\) पर एक segment fit करने से प्राप्त न्यूनतम least-squares residual sum of squares है। Naive search हर date combination जाँचती है, जिनकी संख्या \(T\) और \(m\) के साथ तेजी से बढ़ती है।
Dynamic programming हल किए गए subproblems को फिर उपयोग करती है। यदि \(D(r,j)\), observations 1 से \(j\) को \(r\) वैध segments में बाँटने की सबसे छोटी RSS है, तो recurrence का एक रूप है:
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
जहाँ split \(i\) इस तरह सीमित है कि पहले \(r-1\) segments और अंतिम segment सभी न्यूनतम लंबाई पूरी करें। हर चरण में सबसे छोटा मान देने वाला split सहेजने से तारीखें वापस निकाली जा सकती हैं। अनुमत हर segment count के लिए, specified model और constraints के अधीन global minimum-RSS partition मिलता है; बदलाव एक-एक कर greedy ढंग से नहीं जोड़े जाते। Bai और Perron (2003) इस computation और शुद्ध तथा आंशिक बदलाव models की चर्चा करते हैं।
यहाँ “global” का अर्थ चुनी हुई संख्या, regressors, deterministic terms, trimming और objective के सापेक्ष global है। इसका अर्थ यह नहीं कि statistical model सत्य है, चुनी हुई संख्या सही है या हर संभावित specification में यही partition सर्वोत्तम है। प्रक्रिया कई संख्याओं की कुशल तुलना कर सकती है, लेकिन \(m\) चुनना अलग inference या model-selection चरण है।
खोज के लिए समायोजित inference या criteria से बदलावों की संख्या चुनें
Candidate counts के लिए सर्वोत्तम partitions निकालने के बाद \(m\) चुनने के कई तरीके हैं। Sequential \(\sup F(\ell+1\mid\ell)\) test \(\ell\) बदलावों वाले model की तुलना एक अतिरिक्त बदलाव वाले model से करता है और admissible तारीखों पर supremum statistic लेता है। UDmax या WDmax जैसे double-maximum tests “कोई बदलाव नहीं” की null hypothesis की तुलना एक तय maximum तक अज्ञात संख्या वाले alternative से करते हैं। BIC-जैसे information criteria fit में सुधार और complexity penalty की तुलना करते हैं। ये तरीके संबंधित हैं, पर एक ही प्रश्न का उत्तर नहीं देते।
अज्ञात break dates पर maximum लेने के बाद सामान्य F critical value आमतौर पर उपयुक्त नहीं होती। बदलाव न होने की null के तहत candidate dates alternative जैसी तरह से identified नहीं होतीं, जिससे nonstandard asymptotic distributions बनते हैं। Critical values trimming, pure या partial change, regressors और error covariance assumptions जैसी बातों पर निर्भर करती हैं। Bai और Perron (1998) multiple-change tests निकालते हैं; बाद का critical-value अध्ययन अलग-अलग trimming और model settings के मान देता है। Andrews (1993) एक अज्ञात change point वाले instability tests के महत्वपूर्ण परिणाम देते हैं, पर उनकी critical values multiple-break procedure की जगह नहीं लेतीं।
Sequential tests समझने योग्य हैं, लेकिन हर चरण की power और पहले से तय maximum break count परिणाम को प्रभावित कर सकते हैं। Information criteria की penalties अलग होने से वे अलग संख्या चुन सकते हैं; candidate models सभी केवल approximation भी हो सकते हैं। अधिक बदलाव अपने आप अधिक यथार्थवादी विवरण नहीं देते: fit में मामूली लाभ के बदले segment coefficients अस्थिर हो सकते हैं। Method, maximum count, trimming, test sequence या criterion और critical-value assumptions बताएँ। चयन महत्वपूर्ण हो तो एक संख्या को निश्चित बताने के बजाय sensitivity दिखाएँ।
अनुमानित तारीखों को अनिश्चित conditional estimates मानें
Criterion को न्यूनतम करने वाली तारीखें निर्दिष्ट model के तहत point estimates हैं। इन्हें ऐसे न बताएँ मानो डेटा ने आर्थिक संबंध बदलने का सटीक क्षण खोज लिया हो। Sampling variation, coefficient का छोटा बदलाव, पास-पास breaks, noisy outcomes, कम variation वाले regressors और लंबी minimum segment length minimum के आसपास objective को सपाट कर सकते हैं। कई आस-पास के partitions लगभग समान fit दे सकते हैं।
Bai और Perron निर्दिष्ट शर्तों के तहत break dates के confidence intervals विकसित करते हैं। वे modeled dates की sampling uncertainty बताते हैं; regression specification सही है या नहीं, कौन-से variables शामिल हों, breaks की संख्या और trimming rule—इन सभी अनिश्चितताओं को नहीं समेटते। यदि breaks की संख्या भी अनिश्चित है, तो चुनी हुई एक संख्या पर conditional संकीर्ण date interval कुल uncertainty को कम दिखा सकता है।
रिपोर्ट में date convention, अनुमानित observation index, संबंधित calendar date और हर break का interval अलग बताएँ। Intervals चौड़े हों या overlap करें तो location को कमजोर रूप से निर्धारित बताएं। परिणाम देखने के बाद chart से तारीख चुनकर उसे स्वतंत्र रूप से अनुमानित घटना न कहें। ज्ञात घटना से estimated breaks की तुलना करते समय ध्यान रखें कि घटना और समय-खिड़की डेटा देखने के बाद चुनी गई हो सकती है।
Serial dependence और बदलते variance के अनुरूप inference रखें
RSS partition एक fit criterion है; tests और confidence intervals की वैधता regressors और errors के बारे में मान्यताओं पर निर्भर करती है। Financial regressions में serial correlation, conditional heteroskedasticity, outliers, बदलता volatility, overlapping returns या asynchronous observations हो सकते हैं। यदि covariance estimator और critical values independent, equal-variance errors मानें, जबकि residuals dependent या heteroskedastic हों, तो estimated break dates plausible दिखने पर भी reported significance भ्रामक हो सकती है।
Bai–Perron काम में heteroskedasticity और serial dependence के कुछ रूपों सहित अधिक व्यापक conditions के तहत procedures शामिल हैं। फिर भी वास्तविक setup के अनुसार covariance correction और reference values चुननी चाहिए। Robust या HAC covariance estimate omitted dynamics, endogenous regressor, गलत conditional mean, या असंगत intervals मिलाने वाले observation calendar को ठीक नहीं करता। Robust standard error इस्तेमाल करने मात्र से RSS objective डेटा का बेहतर model भी नहीं बनता।
Candidate segments के भीतर और उनके बीच residual dependence व variance patterns जाँचें। बताएं कि error assumptions segment-specific variances, serial correlation या regressor distribution में बदलाव स्वीकार करती हैं या नहीं, और चुने गए test की theory इन स्थितियों को cover करती है या नहीं। बहुत छोटे segments में robust covariance estimation विशेष रूप से fragile होती है, इसलिए trimming और model dimension की योजना साथ बनाएं। Regression estimates और covariance assumptions की पृष्ठभूमि के लिए OLS regression guide देखें।
Break analysis रिपोर्ट करें, उसे causal या trading claim न बनाएं
पुनरुत्पादित की जा सकने वाली report में outcome, सभी regressors, transformations, sample period और frequency, intercept व coefficient restrictions, pure या partial change specification, candidate maximum \(m\), trimming fraction व minimum length, date convention, optimization method तथा \(m\) चुनने वाला test या criterion दर्ज करें। चुनी गई break count, segment-wise coefficients, dates और uncertainty intervals, test statistics, covariance treatment तथा critical-value source शामिल करें। यह भी समझाएं कि search से कौन-से endpoints या observations बाहर रखे गए।
सांख्यिकीय रूप से detected break निर्दिष्ट regression और उसकी assumptions के अंतर्गत parameter instability का प्रमाण है। यह नहीं बताता कि किस घटना ने बदलाव किया, किसी खास news release या policy को कारण सिद्ध नहीं करता, और न ही दिखाता है कि पहले या बाद के coefficients बने रहेंगे। Break omitted variable, बदली हुई data definition, volatility episode, measurement problem या वास्तविक आर्थिक बदलाव दिखा सकता है; regression test अकेले इन व्याख्याओं में अंतर नहीं करता।
Quant trading में full-sample search हर estimated break के पहले और बाद के observations इस्तेमाल करती है। चुनी हुई तारीख real time में पता थी ऐसा मानकर trade करने से look-ahead bias आता है। किसी regime rule का chronological मूल्यांकन करें, हर तारीख पर उपलब्ध जानकारी से ही फिर estimate करें, और spread, fees, market impact, financing, borrow, turnover तथा latency शामिल करें। Fixed-parameter और no-trade baseline से तुलना करें तथा सचमुच बाद के data को validation के लिए बचाकर रखें। Break model review या risk investigation की वजह हो सकता है; predictive power या investable edge का प्रमाण नहीं।
Bai और Perron (1998) अपने मूल लेख में linear models में कई structural changes के tests और estimation प्रस्तुत करते हैं। उनका 2003 computation लेख dynamic programming और partial-change procedures समझाता है; critical-values लेख बताता है कि design के साथ मान कैसे बदलते हैं। Andrews का unknown-change-point लेख एक break के लिए संबंधित आधार देता है। पास के diagnostics के रूप में पहले से तय तारीख वाला Chow test और regression CUSUM test देखें।
आम सवाल
Q1क्या Bai–Perron breaks की सही संख्या बताता है?
नहीं। यह partitions estimate करता है और candidate counts में से चुनने के लिए tests या criteria देता है। परिणाम regression specification, trimming, error assumptions, maximum count और selection rule पर निर्भर करता है; यह सिद्ध नहीं करता कि data-generating process में ठीक उतने breaks थे।
Q2क्या break date वही तारीख है जब किसी आर्थिक घटना ने बदलाव किया?
नहीं। यह fitted model के तहत parameter instability की estimated location है और इसमें sampling uncertainty होती है। कारण तय करने के लिए अतिरिक्त evidence और प्रतिस्पर्धी व्याख्याओं को हटाने वाला design चाहिए।
Q3क्या मैं estimated break dates के आधार पर सीधे trade कर सकता हूँ?
केवल retrospective full-sample estimate के आधार पर नहीं। खोज candidate break के बाद के observations भी उपयोग करती है। Live rule के लिए chronological evaluation, उस समय उपलब्ध जानकारी, लागतें और बाद के data पर validation चाहिए; detected break profitable signal सिद्ध नहीं करती।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
240 observations के उदाहरण में 15% minimum-segment rule का क्या अर्थ है?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
वह स्थिति जिसमें विकल्प का स्ट्राइक मूल्य अंतर्निहित परिसंपत्ति के बाजार मूल्य के बहुत करीब हो। उसमें अभी महत्वपूर्ण आंतरिक मूल्य न हो, फिर भी बचे हुए समय और अनिश्चितता के कारण प्रीमियम हो सकता है।
विस्तृत गाइड पढ़ेंकॉल विकल्पऐसा अनुबंध जो खरीदार को शर्तों के अनुसार स्ट्राइक मूल्य पर अंतर्निहित परिसंपत्ति खरीदने का अधिकार देता है। यदि अधिकार का प्रयोग और असाइनमेंट हो, तो विक्रेता पर संबंधित दायित्व आता है।
विस्तृत गाइड पढ़ें