

Volatilité réalisée par pré-moyennage : un estimateur face au bruit de microstructure
Découvrez comment le pré-moyennage lisse de courtes fenêtres de rendements haute fréquence, corrige l’effet principal du bruit, règle la longueur de fenêtre et se distingue de TSRV et des noyaux réalisés.
Dans ce guidePourquoi des rendements très fréquents peuvent fausser les variations de prix
Bref résumé
Le pré-moyennage estime les variations de prix lorsque des prix observés à très haute fréquence contiennent du bruit de microstructure. Au lieu de mettre au carré chaque rendement brut, il forme des sommes pondérées et chevauchantes de rendements voisins, les met au carré, puis retranche un terme correspondant à l’effet principal du bruit. Le résultat dépend de la forme des poids, de la longueur de fenêtre, du plan d’échantillonnage et des hypothèses sur le bruit. Il mesure les variations d’un intervalle observé ; ce n’est ni une prévision de volatilité ni un signal de trading.
Pourquoi des rendements très fréquents peuvent fausser les variations de prix
Si le prix observé était identique au prix efficient, la somme des rendements intrajournaliers au carré serait une manière naturelle d’estimer les variations sur la séance. Mais les prix de transaction et les cotations peuvent refléter l’alternance entre bid et ask, l’arrondi à la taille du tick, la latence, la discrétisation des prix ou les conventions d’enregistrement. Lorsque l’intervalle d’échantillonnage est extrêmement court, ces effets peuvent représenter une part importante de chaque rendement au carré. Ajouter des observations peut alors accroître la composante de bruit au lieu de simplement révéler davantage de mouvements du prix latent.
Le pré-moyennage répond à ce problème en combinant des rendements dans une courte fenêtre locale avant de les mettre au carré. Une fonction de poids régulière part de zéro, attribue du poids aux rendements voisins et revient à zéro au bord de la fenêtre. La somme pondérée agit comme un filtre local : des erreurs d’observation rapides et indépendantes peuvent en partie s’annuler, tandis qu’un mouvement plus large du prix efficient peut subsister. Les fenêtres chevauchantes permettent d’utiliser l’information sur tout l’intervalle.
Le lissage seul ne rend pas un estimateur sans biais. Les rendements filtrés au carré contiennent encore des variations dues au bruit ; un terme de correction est donc nécessaire. Jacod, Li, Mykland, Podolskij et Vetter dérivent une méthode de pré-moyennage pour estimer la volatilité intégrée sous des hypothèses explicites et montrent que certaines versions atteignent le taux de convergence \(n^{-1/4}\). Leur article original fonde la méthode ; ce guide en explique le mécanisme, les choix et les limites.
Distinguer le prix latent, le prix observé et la cible
Notons \(X_{t_i}\) le logarithme du prix efficient latent à l’instant d’observation \(t_i\), et \(Y_{t_i}\) le logarithme du prix enregistré :
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
où \(\epsilon_{t_i}\) représente le bruit d’observation. Un modèle de base courant traite \(X_t\) comme une semimartingale continue à taux de variance local \(\sigma_t^2\). La cible sur un intervalle fixe \([0,T]\) est la variance intégrée :
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Le rendement observé se décompose en \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Même si les erreurs de prix sont indépendantes d’une observation à l’autre, deux rendements adjacents partagent l’erreur d’une extrémité avec des signes opposés. Une dépendance sérielle apparaît donc dans les rendements, et la variance réalisée sur toutes les observations dépend du nombre de différences bruitées.
L’explication théorique simple suppose souvent un bruit centré, indépendant dans le temps et du processus de prix efficient, avec des moments finis suffisants. Ces hypothèses facilitent la compréhension de la correction, mais ne sont pas garanties pour les transactions, les cotations ou les prix médians. Le bruit peut varier selon la liquidité et l’heure, être lié au prix efficient ou être sériellement dépendant. La cible doit aussi être précisée : en présence de sauts, la variation quadratique inclut leurs carrés, contrairement à la variance intégrée continue.
Il s’agit d’une mesure ex post pour une série de prix et un intervalle définis. Elle ne reconstitue pas chaque prix latent, ne désigne pas le tick erroné et ne renseigne pas sur la volatilité future. Avant de comparer les résultats, précisez si les données portent sur les prix de transaction, les milieux de cotation ou une autre construction.
Construire des rendements pré-moyennés chevauchants
Pour \(n\) rendements observés \(r_i=Y_{t_i}-Y_{t_{i-1}}\), on choisit une longueur de fenêtre entière \(k_n\) et une fonction de poids \(g\) sur \([0,1]\). Un rendement pré-moyenné courant s’écrit
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
La fonction est en général continue, nulle aux deux extrémités et suffisamment régulière pour les résultats asymptotiques. Un exemple triangulaire est \(g(u)=\min(u,1-u)\). Ses valeurs sont nulles au bord de la fenêtre, de sorte que les rendements limites ne reçoivent pas brusquement un poids maximal. Cette forme définit un poids local ; ce n’est ni une prévision ni une tendance estimée.
Chaque \(\bar r_i\) regroupe des rendements adjacents avant leur mise au carré. Les fenêtres se chevauchant, les rendements pré-moyennés sont corrélés même si les rendements bruts ne le sont pas. Cette dépendance fait partie du comportement d’échantillonnage de l’estimateur : les nombreuses sommes de fenêtre ne doivent pas être considérées comme des observations indépendantes. La plage d’indices et la convention aux extrémités doivent correspondre à la normalisation des poids.
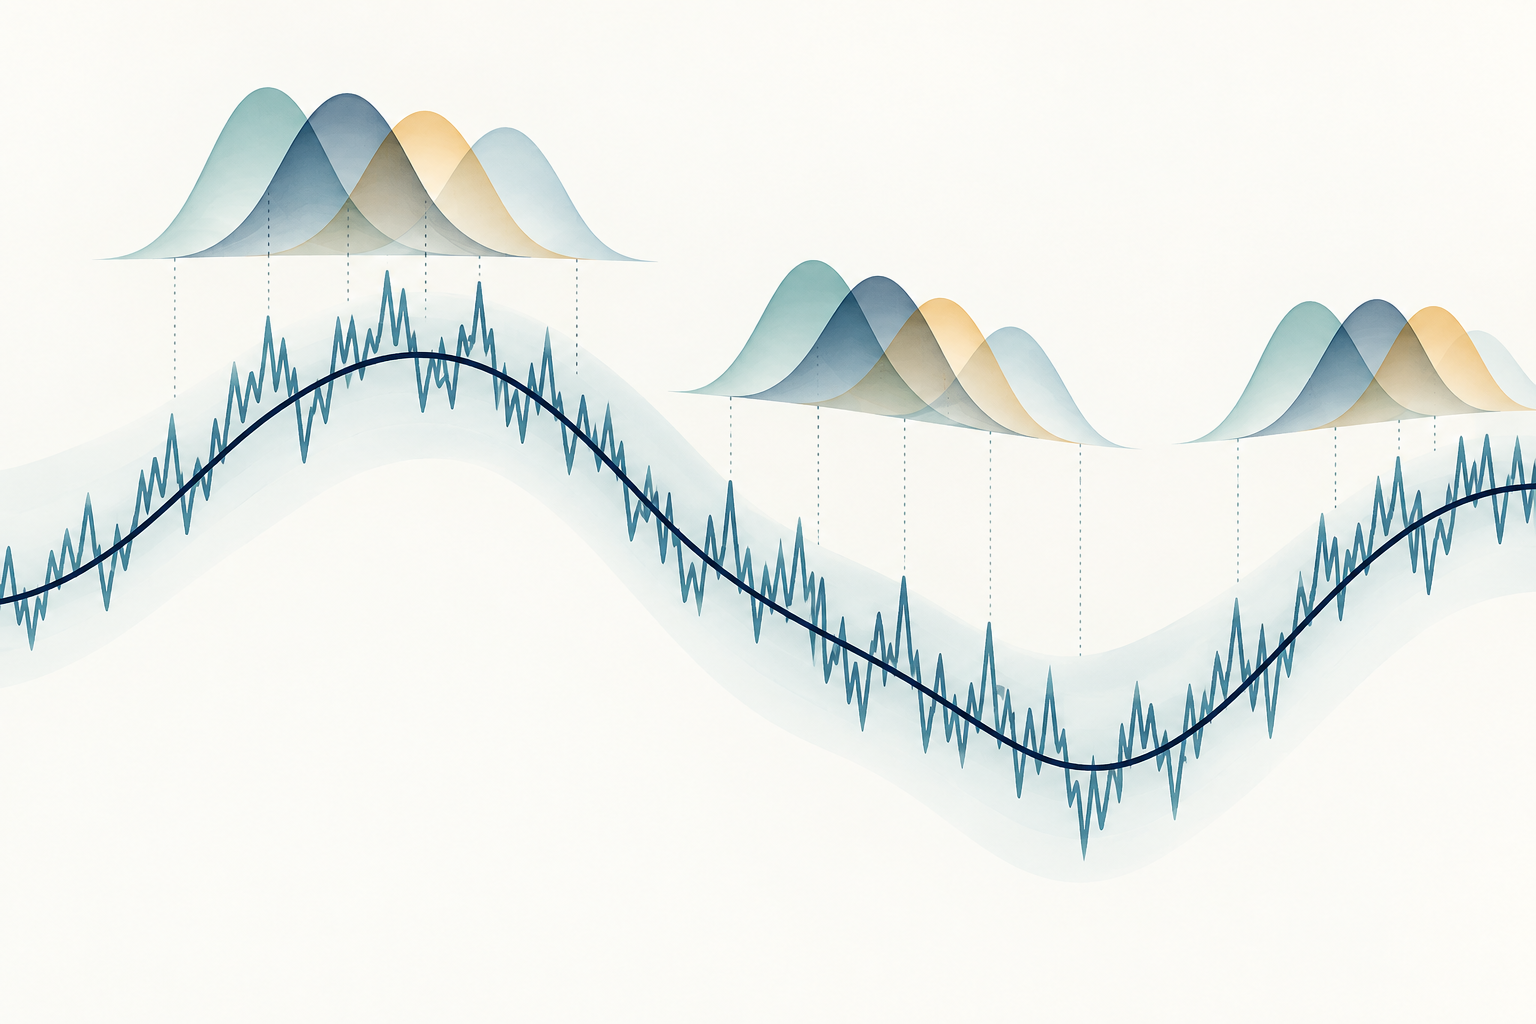
La figure montre une trajectoire latente lisse, une trajectoire observée irrégulière et plusieurs fenêtres chevauchantes dont les poids s’atténuent. Elle illustre le regroupement local ; ce n’est ni une série de prix ni le résultat empirique d’un filtre.
<!-- learn:illustration --> <!-- Concept sans texte : une trajectoire de prix latente lisse à côté d’une trajectoire observée irrégulière, avec des fenêtres locales chevauchantes et atténuées qui regroupent les mouvements voisins. Illustration conceptuelle, ni données de marché, ni prévision, ni signal de trading. -->
Corriger la contribution de bruit résiduelle
Le pré-moyennage réduit l’influence des erreurs d’observation rapides, mais les rendements filtrés au carré contiennent encore une contribution du bruit. Une forme courante de l’estimateur univarié sur une grille régulière, avec des constantes de normalisation asymptotiques, est
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
où les constantes des poids sont
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
Le premier terme remet à l’échelle la somme des rendements pré-moyennés au carré pour viser la variance intégrée. Le second estime puis retranche, sous le modèle, la contribution principale du bruit d’observation. Il n’estime pas chaque réalisation du bruit et ne corrige ni un champ de prix erroné, ni un horodatage fautif, ni une valeur aberrante. Une mise en œuvre en échantillon fini peut utiliser des versions discrètes de \(\psi_1\) et \(\psi_2\), des ajustements d’extrémité et une convention d’indexation précise. Ces détails doivent être indiqués et appliqués de façon cohérente.
La correction peut conduire à une estimation faible ou négative en échantillon fini. Cela ne signifie pas que l’actif avait une variance physique négative ; cela indique que la correction choisie a dépassé le premier terme dans cet échantillon. Ne ramenez pas silencieusement une valeur négative à zéro. Présentez le calcul brut et toute règle de troncature distincte, car cette troncature modifie l’estimateur et peut affecter les moyennes ou l’inférence en aval.
Choisir la longueur de fenêtre selon le bruit et l’échantillon
\(k_n\) règle le degré de lissage. Une fenêtre trop courte laisse davantage de bruit haute fréquence dans les rendements filtrés. Une fenêtre trop longue moyenne les mouvements locaux sur une période plus large et réduit le nombre de fenêtres utilisées, ce qui peut accroître d’autres erreurs d’estimation. La longueur de fenêtre et la fonction de poids agissent ensemble ; la valeur de \(k_n\) n’a pas de sens isolément de la forme des poids et de l’intervalle d’échantillonnage.
Dans le schéma équilibré classique, pour une durée fixe et un nombre \(n\) d’observations de plus en plus fréquent, la fenêtre croît à l’ordre de \(\sqrt n\), souvent noté \(k_n\sim\theta\sqrt n\), avec \(\theta>0\). Sous les hypothèses de l’article, l’estimateur peut converger au taux \(n^{1/4}\), soit une erreur d’ordre \(n^{-1/4}\). Ce taux est plus lent que le taux sans bruit \(n^{1/2}\) et optimal dans le cadre bruité de base étudié par les auteurs ; ce n’est pas une garantie pour tous les jeux de données de marché.
\(\theta\), la fonction de poids et toute procédure de sélection fondée sur les données influencent le biais et la variance en échantillon fini. Un choix automatique peut dépendre d’estimations du bruit et de la volatilité qui sont elles-mêmes incertaines. Présentez la sensibilité pour plusieurs fenêtres défendables, expliquez l’horloge d’échantillonnage et les limites de séance, et ne choisissez pas la fenêtre après avoir vu quelle valeur appuie la conclusion souhaitée.
Petit calcul hypothétique
Considérons six rendements observés hypothétiques, exprimés en points de base :
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Utilisons un poids triangulaire \(g(u)=\min(u,1-u)\) et une fenêtre volontairement courte \(k=3\). Les deux poids intérieurs de la grille valent \(g(1/3)=g(2/3)=1/3\). Pour détailler exactement l’arithmétique sur cette petite grille, définissons les constantes discrètes de normalisation
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Selon la convention d’indices ci-dessus, il y a \(n-k+2=5\) fenêtres chevauchantes. Chacune regroupe un rendement voisin de \(1\) bp et un rendement de \(0\) bp ; ainsi \(\bar r_i=(1/3)(1+0)=1/3\) bp, et
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
La normalisation discrète correspondante donne
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Cet exemple sert à vérifier l’arithmétique et les unités ; six rendements et une fenêtre aussi courte ne justifient pas l’approximation asymptotique. Les valeurs sont construites pour rendre le calcul lisible. Ce ne sont ni des données de marché, ni la simulation d’un processus de bruit, ni la preuve que la variance intégrée latente a été retrouvée. Aucun écart-type ni aucune prévision ne sont calculés.
Comprendre les hypothèses et leurs limites
La dérivation standard repose sur un prix efficient continu observé fréquemment avec un bruit additif et sous certaines conditions de régularité. Un bruit centré et indépendant constitue un point de départ utile, mais une dépendance entre bruit et prix, des erreurs autocorrélées, un bruit variable dans le temps, des observations irrégulières ou un échantillonnage endogène peuvent nécessiter un estimateur modifié ou une théorie adaptée. Aït-Sahalia, Mykland et Zhang étudient l’estimation de la volatilité intégrée avec un bruit de microstructure dépendant. Leur article rappelle que la formule sous bruit indépendant n’est pas universelle.
Les sauts soulèvent une question distincte sur la cible. La variation quadratique inclut les carrés des sauts, contrairement à la variance intégrée continue. L’estimateur ordinaire par pré-moyennage ne sépare pas automatiquement les sauts. Une troncature robuste aux sauts ou une autre construction requiert ses propres hypothèses et paramètres. Une transaction aberrante importante peut aussi affecter plusieurs fenêtres chevauchantes ; la validation des données et le traitement des valeurs extrêmes restent nécessaires.
Le pré-moyennage ne résout pas non plus à lui seul les problèmes multivariés et asynchrones. Christensen, Kinnebrock et Podolskij développent des méthodes de covariance par pré-moyennage et une extension de Hayashi–Yoshida robuste au bruit pour les observations non synchrones dans leur étude. Ces constructions traitent des questions supplémentaires de plan d’échantillonnage. Appliquer une formule univariée à chaque actif ne synchronise pas automatiquement les horodatages et ne garantit pas une matrice de covariance valide.
Distinguer le pré-moyennage de TSRV et des noyaux réalisés
Ces estimateurs traitent des problèmes proches de variation haute fréquence, mais organisent l’information différemment. La Two-Scale Realized Volatility, ou TSRV, moyenne des variances réalisées sur des grilles d’échantillonnage clairsemées et décalées, puis soustrait une estimation à l’échelle fine multipliée par un facteur pour corriger le biais principal dû au bruit. Le pré-moyennage filtre d’abord de courtes fenêtres de rendements chevauchantes avec des poids réguliers, met les rendements filtrés au carré et applique une correction correspondante. L’article original sur les deux échelles décrit cette autre construction.
Un noyau réalisé part de la somme des rendements au carré et ajoute des autocovariances pondérées à plusieurs retards. La largeur de bande fixe le retard maximal. Le pré-moyennage modifie les rendements locaux avant leur mise au carré. Les deux méthodes utilisent des poids et des paramètres de réglage, mais leurs formules, normalisations et hypothèses ne sont pas interchangeables. Consultez le guide des noyaux réalisés pour la construction fondée sur les retards et la largeur de bande.
Le choix doit dépendre des données et de la quantité recherchée, pas du nom de l’estimateur. Comparez le plan d’échantillonnage, le modèle de bruit, le traitement des extrémités, la cible en présence de sauts et le comportement en échantillon fini. La robustesse asymptotique au bruit ne garantit pas que la méthode convienne le mieux à des actifs peu liquides, à une courte séance, à un bruit changeant ou à un flux de données irrégulier. Le guide TSRV présente ses choix d’échelle et de correction.
Rendre compte de la mesure d’un intervalle sans en tirer une conclusion de trading
Pour rendre le résultat reproductible, indiquez l’actif et le champ de prix, l’intervalle, la fréquence d’échantillonnage, les règles d’horodatage et de séance, les unités de rendement, la fonction de poids, la longueur de fenêtre, la normalisation, la convention aux extrémités et les hypothèses de bruit. Pour l’inférence, précisez aussi l’estimateur de variance ou la méthode d’intervalle de confiance et ses hypothèses. Un tableau de sensibilité pour plusieurs fenêtres raisonnables indique si la conclusion dépend d’un seul réglage.
La variance intégrée mesure un intervalle d’observation achevé. Sa racine carrée exprime une échelle de volatilité pour ce même intervalle, sans en faire une prévision. L’annualisation nécessite une convention temporelle explicitée et ne crée pas non plus de prévision. Prévoir une période ultérieure exige un modèle prédictif distinct et une évaluation hors échantillon. Le guide de calcul de la volatilité réalisée explique le benchmark des rendements au carré ; le guide de variation quadratique distingue la variation du chemin de la cible de variance intégrée continue.
L’estimateur ne prouve pas pourquoi le prix a bougé, ne révèle pas de stratégie rentable et ne garantit pas la mesure du risque d’exécution. Les coûts de transaction, la liquidité, les sauts, la dynamique de volatilité et l’incertitude d’estimation restent des questions distinctes. Le pré-moyennage est un outil de mesure statistique dont l’utilité dépend de l’adéquation entre ses hypothèses explicites et les données observées.
Questions fréquentes
Q1Le pré-moyennage revient-il à appliquer une moyenne mobile aux prix ?
Non. L’estimateur forme des sommes pondérées de rendements proches, puis les met au carré et les corrige. Moyenner les niveaux de prix avant de les différencier est une autre transformation, avec des poids et des effets de bord différents.
Q2Le pré-moyennage élimine-t-il tout le bruit de microstructure ?
Non. Il réduit l’effet principal sous des hypothèses précises de bruit et d’échantillonnage. Le bruit dépendant ou variable, les sauts, les valeurs aberrantes et les problèmes d’horodatage peuvent encore affecter le résultat.
Q3Pourquoi deux estimations par pré-moyennage peuvent-elles différer ?
La fonction de poids, la longueur de fenêtre, la normalisation en échantillon fini, le champ de prix, le traitement des extrémités ou le nettoyage des données peuvent différer. Il faut documenter ces choix et étudier leur sensibilité.
Q4Une estimation par pré-moyennage est-elle une prévision de volatilité ?
Pas à elle seule. Elle mesure les variations de l’intervalle utilisé pour son calcul. Prévoir une période ultérieure nécessite un modèle séparé et une évaluation hors échantillon.
Sources et lectures complémentaires
Signaler un problème
Nous préparons un e-mail avec le lien de cet article. Mark ne reçoit le signalement qu’après son envoi
Vérification rapide
Guide terminé ? Vérifiez vos acquis avec 3 questions
Question 01
Quel est l’objectif principal des rendements pré-moyennés ?
Choisissez une réponse pour voir l'explication
Glossaire des options
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Lire le guide approfondiQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Lire le guide approfondi