

কোয়ান্ট–অ্যান্ড্রুজ পরীক্ষা: অজানা ব্রেক তারিখের জন্য sup-Wald
কোয়ান্ট–অ্যান্ড্রুজ sup-Wald পরীক্ষা কীভাবে রিগ্রেশনে একটি অজানা ব্রেক খোঁজে, trimming কেন গুরুত্বপূর্ণ, এবং এর null distribution কেন সাধারণ F distribution নয়—জানুন
এই গাইডেঅজানা break date প্রশ্নটিই বদলে দেয়
সংক্ষিপ্ত সারাংশ
Quandt–Andrews পদ্ধতি পরীক্ষা করে, একটি অজানা break date থাকলে regression coefficient স্থির থাকে কি না। এটি প্রতিটি গ্রহণযোগ্য তারিখে একটি statistic হিসাব করে এবং সর্বোচ্চ মানটি নেয়। তারিখটি অনুসন্ধানের মাধ্যমে বেছে নেওয়া হয় এবং no-break null সত্য হলে শনাক্তযোগ্য নয়; তাই এই maximum-এর distribution নির্দিষ্ট তারিখের সাধারণ F distribution নয়।
অজানা break date প্রশ্নটিই বদলে দেয়
Chow test-এর প্রশ্ন নির্দিষ্ট: ফল দেখার আগে বেছে রাখা একটি তারিখে regression coefficient বদলেছে কি? অনেক আর্থিক ও সামষ্টিক-অর্থনৈতিক প্রয়োগে আগে থেকে যুক্তিসঙ্গত একটি তারিখ বেছে নেওয়া যায় না। নানা তারিখ পরীক্ষা করে সবচেয়ে significant Chow ফল জানালে তারিখ বাছাইও test-এর অংশ হয়ে যায়। সাধারণ single-date critical value সেই অনুসন্ধানকে উপেক্ষা করে।
Quandt-এর দুই-regime পদ্ধতি এবং Andrews-এর পরবর্তী asymptotic framework সম্ভাব্য break date-গুলোর একটি সেটে statistic হিসাব করে এই সমস্যা সামলায়। প্রয়োগিক linear regression-এ নির্দিষ্ট statistic ও covariance treatment অনুযায়ী maximum-টিকে Quandt likelihood-ratio (QLR), sup-F, বা sup-Wald বলা হয়। অজানা change point-সহ আরও বিস্তৃত parametric model-এর জন্য Andrews sup-Wald, LM, ও LR-ধরনের test বিকাশ করেন (Quandt, 1960; Andrews, 1993).
এখানে লক্ষ্যটি ইচ্ছাকৃতভাবে সীমিত: একটি নির্দিষ্ট regression relationship-এ একটি সম্ভাব্য পরিবর্তন পরীক্ষা করা, যেখানে তারিখ অজানা। এই test অজানা সংখ্যক break নির্ণয় করে না, পরিবর্তনের কারণ ব্যাখ্যা করে না, বা trading opportunity চিহ্নিত করে না। একাধিক অজানা break model করার আলাদা সমস্যা নিয়ে Bai–Perron নির্দেশিকা আলোচনা করে।
এক-break regression ও পরীক্ষার restriction নির্ধারণ করুন
ধরা যাক, ক্রমানুসারে সাজানো sample-এ (t=1,ldots,T) observation আছে, outcome (y_t), এবং regressor vector (x_t)। একটি pure one-break model হলো
yₜ = xₜ′β₁ + uₜ, t ≤ k yₜ = xₜ′β₂ + uₜ, t > k
এখানে (k) হলো প্রথম regime-এর শেষ observation। no-break null-এ পরীক্ষাধীন coefficient vector সমান: (H₀: β₁ = β₂)। one-break alternative বলে, অন্তত একটি গ্রহণযোগ্য তারিখে তারা ভিন্ন। Partial-change model-এ আগে থেকে নির্ধারিত কিছু coefficient-ই বদলাতে পারে; এতে restriction-এর সংখ্যা এবং reference distribution বদলে যায়। কোন coefficient বদলানোর অনুমতি আছে তা স্পষ্ট করুন।
তারিখের অর্থ বোঝাতে sample-এর ক্রমও নির্দিষ্ট হতে হবে। দৈনিক return-এ (k) সাধারণত trading-session index, স্বয়ংক্রিয়ভাবে calendar date নয়। Missing observation, ছুটি, asynchronous market, contract roll, এবং target-এর সংজ্ঞা বদল “আগে” ও “পরে”র অর্থ পাল্টাতে পারে। নির্বাচিত split-কে কোনো ঘটনার সঙ্গে যুক্ত করার আগে sample ও date convention নির্ধারণ করুন।
Rejection নির্দিষ্ট constant-coefficient model-এর বিরুদ্ধে এবং অনুসন্ধান করা সীমার মধ্যে কোনো one-break alternative-এর পক্ষে প্রমাণ। এটি প্রমাণ করে না যে নির্দিষ্ট কোনো announcement break ঘটিয়েছে, regressor exogenous, বা post-break coefficient টিকে থাকবে। Conditional mean, error dynamics, বা measurement process ভুলভাবে নির্দিষ্ট হলে test পরিচ্ছন্ন parameter shift-এর বদলে সেই misspecification-এ সাড়া দিতে পারে।
Candidate date trim করে split-এর দুই পাশ fit করুন
Sample-এর প্রান্তের কাছে candidate date থাকলে এক পাশে নির্ভরযোগ্য estimation-এর জন্য observation কম থাকে। Trimming fraction (\varepsilon) ওই প্রান্ত বাদ দিয়ে আগে থেকে নির্ধারিত একটি interval—যেমন ([\varepsilon,1-\varepsilon])—এর break fraction (lambda=k/T) পর্যন্ত অনুসন্ধান সীমিত করে। Discrete sample-এ implementation এই interval-কে integer date-এ রূপান্তর করে এবং দুই segment-এ পর্যাপ্ত observation ও full-rank regressor নিশ্চিত করে। নির্দিষ্ট convention জানান, যার মধ্যে (k) শেষ pre-break observation নাকি প্রথম post-break observation তাও থাকবে।
প্রতিটি গ্রহণযোগ্য (k)-এর জন্য pooled null model এবং সংশ্লিষ্ট দুই-regime model fit করে coefficient change-এর restriction-এর statistic হিসাব করুন। Independent, homoskedastic error এবং common regressor set-সহ classical OLS-এ এটি residual sum of squares কমার মাধ্যমে লেখা যায়। Normal error থাকলে আগে থেকে নির্ধারিত এক তারিখের statistic-এর exact finite-sample F reference distribution আছে; normality না থাকলে সেই exact দাবি প্রযোজ্য নয়। Wald version estimated coefficient difference-কে estimated covariance দিয়ে scale করে। Heteroskedasticity বা serial dependence থাকলে উপযুক্ত robust covariance ও matching reference method লাগবে। শুধু standard error robust করলেই date search-এর পর সাধারণ F critical value বৈধ হয় না।
Trimming cosmetic setting নয়, test design-এর অংশ। বেশি trimming search ছোট করে ও অতি ছোট regime এড়ায়, তবে প্রান্তের কাছের break বাদ দেয়। কম trimming ওই candidate-গুলো রাখে, কিন্তু asymptotic approximation এবং finite-sample estimate বেশি দুর্বল হতে পারে। statistic কোথায় peak করে তা দেখার আগে sample size, model dimension, ও প্রশ্ন অনুযায়ী range বেছে নিন।
<!-- learn:illustration -->
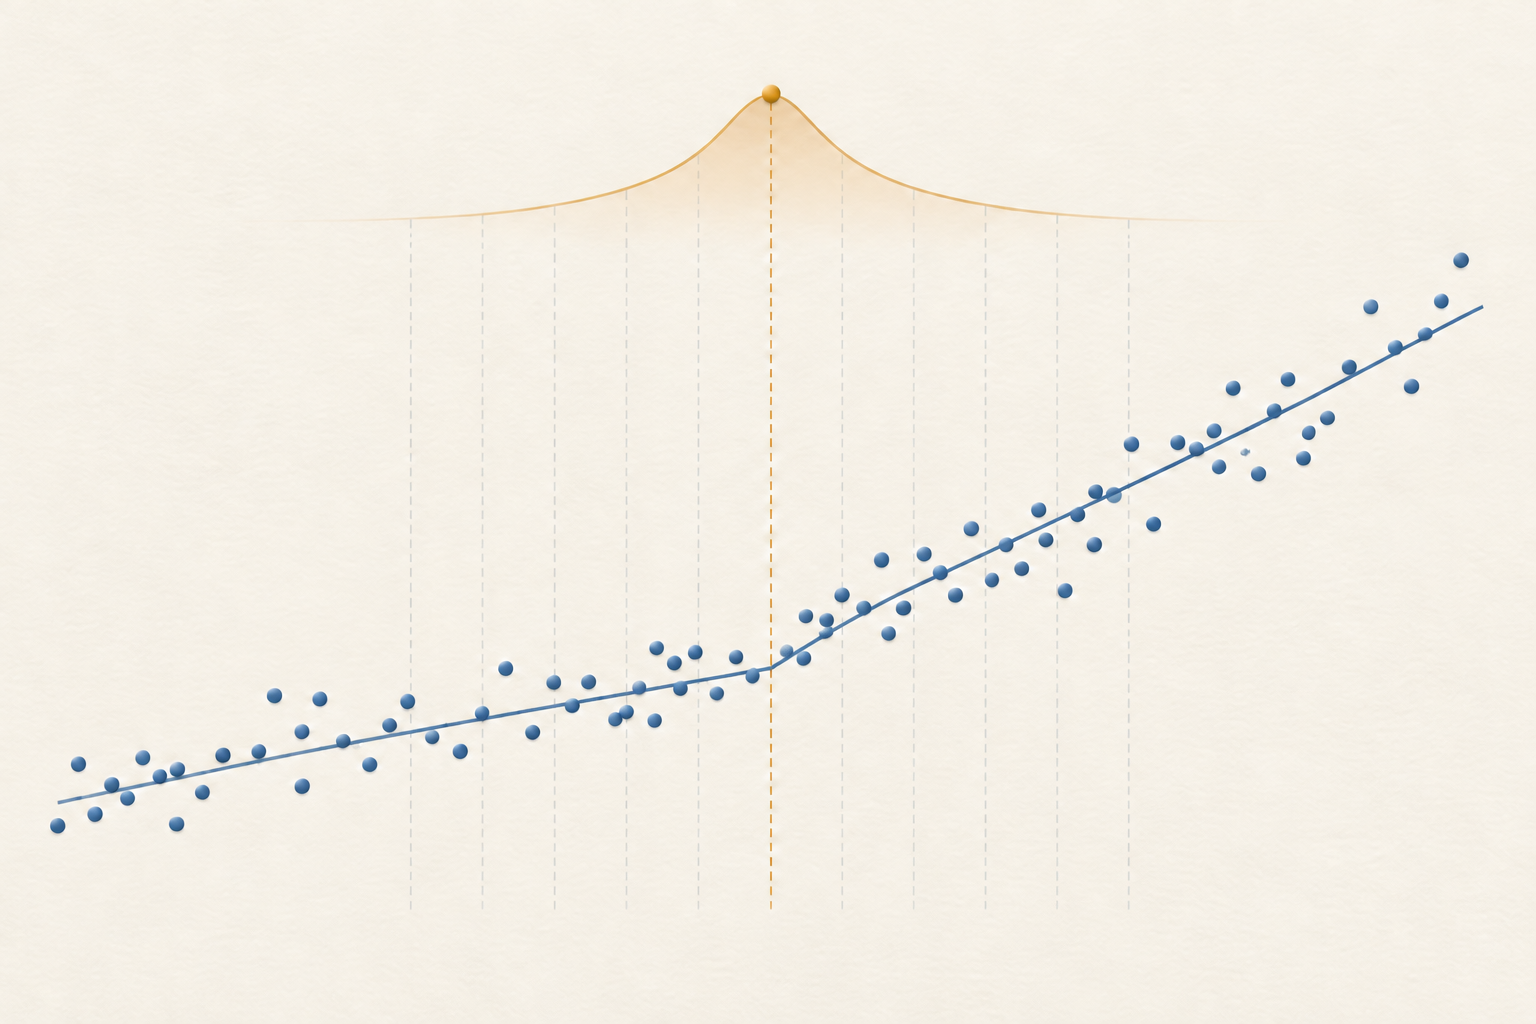
sup-Wald statistic হলো candidate-date statistic-গুলোর সর্বোচ্চ মান
প্রতিটি candidate date (k)-এ নির্দিষ্ট coefficient restriction-এর Wald statistic-কে (W(k)) বলি। এক break-এর sup-Wald statistic হলো
supW = max{k ∈ K} W(k)
এখানে (K) trimming-এর পর গ্রহণযোগ্য date-গুলোর set। Classical linear-regression implementation-এ candidate date-ভিত্তিক Chow F statistic-এর maximum-কে প্রায়ই sup-F বা QLR বলা হয়। সর্বোচ্চ মানদাতা (hat{k}=argmax_{kin K} W(k)) হলো অনুসন্ধানে সবচেয়ে বড় statistic দেয় এমন তারিখ। এটি নির্বাচিত estimate; confidence interval বা অর্থনৈতিক পরিবর্তনের নিখুঁত সময় নয়।
নামগুলো সম্পর্কিত হলেও সব ক্ষেত্রে পরস্পর বিনিমেয় নয়। নির্দিষ্ট তারিখে homoskedastic Chow F তার assumption-এ exact finite-sample F distribution পেতে পারে। তারিখের maximum, robust covariance-সহ asymptotic sup-Wald, এবং likelihood-ratio statistic-এর finite-sample মান বা critical value এক হওয়ার নিশ্চয়তা নেই। শুধু “QLR” না লিখে আসলে কোন statistic, covariance estimator, trimming rule, ও critical-value source ব্যবহৃত হয়েছে জানান।
পাশাপাশি candidate-গুলোর statistic পরস্পর নির্ভরশীল, কারণ কাছাকাছি split-এ প্রায় একই observation পুনর্ব্যবহার হয়। test-টি সবচেয়ে ছোট fixed-date p-value নেওয়া, candidate সংখ্যায় সেটি গুণ করা, বা প্রতিটি date-কে independent test ধরার সমতুল্য নয়। maximum process-এর জন্য অনুসন্ধান-সমন্বিত null distribution ব্যবহার করতে হয়।
অনুসন্ধানে পাওয়া maximum-এর null distribution nonstandard
No-break null-এর অধীনে estimate করার মতো প্রকৃত break date নেই। তারিখের parameter alternative-এ থাকে কিন্তু null-এ অদৃশ্য হয়। ফলে আগে থেকে নির্ধারিত একটি Wald বা F test-এর সাধারণ regularity argument প্রযোজ্য নয়। Candidate date জুড়ে maximum নিলে তাই nonstandard asymptotic distribution তৈরি হয়। এই maximum-কে সাধারণ F cutoff-এর সঙ্গে তুলনা করলে stability-বিরোধী প্রমাণ সাধারণত অতিরঞ্জিত হয়।
Andrews sup-Wald, LM, ও LR-ধরনের test-এর asymptotic distribution এবং critical value নির্ণয় করেন; trimming-এর দুই endpoint ও tested restriction-এর সংখ্যা search interval নির্ধারণে ভূমিকা রাখে (1993)। প্রযোজ্য মান model এবং covariance assumption-এর ওপরও নির্ভর করে। নির্দিষ্ট test-এর সঙ্গে মেলে এমন table, implementation, বা approximation ব্যবহার করুন; ভিন্ন trimming fraction বা restriction count-এর critical value ধার করবেন না। আটটি restriction-এর জন্য কিছু sup-test critical value খুব ছোট ছিল বলে Andrews পরে corrigendum প্রকাশ করেন; সে ক্ষেত্রে সংশোধিত table দরকার (2003 corrigendum)। Hansen structural-change test-এর asymptotic p-value-এর numerical approximation দেন (1997)।
Andrews ও Ploberger alternative-এ থাকা nuisance parameter-এর জন্য average এবং exponential test-ও নির্ণয় করেন (1994)। এগুলো search-aware সম্পর্কিত পদ্ধতি, sup-Wald-এর বিকল্প নাম নয়। Bootstrap বা অন্য finite-sample calibration ব্যবহার করলে resampling design ব্যাখ্যা করুন এবং দেখান যে তা null structure ও একই search পুনরুৎপাদন করে; সাধারণ bootstrap নিজে থেকে date selection বা dependence সমাধান করে না।
বারো observation-এর উদাহরণে trimming ও maximum যাচাই করা যায়
ইচ্ছাকৃতভাবে ছোট একটি কাল্পনিক intercept-only regression বিবেচনা করুন, যার observation হলো
y = [0, 1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 3]
এখানে (T=12) observation। উদাহরণ হিসেবে (\varepsilon=0.25) নিলে প্রতিটি segment-এ অন্তত তিনটি observation থাকা চাই; তাই শেষ pre-break candidate date (k=3,ldots,9)। এটি search arithmetic বোঝায়, trimming-এর সুপারিশ বা inferential sample নয়।
Pooled mean (23/12), এবং pooled residual sum of squares হলো
RSS₀ = Σ yₜ² − (Σ yₜ)²/12 = 59 − 529/12 = 179/12
Candidate (k=6)-এ প্রথম segment-এর sum ও sum of squares দুটোই 5, তাই residual sum of squares (5−5²/6=5/6)। দ্বিতীয় segment-এ 3-এর ছয়টি মান আছে, ফলে তার residual sum of squares শূন্য। সুতরাং (RSS₁(6)=5/6)। একটি restriction এবং দুইটি segment intercept estimate করলে fixed-date statistic হয়
F(6) = [(RSS₀ − RSS₁(6))/1] / [RSS₁(6)/(12−2)] = 169
সাতটি candidate-এ একই হিসাব করলে (k=3,ldots,9) ক্রমে আনুমানিক F মান (7.21, 12.10, 25.28, 169.00, 20.71, 8.94, 4.59)। তাই sup-F হলো maximum 169, যা (k=6)-এ। এই হিসাব নির্মিত sequence-এ কোন candidate সর্বোচ্চ তা যাচাই করে, p-value দেয় না। তারিখ অনুসন্ধান করা হয়েছে বলে 169-কে matching design-এর search-aware nonstandard critical value-এর সঙ্গে তুলনা করতে হবে, সাধারণ fixed-date F distribution-এর সঙ্গে নয়।
Test design-এর সীমায় rejection ও non-rejection ব্যাখ্যা করুন
Rejection বলে নির্বাচিত significance level, test assumption, ও critical value অনুযায়ী অনুমোদিত range-এ পাওয়া সর্বোচ্চ statistic constant-coefficient null-এর সঙ্গে অসঙ্গত। এটি একটিমাত্র নির্ভুল তারিখে break প্রমাণ করে না। কাছাকাছি candidate date-এ statistic মিলতে পারে; sample endpoint, trimming, regressor, বা covariance method বদলালে apparent peak সরে যেতে পারে। (hat{k})-কে exact সময় না বলে candidate statistic profile বা উপযুক্ত date-uncertainty analysis জানান।
Non-rejection coefficient stability প্রমাণ করে না। ছোট পরিবর্তন, trimmed endpoint-এর কাছে পরিবর্তন, বা পরীক্ষিত restriction-এ না থাকা coefficient-এর পরিবর্তনে test power কম হতে পারে। কিছু পরিবর্তন পরস্পর আংশিক বাতিল করলে one-break test সেগুলোও ধরতে নাও পারে। বিপরীতে outlier, variance change, omitted dynamics, data definition change, বা বারবার specification search instability-এর প্রমাণ তৈরি করতে পারে। Test একটি সীমিত statistical প্রশ্নের উত্তর দেয়, কারণের নয়।
Date estimate test-এর একই data থেকে বাছাই করা হয়। সেটিকে pre-specified event date ধরে দ্বিতীয় unadjusted significance test করে independent confirmation দাবি করবেন না। তারিখ forecast update বা trading rule-এ কাজে লাগলে rule নির্দিষ্ট করে পরবর্তী data-তে মূল্যায়ন করুন; in-sample sup statistic post-break persistence বা economic value প্রমাণ করে না।
Chow, CUSUM ও Bai–Perron-এর প্রশ্ন আলাদা করুন
| পদ্ধতি | মূল প্রশ্ন | এটি যা করে না |
|---|---|---|
| Chow test | আগে থেকে স্থির করা তারিখে coefficient কি আলাদা? | single-date reference distribution রেখে অজানা তারিখ খোঁজা |
| [Quandt–Andrews sup test](#) | trimmed range-এর কোনো তারিখে এক break-এর প্রমাণ আছে কি? | অজানা break সংখ্যা বেছে নেওয়া বা কারণ ব্যাখ্যা |
| Regression CUSUM | ordered recursive-residual path কি coefficient stability-এর সঙ্গে সাংঘর্ষিক? | একাই নির্বাচিত one-break date ফেরত দেওয়া |
| Bai–Perron | multiple-break model-এ কয়টি break ও কোন date data support করে? | one-break test-এর specification ও selection choice প্রতিস্থাপন |
Hidden Markov বা regime-switching model অন্য প্রশ্ন করে: transition probability অনুযায়ী বারবার বদলাতে পারে এমন latent state দিয়ে observation মডেল করা যায় কি না। একটি অজানা single-break test নির্দিষ্ট range-এ একবারের স্থায়ী before/after split দেখে। পদ্ধতিগুলো পরিপূরক হতে পারে, কিন্তু assumption ও output এক নয়; regime-switching নির্দেশিকা দেখুন।
অন্য বিশ্লেষক যাতে পুনরুৎপাদন করতে পারেন, সে জন্য search জানান
Outcome ও regressor, pure নাকি partial change, tested coefficient restriction, sample date ও ক্রম, এবং break-date convention উল্লেখ করুন। (T), restriction-এর সংখ্যা, trimming fraction বা exact candidate set, minimum segment size, এবং নির্বাচিত statistic sup-Wald, sup-F/QLR, sup-LM নাকি অন্য পদ্ধতি তা লিখুন। Covariance estimator, critical-value বা p-value method এবং finite-sample correction থাকলে সেটিও জানান।
Candidate date জুড়ে statistic দেখান এবং সর্বোচ্চ মানদাতা date-কে selected location হিসেবে জানান; সম্ভব হলে uncertainty বা sensitivity-ও দিন। Model ও test design আগে নির্ধারিত ছিল কি না, missing observation ও real-time data কীভাবে সামলানো হয়েছে এবং বিকল্প sample বা regressor কী পরীক্ষা করেছেন তা ব্যাখ্যা করুন। Forecasting-এর জন্য হলে break search training sample-এর ভেতরে রাখুন এবং সংশোধিত model পরবর্তী অনাবৃত data-তে মূল্যায়ন করুন।
অজানা-break test-এর statistical significance কোনো ঘটনার কারণ শনাক্ত করে না বা লাভজনক regime প্রমাণ করে না। Non-significant ফল stability নিশ্চিত করে না। যুক্তিসঙ্গত সিদ্ধান্ত হলো নির্দিষ্ট one-break alternative, trimmed date range, regression, sample, এবং search-aware inference method-এর মধ্যেই সীমিত থাকা।
সাধারণ প্রশ্ন
Q1Quandt–Andrews test কি কেবল অনেক তারিখে Chow test বারবার চালানো?
এটি candidate date জুড়ে সম্পর্কিত statistic হিসাব করে, তবে inference-এ maximum নেওয়ার বিষয়টি ধরতে হয়। সর্বোচ্চ সাধারণ Chow ফলের সঙ্গে fixed-date p-value জানালে search উপেক্ষিত হয় এবং সাধারণত ভুল null distribution ব্যবহৃত হয়।
Q2সর্বোচ্চ statistic-এর date কি অর্থনৈতিক ঘটনার break ঘটানোর সময় শনাক্ত করে?
না। নির্বাচিত sample ও trimmed range-এ এটি সর্বোচ্চ statistic-যুক্ত candidate date। এটি causal timestamp বা confidence interval নয়; পাশের date ও design choice-এ ফল কাছাকাছি হতে পারে।
Q3Rejection কি প্রমাণ করে ঠিক একটি break ঘটেছে?
না। এটি searched range-এর কোনো one-break alternative-এর বিপরীতে নির্দিষ্ট constant-coefficient null প্রত্যাখ্যান করে। একাধিক পরিবর্তন, outlier, variance shift বা model misspecification-ও instability-এর প্রমাণ দিতে পারে; multiple break estimate করা আলাদা কাজ।
Q4sup-Wald maximum কি সাধারণ F table-এর সঙ্গে তুলনা করতে পারি?
সাধারণত না। Sup statistic, trimming, restriction count, model, ও covariance assumption-এর সঙ্গে মেলে এমন critical value বা p-value ব্যবহার করুন। সাধারণ F distribution তার assumption-এ pre-specified date test-এর জন্য, search করা maximum-এর জন্য স্বয়ংক্রিয়ভাবে নয়। প্রাথমিক গবেষণা - Quandt, “Tests of the Hypothesis That a Linear Regression System Obeys Two Separate Regimes” (1960) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point” (1993) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point: A Corrigendum” (2003) - Hansen, “Approximate Asymptotic P Values for Structural-Change Tests” (1997) - Andrews and Ploberger, “Optimal Tests When a Nuisance Parameter Is Present Only Under the Alternative” (1994) - Chow, “Tests of Equality Between Sets of Coefficients in Two Linear Regressions” (1960) - Bai and Perron, “Estimating and Testing Linear Models with Multiple Structural Changes” (1998) - Brown, Durbin, and Evans, “Techniques for Testing the Constancy of Regression Relationships over Time” (1975)
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
Break date অজানা হলে Quandt–Andrews sup-Wald test কী করে?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
A model generating observations from finite discrete latent states with Markov transition probabilities and state-dependent emissions.
বিস্তারিত গাইড পড়ুনঅ্যাট-দ্য-মানিযে অবস্থায় কোনো অপশনের স্ট্রাইক মূল্য অন্তর্নিহিত সম্পদের বাজারদামের কাছাকাছি থাকে। তখন অন্তর্নিহিত মূল্য কম বা শূন্য হলেও বাকি সময় ও অনিশ্চয়তার কারণে প্রিমিয়াম থাকতে পারে।
বিস্তারিত গাইড পড়ুন