

Тест Куандта—Эндрюса: sup-Wald при неизвестной дате разрыва
Узнайте, как тест sup-Wald Куандта—Эндрюса ищет один неизвестный разрыв регрессии, зачем нужен trimming и почему нулевое распределение не является обычным F-распределением.
В этом руководствеНеизвестная дата разрыва меняет вопрос
Краткое резюме
Подход Куандта—Эндрюса проверяет, остаются ли коэффициенты регрессии постоянными, если дата одного разрыва неизвестна. Для каждой допустимой даты рассчитывается статистика, после чего выбирается ее максимум. Поскольку дата выбирается в результате поиска и не идентифицируется при нулевой гипотезе об отсутствии разрыва, этот максимум не подчиняется обычному F-распределению для одной фиксированной даты.
Неизвестная дата разрыва меняет вопрос
Тест Чоу отвечает на конкретный вопрос: изменились ли коэффициенты регрессии в дату, выбранную до просмотра результатов? Во многих финансовых и макроэкономических приложениях трудно заранее обосновать одну дату. Если проверить несколько дат и сообщить наиболее значимый результат Чоу, выбор даты становится частью теста. Обычные критические значения для одной даты такой поиск не учитывают.
Двухрежимная процедура Куандта и более поздняя асимптотическая схема Эндрюса решают эту задачу, оценивая статистику на множестве возможных дат разрыва. В прикладной линейной регрессии максимум часто называют отношением правдоподобия Куандта (QLR), sup-F или sup-Wald — в зависимости от статистики и способа оценки ковариации. Эндрюс развивает тесты sup-Wald, LM и LR-типа для более широких параметрических моделей с неизвестной точкой изменения (Quandt, 1960; Andrews, 1993).
Здесь рассматривается намеренно узкая задача: проверить возможность одного изменения в заданной регрессионной зависимости, дата которого неизвестна. Тест не оценивает неизвестное число изменений, не объясняет их причины и не находит торговую возможность. В руководстве Бай—Перрона рассматривается другая задача — моделирование нескольких неизвестных дат разрыва.
Задайте регрессию с одним разрывом и проверяемые ограничения
Пусть упорядоченная выборка содержит наблюдения (t=1,ldots,T), зависимую переменную (y_t) и вектор регрессоров (x_t). Модель с одним чистым разрывом имеет вид
yₜ = xₜ′β₁ + uₜ, t ≤ k yₜ = xₜ′β₂ + uₜ, t > k
где (k) — последнее наблюдение первого режима. При нулевой гипотезе об отсутствии разрыва проверяемые векторы коэффициентов равны: совместное ограничение записывается как (H₀: β₁ = β₂). Альтернатива с одним разрывом означает, что они различаются хотя бы в одну допустимую дату. В модели частичного изменения может меняться только заранее заданная часть коэффициентов; тогда меняются число ограничений и референтное распределение. Укажите, какие коэффициенты могут изменяться.
Порядок наблюдений должен придавать дате разрыва смысл. Для дневной доходности (k) обычно является индексом торговой сессии, а не обязательно календарной датой. Пропуски, праздники, несовпадающие часы работы рынков, роллирование контрактов и изменение определения целевой переменной могут повлиять на понятия «до» и «после». Определите выборку и правило датирования до того, как связывать найденное разделение с событием.
Отклонение нулевой гипотезы свидетельствует против заданной модели постоянных коэффициентов и в пользу некоторой альтернативы с одним разрывом в пределах диапазона поиска. Оно не доказывает, что изменение вызвало конкретное объявление, что регрессоры экзогенны или что коэффициенты после разрыва сохранятся. При неверной спецификации условного среднего, динамики ошибок или процесса измерения тест может реагировать на нее, а не на чистое изменение параметров.
Отсеките крайние даты и оцените обе стороны каждого разделения
Кандидатная дата у края выборки оставляет слишком мало наблюдений с одной стороны для надежной оценки. Доля trimming (ε) исключает края и ограничивает поиск долями разрыва (lambda=k/T) в заранее заданном интервале, например ([ε,1-ε]). В дискретной выборке интервал переводится в целые даты; в обоих сегментах должно оставаться достаточно наблюдений, а матрицы регрессоров должны иметь полный ранг. Укажите точное правило, включая то, обозначает ли (k) последнее наблюдение до разрыва или первое после него.
Для каждой допустимой даты (k) оцените объединенную нулевую модель и соответствующую двухрежимную модель, затем рассчитайте статистику для ограничений на изменение коэффициентов. В классическом МНК со независимыми гомоскедастичными ошибками и общей совокупностью регрессоров статистику можно выразить через снижение суммы квадратов остатков. При нормальных ошибках статистика для одной заранее заданной даты имеет точное F-распределение в конечной выборке; без нормальности это свойство не следует. Вариант Wald сопоставляет оцененную разность коэффициентов с ее оцененной ковариацией. При гетероскедастичности или серийной зависимости нужна подходящая робастная ковариация и согласованный метод расчета референтного распределения. Одна лишь замена стандартных ошибок не делает обычное критическое значение F корректным после поиска даты.
Trimming — часть дизайна теста, а не косметическая настройка. Более сильное отсечение сокращает поиск и исключает очень маленькие режимы, но также убирает крупные разрывы у краев выборки. Более слабое отсечение включает такие даты, но делает асимптотические приближения и оценки в конечной выборке менее надежными. Выберите диапазон с учетом размера выборки, размерности модели и содержательного вопроса до просмотра пика статистики.
<!-- learn:illustration -->
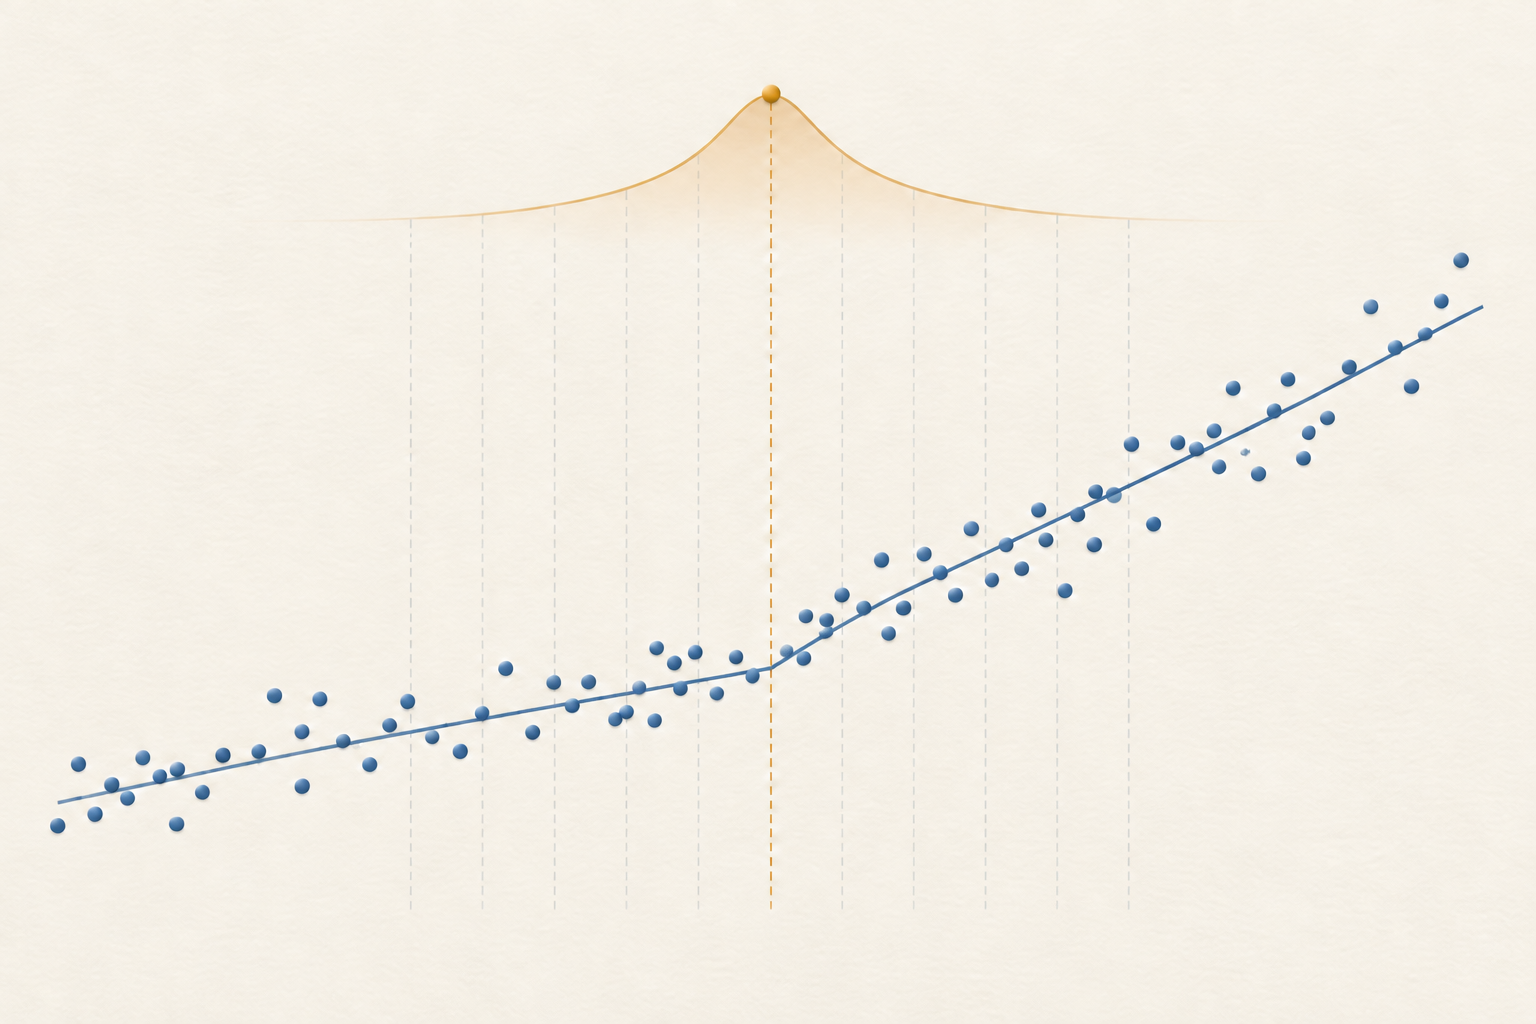
Статистика sup-Wald — максимум статистик по кандидатным датам
Пусть (W(k)) — статистика Wald для заданных ограничений на коэффициенты в каждую кандидатную дату (k). Статистика sup-Wald для одного разрыва определяется как
supW = max{k ∈ K} W(k)
где (K) — множество допустимых дат после trimming. В классической линейной регрессии часто берут максимум статистик F Чоу по кандидатным датам и называют его sup-F или QLR. Дата максимума (hat{k}=argmax_{kin K} W(k)) дает наибольшую статистику в этом поиске. Это выбранная оценка, а не доверительный интервал и не точная временная отметка экономического изменения.
Названия связаны, но не всегда взаимозаменяемы. Обычная гомоскедастическая статистика Чоу F для фиксированной даты при выполнении предпосылок имеет точное F-распределение в конечной выборке. Максимум по датам, асимптотическая sup-Wald с робастной ковариацией и статистика отношения правдоподобия не обязаны иметь одинаковые значения в конечной выборке или одинаковые критические значения. Указывайте фактически рассчитанную статистику, оцениватель ковариации, правило trimming и источник критических значений, а не ограничивайтесь термином «QLR».
Кандидатные статистики сильно зависимы: соседние разделения повторно используют почти все те же наблюдения. Этот тест не равен выбору наименьшего p-значения для фиксированной даты, умножению его на число дат или трактовке каждой даты как независимого теста. Нулевое распределение выводится для максимума с учетом поиска.
Найденный максимум имеет нестандартное нулевое распределение
При нулевой гипотезе об отсутствии разрыва истинной даты разрыва, которую можно было бы оценить, нет. Параметр даты присутствует при альтернативе, но исчезает при нулевой гипотезе; поэтому стандартные условия для одного теста Wald или F с фиксированной датой не выполняются. Максимизация по кандидатным датам дает нестандартное асимптотическое распределение. Сравнение максимума со стандартным критическим значением F обычно завышает свидетельства против стабильности.
Эндрюс выводит асимптотические распределения и критические значения для тестов sup-Wald, LM и LR-типа; на них влияют границы trimming и число проверяемых ограничений (1993). Подходящие значения также зависят от модели и предпосылок о ковариации. Используйте таблицу, реализацию или приближение, соответствующие конкретному тесту; не переносите критическое значение для другой доли trimming или другого числа ограничений. Позднее Эндрюс опубликовал исправление: некоторые указанные критические значения sup-тестов для восьми ограничений были слишком малы, поэтому для этого случая нужна исправленная таблица (исправление 2003 года). Хансен предлагает численные приближения асимптотических p-значений тестов структурных изменений (1997).
Эндрюс и Плобергер также выводят средние и экспоненциальные тесты для nuisance-параметров, присутствующих только при альтернативе (1994). Это родственные процедуры, учитывающие поиск, но не другие названия sup-Wald. При использовании bootstrap или другой калибровки для конечной выборки опишите схему ресэмплинга и покажите, что она воспроизводит нулевую структуру и тот же поиск. Обычный bootstrap сам по себе не решает проблему выбора даты или зависимости.
Пример с двенадцатью наблюдениями позволяет проверить trimming и максимум
Рассмотрим намеренно небольшой гипотетический регрессионный пример только со свободным членом:
y = [0, 1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 3]
Имеется (T=12) наблюдений. Для иллюстрации возьмем (ε=0.25): в каждом сегменте должно быть не менее трех наблюдений, поэтому последними наблюдениями первого сегмента в кандидатных датах являются (k=3,ldots,9). Пример показывает арифметику поиска; это не рекомендуемое значение trimming и не выборка для статистического вывода.
Объединенное среднее равно (23/12), а сумма квадратов остатков объединенной модели составляет
RSS₀ = Σ yₜ² − (Σ yₜ)²/12 = 59 − 529/12 = 179/12
При кандидате (k=6) сумма и сумма квадратов значений первого сегмента равны 5, поэтому его сумма квадратов остатков равна (5−5²/6=5/6). Во втором сегменте шесть значений, равных 3, поэтому его сумма квадратов остатков равна нулю. Следовательно, (RSS₁(6)=5/6). При одном ограничении и двух оцениваемых константах сегментов статистика фиксированной даты равна
F(6) = [(RSS₀ − RSS₁(6))/1] / [RSS₁(6)/(12−2)] = 169
Тот же расчет для всех семи кандидатов дает приблизительные значения F (7.21, 12.10, 25.28, 169.00, 20.71, 8.94, 4.59) для (k=3,ldots,9) соответственно. Sup-F равен максимуму — 169 при (k=6). Расчет лишь проверяет, какой кандидат максимизирует эту сконструированную последовательность; p-значение он не дает. Поскольку дата была выбрана поиском, значение 169 следует сравнивать с соответствующим нестандартным критическим значением, учитывающим поиск, а не с обычным F-распределением для фиксированной даты.
Интерпретируйте отклонение и неотклонение в рамках дизайна
Отклонение означает, что при выбранном уровне значимости и предпосылках и критических значениях теста максимальная статистика в допустимом диапазоне не согласуется с нулевой гипотезой о постоянстве коэффициентов. Оно не устанавливает единственный точно датированный разрыв. Соседние кандидатные даты могут давать похожие статистики, а максимум может сдвинуться при изменении границ выборки, trimming, регрессоров или метода оценки ковариации. Покажите профиль статистик по кандидатным датам или подходящий анализ неопределенности даты, а не представляйте (hat{k}) как точное значение.
Неотклонение не доказывает стабильность коэффициентов. Мощность теста может быть низкой для небольшого изменения, изменения рядом с отсеченным краем или изменения коэффициента, не входящего в проверяемые ограничения. Тест на один разрыв может также пропустить несколько частично взаимно компенсирующих изменений. И наоборот, выброс, изменение дисперсии, пропущенная динамика, смена определения данных или повторный поиск спецификации могут дать свидетельства нестабильности. Тест отвечает на ограниченный статистический вопрос, а не объясняет причину расхождения.
Дата выбирается по тем же данным, на которых проводится тест. Не трактуйте ее как заранее заданную дату события, чтобы затем без поправки провести второй тест значимости и заявить о независимом подтверждении. Если дата влияет на обновление прогноза или торговое правило, сформулируйте правило и оцените его на более поздних данных. Внутривыборочная sup-статистика не доказывает ни устойчивость после разрыва, ни экономическую ценность.
Различайте вопросы тестов Чоу, CUSUM и Бай—Перрона
| Метод | Основной вопрос | Чего он не делает |
|---|---|---|
| Тест Чоу | Различаются ли коэффициенты в заранее заданную дату? | Ищет неизвестные даты, сохраняя референтное распределение для одной даты |
| Тест sup Куандта—Эндрюса | Есть ли свидетельства одного разрыва где-либо в усеченном диапазоне? | Выбирает неизвестное число разрывов или объясняет их причину |
| Регрессионный CUSUM | Противоречит ли упорядоченная траектория рекурсивных остатков стабильности коэффициентов? | Сам по себе возвращает выбранную дату одного разрыва |
| Бай—Перрон | Сколько разрывов и какие даты поддерживает модель с несколькими разрывами? | Заменяет спецификацию и выбор модели для теста одного разрыва |
Скрытая марковская модель или модель переключения режимов ставит другой вопрос: можно ли описать наблюдения латентными состояниями, которые многократно меняются с заданными вероятностями перехода? Тест одного неизвестного изменения рассматривает одно устойчивое разделение на «до» и «после» в пределах диапазона поиска. Методы дополняют друг друга, но их предпосылки и результаты не взаимозаменяемы; см. руководство по переключению режимов.
Опишите поиск так, чтобы другой аналитик мог его воспроизвести
Укажите зависимую переменную и регрессоры, чистое или частичное изменение, проверяемые ограничения на коэффициенты, даты и порядок выборки, а также правило определения даты разрыва. Сообщите (T), число ограничений, долю trimming или точный набор кандидатов, минимальный размер сегмента и использованный тест: sup-Wald, sup-F/QLR, sup-LM или другой. Укажите оцениватель ковариации, метод расчета критического значения или p-значения и поправку для конечной выборки, если она применялась.
Покажите статистику по кандидатным датам и сообщите дату максимума как выбранное положение, по возможности добавив оценку неопределенности или чувствительности. Объясните, были ли модель и дизайн теста заданы заранее, как обрабатывались пропуски и данные в реальном времени, какие альтернативные выборки или регрессоры проверялись. В прогнозных задачах поиск разрыва должен оставаться внутри обучающей выборки; обновленную модель проверяйте на более поздних нетронутых данных.
Статистически значимый тест неизвестного разрыва не определяет причину события и не доказывает прибыльность режима. Незначимый результат также не подтверждает стабильность. Обоснованный вывод ограничен заданной альтернативой с одним разрывом, усеченным диапазоном дат, регрессией, выборкой и методом вывода, учитывающим поиск.
Частые вопросы
Q1Тест Куандта—Эндрюса — это просто повторение теста Чоу для многих дат?
Для кандидатных дат рассчитываются родственные статистики, но вывод должен учитывать выбор максимума. Если сообщить наибольший обычный результат Чоу с p-значением для фиксированной даты, поиск будет проигнорирован и нулевое распределение обычно окажется неверным.
Q2Показывает ли дата максимума, когда экономическое событие вызвало разрыв?
Нет. Это кандидатная дата с наибольшей статистикой в выбранной выборке и усеченном диапазоне. Она не является причинной временной отметкой или доверительным интервалом; соседние даты и другие решения по дизайну могут дать похожие результаты.
Q3Означает ли отклонение, что произошел ровно один разрыв?
Нет. Оно отвергает заданную нулевую гипотезу о постоянных коэффициентах в пользу некоторой альтернативы с одним разрывом в диапазоне поиска. Несколько изменений, выбросы, сдвиги дисперсии или ошибка спецификации также могут указывать на нестабильность; оценка нескольких разрывов — отдельная задача.
Q4Можно ли сравнить максимум sup-Wald с обычной таблицей F?
Как правило, нет. Используйте критические значения или p-значения, соответствующие sup-статистике, trimming, числу ограничений, модели и предпосылкам о ковариации. Обычное F-распределение применимо при своих предпосылках к тесту заранее заданной даты, но не автоматически к максимуму поиска. Основные исследования - Quandt, “Tests of the Hypothesis That a Linear Regression System Obeys Two Separate Regimes” (1960) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point” (1993) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point: A Corrigendum” (2003) - Hansen, “Approximate Asymptotic P Values for Structural-Change Tests” (1997) - Andrews and Ploberger, “Optimal Tests When a Nuisance Parameter Is Present Only Under the Alternative” (1994) - Chow, “Tests of Equality Between Sets of Coefficients in Two Linear Regressions” (1960) - Bai and Perron, “Estimating and Testing Linear Models with Multiple Structural Changes” (1998) - Brown, Durbin, and Evans, “Techniques for Testing the Constancy of Regression Relationships over Time” (1975)
Источники и дополнительное чтение
Сообщить о проблеме
Мы подготовим письмо со ссылкой на эту статью. Mark получит сообщение только после отправки
Быстрая проверка
Прочитали руководство? Проверьте себя в 3 вопросах
Вопрос 01
Что делает тест sup-Wald Куандта—Эндрюса, если дата разрыва неизвестна?
Выберите ответ, чтобы увидеть объяснение
Словарь опционов
A model generating observations from finite discrete latent states with Markov transition probabilities and state-dependent emissions.
Читать подробное руководствооколо денегСостояние, при котором страйк опциона близок к рыночной цене базового актива. Внутренняя стоимость может быть малой или нулевой, но премия способна сохраняться из-за оставшегося времени и неопределённости.
Читать подробное руководство