

Тесты Бай—Перрона для множественных структурных сдвигов в регрессии
Узнайте, как методы Бай—Перрона ищут неизвестное число и даты регрессионных сдвигов, зачем нужны усечение выборки и критические значения и чего оценки сдвигов не доказывают.
В этом руководствеНа какой вопрос отвечает тест на множественные сдвиги в регрессии
Краткое резюме
Методы Бай—Перрона совместно оценивают даты структурных сдвигов в регрессии при заданном числе сдвигов, а затем используют тесты или критерии выбора модели, чтобы оценить, сколько сдвигов поддерживают данные. Число и даты зависят от регрессии, минимальной длины сегмента, предположений об ошибках и процедуры поиска; они не устанавливают причину или торговое преимущество.
На какой вопрос отвечает тест на множественные сдвиги в регрессии
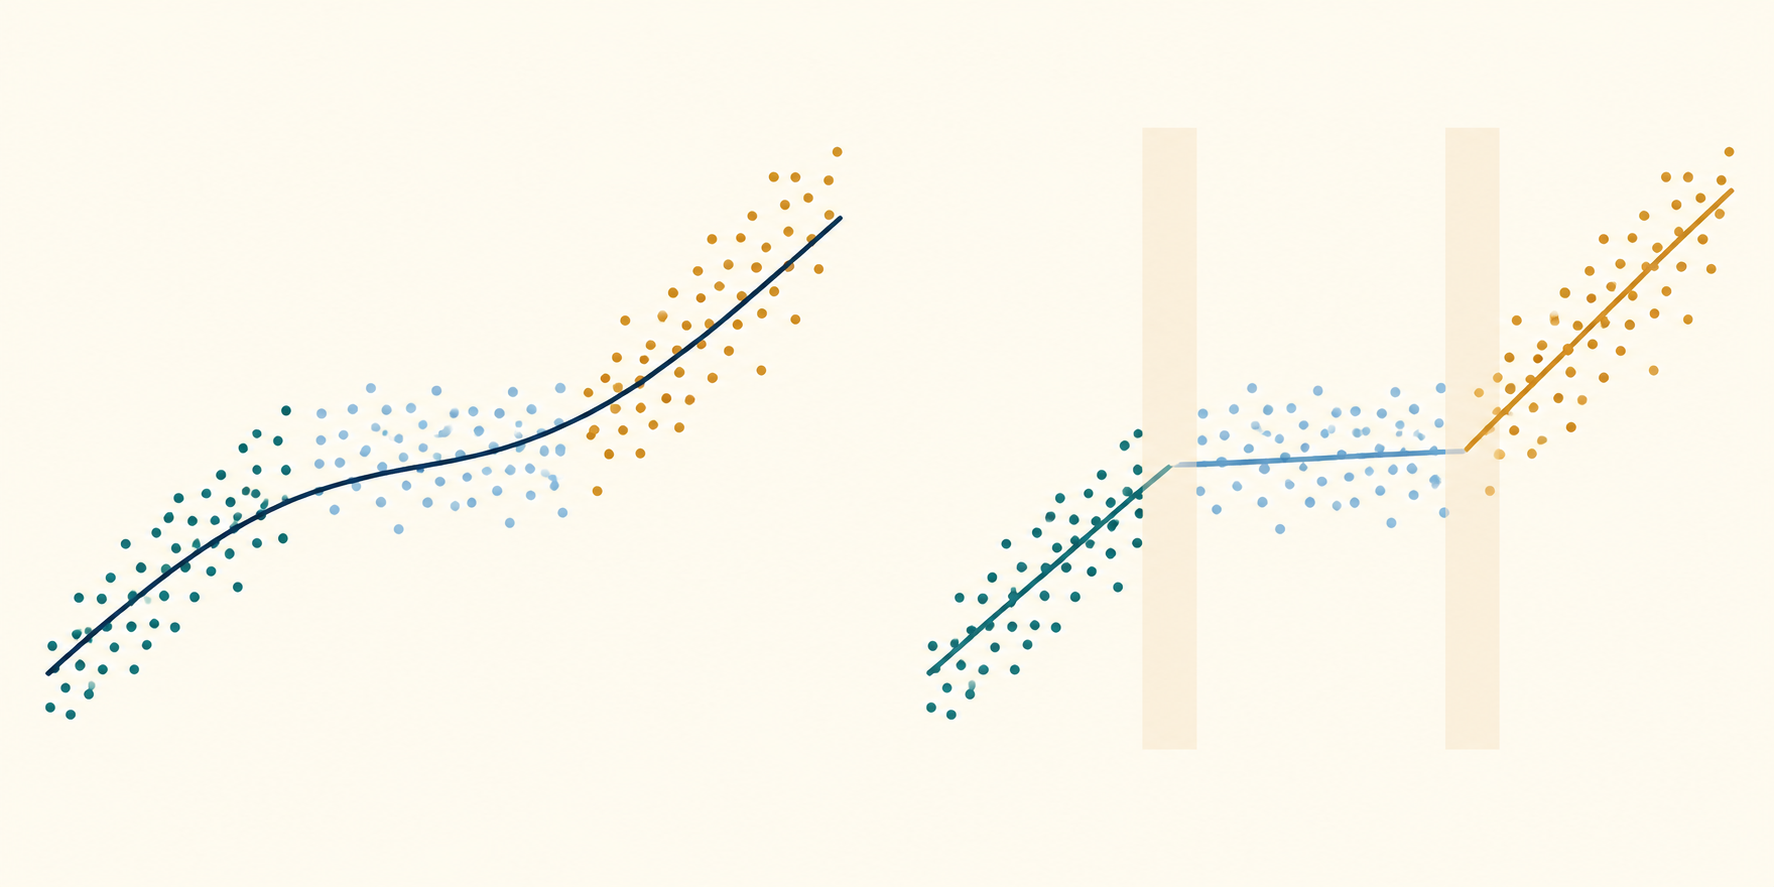
Структурный сдвиг в регрессии означает, что один или несколько коэффициентов могли измениться в неизвестный момент выборки. Одна оценка по всей выборке может скрыть это: если связь доходности с риском в одном периоде положительная, а позже ослабевает или меняет знак, средний коэффициент может плохо описывать оба периода. Процедуры Бай—Перрона превращают эту проблему в формализованный поиск разбиений наблюдений.
Главное отличие от теста Чоу состоит в том, была ли дата задана заранее. Тест Чоу сравнивает указанные подвыборки вокруг заданной даты; если перебрать много дат и сообщить наибольшую обычную статистику Чоу, стандартное референсное распределение теста уже не сохраняется. Тесты Бай—Перрона учитывают поиск среди возможных дат и могут оценивать более одного сдвига. Для случая с заранее заданной датой см. руководство по тесту Чоу.
Важно также отличать этот метод от регрессионного CUSUM. CUSUM анализирует упорядоченную траекторию рекурсивных остатков на предмет нестабильности, но сам по себе не выдает выбранный набор нескольких дат сдвига. Бай—Перрон, напротив, оценивает разбиение в рамках явно заданной кусочно-линейной регрессии. Ни один метод не объясняет, почему изменилась зависимость. Диагностику траектории остатков см. в руководстве по регрессионному CUSUM.
Запишите регрессию с неизвестными датами и числом сдвигов
Пусть имеется \(T\) наблюдений и \(m\) сдвигов в целочисленные даты \(T_1<\cdots<T_m\). Положим \(T_0=0\), \(T_{m+1}=T\), а сегмент \(j\) определим как наблюдения \(T_{j-1}+1,\ldots,T_j\). В модели с полным структурным изменением:
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Здесь \(y_t\) — результат, \(x_t\) — вектор включенных регрессоров, \(\beta_j\) — вектор коэффициентов сегмента \(j\), а \(u_t\) — ошибка. Неизвестны не только значения коэффициентов: если даты сдвигов и их число \(m\) не были зафиксированы дизайном, их также нужно оценить или выбрать. Модель предполагает и осмысленный порядок наблюдений, и постоянство вектора коэффициентов внутри сегмента при выбранной спецификации.
В финансовом примере \(y_t\) может быть доходностью портфеля, а \(x_t\) — включать доходность рынка, изменение ставки или показатель волатильности. Обнаруженный сдвиг означает, что выбранное кусочно-линейное условное среднее лучше подгоняет данные внутри выборки согласно процедуре. Он не означает, что конкретное событие изменило коэффициент, что переменная экзогенна или что зависимость сохранится вне выборки.
Полезно различать дату наблюдения и календарную дату. Если данные состоят из ежедневных торговых сессий, сдвиг между сессиями 120 и 121 не обязательно соответствует одному календарному дню рыночной динамики: на соответствие влияют праздники, пропущенные котировки и нерегулярная частота. До интерпретации сдвига как времени события укажите порядок выборки и способ представления даты.
Осознанно выберите полное или частичное изменение структуры
В модели с полным структурным изменением каждый коэффициент в \(\beta_j\) может меняться между сегментами. Это позволяет изменяться и константе, и всем наклонам, но требует больше сегментных параметров. Поэтому точная оценка сдвига может быть трудной при коротких сегментах или большом векторе регрессоров. Полное изменение подходит, только если исследовательский вопрос допускает перезапуск каждой моделируемой зависимости.
В модели с частичным структурным изменением некоторые коэффициенты остаются общими, а другие могут меняться. Например, запишем \(\beta_j=(\delta',\gamma_j')'\), где \(\delta\) общая для сегментов, а \(\gamma_j\) относится только к сегменту \(j\). Это может отражать содержательное ограничение: например, разрешить изменение константы и наклона воздействия политики, сохранив общий эффект контрольной переменной. Ограничение меняет и целевую функцию подгонки, и референсное распределение теста; его нужно явно указать, а не считать безвредным упрощением.
Различается и вычисление. При полном изменении RSS-критерий разбиения равен сумме RSS независимых сегментов, поэтому рекурсия динамического программирования может оптимизировать разбиение при фиксированном числе сдвигов. В частичной модели общие коэффициенты связывают все сегменты. Бай и Перрон описывают итеративную процедуру: попеременно оцениваются даты сдвигов и меняющиеся коэффициенты при фиксированных общих коэффициентах, затем общие коэффициенты обновляются при заданном разбиении. Простая рекурсия, складывающая сегментные RSS, сама по себе совместно не решает эту ограниченную задачу. Выбирайте спецификацию под научный вопрос или задачу прогнозирования, а не под вариант, который показывает больше сдвигов.
Заранее задайте минимальную длину сегмента
Для поиска сдвигов нужно установить минимальное число наблюдений в каждом сегменте. Правило усечения не дает подгонять очень короткие интервалы, где коэффициенты могут быть неустойчивыми, но одновременно исключает реальные изменения слишком близко к границе выборки или к соседнему сдвигу. Это часть дизайна, а не универсальный закон.
Рассмотрим явно гипотетическую выборку из \(T=240\) наблюдений с выбранной долей усечения 15%. Тогда минимальная длина сегмента равна \(h=0.15\times240=36\) наблюдениям. При одном сдвиге, если дата обозначает последнее наблюдение предыдущего сегмента, допустимы даты \(36\le T_1\le204\). В обеих частях будет не менее 36 наблюдений.
При двух сдвигах допустимые пары дат должны удовлетворять условиям:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Эквивалентно, \(T_1\le168\), а \(T_2\) должен оставлять 36 наблюдений после второго сдвига и находиться как минимум на 36 наблюдений дальше первого. Пара \((72,156)\) допустима: три сегмента содержат 72, 84 и 84 наблюдения. Пара \((80,100)\) недопустима, поскольку средний сегмент содержит только 20 наблюдений. При таком \(h\) в 240 наблюдениях может поместиться не более пяти сдвигов: шести сегментам требуется минимум \(6\times36=216\) наблюдений, а семи — \(7\times36=252\).
Доля 15% здесь — явно заданный гипотетический выбор дизайна, а не рекомендация по умолчанию. Более высокая доля может исключить короткие режимы и даты у границ выборки; более низкая допускает короткие сегменты, но может оставить слишком мало данных для надежной оценки наклонов и долгосрочных ковариационных величин. Выбирайте правило с учетом частоты данных, числа регрессоров, вероятной длительности режима и метода вывода. Укажите его и, если это содержательно оправдано, покажите чувствительность выводов к близким вариантам усечения. Реализации по-разному определяют эффективный размер выборки и границы при наличии лагов или пропусков, поэтому документируйте используемое соглашение.
Используйте динамическое программирование для глобального разбиения при фиксированном числе сдвигов
Для модели с полным изменением и фиксированным \(m\) поиск дат можно записать как минимизацию суммарного RSS сегментов:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
при условии порядка дат и минимальной длины сегмента. \(\operatorname{SSR}(a,b)\) — минимальная сумма квадратов остатков при подгонке одного сегмента на наблюдениях \(a,\ldots,b\). Наивный поиск проверяет все сочетания дат; их число быстро растет с \(T\) и \(m\).
Динамическое программирование повторно использует оптимальные подзадачи. Если \(D(r,j)\) — наименьшее RSS для разбиения наблюдений с 1 по \(j\) на \(r\) допустимых сегментов, одна из форм рекурсии имеет вид:
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
где разделитель \(i\) ограничен так, чтобы каждый из первых \(r-1\) сегментов и последний сегмент соблюдали минимальную длину. Сохранение минимизирующего разделителя на каждом шаге позволяет восстановить даты. Для каждого допустимого числа сегментов алгоритм получает глобально минимальное RSS-разбиение при заданных модели и ограничениях, а не добавляет сдвиги по одному жадным способом. Бай и Перрон (2003) разрабатывают вычисления и обсуждают полное и частичное изменение.
«Глобальный» здесь означает условный на выбранном числе сдвигов, регрессорах, детерминированных членах, усечении и целевой функции. Это не означает, что статистическая модель верна, число сдвигов правильно или разбиение глобально оптимально среди всех возможных спецификаций. Процедура может эффективно сравнить несколько значений, но выбор \(m\) — отдельный этап вывода или отбора модели.
Выберите число сдвигов с поправкой на поиск или по критериям
После вычисления лучших разбиений для кандидатных чисел выбрать \(m\) помогают несколько подходов. Последовательный тест \(\sup F(\ell+1\mid\ell)\) сравнивает модель с \(\ell\) сдвигами и модель еще с одним сдвигом, используя супремум статистики по допустимым датам. Тесты double-maximum, например UDmax или WDmax, проверяют отсутствие сдвигов против альтернативы с неизвестным числом сдвигов до заданного максимума. Информационные критерии, в том числе варианты BIC, сопоставляют улучшение подгонки со штрафом за сложность. Эти методы отвечают на связанные, но не одинаковые вопросы.
Обычное критическое значение F, как правило, неприменимо после максимизации по неизвестным датам сдвига. При нулевой гипотезе об отсутствии сдвига кандидатные даты идентифицируются иначе, чем при альтернативе, что приводит к нестандартным асимптотическим распределениям. Критические значения зависят от усечения, полного или частичного изменения, регрессоров и предположений о ковариации ошибок. Бай и Перрон (1998) выводят тесты для множественных изменений; их последующая работа по критическим значениям приводит таблицы для разных вариантов усечения и модели. Andrews (1993) дает важные результаты для тестов нестабильности с одной неизвестной точкой изменения, но его критические значения не заменяют процедуру для нескольких сдвигов.
Последовательные тесты понятны, однако результат может зависеть от мощности на каждом шаге и заранее заданного максимального числа сдвигов. Информационные критерии могут выбирать разные значения из-за различных штрафов и потому, что все кандидатные модели могут быть приближениями. Больше сдвигов не обязательно означает более реалистичное описание: небольшой выигрыш подгонки может сопровождаться нестабильными сегментными коэффициентами. Укажите метод, максимальное число, усечение, последовательность тестов или критерий и соответствующие предположения для критических значений. Если выбор важен, покажите чувствительность, а не представляйте одно значение как достоверное.
Считайте оцененные даты условными и неопределенными
Даты, минимизирующие RSS, — точечные оценки в рамках заданной модели. Не следует сообщать их так, будто данные выявили точный момент изменения экономической зависимости. Выборочная вариация, небольшой сдвиг коэффициента, близкие переломы, шумные результаты, малая вариация регрессоров и длинный минимальный сегмент могут сделать целевую функцию относительно плоской около минимума. Несколько соседних разбиений могут подходить почти одинаково хорошо.
Бай и Перрон разрабатывают доверительные интервалы для дат сдвига при оговоренных условиях. Эти интервалы описывают выборочную неопределенность дат, заданных в модели; они не охватывают всю неопределенность в корректности регрессии, составе переменных, числе сдвигов или правиле усечения. Если неопределенно и само число сдвигов, узкий интервал даты при условии одного выбранного числа может занижать общую неопределенность.
В практическом отчете различайте соглашение о дате, оцененный индекс наблюдения, преобразованную календарную дату и интервал для каждого сдвига. При широких или пересекающихся интервалах укажите, что локализация по времени неточная. Не выбирайте дату на графике после просмотра результата, а затем не называйте ее независимым прогнозом события. При сопоставлении оцененных сдвигов с известным событием учитывайте, что событие и окно могли быть выбраны после просмотра данных.
Согласуйте выводы с серийной зависимостью и изменением дисперсии
Разбиение по RSS — критерий подгонки; корректность тестов и доверительных интервалов зависит от предположений о регрессорах и ошибках. В финансовых регрессиях часто встречаются серийная корреляция, условная гетероскедастичность, выбросы, меняющаяся волатильность, перекрывающиеся доходности или асинхронные наблюдения. Если оценка ковариации и критические значения предполагают независимые ошибки с одинаковой дисперсией, а остатки зависимы или гетероскедастичны, заявленная значимость может вводить в заблуждение даже при правдоподобных оцененных датах сдвига.
Работы Бай—Перрона разрабатывают процедуры при более широких условиях, включая некоторые формы гетероскедастичности и серийной зависимости, однако аналитик должен использовать поправку ковариации и референсные значения, соответствующие фактической постановке. Робастная оценка ковариации или HAC не исправляет пропущенную динамику, эндогенный регрессор, неверное условное среднее или календарь наблюдений с несовместимыми интервалами. И сама по себе робастная стандартная ошибка не превращает критерий RSS в более подходящую модель данных.
Проверьте зависимость остатков и их дисперсионные закономерности внутри и между кандидатными сегментами. Укажите, допускают ли предположения об ошибках сегментные дисперсии, серийную корреляцию или изменение распределений регрессоров, и охватывает ли это теория выбранного теста. В очень коротких сегментах робастную ковариацию оценивать особенно трудно, что также требует совместного планирования усечения и размерности модели. О предположениях регрессионных оценок и ковариации см. руководство по регрессии OLS.
Сообщайте о сдвигах без причинных или торговых заявлений
Воспроизводимый отчет указывает результат, все регрессоры, преобразования, период и частоту выборки, ограничения константы и коэффициентов, спецификацию полного или частичного изменения, максимальное кандидатное \(m\), долю усечения и минимальную длину, соглашение о дате, метод оптимизации и тест или критерий выбора \(m\). Включите выбранное число сдвигов, коэффициенты по сегментам, даты и интервалы неопределенности, тестовые статистики, способ учета ковариации и источник критических значений. Объясните конечные точки или наблюдения, исключенные из поиска.
Статистически обнаруженный сдвиг свидетельствует о нестабильности параметров в указанной регрессии при ее предположениях. Он не устанавливает, какое событие вызвало изменение, не доказывает ответственность конкретного сообщения или изменения политики и не показывает, что коэффициенты до и после сдвига сохранятся. Сдвиг может отражать пропущенную переменную, изменение определения данных, эпизод волатильности, проблему измерения или реальное изменение экономики; одна регрессионная процедура не различает эти объяснения.
В количественной торговле поиск на полной выборке использует наблюдения по обе стороны каждого оцененного сдвига. Торговля так, будто выбранная дата была известна в реальном времени, создает смещение заглядывания вперед. Проверяйте правило режимов хронологически, переоценивайте его только на информации, доступной к каждой дате, и учитывайте спред, комиссии, рыночное воздействие, финансирование, стоимость займа, оборот и задержку. Сравните простые базовые варианты с постоянными параметрами и без сделок, а действительно более поздние данные оставьте для проверки. Сдвиг может стать поводом пересмотреть модель или риск, но не доказывает прогнозную способность или инвестируемое преимущество.
Бай и Перрон (1998) представляют тесты и оценивание множественных структурных изменений в линейных моделях в оригинальной статье. Их статья о вычислениях 2003 года объясняет динамическое программирование и процедуры частичного изменения, а статья о критических значениях показывает, как значения зависят от дизайна. Работа Andrews о неизвестной точке изменения дает близкую основу для одного сдвига. Для смежной диагностики сравните тест Чоу с заранее заданной датой и тест CUSUM для регрессии.
Частые вопросы
Q1Показывает ли Бай—Перрон истинное число сдвигов?
Нет. Метод оценивает разбиения и предоставляет тесты или критерии для выбора среди кандидатных чисел. Результат зависит от спецификации регрессии, усечения, предположений об ошибках, максимального числа и правила выбора; он не гарантирует, что в процессе генерации данных было ровно столько сдвигов.
Q2Является ли дата сдвига датой, когда экономическое событие вызвало изменение?
Нет. Это оцененное положение нестабильности параметров в подогнанной модели с выборочной неопределенностью. Для связи с причиной нужны дополнительные данные и дизайн, исключающий альтернативные объяснения.
Q3Можно ли торговать непосредственно по оцененным датам сдвигов?
Не только на основе ретроспективной оценки по всей выборке. Поиск даты использует полную выборку, включая наблюдения после кандидатного сдвига. Для правила реального времени нужны хронологическая оценка, информация, доступная тогда, учет затрат и проверка на более поздних данных; обнаруженный сдвиг не доказывает прибыльный сигнал.
Источники и дополнительное чтение
Сообщить о проблеме
Мы подготовим письмо со ссылкой на эту статью. Mark получит сообщение только после отправки
Быстрая проверка
Прочитали руководство? Проверьте себя в 3 вопросах
Вопрос 01
Что означает правило минимального сегмента 15% в примере с 240 наблюдениями?
Выберите ответ, чтобы увидеть объяснение
Словарь опционов
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Читать подробное руководствоMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Читать подробное руководство