

すべてのオプションガイド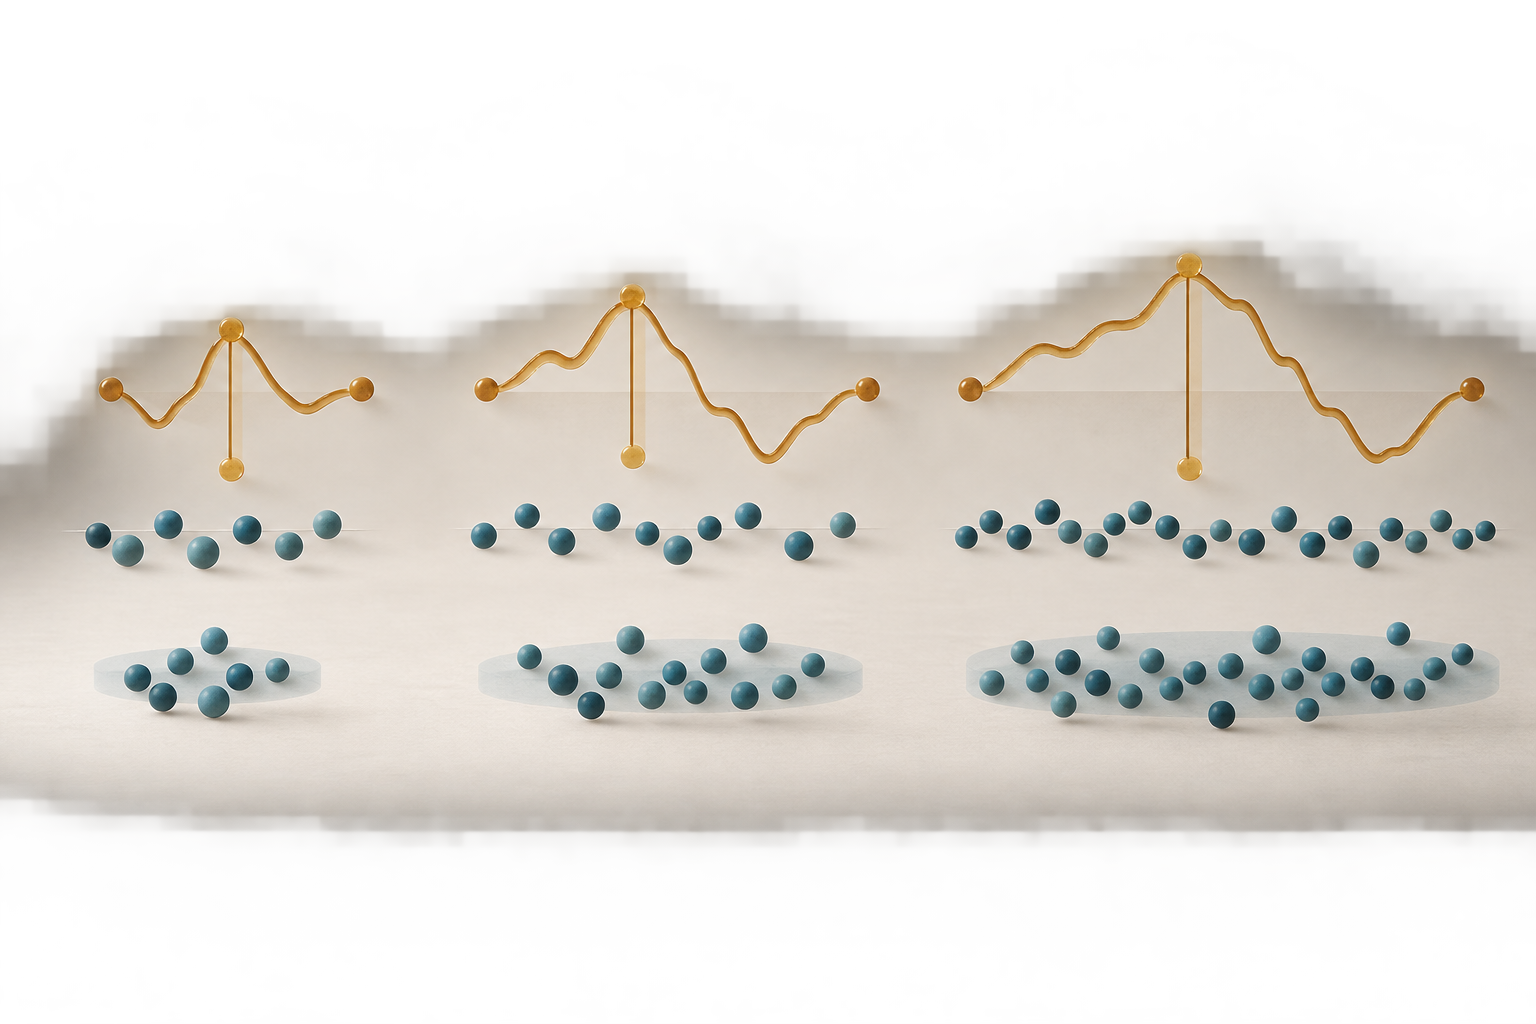
複数のスケールでR/S分析を繰り返す概念図です。各窓の平均を引き、偏差を累積し、その範囲を窓内のばらつきと比べます。模式図であり、市場データ、推定H、予測、売買シグナルを示すものではありません
問題 1 / 3
時間軸を変えたときの依存性のスケーリングを要約する統計量16分で読めます
ハースト指数とR/S分析:長期記憶の推定とトレード上の限界
再スケーリングレンジ分析でハースト指数を推定する方法を学び、架空データで計算を確認し、持続性が利益につながる売買シグナルとは限らない理由を解説します。
このガイドの内容ハースト指数が表すのはスケーリングであり、次の価格変動ではありません
短い要約
ハースト指数は、観測窓を長くしたときに再スケーリングレンジなどの統計量がどの程度の速さで増えるかを要約します。特定のスケーリングモデルの下では、0.5を超える値は増分の持続性と、0.5を下回る値は反持続性と整合します。ただし、推定値だけで価格が予測可能であること、戦略が利益を生むこと、測定されたパターンが真の長期記憶であることは証明できません。
ハースト指数が表すのはスケーリングであり、次の価格変動ではありません
ハースト指数 \(H\) は、時間スケールとそのスケールで測定した変動の大きさとの関係を表す傾きです。再スケーリングレンジ分析では、累積偏差のレンジを系列の標準偏差で割ります。ブロック長 \(n\) に対して平均比率が概ね \(n^H\) の速さで増えるなら、対数同士の関係の傾きが \(H\) の推定値になります。この係数は、変動する河川流量を管理するために貯水池がどれだけの貯蔵容量を必要とするかを調べた H. E. Hurst の研究に由来し、売買指標として作られたものではありません。Hurst の原著 “Long-Term Storage Capacity of Reservoirs” では、年次流量の平均からの累積偏差を使ってレンジを計算しています。
「持続的」「反持続的」「ランダムに近い」といった解釈は、対象の過程とスケーリングに関する仮定に依存します。一般的な定常増分のベンチマークでは、\(H=0.5\) は時間の平方根に比例するスケーリングに対応し、\(H>0.5\) は正の持続性、\(H<0.5\) は反持続性と関連します。これらの表現が示すのは、分析したスケールにおける系列の依存性であり、次のリターンが特定の符号になる確率ではありません。
入力する系列を変えると、調べている問いも変わります。リターン、絶対リターン、二乗リターン、価格水準、累積リターンに同じ方法を適用しても、互換性のある答えは得られません。方向の依存性がほとんどないリターン系列でも、絶対リターンには持続的なボラティリティ・クラスタリングが見られることがあります。トレンドを含む価格水準や積分系列では、定常リターンにおける長期記憶とは異なる理由でスケーリングが現れる場合があります。\(H\) を報告する際は、変数、サンプリング間隔、対象にしたスケール範囲を明記してください。
R/S分析では各ブロックをスケール統計量に変換します
\(n\) 個の観測値 \(x_1,\ldots,x_n\) からなるブロックを考えます。まずブロック平均 \(\bar{x}_n\) を計算し、各観測値からその平均を引いて、中心化した値を累積します。
\[ Y_{k,n}=\sum_{t=1}^{k}(x_t-\bar{x}_n), \qquad k=1,\ldots,n. \]
中心化した観測値の合計はブロック末尾でゼロになりますが、累積経路は途中で上下します。レンジは累積値の最大値から最小値を引いて求めます。
\[ R_n=\max_{1\leq k\leq n}Y_{k,n}-\min_{1\leq k\leq n}Y_{k,n}. \]
明示した規約に従ってブロック標準偏差を計算します。ここでは分母に \(n\) を使います。
\[ S_n=\sqrt{\frac{1}{n}\sum_{t=1}^{n}(x_t-\bar{x}_n)^2}, \qquad Q_n=\frac{R_n}{S_n}. \]
比率 \(Q_n\) は、累積レンジをブロック内の通常の変動と同じ単位で表します。一定値だけのブロックでは \(S_n=0\) となり、比率は定義できません。これを暗黙にゼロの寄与として扱ってはいけません。実務では記録を選んだ長さのブロックに分割し、有効な各ブロックの比率を計算して平均します。あらかじめ定めた複数のブロック長について同じ計算を繰り返します。Mandelbrot と Wallis は、1969年の論文で多様なシミュレーション分布や依存パターンのもとでR/Sの挙動を調べました。この研究によってR/Sは広く使われるスケーリング診断になりましたが、あらゆるモデル誤指定に対して頑健な手法になったわけではありません。
選んだスケール上で平均ブロック統計量が \(\overline{Q}_n\approx Cn^H\) に従うなら、対数を取ります。
\[ \log \overline{Q}_n=\log C+H\log n+\varepsilon_n. \]
\(\log \overline{Q}_n\) を \(\log n\) に対して回帰した傾きが指数の推定値です。狭い範囲や結果を見て選んだ区間で直線に見えても、それだけでは弱い証拠です。多くの有限標本は数個のスケールでは直線状に見えますし、同じ記録の別の区間では異なる傾きになることもあります。
小さな架空データで計算を確認します
基点は任意のベーシスポイント単位として、架空のリターンを8個 \(3,1,0,-1,2,0,-2,-3\) とします。全標本の平均はゼロです。各ブロック長で連続する重複しないブロックに分け、それぞれの \(R_n/S_n\) を計算して平均します。この例では母標準偏差に相当する分母 \(n\) を使います。別の規約を使えば数値は少し変わります。
\(n=2\) では各ペアのレンジと標準偏差の比が1なので、平均も1です。\(n=4\) では2つのブロックの \((R,S)\) はそれぞれ約 \((2.500,1.479)\)、\((3.500,1.920)\) です。各比率は約1.690と1.823で、平均は約1.756になります。\(n=8\) での中心化累積経路は \(3,4,4,3,5,5,3,0\) なので、レンジは5です。標準偏差は \(\sqrt{3.5}\approx1.871\)、比率は約2.673です。
| ブロック長 \(n\) | 平均 \(R/S\) |
|---|---|
| 2 | 1.000 |
| 4 | 1.756 |
| 8 | 2.673 |
この3点は対数スケール上で等間隔なので、通常の最小二乗傾きは両端を結ぶ傾きになります。
\[ \widehat{H}=\frac{\log(2.673)-\log(1.000)}{\log(8)-\log(2)}\approx0.709. \]
これは作り物の8個の値を使った再現可能な計算であり、長期記憶の信頼できる証拠ではありません。推定値は個々の観測値に大きく左右され、スケールは3つだけで、不確実性区間もありません。系列に構造変化が含まれる場合や、望ましい傾きが得られるスケールを後から選んだ場合は、観測数を増やすだけでは問題は解決しません。
<!-- 図の配置:この節の後。短いブロックと長いブロックで中心化した観測値が累積してレンジを作り、そのレンジがブロック内の標準偏差より速く増える様子を文字なしで概念的に示す。軸、ラベル、数値の主張は含めない。 -->
0.5前後の値はモデルと不確実性を踏まえて読みます
有限分散と短期依存を持つ定常系列では、多くの一般的な長期スケーリングの結果で指数は0.5前後になります。fractional Gaussian noise型のモデルでは、\(H>0.5\) は正の長期依存と整合します。ベンチマークよりも同じ符号の偏差が続きやすく、相関がゆっくり減衰するという意味です。0.5未満の指数は反持続性と関連し、反転や符号が逆の依存性がスケーリングの振る舞いに優勢となります。
「モデルのもとで」という条件が重要です。通常のR/Sの傾きは推定値であり、唯一の経済的メカニズムを直接検定するものではありません。小標本のバイアスによって0.5から離れることがあり、重複ブロック、分母の規約、スケールの端点、自己相関も結果に影響します。信頼区間に0.5が含まれても独立性は証明されません。反対に0.5が区間外でも、安定した長期記憶モデルが観測値を生んだと証明されたわけではありません。
\(H=0.7\) を「トレンド継続の確率が70%」「リターンが70日続く」「勝率が70%」などと読み替えないでください。\(H\) は確率や保有期間を表す値ではなく、推定したスケーリング関係を記述します。依存性の統計的証拠を主張するなら、モデルと不確実性の評価に加え、短期相関、条件付き不均一分散、決定論的トレンド、レジーム変化といった代替説明も確認する必要があります。
短期自己相関とボラティリティ・クラスタリングが持続性に見えることがあります
古典的R/Sは真の長期依存だけに反応するわけではありません。短期間のARパターンは同じ符号の偏差を近くに保ち、累積レンジを大きくすることがあります。Loは短期の系列相関が古典統計量に上方バイアスを与え、短期記憶の過程が持続的に見える場合があることを示しました。Loの修正R/Sは短期依存を考慮して長期記憶を検定するために設計されました。調べた株式リターン指数では短期自己相関を考慮すると長期記憶の証拠がなくなりましたが、これはその標本と検定の結果であり、あらゆる資産や後の期間に対する結論ではありません。Loの1991年の論文を参照してください。
ボラティリティ・クラスタリングは別の落とし穴です。リターンの符号は交互に変わっても、リターンの大きさはまとまって現れることがあります。リターンにR/Sを適用すると符号付き累積偏差を調べ、絶対リターンや二乗リターンに適用すると大きさの持続性を調べます。\(|r_t|\) の推定値が高くても、価格の方向を予測できるとは限らず、リスクのまとまりを表している場合があります。条件付き分散依存性の別の診断にはARCH LM検定のガイドを参照してください。分散比検定のガイドでは、異なる期間におけるリターン依存性を別の形で要約します。
裾の厚い分布や外れ値も重要です。Mandelbrot と Wallis は多くの非ガウス・シミュレーションで有用な頑健性を示しましたが、極端な変動、ボラティリティ体制の変化、誤った平均の指定が無害になるわけではありません。適切な分析では、選んだ元の系列の結果を報告し、妥当な別の設定で結果がどう変わるかを調べます。指数が見慣れた値になるまで都合の悪い観測値を除くべきではありません。
トレンド、構造変化、スケールの選択が偽の長期記憶を作ることがあります
各ブロックからブロック平均を引くと一定の水準は除去できますが、すべての決定論的パターンや変化するパターンが消えるわけではありません。緩やかなトレンド、単発の水準シフト、標本構成の変更、ボラティリティの構造変化は長い累積的な動きを作ります。その結果、安定した長期記憶の仕組みがない系列でも、当てはめた対数関係がべき乗則のように見えることがあります。構造変化検定や区分回帰は別の問いに答える手法です。中断時系列回帰のガイドを参照してください。
スケールの選択はモデルの一部です。非常に短いブロックは主に局所ノイズや市場のマイクロストラクチャーを反映し、非常に長いブロックでは使える区間が少なくなります。重複窓を使えば計算する比率は増えますが、独立した情報が同じだけ増えるわけではありません。短いスケールと長いスケールで異なる傾きを示すクロスオーバーは、異なるダイナミクス、構造変化、季節性、または推定ノイズを示している可能性があります。説明なしに一つの \(H\) にまとめるべきではありません。
入力が価格、対数価格、リターン、絶対リターン、フィルター後の残差のどれか、またブロックが重複するかを明確にしてください。結果を解釈する前にブロック範囲と最小ブロック数を決め、各スケールの観測数を報告し、妥当な端点を変えた感度も示してください。価格が積分過程なら、定常リターンに対する通常の解釈はそのまま当てはまりません。デトレンドは万能の解決策ではなく、測定対象を変え、不要なトレンドとともに経済的に意味のある変動も取り除く可能性があります。
Loの修正R/Sは分母に長期分散の推定値を使います
Loの修正では、中心化した累積偏差のレンジを保ちながら、通常のブロック標準偏差を、短いラグの自己共分散を含む長期分散の推定値に置き換えます。一般的な表記の一つは次のとおりです。
\[ Q_n^{\mathrm{Lo}}(q)=\frac{R_n}{\widehat{\sigma}_n(q)},\qquad \widehat{\sigma}_n^2(q)=\widehat{\gamma}_0+ 2\sum_{j=1}^{q}\left(1-\frac{j}{q+1}\right)\widehat{\gamma}_j. \]
ここで \(\widehat{\gamma}_j\) はラグ \(j\) の標本自己共分散、\(q\) は打ち切り帯域幅です。三角形の重みは打ち切り点に近い自己共分散ほど小さく扱います。修正統計量は適切な帰無分布と比較します。これは分母だけを見栄えよくした古典的R/S推定ではなく、その値が自動的に補正済みの \(H\) になるわけでもありません。
帯域幅によって分散推定に含める短期相関が変わります。\(q\) が小さすぎると必要な短期依存を取りこぼし、大きすぎると推定がノイジーになり、区別したいパターンまで吸収することがあります。帯域幅のルール、標本頻度、検定統計量、帰無仮説、p値を報告し、事前に定めた範囲で感度を調べてください。Loの論文はこの違いが重要な理由を示しています。古典的R/Sは短期記憶にも反応し得ますが、修正検定は弱い短期依存を許す、より広い帰無仮説を対象にします。
DFAと周波数領域の推定では異なる変換を使います
Detrended fluctuation analysis(DFA)は、平均を中心化した観測値から積分プロファイルを作り、これを窓に分割します。各窓内で局所多項式を当てはめ、残差の変動の二乗平均平方根 \(F(s)\) を窓幅 \(s\) ごとに計算します。\(\log F(s)\) を \(\log s\) に回帰してスケーリング傾きを推定します。局所当てはめは指定した多項式トレンドへの感度を下げる場合がありますが、デトレンドの次数、窓長、系列の種類は依然として重要です。DFAも構造変化、ボラティリティ変化、グラフを見てから選んだスケール範囲の影響を免れません。
周波数領域の手法はピリオドグラムから低周波の挙動を推定します。特定の定常長期記憶モデルで、ゼロ周波数付近のスペクトルパワーが \(f(\lambda)\propto|\lambda|^{-\beta}\) に従うなら、fractional-noise型のリターン系列では \(H=(\beta+1)/2\) です。低周波帯域によって傾きの推定に含まれる観測値が変わり、季節性のピーク、構造変化、少数の低周波点が結果を左右することがあります。スペクトルのパラメータと \(H\) の関係は、入力が定常増分系列か積分された水準かによって異なります。
これらは有限標本で異なる挙動を示す代替推定法であり、3つの独立した確認が得られるという意味ではありません。Weron の有限標本比較(DOI 10.1016/S0378-4371(02)00961-5)は、シミュレーションによるガウス白色雑音を使ってR/S、DFA、ピリオドグラム回帰を比較し、推定値と信頼区間が手法や標本長によって異なることを示しました。この結果は金融データでDFAが常に最良だと示すものではありません。実際の手順とデータ生成条件に合わせて推論を評価する必要性を示しています。
トレード仮説にはコスト控除後のアウトオブサンプル証拠が必要です
推定した指数は、過去のスケーリングパターンを説明したり、明確な仮説を立てたりするのに役立ちます。しかし、エントリーとエグジットのルール、予測のタイミング、ポジションサイズ、リスク上限や、関係性が知られた後も続く理由は示しません。直近の \(H\) 推定値がリターンを予測するかを検証するなら、予測期間と判断時点を評価前に固定し、各入力値がその時点で利用可能だったことを確認します。
高い \(H\) が出るまで窓長、ブロックサイズ、資産、リターン変換、デトレンド次数、閾値を多数試す行為は多重検定です。見かけ上の勝者は評価に使った同じデータから選ばれています。探索全体を研究記録に含め、未使用データまたは適切な前進型評価を使い、候補を検索したことを調整に反映してください。バックテスト過剰適合確率のガイドとWhiteのReality Checkのガイドでは関連する選択問題を扱っています。
統計的な関連がコスト控除後の売買優位性を意味するわけではありません。ビッド・アスク・スプレッド、手数料、スリッページ、市場インパクト、資金調達費用、借株コスト、売買回転率を差し引いて評価してください。持続的なボラティリティは、リターン方向の予測力を高めずにリスクやドローダウンを増やす場合があります。推定の不確実性を報告し、短期記憶や構造変化を含む別の説明と比較し、最終テスト前にルールを固定して、過去の診断結果と戦略の成績を区別してください。
リサンプリングが役立つのは、その設計が調べる依存性に合っている場合だけです。各リターンを独立に抽出するiidブートストラップでは時系列の順序が失われます。ブロック・ブートストラップは選んだブロック内の局所的な連続性を保ちますが、短いブロックでは遅い依存を捉えにくく、長いブロックでは実質的に異なる区間が少なくなります。どちらも構造変化を消すものではありません。データからスケール、窓、資産を選んだ場合、探索調整済みの不確実性を求めるには各再標本化の中で選択手順を繰り返します。最後に選んだ指数だけを再標本化すると、探索によって増えた不確実性を過小評価します。
よくある質問
Q1ハースト指数が0.5を超えるとはどういう意味ですか?
一般的な定常増分スケーリングモデルでは、分析したスケールの系列に持続的な依存があることと整合する場合があります。価格上昇の確率が50%や70%という意味でも、利益につながるシグナルの証明でもありません。
Q2R/S分析とLoの修正R/S検定は同じですか?
いいえ。古典的R/Sは累積偏差のレンジをブロック内の通常の変動で割ります。Loの修正統計量は、短いラグの自己共分散を重み付けして含めた長期分散推定値を使い、短期依存を許容する帰無仮説の下で検定します。
Q3ハースト指数を使って売買戦略を選べますか?
研究仮説のきっかけにはできますが、指数だけではエントリー、エグジット、ポジションサイズのルールは決まりません。戦略を提案するなら、事前に固定した仕様、不確実性と代替モデルの確認、アウトオブサンプル評価、現実的な執行コストが必要です。
出典
問題を報告
この記事のリンクを含むメールを準備します。送信すると Mark に報告が届きます
クイックチェック
記事を読み終えたら、3問で確認しましょう
問題 01
log R/Sをlogブロック長に回帰した傾きが推定するのは何ですか?
答えを選ぶと解説を確認できます
オプション用語集
関連ガイド
金融時系列の診断ARCH LM検定とは?金融モデル残差のボラティリティ・クラスタリングを診断ARCH LM検定で残差の二乗にラグ依存があるかを調べる方法、次数qの選び方、検定結果から言えることと言えないことを解説します。リターン分散が時間とともにどう増えるかを検定する分散比検定:ランダムウォーク、期間と取引分散比が1期間と複数期間のリターンをどう比較するか、1を上回る・下回る値が何を示唆するか、なぜ取引の優位性を証明しないかを解説します。すでに動いていた経路から介入を分ける中断時系列と分割回帰中断時系列が水準変化と傾き変化を推定する仕組み、基準トレンドと自己相関の重要性、対照系列が金融イベント分析を強める条件を解説します。バックテスト首位が候補群の中央値を下回る頻度バックテスト過剰適合確率(PBO)とCSCVの解説組合せ対称交差検証がPBOを推定する仕組み、OOS順位をlogitに変換する方法、将来の損失予測とは異なる理由を解説します戦略探索の勝者を候補群全体の観点から検定する理由White’s Reality Checkで戦略バックテストのデータスヌーピングを検証するWhite’s Reality Checkが探索で選ばれた最良の戦略をベンチマークと比較し、依存性を考慮したbootstrapの最大値で選択バイアスを調整する方法を解説します