

Volatilità realizzata con pre-averaging: uno stimatore per il rumore di microstruttura
Scopri come il pre-averaging smussa brevi finestre di rendimenti ad alta frequenza, corregge l’effetto principale del rumore, sceglie la lunghezza della finestra e si distingue da TSRV e realized kernel.
In questa guidaPerché rendimenti molto frequenti possono distorcere la variazione dei prezzi
Breve sintesi
Il pre-averaging stima le variazioni di prezzo quando i prezzi registrati molto frequentemente contengono rumore di microstruttura. Invece di elevare al quadrato ogni rendimento grezzo, forma somme ponderate e sovrapposte di rendimenti vicini, le eleva al quadrato e sottrae un termine relativo alla componente principale del rumore. Il risultato dipende dalla forma dei pesi, dalla lunghezza della finestra, dal disegno di campionamento e dalle ipotesi sul rumore. Misura la variazione nell’intervallo osservato; non è una previsione di volatilità né un segnale operativo.
Perché rendimenti molto frequenti possono distorcere la variazione dei prezzi
Se il prezzo osservato coincidesse con il prezzo efficiente, sommare i rendimenti intraday al quadrato sarebbe un modo naturale per stimare la variazione durante la sessione. Tuttavia, i prezzi di transazione e le quotazioni possono risentire dell’alternanza tra bid e ask, dell’arrotondamento alla dimensione minima del tick, della latenza, della discrezione dei prezzi o delle convenzioni di registrazione. Quando l’intervallo di campionamento è estremamente breve, questi effetti possono rappresentare una quota rilevante di ogni rendimento al quadrato. Aggiungere osservazioni può quindi aumentare il contributo del rumore invece di rivelare soltanto più movimento del prezzo latente.
Il pre-averaging affronta il problema combinando i rendimenti in una breve finestra locale prima di elevarli al quadrato. Una funzione di peso regolare parte da zero, attribuisce peso ai rendimenti vicini e torna a zero al bordo della finestra. La somma ponderata agisce come un filtro locale: gli errori di osservazione rapidi e indipendenti possono compensarsi in parte, mentre può rimanere il movimento più ampio del prezzo efficiente. Le finestre sovrapposte consentono di usare le informazioni lungo tutto l’intervallo.
La sola levigazione non rende uno stimatore non distorto. Anche i rendimenti filtrati al quadrato contengono una componente di variazione dovuta al rumore, perciò serve un termine di correzione. Jacod, Li, Mykland, Podolskij e Vetter derivano un approccio di pre-averaging per stimare la volatilità integrata sotto ipotesi esplicite e mostrano che versioni appropriate raggiungono un tasso di convergenza \(n^{-1/4}\). Il loro articolo originale fonda il metodo; questa guida ne spiega meccanica, scelte e limiti.
Distinguere prezzo latente, prezzo osservato e obiettivo
Indichiamo con \(X_{t_i}\) il logaritmo del prezzo efficiente latente all’istante di osservazione \(t_i\), e con \(Y_{t_i}\) il logaritmo del prezzo registrato:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
dove \(\epsilon_{t_i}\) rappresenta il rumore di osservazione. Un modello di base comune tratta \(X_t\) come una semimartingala continua con tasso di varianza locale \(\sigma_t^2\). L’obiettivo su un intervallo fisso \([0,T]\) è la varianza integrata:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Il rendimento osservato si scompone in \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Anche se gli errori di prezzo sono indipendenti tra le osservazioni, due rendimenti adiacenti condividono l’errore di un estremo con segni opposti. Questo crea dipendenza seriale nei rendimenti e rende la varianza realizzata calcolata su tutte le osservazioni sensibile al numero di differenze rumorose.
La spiegazione teorica più semplice spesso assume rumore a media zero, indipendente nel tempo e dal processo del prezzo efficiente, con momenti finiti adeguati. Queste ipotesi aiutano a capire la correzione, ma non sono garantite per transazioni, quotazioni o prezzi medi. Il rumore può variare con la liquidità e l’ora del giorno, dipendere dal prezzo efficiente o avere dipendenza seriale. Anche l’obiettivo va specificato: in presenza di salti, la variazione quadratica include i loro quadrati, mentre la varianza integrata continua no.
È una misura ex post per una serie di prezzi e un intervallo definiti. Non ricostruisce ogni prezzo latente, non individua la singola stampa errata e non indica quale sarà la volatilità futura. Prima di confrontare le stime, specifica se l’input usa prezzi di transazione, mid-quote o un’altra costruzione.
Costruire rendimenti pre-averaged sovrapposti
Per \(n\) rendimenti osservati \(r_i=Y_{t_i}-Y_{t_{i-1}}\), si scelgono una lunghezza intera della finestra \(k_n\) e una funzione di peso \(g\) su \([0,1]\). Una definizione comune di rendimento pre-averaged è
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Di norma la funzione è continua, vale zero a entrambi gli estremi e soddisfa la regolarità richiesta dai risultati asintotici. Un esempio triangolare è \(g(u)=\min(u,1-u)\). Poiché i pesi sono nulli ai bordi della finestra, il rendimento all’estremo non riceve improvvisamente il peso massimo. È una forma di pesatura locale, non una previsione né un trend stimato.
Ogni \(\bar r_i\) aggrega rendimenti adiacenti prima che vengano elevati al quadrato. Poiché le finestre si sovrappongono, i rendimenti pre-averaged risultano correlati anche se i rendimenti grezzi non lo fossero. Questa dipendenza fa parte del comportamento campionario dello stimatore: le numerose somme su finestra non vanno trattate come osservazioni indipendenti. Intervallo degli indici e convenzione per gli estremi devono essere coerenti con la normalizzazione dei pesi.
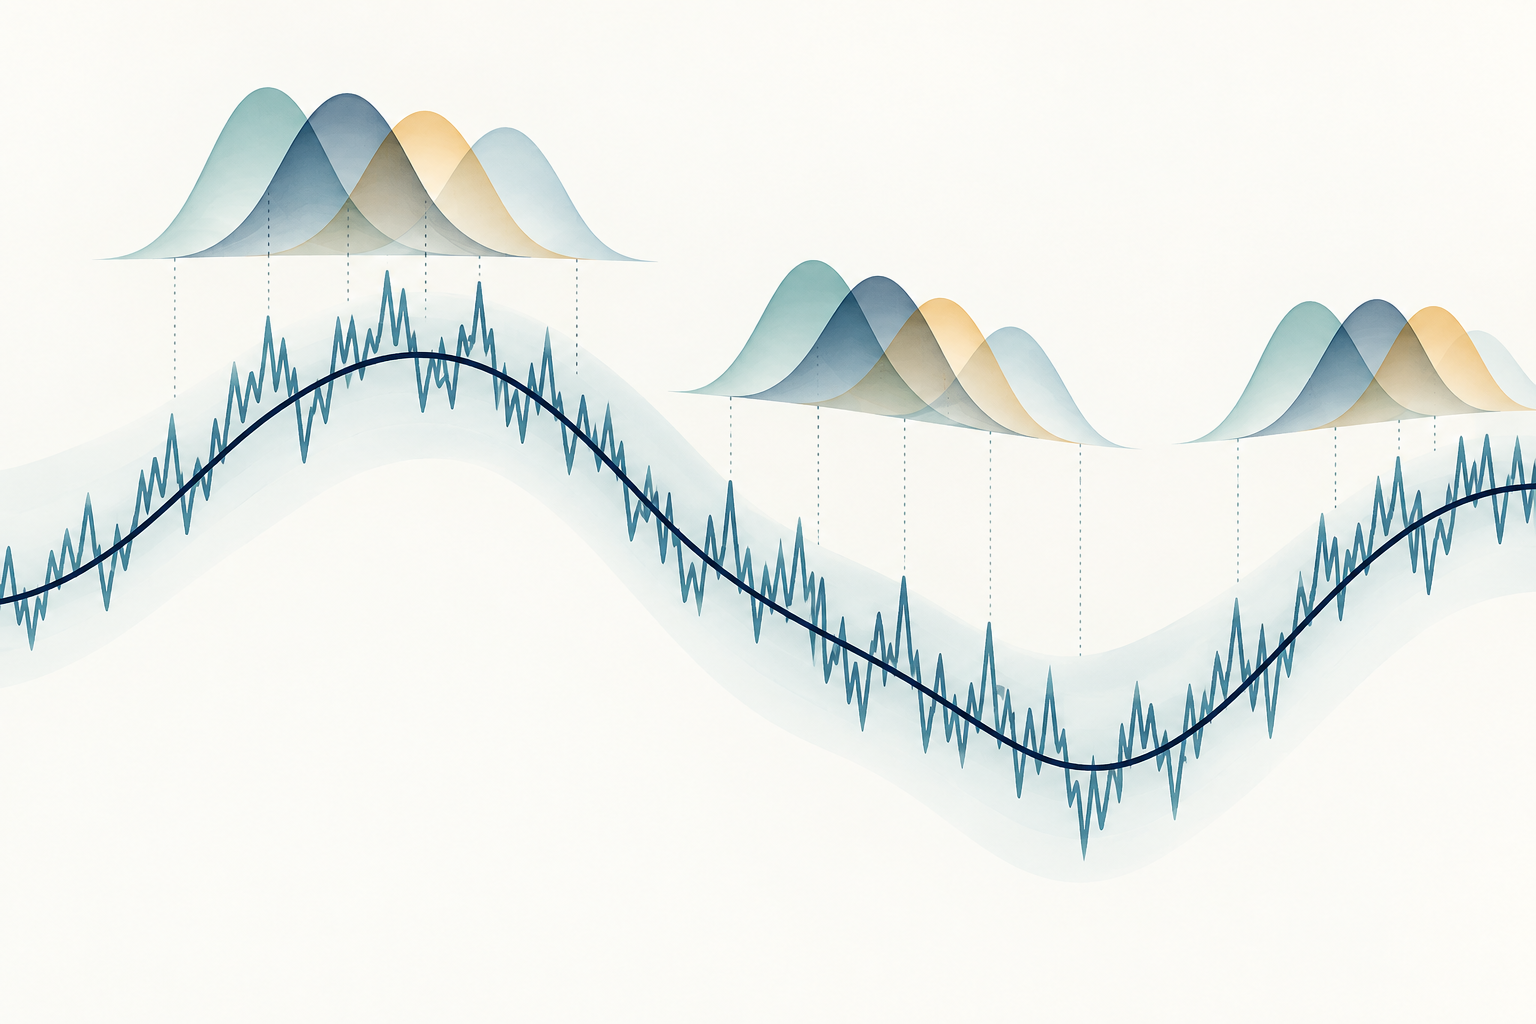
La figura mostra un percorso latente regolare, un percorso osservato frastagliato e più finestre sovrapposte con pesi attenuati ai bordi. Illustra l’aggregazione locale; non è una serie di prezzi né l’output empirico di un filtro.
<!-- learn:illustration --> <!-- Concetto senza testo: un percorso di prezzo latente regolare accanto a un percorso osservato frastagliato, con finestre locali sovrapposte e attenuate che aggregano movimenti vicini. Solo concettuale: non sono dati di mercato, una previsione o un segnale operativo. -->
Correggere la componente di rumore residua
Il pre-averaging riduce l’influenza degli errori di osservazione rapidi, ma i rendimenti filtrati al quadrato contengono ancora una componente di rumore. Una forma comune dello stimatore univariato su una griglia regolare, con costanti di normalizzazione asintotiche, è
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
dove le costanti dei pesi sono
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
Il primo termine riscalibra la somma dei rendimenti pre-averaged al quadrato per approssimare la varianza integrata. Il secondo stima e sottrae, sotto il modello, la componente principale del rumore di osservazione. Non stima ogni singola realizzazione del rumore e non corregge un campo prezzo errato, un timestamp scorretto o un valore anomalo. Una formula per campioni finiti può usare versioni discrete di \(\psi_1\) e \(\psi_2\), correzioni agli estremi e una specifica convenzione per gli indici dei rendimenti. Questi dettagli vanno dichiarati e applicati coerentemente.
La correzione può lasciare una stima piccola o negativa in un campione finito. Ciò non significa che l’asset abbia avuto varianza fisica negativa: indica che, in quel campione, la correzione scelta ha superato il primo termine. Non sostituire silenziosamente a zero una stima negativa. Riporta il calcolo grezzo e ogni regola separata di troncamento, perché il troncamento modifica lo stimatore e può influire su medie o inferenza successive.
Scegliere la lunghezza della finestra in base a rumore e campione
\(k_n\) controlla il grado di smoothing. Se la finestra è troppo corta, nei rendimenti filtrati resta più rumore ad alta frequenza. Se è troppo lunga, i movimenti locali del prezzo vengono mediati su un periodo più ampio e contribuiscono meno finestre, con possibile aumento di altri errori di stima. Lunghezza della finestra e funzione di peso agiscono insieme: \(k_n\) non è interpretabile senza la forma dei pesi e l’intervallo di campionamento.
Nel classico disegno bilanciato, con orizzonte temporale fisso e \(n\) osservazioni sempre più frequenti, la finestra cresce nell’ordine di \(\sqrt n\), spesso indicato con \(k_n\sim\theta\sqrt n\), dove \(\theta\) è una costante positiva di taratura. Sotto le ipotesi dell’articolo, lo stimatore può convergere al tasso \(n^{1/4}\), cioè con errore di stima dell’ordine di \(n^{-1/4}\). È più lento del tasso \(n^{1/2}\) senza rumore ed è ottimale nel caso rumoroso di base studiato dagli autori; non è una garanzia per ogni dataset di mercato.
\(\theta\), la funzione di peso e il metodo di selezione basato sui dati incidono su bias e varianza nei campioni finiti. Una scelta automatica può dipendere da stime di rumore e volatilità che sono a loro volta incerte. Mostra la sensibilità per diverse finestre ragionevoli, spiega la convenzione temporale di campionamento e i confini della sessione, e non scegliere la finestra dopo aver visto quale valore favorisce la conclusione desiderata.
Un piccolo calcolo ipotetico
Consideriamo sei rendimenti osservati ipotetici, espressi in punti base:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Usiamo un peso triangolare \(g(u)=\min(u,1-u)\) e una finestra volutamente breve \(k=3\). I due pesi interni della griglia sono \(g(1/3)=g(2/3)=1/3\). Per mostrare con precisione il calcolo su questa piccola griglia, definiamo i normalizzatori discreti:
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Con la convenzione di indici indicata sopra, ci sono \(n-k+2=5\) finestre sovrapposte. Ognuna combina un rendimento vicino di \(1\) bp con uno di \(0\) bp; quindi \(\bar r_i=(1/3)(1+0)=1/3\) bp, e
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Applicando la normalizzazione discreta corrispondente si ottiene
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
L’esempio permette di verificare l’aritmetica e le unità; sei rendimenti e una finestra così breve non bastano a giustificare l’approssimazione asintotica. I valori sono costruiti per rendere trasparente il calcolo. Non sono dati di mercato, una simulazione di un processo di rumore o una prova del recupero della varianza integrata latente. Non sono calcolati né errore standard né previsione.
Comprendere le ipotesi e quando possono non valere
La derivazione standard presuppone un prezzo efficiente continuo osservato frequentemente con rumore additivo e condizioni di regolarità. Un rumore indipendente a media zero è un utile punto di partenza, ma la dipendenza tra rumore e prezzo, errori serialmente correlati, rumore variabile nel tempo, istanti di osservazione irregolari o campionamento endogeno possono richiedere uno stimatore modificato o una teoria specifica. Aït-Sahalia, Mykland e Zhang studiano la stima della volatilità integrata con rumore di microstruttura dipendente. Il loro lavoro ricorda perché la formula basata su rumore indipendente non è universale.
I salti pongono una domanda separata sull’obiettivo. La variazione quadratica include i quadrati dei salti, mentre la varianza integrata continua no. Un normale stimatore di pre-averaging non separa automaticamente i salti. La troncatura robusta ai salti o un’altra costruzione richiedono ipotesi e parametri propri. Una grande stampa anomala può inoltre influire su più finestre sovrapposte, quindi la convalida dei dati e il trattamento degli outlier restano necessari.
Il pre-averaging da solo non risolve neppure tutti i problemi dei dati multivariati o asincroni. Christensen, Kinnebrock e Podolskij sviluppano metodi di covarianza basati sul pre-averaging e un’estensione Hayashi–Yoshida robusta al rumore per osservazioni non sincrone nel loro studio. Queste costruzioni affrontano ulteriori problemi di disegno campionario. Applicare separatamente una formula univariata a ciascun asset non sincronizza automaticamente i timestamp e non garantisce una matrice di covarianza valida.
Distinguere il pre-averaging da TSRV e realized kernel
Questi stimatori affrontano problemi correlati di variazione ad alta frequenza, ma organizzano le informazioni in modo diverso. Two-scale realized volatility, o TSRV, fa la media delle varianze realizzate su griglie di campionamento rade e traslate, poi sottrae una versione scalata della stima sulla griglia fitta per correggere il bias principale dovuto al rumore. Il pre-averaging filtra invece brevi finestre di rendimenti sovrapposte con pesi regolari, eleva al quadrato i rendimenti filtrati e applica una correzione corrispondente. L’articolo originale sulle due scale presenta l’altra costruzione.
Un realized kernel parte dalla somma dei rendimenti al quadrato e aggiunge autocovarianze ponderate dei rendimenti a diversi ritardi. La bandwidth controlla il ritardo massimo incluso. Il pre-averaging modifica i rendimenti locali prima di elevarli al quadrato. Entrambi usano pesi e parametri di taratura, ma formule, normalizzazioni e ipotesi non sono intercambiabili. La guida ai realized kernel spiega la costruzione basata sui ritardi e la bandwidth.
La scelta dovrebbe dipendere dai dati e dalla quantità richiesta, non dal nome dello stimatore. Confronta disegno di campionamento, modello del rumore, trattamento degli estremi, obiettivo in presenza di salti e comportamento nei campioni finiti. La robustezza asintotica al rumore non garantisce che il metodo sia il più adatto per asset poco liquidi, sessioni brevi, rumore variabile o flussi di dati irregolari. La guida TSRV spiega le scelte di scala e correzione di quel metodo.
Riportare la misura dell’intervallo senza trarne una conclusione di trading
Per rendere riproducibile il risultato, specifica asset e campo prezzo, intervallo temporale, frequenza di campionamento, regole per timestamp e sessioni, unità dei rendimenti, funzione di peso, lunghezza della finestra, normalizzazione, convenzione agli estremi e ipotesi sul rumore. Se lo stimatore viene usato per inferenza, riporta anche lo stimatore della varianza o il metodo dell’intervallo di confidenza e le relative ipotesi. Una tabella di sensibilità su finestre ragionevoli può mostrare se la conclusione dipende da una singola scelta di taratura.
La varianza integrata misura l’intervallo osservato già concluso. La radice quadrata la esprime come scala di volatilità per lo stesso intervallo, ma non la trasforma in una previsione. Annualizzarla richiede una convenzione temporale esplicita e non crea comunque una previsione. Per prevedere un orizzonte successivo serve un modello separato e una valutazione out-of-sample. La guida al calcolo della volatilità realizzata illustra il benchmark basato sui rendimenti al quadrato; la guida alla variazione quadratica distingue la variazione del percorso dall’obiettivo continuo della varianza integrata.
Lo stimatore non dimostra perché il prezzo si sia mosso, non identifica una strategia profittevole e non garantisce una misura del rischio di esecuzione. Costi di negoziazione, liquidità, salti, dinamica della volatilità e incertezza della stima sono questioni separate. Il pre-averaging è uno strumento di misurazione statistica; la sua utilità dipende da quanto le ipotesi dichiarate sono adatte ai dati osservati.
Domande frequenti
Q1Il pre-averaging equivale a calcolare una media mobile dei prezzi?
No. Lo stimatore forma somme ponderate di rendimenti vicini e poi le eleva al quadrato e le corregge. Mediare i livelli di prezzo e calcolarne le differenze è un’altra trasformazione, con pesi e comportamento ai bordi diversi.
Q2Il pre-averaging elimina tutto il rumore di microstruttura?
No. Riduce l’effetto principale sotto ipotesi specifiche su rumore e campionamento. Rumore dipendente o variabile, salti, valori anomali e problemi di timestamp possono ancora influire sul risultato.
Q3Perché due stime con pre-averaging possono differire?
Possono cambiare funzione di peso, lunghezza della finestra, normalizzazione a campione finito, campo prezzo, regole per gli estremi o pulizia dei dati. Occorre riportare queste scelte e valutarne la sensibilità.
Q4Una stima con pre-averaging è una previsione di volatilità?
Non da sola. Misura la variazione dell’intervallo usato per calcolarla. Per prevedere un periodo successivo servono un modello separato e una valutazione out-of-sample.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
Qual è lo scopo principale dei rendimenti pre-averaged?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Leggi la guida completaQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Leggi la guida completa