

Pre-Averaging bei realisierter Volatilität: Ein Schätzer für Mikrostrukturrauschen
Erfahren Sie, wie Pre-Averaging kurze Hochfrequenz-Renditefenster glättet, den führenden Rauscheffekt korrigiert, die Fensterlänge abstimmt und sich von TSRV und Realized Kernels unterscheidet.
In diesem LeitfadenWarum sehr häufige Renditen Kursbewegungen falsch messen können
Kurze Zusammenfassung
Pre-Averaging schätzt Kursbewegungen, wenn sehr häufig aufgezeichnete Preise Mikrostrukturrauschen enthalten. Statt jede rohe Rendite einzeln zu quadrieren, bildet das Verfahren überlappende, gewichtete Summen benachbarter Renditen, quadriert diese und zieht einen Term für den führenden Rauschbeitrag ab. Das Ergebnis hängt von der Gewichtsform, Fensterlänge, Stichprobenanlage und den Rauschannahmen ab. Es misst die Variation eines beobachteten Intervalls, ist aber weder Volatilitätsprognose noch Handelssignal.
Warum sehr häufige Renditen Kursbewegungen falsch messen können
Wäre der beobachtete Kurs gleich dem effizienten Kurs, wäre die Summe quadrierter Intraday-Renditen ein naheliegender Schätzer der Variation während einer Sitzung. Tatsächliche Transaktionspreise und Quotes enthalten jedoch möglicherweise Bid-Ask-Bounce, Rundung auf die Tickgröße, Verzögerungen, diskrete Preisstufen oder Effekte der Datenerfassung. Wird das Samplingintervall extrem kurz, können diese Einflüsse einen großen Anteil jeder quadrierten Rendite ausmachen. Mehr Beobachtungen erhöhen dann womöglich den Rauschanteil, statt lediglich mehr Bewegung des latenten Kurses sichtbar zu machen.
Pre-Averaging begegnet dem Problem, indem es Renditen über ein kurzes lokales Fenster zusammenfasst, bevor es sie quadriert. Eine glatte Gewichtsfunktion beginnt bei null, gewichtet benachbarte Renditen und fällt am Fensterrand wieder auf null. Die gewichtete Summe wirkt wie ein lokaler Filter: schnelle, unabhängige Beobachtungsfehler können sich teilweise aufheben, während breitere Bewegungen des effizienten Kurses erhalten bleiben können. Überlappende Fenster nutzen Informationen über das ganze Intervall.
Glättung allein macht einen Schätzer nicht unverzerrt. Auch die quadrierten gefilterten Renditen enthalten einen Rauschbeitrag, weshalb ein Korrekturterm nötig ist. Jacod, Li, Mykland, Podolskij und Vetter leiten unter ausdrücklich genannten Annahmen ein Pre-Averaging-Verfahren für integrierte Volatilität her und zeigen, dass geeignete Varianten die Konvergenzrate \(n^{-1/4}\) erreichen. Ihr Originalbeitrag begründet die Methode; dieser Leitfaden erläutert Mechanik, Entscheidungen und Grenzen.
Latenten Kurs, beobachteten Kurs und Zielgröße trennen
Sei \(X_{t_i}\) der latente effiziente logarithmische Kurs zum Beobachtungszeitpunkt \(t_i\) und \(Y_{t_i}\) der aufgezeichnete logarithmische Kurs:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
wobei \(\epsilon_{t_i}\) das Beobachtungsrauschen bezeichnet. Ein übliches Basismodell behandelt \(X_t\) als stetiges Semimartingal mit lokaler Varianzrate \(\sigma_t^2\). Die Zielgröße über ein festes Intervall \([0,T]\) ist die integrierte Varianz:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Die beobachtete Rendite zerfällt in \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Selbst wenn die Kursfehler zwischen Beobachtungen unabhängig sind, teilen benachbarte Renditen einen Endpunktfehler mit entgegengesetztem Vorzeichen. So entsteht serielle Abhängigkeit der Renditen, und die realisierte Varianz aus allen Beobachtungen reagiert auf die Zahl verrauschter Differenzen.
Die einfache theoretische Darstellung nimmt häufig zentriertes, zeitlich unabhängiges und vom effizienten Kursprozess unabhängiges Rauschen sowie geeignete endliche Momente an. Das erleichtert die Erklärung des Korrekturterms, ist aber bei Transaktionen, Quotes oder Midquotes nicht garantiert. Rauschen kann sich mit Liquidität und Tageszeit ändern, mit dem effizienten Kurs zusammenhängen oder seriell abhängig sein. Auch die Zielgröße muss klar sein: Bei Sprüngen enthält die quadratische Variation deren quadrierte Größen, die kontinuierliche integrierte Varianz dagegen nicht.
Es handelt sich um eine Ex-post-Messung für eine bestimmte Preisreihe und ein festgelegtes Zeitintervall. Sie rekonstruiert nicht jeden latenten Kurs, kennzeichnet nicht den einzelnen fehlerhaften Tick und sagt nichts über die künftige Volatilität aus. Vor einem Vergleich ist daher anzugeben, ob Transaktionspreise, Midquotes oder eine andere Preisreihe verwendet wurden.
Überlappende vorab gemittelte Renditen bilden
Für \(n\) beobachtete Renditen \(r_i=Y_{t_i}-Y_{t_{i-1}}\) werden eine ganzzahlige Fensterlänge \(k_n\) und eine Gewichtsfunktion \(g\) auf \([0,1]\) gewählt. Eine verbreitete vorab gemittelte Rendite ist
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Die Funktion ist üblicherweise stetig, verschwindet an beiden Endpunkten und erfüllt die für die asymptotischen Ergebnisse nötigen Glattheitsbedingungen. Ein Dreiecksgewicht ist \(g(u)=\min(u,1-u)\). Weil die Gewichte an den Fensterenden null sind, erhalten Renditen am Rand nicht plötzlich volles Gewicht. Die Form ist ein lokales Gewichtsschema, weder Prognose noch geschätzter Trend.
Jede \(\bar r_i\) bündelt benachbarte Renditen, bevor sie quadriert wird. Da die Fenster überlappen, sind die vorab gemittelten Renditen auch dann korreliert, wenn die Roh-Renditen unabhängig wären. Diese Abhängigkeit gehört zum Stichprobenverhalten des Schätzers; viele Fenstersummen dürfen nicht als unabhängige Beobachtungen behandelt werden. Indexbereich und Randkonvention müssen zur verwendeten Gewichtsnormierung passen.
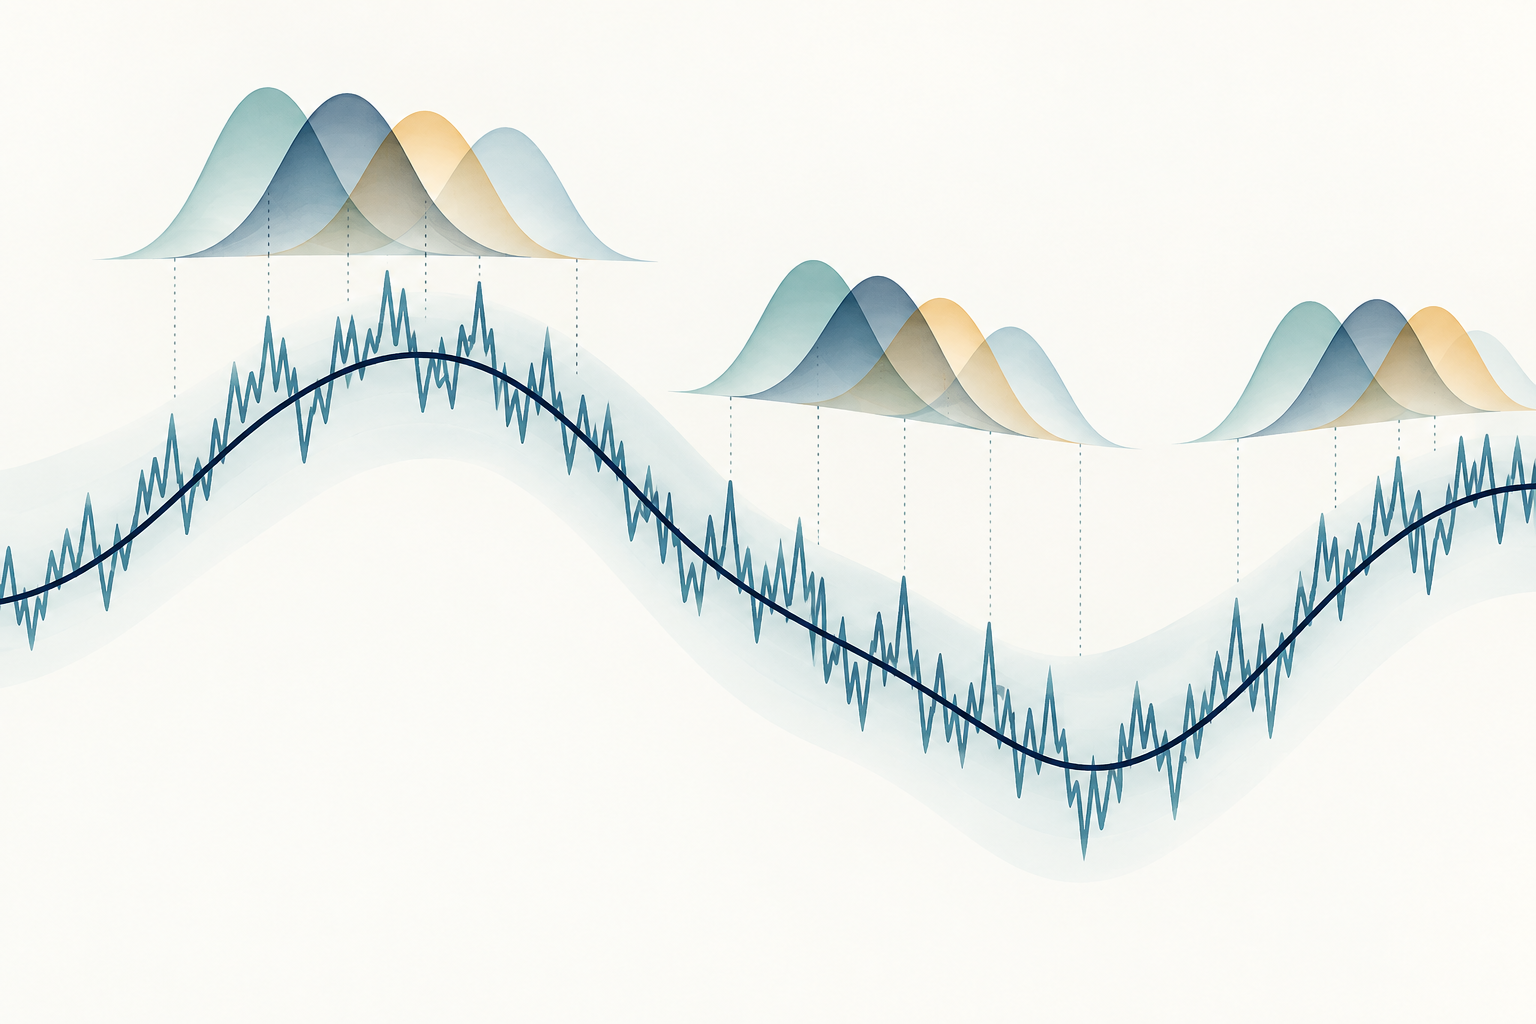
Die Abbildung zeigt einen glatten latenten Kurs, einen gezackten beobachteten Verlauf und mehrere überlappende Fenster mit auslaufenden Gewichten. Sie veranschaulicht die lokale Bündelung und ist weder ein Kursdatensatz noch ein empirisches Filterergebnis.
<!-- learn:illustration --> <!-- Textfreies Konzept: Ein glatter latenter Kurs neben einem gezackten beobachteten Verlauf; überlappende, auslaufend gewichtete Fenster bündeln benachbarte Bewegungen. Nur konzeptionell, keine Marktdaten, Prognose oder Handelssignal. -->
Den verbleibenden Rauschbeitrag korrigieren
Pre-Averaging verringert den Einfluss schneller Beobachtungsfehler, doch die quadrierten gefilterten Renditen enthalten weiterhin einen Rauschbeitrag. Eine verbreitete Form des univariaten Schätzers auf einem regelmäßigen Raster mit asymptotischen Normierungskonstanten lautet
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
wobei die Gewichtskonstanten
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du \]
sind. Der erste Term skaliert die Summe der quadrierten vorab gemittelten Renditen so, dass sie zur integrierten Varianz passt. Der zweite schätzt unter dem Modell den führenden Beitrag des Beobachtungsrauschens und zieht ihn ab. Er schätzt nicht jede einzelne Rauschrealisierung und kann weder ein falsches Preisfeld noch einen Zeitstempelfehler oder Ausreißer korrigieren. Eine konkrete Implementierung kann diskrete Varianten von \(\psi_1,\psi_2\), Randkorrekturen und eine bestimmte Indexkonvention verwenden. Diese Details sind anzugeben und konsistent umzusetzen.
Der korrigierte Schätzer kann in einer endlichen Stichprobe klein oder negativ ausfallen. Das bedeutet nicht, dass ein Vermögenswert eine negative physische Varianz hatte, sondern dass der gewählte Korrekturterm in dieser Stichprobe den ersten Term übertraf. Setzen Sie einen negativen Wert nicht stillschweigend auf null. Berichten Sie den Rohwert und jede separate Abschneideregel, denn Abschneiden verändert den Schätzer und kann spätere Mittelwerte oder Inferenz beeinflussen.
Die Fensterlänge an Rauschen und Stichprobe anpassen
\(k_n\) steuert den Glättungsgrad. Ist das Fenster zu kurz, bleibt mehr hochfrequentes Rauschen in den gefilterten Renditen. Ist es zu lang, werden lokale Kursbewegungen über einen größeren Zeitraum gemittelt und es gehen weniger Fenster ein, was andere Schätzfehler vergrößern kann. Fensterlänge und Gewichtsfunktion wirken zusammen; ohne Gewichtsform und Samplingintervall ist ein \(k_n\)-Wert nicht aussagekräftig.
Im klassischen balancierten Design wächst die Fensterlänge bei festem Zeitintervall und zunehmend häufigen \(n\) Beobachtungen von der Größenordnung \(\sqrt n\), oft geschrieben als \(k_n\sim\theta\sqrt n\) für eine positive Abstimmungskonstante \(\theta\). Unter den Annahmen der Arbeit kann der Schätzer die Rate \(n^{1/4}\) erreichen, also einen Schätzfehler der Größenordnung \(n^{-1/4}\) haben. Das ist langsamer als die rauschfreie Rate \(n^{1/2}\) und im betrachteten Basismodell mit Rauschen optimal; es ist keine Garantie für jeden Marktdatensatz.
\(\theta\), die Gewichtsfunktion und eine datenbasierte Wahlmethode beeinflussen den Bias und die Varianz in endlichen Stichproben. Eine automatische Abstimmung kann Schätzungen von Rauschen und Volatilität verwenden, die selbst unsicher sind. Zeigen Sie die Sensitivität für eine vertretbare Auswahl von Fensterlängen und erläutern Sie Samplinguhr sowie Sitzungsgrenzen. Wählen Sie das Fenster nicht erst danach aus, welcher Wert die gewünschte Schlussfolgerung stützt.
Ein kleines hypothetisches Zahlenbeispiel
Angenommen, sechs hypothetische beobachtete Renditen lauten in Basispunkten:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Verwendet wird das Dreiecksgewicht \(g(u)=\min(u,1-u)\) mit einem absichtlich kurzen Fenster \(k=3\). Die beiden inneren Rastergewichte sind \(g(1/3)=g(2/3)=1/3\). Für die genaue arithmetische Darstellung definieren wir diskrete Normierungskonstanten:
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Nach der oben verwendeten Indexkonvention gibt es \(n-k+2=5\) überlappende Fenster. Jedes bündelt eine Rendite von \(1\) bp mit der benachbarten Rendite von \(0\) bp. Daher ist \(\bar r_i=(1/3)(1+0)=1/3\) bp und
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Mit der passenden diskreten Normierung ergibt sich
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
Das Beispiel prüft die Rechnung und Einheiten; sechs Renditen und ein so kurzes Fenster reichen bei Weitem nicht für eine asymptotische Näherung. Die Werte wurden zur transparenten Rechnung konstruiert. Sie sind weder Marktdaten noch eine Simulation eines Rauschprozesses oder ein Beleg dafür, dass latente integrierte Varianz wiedergewonnen wurde. Ein Standardfehler und eine Prognose werden nicht berechnet.
Annahmen und ihre Grenzen verstehen
Die Standardherleitung beruht auf einem stetigen effizienten Kursprozess mit additivem Rauschen, dichter Beobachtung und bestimmten Regularitätsbedingungen. Zentriertes, unabhängiges Rauschen ist ein hilfreicher Ausgangspunkt. Eine Abhängigkeit zwischen Rauschen und Kurs, seriell korrelierte Fehler, zeitlich veränderliches Rauschen, unregelmäßige Beobachtungszeiten oder endogene Samplingzeiten können jedoch einen angepassten Schätzer oder eine dafür entwickelte Theorie erfordern. Aït-Sahalia, Mykland und Zhang untersuchen integrierte Volatilität bei abhängigem Mikrostrukturrauschen. Ihre Arbeit zeigt, warum die Formel mit unabhängigem Rauschen nicht als allgemeingültig gelten sollte.
Sprünge stellen eine separate Frage nach der Zielgröße. Zur quadratischen Variation gehören die quadrierten Sprünge; zur kontinuierlichen integrierten Varianz nicht. Ein gewöhnlicher Pre-Averaging-Schätzer trennt Sprünge nicht automatisch. Sprungrobuste Trunkierung oder eine andere Konstruktion erfordert eigene Annahmen und Abstimmungsparameter. Ein großer fehlerhafter Kurs kann außerdem mehrere überlappende Fenster beeinflussen; Datenprüfung und Ausreißerbehandlung bleiben nötig.
Pre-Averaging löst auch nicht von selbst alle Probleme multivariater oder asynchroner Daten. Christensen, Kinnebrock und Podolskij entwickeln Pre-Averaging-Verfahren für Kovarianzen sowie eine rauschrobuste Hayashi–Yoshida-Erweiterung für nicht synchrone Beobachtungen in ihrer Studie. Diese Konstruktionen behandeln zusätzliche Fragen der Stichprobenanlage. Eine univariate Formel für jeden Vermögenswert gleicht Zeitstempel nicht automatisch ab und erzeugt nicht zwingend eine gültige Kovarianzmatrix.
Pre-Averaging von TSRV und Realized Kernels unterscheiden
Diese Schätzer behandeln verwandte Probleme mit Hochfrequenzvariation, ordnen die Daten aber unterschiedlich an. Two-Scale Realized Volatility, kurz TSRV, mittelt realisierte Varianzen aus verschobenen, dünn besetzten Stichprobenrastern und zieht zur Korrektur des führenden Rauschbias einen skalierten Schätzer auf dem feinen Raster ab. Pre-Averaging filtert dagegen zuerst kurze, überlappende Renditefenster mit einer glatten Gewichtsfunktion, quadriert die gefilterten Renditen und verwendet eine dazu passende Korrektur. Die Originalarbeit zu den zwei Zeitskalen beschreibt die andere Konstruktion.
Ein Realized Kernel beginnt mit der Summe quadrierter Renditen und ergänzt gewichtete Renditeautokovarianzen über mehrere Lags. Die Bandbreite steuert, wie weit die Lags reichen. Pre-Averaging verändert dagegen lokale Renditen, bevor sie quadriert werden. Beide Verfahren verwenden Gewichte und Abstimmungsparameter, doch Formeln, Normierungen und Annahmen sind nicht austauschbar. Der Leitfaden zu Realized Kernels behandelt die lagbasierte Konstruktion und Bandbreite.
Die Wahl sollte sich nach Daten und Zielgröße richten, nicht nach dem Namen des Schätzers. Vergleichen Sie Samplingdesign, Rauschmodell, Randbehandlung, Sprungziel und Verhalten in endlichen Stichproben. Asymptotische Robustheit gegenüber Rauschen garantiert nicht, dass ein Verfahren für selten gehandelte Werte, kurze Sitzungen, wechselndes Rauschen oder unregelmäßige Datenfeeds am besten geeignet ist. Der TSRV-Leitfaden erläutert dessen Skala und Korrektur.
Intervallmessung berichten und keine Handelsaussage daraus ableiten
Ein reproduzierbares Ergebnis nennt Vermögenswert und Preisfeld, Zeitintervall, Samplingfrequenz, Zeitstempel- und Sitzungsregeln, Renditeeinheiten, Gewichtsfunktion, Fensterlänge, Normierung, Randkonvention und Rauschannahmen. Für Inferenz sind auch Varianzschätzer oder Konfidenzverfahren samt den nötigen Annahmen zu berichten. Eine Sensitivitätstabelle für vertretbare Fensterlängen macht sichtbar, ob die Schlussfolgerung von einer einzelnen Abstimmung abhängt.
Integrierte Varianz misst ein abgeschlossenes Beobachtungsintervall. Die Quadratwurzel drückt sie als Volatilitätsskala desselben Intervalls aus, macht sie aber nicht zur Prognose. Eine Annualisierung benötigt eine offengelegte Zeitkonvention und erzeugt ebenfalls keine Vorhersage. Eine Prognose für einen späteren Zeitraum erfordert ein separates Modell mit Out-of-Sample-Auswertung. Der Leitfaden zur Berechnung realisierter Volatilität erläutert den einfachen Benchmark; der Leitfaden zur quadratischen Variation unterscheidet Pfadvariation von kontinuierlicher integrierter Varianz.
Der Schätzer beweist weder, warum sich der Kurs bewegt hat, noch identifiziert er eine profitable Strategie oder garantiert die Messung ausführbarer Risiken. Handelskosten, Liquidität, Sprünge, Volatilitätsdynamik und Schätzunsicherheit sind getrennte Fragen. Pre-Averaging ist ein statistisches Messinstrument; sein Nutzen hängt davon ab, wie gut seine ausdrücklich genannten Annahmen zu den beobachteten Daten passen.
Häufige Fragen
Q1Ist Pre-Averaging dasselbe wie ein gleitender Durchschnitt der Kurse?
Nein. Der Schätzer bildet gewichtete Summen benachbarter Renditen und quadriert sowie korrigiert diese anschließend. Kursniveaus zu mitteln und dann zu differenzieren ist eine andere Transformation mit anderen Gewichten und Randeffekten.
Q2Entfernt Pre-Averaging das gesamte Mikrostrukturrauschen?
Nein. Unter bestimmten Rausch- und Samplingannahmen mindert es den führenden Effekt. Abhängiges oder veränderliches Rauschen, Sprünge, Ausreißer und Zeitstempelprobleme können das Ergebnis weiterhin beeinflussen.
Q3Warum unterscheiden sich Pre-Averaging-Schätzungen?
Gewichtsfunktion, Fensterlänge, Normierung der endlichen Stichprobe, Preisfeld, Randregeln oder Datenbereinigung können abweichen. Diese Entscheidungen sollten berichtet und auf Sensitivität geprüft werden.
Q4Ist ein Pre-Averaging-Schätzer eine Volatilitätsprognose?
Nein. Er misst die Variation des für die Berechnung verwendeten Intervalls. Für spätere Zeiträume braucht es ein separates Prognosemodell und eine Out-of-Sample-Auswertung.
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Was ist der Hauptzweck vorab gemittelter Renditen?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Detaillierten Leitfaden lesenQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Detaillierten Leitfaden lesen