

Pre-Averaging Realized Volatility: Microstructure Noise-এর জন্য একটি Estimator
Pre-averaging কীভাবে ছোট high-frequency return window smooth করে, noise-এর leading effect correct করে, window length বেছে নেয় এবং TSRV ও realized kernel থেকে আলাদা—তা জানুন।
এই গাইডেখুব ঘন return price variation ভুলভাবে মাপতে পারে কেন
সংক্ষিপ্ত সারাংশ
খুব ঘন ঘন record করা price-এ microstructure noise থাকলে pre-averaging price variation estimate করার একটি পদ্ধতি। প্রতিটি raw return square না করে, এটি কাছাকাছি return-এর overlapping weighted sum বানায়, সেটিকে square করে এবং noise-এর leading contribution-এর জন্য একটি term বাদ দেয়। ফলাফল weight shape, window length, sampling design ও noise assumption-এর ওপর নির্ভর করে। এটি observed interval-এর variation মাপে; volatility forecast বা trading signal নয়।
খুব ঘন return price variation ভুলভাবে মাপতে পারে কেন
Observed price যদি efficient price-এর সঙ্গে হুবহু মিলে যেত, তবে intraday return-এর square যোগ করা session-এর variation estimate করার স্বাভাবিক উপায় হতো। কিন্তু বাস্তব transaction price ও quote-এ bid–ask bounce, tick-size rounding, latency, discrete price level বা recording convention-এর প্রভাব থাকতে পারে। Sampling interval অত্যন্ত ছোট হলে প্রতিটি squared return-এর বড় অংশ এসব প্রভাব থেকে আসতে পারে। তাই বেশি observation যোগ করলে latent price-এর নতুন movement-ই শুধু ধরা পড়বে এমন নয়; noise contribution-ও বাড়তে পারে।
Pre-averaging এই সমস্যায় return square করার আগে ছোট local window-তে return মিলিয়ে নেয়। Smooth weight function শূন্য থেকে শুরু হয়ে পাশের return-গুলোকে weight দেয়, তারপর window-এর শেষে আবার শূন্যে নামে। Weighted sum একটি local filter-এর মতো কাজ করে: দ্রুত ওঠানামা করা independent observation error আংশিকভাবে cancel হতে পারে, আর efficient price-এর বিস্তৃত movement টিকে থাকতে পারে। Overlapping window পুরো interval জুড়ে তথ্য ব্যবহার করতে দেয়।
শুধু smooth করলেই estimator unbiased হয় না। Filtered return square করার পরও noise variation থাকে, তাই correction term দরকার। Jacod, Li, Mykland, Podolskij ও Vetter নির্দিষ্ট assumption-এর অধীনে integrated volatility estimate করার pre-averaging পদ্ধতি বিশ্লেষণ করেন এবং দেখান যে উপযুক্ত estimator \(n^{-1/4}\) convergence rate পেতে পারে। তাঁদের মূল গবেষণা পদ্ধতির ভিত্তি; এই guide estimator-এর mechanics, choice ও limit ব্যাখ্যা করে।
Latent price, observed price এবং target আলাদা করুন
Observation time \(t_i\)-তে latent efficient log price \(X_{t_i}\) এবং recorded log price \(Y_{t_i}\) ধরা যাক:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
যেখানে \(\epsilon_{t_i}\) observation noise। একটি প্রচলিত baseline model-এ \(X_t\) হলো local variance rate \(\sigma_t^2\)-সহ continuous semimartingale। নির্দিষ্ট interval \([0,T]\)-তে লক্ষ্য হলো integrated variance:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
Observed return-কে লেখা যায় \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\)। Price error-গুলো observation জুড়ে independent হলেও পাশাপাশি return দুটি একটি endpoint error বিপরীত sign-এ share করে। এতে return-এ serial dependence তৈরি হয় এবং সব observation-সহ realized variance noisy difference-এর সংখ্যার প্রতি sensitive হয়।
সহজ theoretical explanation সাধারণত zero-mean noise ধরে, যা সময়ে এবং efficient-price process-এর সঙ্গে independent, সঙ্গে উপযুক্ত finite moment। Correction কেন দরকার তা বোঝাতে এই assumption সুবিধাজনক, কিন্তু trade, quote বা midpoint price-এ এগুলো নিশ্চিত নয়। Noise liquidity ও দিনের সময়ের সঙ্গে বদলাতে পারে, efficient price-এর সঙ্গে সম্পর্কিত হতে পারে বা serially dependent হতে পারে। Target-ও পরিষ্কার করতে হবে: jump থাকলে quadratic variation-এ jump-এর square অন্তর্ভুক্ত, কিন্তু continuous integrated variance-এ নয়।
এটি নির্দিষ্ট price series ও সময়সীমার ex post measurement। এটি প্রতিটি latent price পুনর্গঠন করে না, কোন একক print ভুল ছিল তা চিহ্নিত করে না এবং ভবিষ্যৎ volatility জানায় না। Estimate তুলনার আগে input transaction price, quote midpoint, নাকি অন্য কোনো price construction—তা বলুন।
Overlapping pre-averaged return তৈরি করুন
\(n\)টি observed return \(r_i=Y_{t_i}-Y_{t_{i-1}}\) হলে, integer window length \(k_n\) এবং \([0,1]\)-এ weight function \(g\) বেছে নিন। একটি প্রচলিত pre-averaged return হলো
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Weight function সাধারণত continuous হয়, দুই endpoint-এ শূন্য হয় এবং asymptotic result-এর জন্য যথেষ্ট smooth হয়। Triangular উদাহরণ হলো \(g(u)=\min(u,1-u)\)। Window-এর দুই প্রান্তে weight শূন্য হওয়ায় edge return হঠাৎ পূর্ণ weight পায় না। এটি local weight shape; forecast বা fitted trend নয়।
প্রতিটি \(\bar r_i\) adjacent return-গুলোকে square করার আগে একত্র করে। Window overlapping হওয়ায় raw return independent হলেও pre-averaged return correlated হয়। এই dependence estimator-এর sampling behavior-এর অংশ; অনেক window sum-কে independent observation ধরে নেওয়া যাবে না। Index range ও endpoint convention weight-এর normalization-এর সঙ্গে মেলাতে হবে।
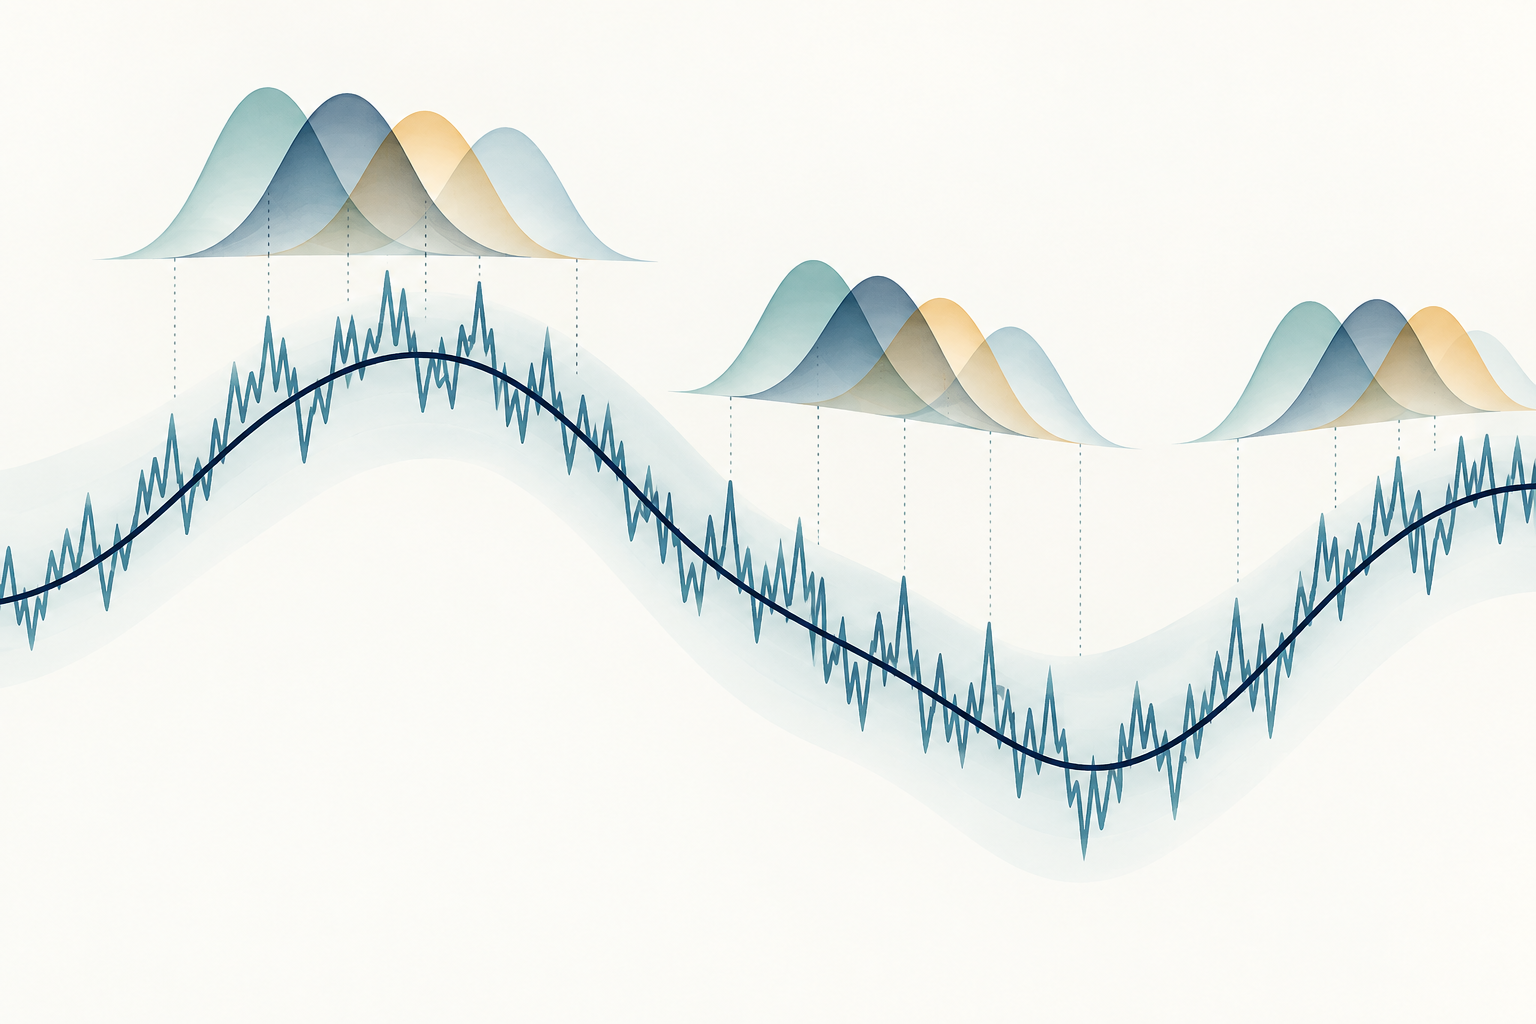
চিত্রে মসৃণ latent path-এর পাশে jagged observed path এবং tapered weight-সহ কয়েকটি overlapping window দেখানো হয়েছে। এটি local pooling বোঝানোর ধারণামূলক ছবি; price record বা empirical filter output নয়।
<!-- learn:illustration --> <!-- Text-free concept: smooth latent price path-এর পাশে jagged observed path, যেখানে overlapping tapered local window পাশের movement একত্র করে। ধারণামূলক; market data, forecast বা trading signal নয়। -->
অবশিষ্ট noise contribution correct করুন
Pre-averaging দ্রুত observation error-এর প্রভাব কমায়, কিন্তু filtered return-এর square-এ noise contribution থাকে। Regular grid-এর জন্য asymptotic normalizer-সহ univariate estimator-এর একটি প্রচলিত রূপ হলো
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
যেখানে weight constant-গুলো
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
প্রথম term pre-averaged squared return-এর sum-কে integrated variance-এর scale-এ আনে। দ্বিতীয় term model-এর অধীনে observation noise-এর leading contribution estimate করে বাদ দেয়। এটি প্রতিটি noise realization estimate করে না, ভুল price field, timestamp error বা outlier ঠিকও করে না। Finite-sample formula-তে \(\psi_1,\psi_2\)-এর discrete version, endpoint adjustment বা return-index convention থাকতে পারে। সেসব detail জানাতে হবে এবং একইভাবে প্রয়োগ করতে হবে।
Correction-এর পরে finite-sample estimate ছোট বা negative হতে পারে। তার মানে asset-এর physical variance negative ছিল না; বরং ওই sample-এ chosen correction প্রথম term-এর চেয়ে বেশি হয়েছে। Negative estimate চুপচাপ zero করবেন না। Raw calculation এবং আলাদা truncation rule থাকলে সেটি জানান, কারণ truncation estimator বদলে দেয় এবং পরের average বা inference-এ প্রভাব ফেলতে পারে।
Noise ও sample অনুযায়ী window length বেছে নিন
\(k_n\) smoothing-এর পরিমাণ নিয়ন্ত্রণ করে। Window খুব ছোট হলে filtered return-এ high-frequency noise বেশি থাকে। খুব বড় হলে local price movement আরও দীর্ঘ সময় ধরে average হয় এবং কম window ব্যবহার হয়, ফলে অন্য estimation error বাড়তে পারে। Window length ও weight function একসঙ্গে কাজ করে; weight shape ও sampling interval ছাড়া \(k_n\)-এর মানের অর্থ সম্পূর্ণ হয় না।
Classical balanced design-এ fixed time span-এর মধ্যে \(n\) ক্রমশ ঘন observation নিলে window-এর order \(\sqrt n\), যা প্রায়ই \(k_n\sim\theta\sqrt n\) লেখা হয়; \(\theta\) একটি positive tuning constant। Paper-এর assumption ঠিক থাকলে estimator-এর convergence rate \(n^{1/4}\), অর্থাৎ estimation error \(n^{-1/4}\)-এর order হতে পারে। Noise-free \(n^{1/2}\) rate-এর তুলনায় এটি ধীর; লেখকদের baseline noisy setting-এ এটি optimal rate, সব market dataset-এর নিশ্চয়তা নয়।
\(\theta\), weight function এবং data-driven selection method finite-sample bias ও variance-এ প্রভাব ফেলে। Automatic selection noise ও volatility estimate-এর ওপর নির্ভর করতে পারে, যেগুলো নিজেরাও uncertain। যুক্তিসংগত কয়েকটি window setting-এ sensitivity দেখান, sampling clock ও session boundary জানান, এবং পছন্দের conclusion-এর সঙ্গে মানানসই value দেখে পরে window বেছে নেবেন না।
ছোট একটি hypothetical calculation
Basis point-এ ছয়টি hypothetical observed return ধরা যাক:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Triangular weight \(g(u)=\min(u,1-u)\) এবং ইচ্ছাকৃতভাবে ছোট window \(k=3\) নিন। দুইটি interior grid weight হলো \(g(1/3)=g(2/3)=1/3\)। এই ছোট grid-এর arithmetic স্পষ্ট করতে discrete normalizer সংজ্ঞায়িত করি:
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
আগের index convention-এ \(n-k+2=5\)টি overlapping window আছে। প্রতিটি পাশের \(1\) bp ও \(0\) bp return একত্র করে, তাই \(\bar r_i=(1/3)(1+0)=1/3\) bp এবং
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
সংশ্লিষ্ট discrete normalization বসালে
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
এই উদাহরণ arithmetic ও unit যাচাই করে; ছয়টি return ও এত ছোট window asymptotic approximation সমর্থন করার জন্য যথেষ্ট নয়। হিসাব পরিষ্কার রাখতে মানগুলো তৈরি করা হয়েছে। এগুলো market data, noise process simulation বা latent integrated variance recover হওয়ার প্রমাণ নয়। Standard error বা forecast হিসাব করা হয়নি।
Assumption বুঝুন এবং কোথায় তা ভাঙতে পারে
Standard derivation-এ continuous efficient-price process, additive noise, ঘন observation এবং কিছু regularity condition থাকে। Zero-mean independent noise ভালো starting point, কিন্তু noise ও price-এর dependence, serially correlated error, সময়ে পরিবর্তনশীল noise, irregular observation time বা endogenous sampling হলে modified estimator বা সেই পরিস্থিতির theory লাগতে পারে। Aït-Sahalia, Mykland ও Zhang dependent microstructure noise-এর মধ্যে integrated volatility estimate করার বিষয়টি অধ্যয়ন করেছেন। তাঁদের গবেষণা মনে করিয়ে দেয় যে independent-noise formula সর্বজনীন নয়।
Jump থাকলে target নিয়ে আলাদা সিদ্ধান্ত দরকার। Quadratic variation-এ jump-এর square থাকে, কিন্তু continuous integrated variance-এ নয়। সাধারণ pre-averaging estimator নিজে থেকে jump আলাদা করে না। Jump-robust truncation বা অন্য construction-এর নিজস্ব assumption ও tuning দরকার। বড় outlier একাধিক overlapping window-কে প্রভাবিত করতে পারে, তাই data validation ও outlier treatment এখনও গুরুত্বপূর্ণ।
Pre-averaging একাই multivariate বা asynchronous data-র সব সমস্যা সমাধান করে না। Christensen, Kinnebrock ও Podolskij non-synchronous observation-এর জন্য pre-averaging covariance method এবং noise-robust Hayashi–Yoshida extension তৈরি করেন তাঁদের গবেষণায়। সেসব construction অতিরিক্ত sampling-design সমস্যা মোকাবিলা করে। প্রতিটি asset-এ univariate formula আলাদা করে প্রয়োগ করলে timestamp স্বয়ংক্রিয়ভাবে synchronize হয় না বা valid covariance matrix নিশ্চিত হয় না।
Pre-averaging-কে TSRV ও realized kernel থেকে আলাদা করুন
এই estimator-গুলো কাছাকাছি high-frequency variation problem মাপে, তবে তথ্য সাজানোর পদ্ধতি আলাদা। Two-scale realized volatility বা TSRV shifted sparse sampling grid-এর realized variance average করে, তারপর leading noise bias correct করতে fine-grid estimate-এর scaled অংশ বিয়োগ করে। Pre-averaging বরং ছোট overlapping return window smooth weight দিয়ে filter করে, filtered return square করে এবং তার সঙ্গে মেলে এমন correction প্রয়োগ করে। মূল two-scale paper আলাদা TSRV construction ব্যাখ্যা করে।
Realized kernel squared-return sum থেকে শুরু করে একাধিক lag-এর weighted return autocovariance যোগ করে। Bandwidth ঠিক করে কত দূরের lag থাকবে। Pre-averaging square করার আগেই local return বদলে দেয়। উভয় পদ্ধতিতে weight ও tuning choice থাকলেও formula, normalization ও assumption পরস্পরের বদলি নয়। Lag-based construction ও bandwidth-এর জন্য realized-kernel guide দেখুন।
Estimator-এর নাম নয়, data design ও প্রয়োজনীয় target দেখে পদ্ধতি বেছে নিন। Sampling design, noise model, endpoint handling, jump target এবং finite-sample behavior তুলনা করুন। Asymptotic noise robustness মানেই illiquid asset, ছোট session, changing noise বা irregular data feed-এর জন্য সেরা পদ্ধতি—এমন নয়। TSRV guide তার scale ও correction choice ব্যাখ্যা করে।
Interval measurement জানান, trading conclusion নয়
Result পুনরুৎপাদন করতে asset ও price field, সময়সীমা, sampling frequency, timestamp ও session rule, return unit, weight function, window length, normalization, endpoint convention এবং noise assumption জানান। Inference-এর জন্য ব্যবহার করলে variance estimator বা confidence procedure এবং তার assumption-ও বলুন। যুক্তিসংগত window setting-গুলোর sensitivity table দেখালে conclusion একটি tuning choice-এর ওপর নির্ভর করে কি না বোঝা যায়।
Integrated variance সম্পূর্ণ observed interval মাপে। Square root নিলে একই interval-এর volatility scale পাওয়া যায়, কিন্তু তা forecast হয় না। Annualize করতে স্পষ্ট time convention দরকার; annualization-ও forecast তৈরি করে না। ভবিষ্যৎ horizon predict করতে আলাদা model এবং out-of-sample evaluation দরকার। Basic squared-return benchmark-এর জন্য realized-volatility calculation guide দেখুন; path variation ও continuous integrated-variance target-এর পার্থক্য quadratic-variation guide-এ আছে।
Estimate price movement-এর কারণ প্রমাণ করে না, profitable strategy শনাক্ত করে না এবং execution risk পুরোপুরি মাপার নিশ্চয়তা দেয় না। Trading cost, liquidity, jumps, volatility dynamics ও estimation uncertainty আলাদা বিষয়। Pre-averaging একটি statistical measurement tool; observed data তার স্পষ্ট assumption-এর সঙ্গে কতটা মেলে, তার ওপর এর উপযোগিতা নির্ভর করে।
সাধারণ প্রশ্ন
Q1Pre-averaging কি price-এ moving average নেওয়ার মতো?
না। Estimator কাছাকাছি return-এর weighted sum তৈরি করে, তারপর square ও correct করে। Price level average করে difference নেওয়া আলাদা transformation; তার weight ও boundary behavior-ও আলাদা।
Q2Pre-averaging কি সব microstructure noise সরিয়ে দেয়?
না। নির্দিষ্ট noise ও sampling assumption-এর অধীনে leading effect কমায়। Dependent বা changing noise, jump, outlier এবং timestamp সমস্যা ফলাফলে প্রভাব ফেলতে পারে।
Q3Pre-averaging estimate আলাদা হতে পারে কেন?
Weight function, window length, finite-sample normalization, price field, endpoint rule বা data-cleaning পদ্ধতি আলাদা হতে পারে। Choice-গুলো জানান এবং sensitivity পরীক্ষা করুন।
Q4Pre-averaging estimate কি volatility forecast?
নিজে থেকে নয়। এটি হিসাবের জন্য ব্যবহৃত interval-এর variation মাপে। পরবর্তী period forecast করতে আলাদা model ও out-of-sample evaluation দরকার।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
Pre-averaged return তৈরির প্রধান উদ্দেশ্য কী?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
বিস্তারিত গাইড পড়ুনQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
বিস্তারিত গাইড পড়ুন