

Fama–MacBeth Regression: อธิบาย risk premium แบบสองขั้นตอน
ติดตามขั้นตอน Fama–MacBeth ตั้งแต่การประมาณ beta จากอนุกรมเวลา ไปจนถึง risk price แบบภาคตัดขวางในแต่ละวัน พร้อมแยกความต่างระหว่าง standard error, Shanken adjustment และ HAC inference
ในคู่มือนี้ประมาณราคาของ exposure ไม่ใช่ beta จากอนุกรมเวลาเพียงค่าเดียว
สรุปสั้น
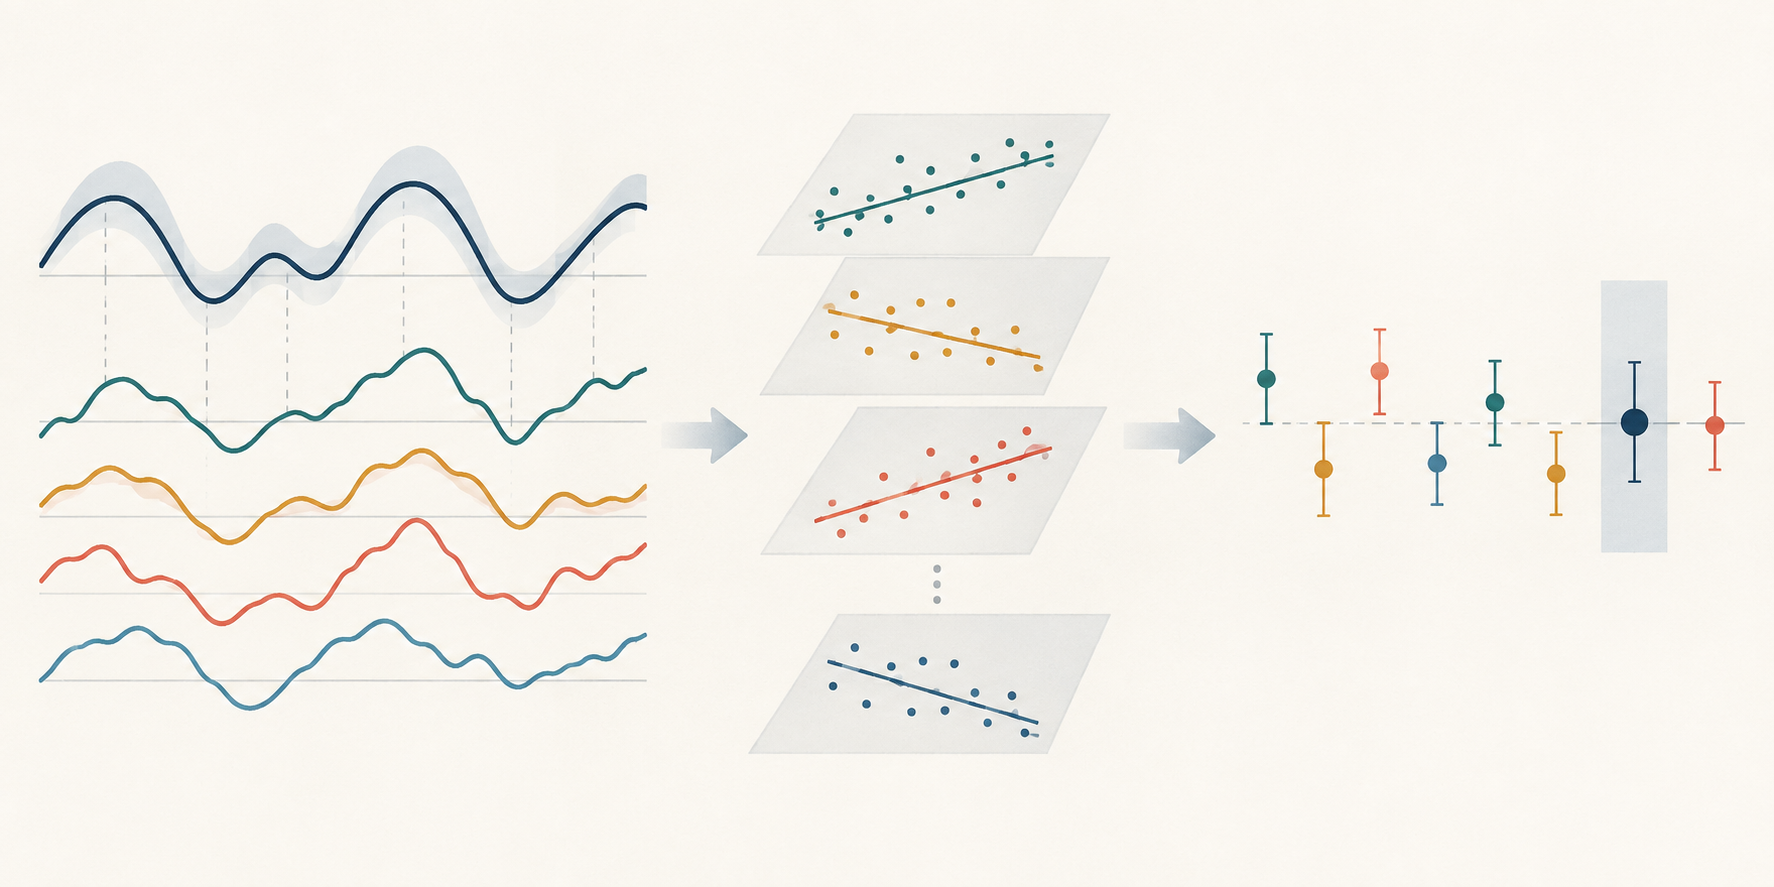
วิธี Fama–MacBeth ประมาณ exposure ต่อปัจจัยของสินทรัพย์ทดสอบแต่ละรายการจากอนุกรมเวลาของสินทรัพย์นั้น จากนั้นในแต่ละวันจะถดถอยผลตอบแทนของสินทรัพย์ตาม exposure ที่ประมาณได้ในภาคตัดขวาง แล้วนำ slope ของ risk price ที่ได้มาเฉลี่ยตามเวลา อนุกรมเวลาของ slope เป็นพื้นฐานของการคำนวณความไม่แน่นอนแบบทั่วไป อย่างไรก็ตาม standard error ของขั้นที่สองไม่ได้คำนึงถึง beta ที่ประมาณได้ การพึ่งพากันตามลำดับเวลา หรือโมเดลกำหนดราคาที่ระบุผิดโดยอัตโนมัติ risk price เฉลี่ยที่มีนัยสำคัญทางสถิติไม่ใช่ค่าประมาณกำไรจากการซื้อขาย
ประมาณราคาของ exposure ไม่ใช่ beta จากอนุกรมเวลาเพียงค่าเดียว
factor beta และ factor risk price ตอบคำถามคนละข้อ beta อธิบายว่าผลตอบแทนของสินทรัพย์เคลื่อนไหวร่วมกับปัจจัยอย่างไรใน time-series regression ขั้นแรก ส่วนค่าสัมประสิทธิ์ risk price ซึ่งมักเขียนเป็น \(\lambda\) อธิบายว่าใน cross-section ของขั้นที่สอง ผลตอบแทนต่างกันอย่างไรระหว่างสินทรัพย์ที่มี beta ประมาณได้ต่างกัน วิธี Fama–MacBeth ประมาณ risk price แยกตามวันที่ แล้วสรุปค่าประมาณเหล่านั้นตามเวลา
การออกแบบนี้มีประโยชน์เมื่อคำถามวิจัยคือ exposure ต่อปัจจัยเสี่ยงที่เสนอไว้สัมพันธ์กับผลตอบแทนเฉลี่ยของหุ้นหรือพอร์ตโฟลิโอที่เลือกมาหรือไม่ นี่เป็นวิธีทางสถิติสำหรับการกำหนดราคาสินทรัพย์ ไม่ใช่การออกแบบเพื่อระบุเหตุและผล และตัววิธีเองก็ไม่ได้ระบุพอร์ตโฟลิโอที่ซื้อขายได้โดยใช้เฉพาะข้อมูลที่มีอยู่ ณ เวลานั้น
งานดั้งเดิมของ Fama และ MacBeth ใช้การถดถอยความเสี่ยงกับผลตอบแทนแบบ cross-section ซ้ำ ๆ กับหุ้น NYSE งานภายหลัง รวมถึงการทดสอบเชิงประจักษ์ของ Fama และ French ทำให้ slope แบบภาคตัดขวางรายเดือนเป็นวิธีที่ใช้กันทั่วไปในการประมาณและทดสอบ risk price เฉลี่ย ควรเข้าใจวิธีนี้ว่าเป็นปัญหาการประมาณสองขั้นตอนที่เชื่อมโยงกัน โดยแต่ละขั้นมีสมมติฐานของตนเอง
ขั้นที่หนึ่ง: ประมาณ exposure ของสินทรัพย์ทดสอบแต่ละรายการ
สำหรับสินทรัพย์หรือพอร์ตโฟลิโอทดสอบ \(i\) แต่ละรายการ ให้ประมาณ time-series regression เช่น
\[ r^{e}_{i,t} = \alpha_i + \boldsymbol{\beta}_i^\top \mathbf{f}_t + \varepsilon_{i,t}, \]
โดย \(r^{e}_{i,t}\) คือผลตอบแทนส่วนเกินของสินทรัพย์ \(\mathbf{f}_t\) คือเวกเตอร์ผลตอบแทนปัจจัย ณ วันที่ \(t\) และ \(\boldsymbol{\beta}_i\) คือเวกเตอร์ exposure ค่า \(\hat{\boldsymbol{\beta}}_i\) ที่ประมาณได้จะกลายเป็นตัวแปรอธิบายในขั้นที่สอง ตัวอย่างที่ใช้เฉพาะตลาดมี beta หนึ่งค่า ส่วนตัวอย่างหลายปัจจัยจะมี loading ที่ประมาณได้หนึ่งค่าสำหรับแต่ละปัจจัย
ขั้นแรกต้องมีความแปรผันตามเวลาของปัจจัยเพียงพอสำหรับประมาณ slope หน้าต่างที่ยาวอาจมีข้อมูลมากขึ้น แต่รวมช่วงตลาดที่อยู่คนละ regime เข้าด้วยกัน หน้าต่างสั้นอาจสะท้อน exposure ช่วงล่าสุดได้ดีขึ้น แต่ทำให้ค่าประมาณ beta มี noise มากขึ้น ระบุความถี่ผลตอบแทน วันที่ตัวอย่าง วิธีสร้างปัจจัย กฎจัดการข้อมูลที่หายไป การจัดการ intercept และหน้าต่างประมาณค่า
นี่ไม่ใช่คำแนะนำทั่วไปให้ประมาณ beta ทุกค่าโดยใช้ตัวอย่างทั้งหมด ใน ex-post asset-pricing test ค่า beta จากตัวอย่างเต็มอาจใช้อธิบายตัวอย่างที่ศึกษาได้ แต่ใน historical trading simulation การใช้ beta ที่ประมาณจากข้อมูลอนาคตคือการรั่วไหลของข้อมูล การใช้งานแบบนั้นต้องประมาณ beta ณ แต่ละจุดเวลาโดยใช้ข้อมูลที่มีอยู่ก่อนการตัดสินใจจำลองเท่านั้น
ขั้นที่สอง: กำหนดราคาของ exposure ใน cross-section ของแต่ละวัน
ในแต่ละวันที่ \(t\) ให้ถดถอยผลตอบแทนของสินทรัพย์ทดสอบในวันนั้นตาม beta จากขั้นแรก:
\[ r^{e}_{i,t} = \lambda_{0,t} + \hat{\boldsymbol{\beta}}_i^\top \boldsymbol{\lambda}_t + \eta_{i,t}. \]
\(\boldsymbol{\lambda}_t\) มี risk price เฉพาะวันที่นั้น หากมีปัจจัยเดียว cross-sectional slope \(\lambda_t\) จะวัดส่วนต่างผลตอบแทนที่สัมพันธ์กับ beta ประมาณได้หนึ่งหน่วยในวันนั้น ส่วน \(\lambda_{0,t}\) เป็น intercept ของ cross-section แยกต่างหาก การประมาณแบบอิสระ การกำหนดข้อจำกัด หรือการตีความเป็นผลตอบแทนของสินทรัพย์ beta ศูนย์ ขึ้นอยู่กับโมเดลที่ทดสอบและการใช้ผลตอบแทนดิบหรือผลตอบแทนส่วนเกิน
การถดถอยขั้นที่สองเป็นการเปรียบเทียบสินทรัพย์ ณ วันเดียว ไม่ใช่ time-series regression อีกชุดหนึ่ง ความพอดีของโมเดลขึ้นอยู่กับจำนวนและองค์ประกอบของสินทรัพย์ทดสอบ การกระจายของ beta ที่ประมาณได้ และความสัมพันธ์ระหว่าง beta เหล่านั้น หาก beta แทบไม่ต่างกันระหว่างสินทรัพย์ cross-section ก็มีข้อมูลน้อยในการแยก risk price การเพิ่มสินทรัพย์จำนวนมากที่เกือบเหมือนกันไม่สร้างความแปรผันของ exposure ที่ไม่มีอยู่เดิม
การทำซ้ำ regression จะได้อนุกรม \(\hat{\boldsymbol{\lambda}}_1,\ldots,\hat{\boldsymbol{\lambda}}_T\) ค่า Fama–MacBeth estimate สำหรับปัจจัย \(k\) คือค่าเฉลี่ยตามเวลา
\[ \bar{\lambda}_k = \frac{1}{T}\sum_{t=1}^{T}\hat{\lambda}_{k,t}. \]
ค่าเฉลี่ยมีหน่วยและความถี่ผลตอบแทนเหมือนกับผลตอบแทนในขั้นที่สอง การถ่วงน้ำหนัก cross-section วันที่หายไป หรือการเปลี่ยน universe ของสินทรัพย์ ล้วนมีผลต่อความหมายของค่าเฉลี่ยนี้และควรรายงานไว้
ตัวอย่างแยกผลรายเดือนออกจากค่าเฉลี่ย
สมมติว่าค่าประมาณ market beta ขั้นแรกของพอร์ตโฟลิโอทดสอบสามชุดคือ \(0.5\), \(1.0\) และ \(1.5\) ในเดือนสมมติหนึ่งเดือน ผลตอบแทนส่วนเกินเท่ากับ \(0.3\%\), \(0.8\%\) และ \(1.3\%\) จุดทั้งสามอยู่บนเส้น
\[ r^{e}_{i,t} = -0.2\% + 1.0\%\times\hat{\beta}_{i}. \]
slope ที่ประมาณได้ของเดือนนั้นคือ 1.0 จุดเปอร์เซ็นต์ต่อ beta หนึ่งหน่วย และ intercept คือ \(-0.2\%\) นี่เป็นตัวอย่างขนาดเล็กที่ตั้งใจให้เห็นภาพและมีความพอดีสมบูรณ์ ไม่ได้พิสูจน์ว่า market beta มีราคา และจุดเพียงสามจุดก็ไม่ใช่การทดสอบเชิงประจักษ์ที่มีประโยชน์
สมมติว่า slope ขั้นที่สองในหกเดือนแยกกันมีค่า ต่อ beta หนึ่งหน่วย เท่ากับ \(0.8\%\), \(-0.4\%\), \(1.0\%\), \(-0.2\%\), \(0.6\%\) และ \(0.0\%\) ค่าเฉลี่ยเลขคณิตคือ
\[ (0.8 - 0.4 + 1.0 - 0.2 + 0.6 + 0.0)/6 = 0.3\%\text{ ต่อเดือน}. \]
slope ของเดือนแรกไม่ใช่ Fama–MacBeth estimate สุดท้าย ค่าประมาณคือค่าเฉลี่ยของ slope เฉพาะวันที่ทั้งหก ค่าในเดือนที่เป็นลบยังคงอยู่ในการคำนวณ การเลือกเฉพาะเดือนที่เป็นบวกจะเปลี่ยน estimand และเพิ่มขั้นตอนการคัดเลือกอีกชั้น ตัวเลขสมมติเหล่านี้แสดงเฉพาะวิธีคำนวณ ไม่ใช่ผลตลาดหรือคำกล่าวอ้างว่าปัจจัยทำนายผลตอบแทนได้
standard error ทั่วไปใช้เวลาเป็นมิติของการอนุมาน
ในการคำนวณอย่างง่ายที่สุด ให้นำส่วนเบี่ยงเบนมาตรฐานตัวอย่าง \(s_\lambda\) ของ slope รายเดือน \(T\) ค่า หารด้วย \(\sqrt{T}\):
\[ \operatorname{SE}(\bar{\lambda}) = \frac{s_\lambda}{\sqrt{T}}. \]
ค่า t-statistic ที่เกี่ยวข้องคือ slope เฉลี่ยที่ประมาณได้หารด้วย standard error นี้ มิติที่เกิดซ้ำสำหรับประเมินความไม่แน่นอนของ risk price เฉลี่ยคือเวลา จำนวนสินทรัพย์ \(N\) กำหนดว่า cross-section รายเดือนประมาณ slope ได้ดีเพียงใด แต่ใช้แทน \(T\) ใน standard error ของค่าเฉลี่ยตามเวลาไม่ได้
สำหรับ slope ตัวอย่างทั้งหก ส่วนเบี่ยงเบนมาตรฐานตัวอย่างอยู่ที่ประมาณ 0.576 จุดเปอร์เซ็นต์ต่อเดือน เมื่อหารด้วย \(\sqrt{6}\) จะได้ standard error ทั่วไปราว 0.235 จุดเปอร์เซ็นต์ และ \(0.3/0.235\) ประมาณ 1.28 ข้อมูลเพียงหกจุดน้อยเกินไปสำหรับประเมินนัยสำคัญอย่างน่าเชื่อถือ การคำนวณนี้แสดงเพียงว่าค่าเฉลี่ยเป็นบวกไม่ได้แปลว่าประมาณได้อย่างแม่นยำ
standard error ทั่วไปยังขึ้นอยู่กับคุณสมบัติของอนุกรมเวลา slope ด้วย หากค่าประมาณมี serial dependence standard error ที่สมมติว่าข้อมูลเป็นอิสระอาจประเมินความไม่แน่นอนผิดพลาด หากตัวอย่างสั้นหรือองค์ประกอบสินทรัพย์เปลี่ยน ค่า asymptotic t-statistic อาจเปราะบางเป็นพิเศษ ให้รายงานความยาวและความถี่ของอนุกรม \(\lambda_t\) ไม่ใช่เฉพาะจำนวนสินทรัพย์ใน cross-section
Fama–MacBeth กับ pooled OLS ไม่ได้ให้ point estimate ต่างกันเสมอไป
มักเปรียบเทียบ “Fama–MacBeth” กับ “pooled panel regression” ราวกับว่าความชันต้องต่างกัน มีกรณีพิเศษที่สำคัญ: หากมีสินทรัพย์ชุดเดิมในทุกวัน ตัวแปร beta คงที่ตามเวลา และ cross-section รายเดือนทุกชุดใช้ดีไซน์ ordinary least squares แบบเดียวกัน ค่าเฉลี่ยของ OLS coefficient รายวันจะเท่ากับ common-slope coefficient ของ pooled OLS ทั้งสองวิธีสรุปชุด cross-sectional regressions แบบสมดุลชุดเดียวกัน
ความเท่ากันอาจไม่เกิดขึ้นเมื่อชุดสินทรัพย์หรือน้ำหนักเปลี่ยนตามวันที่ beta เปลี่ยนตามเวลา panel ไม่สมดุล ใช้ controls ต่างกัน หรือ pooled model เพิ่มข้อจำกัด ในกรณีเหล่านั้น วิธีต่าง ๆ อาจให้น้ำหนักวันที่หรือข้อมูลไม่เหมือนกันและตอบคำถามเกี่ยวกับตัวอย่างคนละข้อ อย่าเลือกวิธีจากชื่อเพียงอย่างเดียว ให้ระบุ design matrix วิธีถ่วงน้ำหนัก และ coefficient เป้าหมายให้ชัดเจน
แม้ point estimate จะตรงกัน การคำนวณความไม่แน่นอนก็อาจต่างกัน Fama–MacBeth inference ใช้ความแปรผันตามเวลาของ slope ใน cross-section ส่วน pooled regression ต้องใช้ covariance estimator ที่ตรงกับโครงสร้างข้อผิดพลาดของ panel การจัดกลุ่มตามวันที่หรือตามสินทรัพย์ การประมาณ covariance แบบสองทาง และ time-series HAC ต่างมีสมมติฐานของตนเอง การเรียกโมเดลว่า pooled หรือ Fama–MacBeth ไม่ได้ทำให้วิธีใดถูกต้องขึ้นเอง
beta ที่ประมาณได้และ HAC จัดการความไม่แน่นอนคนละแหล่ง
ขั้นที่สองปฏิบัติต่อ \(\hat{\boldsymbol{\beta}}_i\) ราวกับเป็นค่าที่ทราบ ทั้งที่มาจาก regression ที่ประมาณในขั้นแรก ความคลาดเคลื่อนในตัวแปรที่สร้างขึ้นอาจกระทบ risk-price estimate และความไม่แน่นอน การวิเคราะห์ของ Shanken อนุมาน adjustment สำหรับการทดสอบ beta-pricing ภายใต้การตั้งค่า asset-pricing ที่ระบุไว้ ไม่ใช่ตัวคูณสากลที่แก้การออกแบบสองขั้นตอนทุกแบบ งานภายหลังศึกษาพฤติกรรมตัวอย่างขนาดใหญ่และ estimator ทางเลือกภายใต้เงื่อนไขอื่น ระบุ correction หรือวิธี inference ที่ใช้ พร้อมสมมติฐานที่ทำให้วิธีนั้นเกี่ยวข้อง
serial correlation ใน \(\hat{\lambda}_{k,t}\) เป็นอีกปัญหาหนึ่ง ตัวอย่างเช่น ผลตอบแทนหลายเดือนที่ทับซ้อนกันอาจทำให้ slope ของวันที่ติดกันใช้ข้อมูลผลตอบแทนบางรายการร่วมกัน estimator ที่ทนต่อ heteroskedasticity และ autocorrelation เช่น covariance estimate ของ Newey–West จะปรับ variance โดยประมาณของค่าเฉลี่ยตามเวลาให้คำนึงถึง serial dependence จนถึงช่วง lag ที่เลือก วิธีนี้ไม่ได้ใส่ความคลาดเคลื่อนจากการประมาณ beta ขั้นแรกกลับเข้าไปในขั้นที่สอง ไม่แก้การระบุ factor model ผิด และไม่แก้ look-ahead bias ในทางกลับกัน Shanken adjustment ก็ใช้แทนการตรวจ dependence ในอนุกรม lambda ไม่ได้
Jagannathan และ Wang รวมถึง Shanken และ Zhou วิเคราะห์คุณสมบัติของขั้นตอน beta-pricing ภายใต้เงื่อนไขของโมเดลและการสุ่มตัวอย่างบางแบบ ผลงานเหล่านี้เป็นเหตุผลให้บรรยายการออกแบบสองขั้นตอนจริง แทนการพูดกว้าง ๆ ว่า Fama–MacBeth standard error แบบทั่วไปเล็กเกินไปเสมอหรือถูกต้องเสมอ ให้รายงานว่าประมาณ beta ครั้งเดียวหรืออัปเดตเป็นระยะ จัดการ dependence ของอนุกรม lambda อย่างไร ใช้ correction สำหรับ beta ที่ประมาณได้หรือไม่ และเหตุใดทางเลือกนั้นจึงตรงกับคำถาม
risk price เฉลี่ยที่มีนัยสำคัญไม่ใช่ค่าประมาณกำไรจากการเทรด
ค่าเฉลี่ย \(\lambda\) ที่เป็นบวกและแตกต่างจากศูนย์อย่างมีนัยสำคัญทางสถิติหมายความว่า ภายใต้ universe ของสินทรัพย์ทดสอบ นิยามปัจจัย beta estimates และวิธีอนุมานที่เลือก สินทรัพย์ที่มี exposure โดยประมาณสูงกว่าให้ผลตอบแทนเฉลี่ยสูงกว่าในตัวอย่าง ไม่ได้แสดงว่านักลงทุนจะได้ส่วนต่างนี้หลังหักต้นทุน ปัจจัยดังกล่าวเป็นแหล่งผลตอบแทนเชิงสาเหตุ หรือ pricing model ถูกต้อง
ผลลัพธ์อาจเปลี่ยนตามชุดปัจจัย ช่วงตัวอย่าง การสร้างพอร์ตโฟลิโอ หน้าต่าง beta สินทรัพย์ทดสอบ หรือวิธีถ่วงน้ำหนัก การค้นหาจากปัจจัย ช่วงตัวอย่างย่อย และ specification จำนวนมากเพิ่มปัญหาการทดสอบหลายครั้ง การทดสอบ risk price ที่ประมาณได้เพียงหนึ่งค่าก็ไม่ได้สรุป pricing error ร่วมของสินทรัพย์ทุกตัว ระบุให้ชัดว่าผลเป็น conditional association, model-based pricing test หรือการพยากรณ์นอกตัวอย่าง อย่าใช้คำเหล่านี้แทนกัน
สำหรับกลยุทธ์จริงหรือจำลอง ต้องสร้าง exposure และน้ำหนักพอร์ตโดยใช้ข้อมูลที่มีอยู่ ณ เวลานั้นเท่านั้น นอกจากนี้ยังต้องมีราคาเข้าซื้อที่ดำเนินการได้ turnover ต้นทุนการซื้อขาย เงินทุน ความจุ และกฎปรับสมดุลพอร์ต factor beta เป็นค่าประมาณ exposure ส่วนค่าเฉลี่ย \(\lambda\) ไม่ใช่ผลตอบแทนของพอร์ตที่ได้รับ beta premium นั้นโดยอัตโนมัติ อ่านต่อที่ คู่มือ factor loading และ factor model, คู่มือ robust standard error และ HAC และ คู่มือ rank information coefficient
รายงานดีไซน์ให้ผู้อื่นทำซ้ำได้
ผลที่ตีความได้ควรระบุสินทรัพย์ทดสอบ ผลตอบแทนปัจจัย อนุกรม risk-free หากใช้ หน่วยผลตอบแทน ความถี่ของวันที่ และช่วงตัวอย่าง พร้อมบันทึกว่าแต่ละ beta ประมาณอย่างไร หน้าต่างของขั้นแรกทับซ้อนกับช่วงทดสอบของขั้นที่สองหรือไม่ แต่ละวันมีสินทรัพย์ใดบ้าง จัดการผลตอบแทนที่หายไปและการเปลี่ยนสมาชิกอย่างไร ถ่วงน้ำหนัก cross-section หรือไม่ และใส่หรือจำกัด intercept อย่างไร
ด้าน inference ให้รายงานจำนวน slope เฉพาะวันที่ทั้งหมด \(T\) ค่าเฉลี่ยและการกระจายตามเวลา estimator ของ standard error ค่า HAC bandwidth หากใช้ correction สำหรับ beta estimation และการเลือกวิธีสำหรับตัวอย่างจำกัด แสดงการกระจายของ beta และ cross-sectional fit พร้อม t-statistic จำนวนสินทรัพย์มากไม่สามารถชดเชย exposure ที่แทบเหมือนกันได้ เปรียบเทียบหน้าต่าง นิยามปัจจัย และองค์ประกอบสินทรัพย์ทดสอบทางเลือกที่สมเหตุสมผล โดยไม่เลือกเฉพาะแบบที่บังเอิญให้ p-value ต่ำสุด
วิธีดั้งเดิมและการประยุกต์เป็นตัวอย่าง ไม่ใช่หลักประกันว่าชุดข้อมูลสมัยใหม่ทุกชุดจะตรงตามสมมติฐาน งาน ปี 1973 ของ Fama และ MacBeth, cross-sectional tests ปี 1992 ของ Fama และ French, การวิเคราะห์ beta-pricing ของ Shanken, การวิเคราะห์ asymptotic ของ Jagannathan และ Wang, การเปรียบเทียบ beta-pricing estimator ของ Shanken และ Zhou และ วิธี HAC covariance ของ Newey และ West พิจารณาคนละส่วนของดีไซน์ อ่านสมมติฐานควบคู่กับ coefficient ที่รายงาน
คำถามที่พบบ่อย
Q1Fama–MacBeth regression เป็นการทดสอบเหตุและผลหรือไม่?
ไม่ วิธีนี้ประมาณความสัมพันธ์ระหว่าง exposure ที่ประมาณได้กับผลตอบแทน ภายใต้ pricing model และ test-asset design ที่เลือก การตีความเชิงสาเหตุต้องมีเหตุผลด้าน identification แยกต่างหาก
Q2การเพิ่มสินทรัพย์ทำให้ค่าประมาณ risk price แม่นยำขึ้นเสมอหรือไม่?
ไม่ สินทรัพย์ที่เพิ่มอาจช่วย cross-section ของวันหนึ่ง แต่ความแม่นยำยังขึ้นอยู่กับว่า beta ต่างกันมากเพียงใด ประมาณ beta ได้แม่นแค่ไหน และมีวันที่ร่วมในการเฉลี่ยกี่วัน
Q3ควรใช้ HAC standard error เมื่อใด?
พิจารณาใช้เมื่ออนุกรม risk price เฉพาะวันอาจมี heteroskedasticity หรือ serial dependence เช่น กรณีผลตอบแทนทับซ้อน ระบุ lag window และจำไว้ว่า HAC ไม่แก้ error จากการประมาณ beta ในขั้นแรก
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
ในกระบวนการสองขั้นตอนมาตรฐาน slope ขั้นที่สอง ณ วันที่ t ประมาณค่าอะไร?
เลือกคำตอบเพื่อดูคำอธิบาย
อภิธานศัพท์ออปชัน
A model decomposing asset returns into exposure to a small set of common factors and an asset-specific residual.
อ่านคู่มือฉบับละเอียดHeteroskedasticityVariation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
อ่านคู่มือฉบับละเอียดAt the moneyA call or put whose strike is near the underlying price; it has little intrinsic value and often substantial sensitivity to time and volatility.
อ่านคู่มือฉบับละเอียด