

Volatilidade Realizada por Pre-Averaging: Um Estimador com Ruído de Microestrutura
Entenda como o pre-averaging suaviza janelas curtas de retornos de alta frequência, corrige o principal viés de ruído, orienta a escolha da janela e difere de TSRV e realized kernels.
Neste guiaPor que retornos muito frequentes podem distorcer a variação dos preços
Resumo breve
Pre-averaging estima a variação dos preços quando preços registrados com muita frequência contêm ruído de microestrutura. Em vez de elevar ao quadrado cada retorno bruto, o método forma somas ponderadas e sobrepostas de retornos próximos, eleva essas somas ao quadrado e subtrai um termo para a principal contribuição do ruído. O resultado depende do formato dos pesos, do tamanho da janela, do desenho de amostragem e das hipóteses sobre o ruído. Ele mede a variação no intervalo observado; não é uma previsão de volatilidade nem um sinal de negociação.
Por que retornos muito frequentes podem distorcer a variação dos preços
Se o preço observado coincidisse com o preço eficiente, somar os retornos intradiários ao quadrado seria uma forma natural de estimar a variação durante a sessão. Preços de transação e cotações também refletem alternância entre bid e ask, arredondamento ao tamanho mínimo do tick, latência, discretização dos preços e convenções de registro. Quando o intervalo de amostragem fica muito curto, esses efeitos podem representar uma parcela grande de cada retorno ao quadrado. Acrescentar observações pode, então, aumentar a contribuição do ruído em vez de simplesmente revelar mais movimentos do preço subjacente.
O pre-averaging aborda esse problema ao combinar retornos em uma janela local curta antes de elevá-los ao quadrado. Uma função de peso suave começa em zero, dá peso aos retornos vizinhos e volta a zero na borda da janela. A soma ponderada age como um filtro local: erros de observação independentes e rápidos podem se cancelar parcialmente, enquanto movimentos mais amplos do preço eficiente podem permanecer. Janelas sobrepostas permitem usar informações ao longo de todo o intervalo.
A suavização, por si só, não torna um estimador não viesado. Os retornos filtrados ao quadrado ainda contêm variação causada pelo ruído, por isso é necessário um termo de correção. Jacod, Li, Mykland, Podolskij e Vetter desenvolvem uma abordagem de pre-averaging para volatilidade integrada sob hipóteses explícitas e mostram que versões adequadas atingem taxa de convergência \(n^{-1/4}\). O artigo original fundamenta o método; este guia trata de sua mecânica, escolhas e limitações.
Separe o preço latente, o preço registrado e o alvo
Seja \(X_{t_i}\) o logaritmo do preço eficiente latente no instante de observação \(t_i\), e \(Y_{t_i}\) o logaritmo do preço registrado:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
em que \(\epsilon_{t_i}\) representa o ruído de observação. Um modelo-base comum trata \(X_t\) como uma semimartingala contínua com variância local \(\sigma_t^2\). O alvo em um intervalo fixo \([0,T]\) é a variância integrada:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
O retorno observado se decompõe em \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\). Mesmo que os erros de preço sejam independentes entre observações, os erros de retornos adjacentes compartilham o erro de um ponto final com sinais opostos. Isso cria dependência serial nos retornos e torna a variância realizada com todas as observações sensível ao número de incrementos ruidosos.
A explicação teórica mais simples costuma supor ruído centrado, independente ao longo do tempo e do processo de preço eficiente, com momentos finitos adequados. Essas hipóteses ajudam a explicar o estimador, mas não são garantidas para transações, cotações ou preços médios. O ruído pode variar com a liquidez e o horário, depender do preço eficiente ou apresentar dependência serial. O alvo relatado também importa: com saltos, a variação quadrática inclui os quadrados dos saltos, mas a variância integrada contínua não.
Esta é uma medida ex post para uma série de preços e uma janela de tempo especificadas. Ela não reconstrói cada preço latente, não identifica qual registro individual estava errado nem indica qual será a volatilidade futura. Antes de comparar estimativas, informe se a entrada usa preços de transação, preços médios entre bid e ask ou outra construção.
Construa retornos pre-averaged sobrepostos
Para \(n\) retornos observados \(r_i=Y_{t_i}-Y_{t_{i-1}}\), escolha um tamanho inteiro de janela \(k_n\) e uma função de peso \(g\) em \([0,1]\). Uma definição padrão de retorno pre-averaged é
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
Em geral, a função é contínua, vale zero nos dois extremos e tem suavidade suficiente para os resultados assintóticos. Um exemplo triangular é \(g(u)=\min(u,1-u)\). Como os pesos nas extremidades são zero, os retornos na borda da janela não recebem abruptamente peso máximo. O formato dos pesos é um filtro local, não uma previsão ou tendência estimada.
Cada \(\bar r_i\) combina retornos adjacentes antes de elevá-los ao quadrado. Como as janelas se sobrepõem, os retornos pre-averaged são correlacionados mesmo quando os retornos brutos não são. Essa dependência faz parte do comportamento amostral do estimador; as muitas somas de janela não devem ser tratadas como observações independentes. O intervalo dos índices das janelas e a convenção para as extremidades precisam corresponder à normalização usada com os pesos.
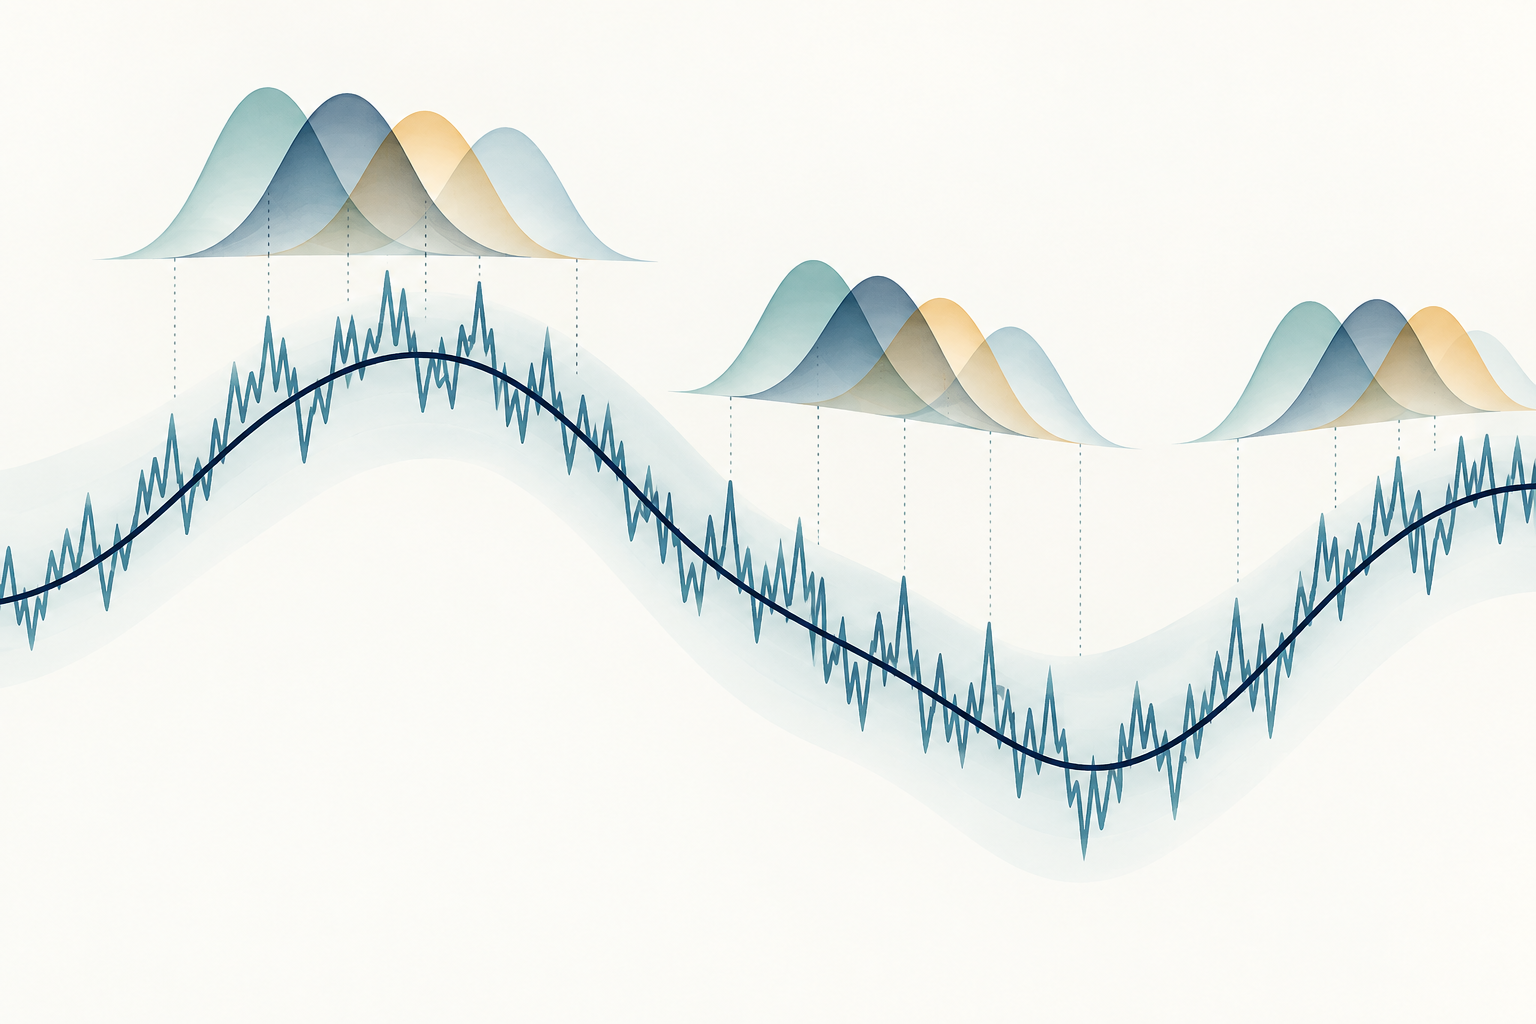
A figura mostra uma trajetória latente suave, uma trajetória observada irregular e várias janelas sobrepostas com pesos atenuados nas bordas. É uma explicação do agrupamento local, não um registro de preços amostral nem o resultado empírico de um filtro.
<!-- learn:illustration --> <!-- Conceito sem texto: curva suave do preço latente ao lado de uma trajetória observada irregular, com janelas locais sobrepostas e afuniladas que agrupam movimentos próximos. Apenas conceitual; não são dados de mercado, previsão ou sinal de negociação. -->
Corrija a contribuição de ruído que permanece
O pre-averaging reduz a influência de erros de observação rápidos, mas os retornos filtrados ao quadrado ainda contêm uma contribuição de ruído. Em uma grade regular, uma forma comum do estimador univariado com normalizadores assintóticos é
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
em que as constantes dos pesos são
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
O primeiro termo reescala a soma dos retornos pre-averaged ao quadrado para aproximá-la da variância integrada. O segundo estima e subtrai, sob o modelo, a principal contribuição do ruído de observação. Ele não estima cada realização do ruído nem corrige uma coluna de preços errada, um horário incorreto ou um valor atípico. A fórmula exata em amostras finitas pode usar versões discretas de \(\psi_1\) e \(\psi_2\), ajustes nas extremidades e uma convenção específica para o índice dos retornos. Esses detalhes devem ser informados e mantidos consistentes.
A correção pode produzir uma estimativa pequena ou negativa em amostras finitas. Isso não significa que o ativo teve variância física negativa; significa que, naquela amostra, a correção escolhida excedeu o primeiro termo. Não substitua silenciosamente uma estimativa negativa por zero. Informe o cálculo original e qualquer regra de truncamento aplicada separadamente, pois truncar altera o estimador e pode afetar médias ou inferências posteriores.
Escolha o tamanho da janela considerando o ruído e a amostra
O tamanho \(k_n\) controla a intensidade da suavização. Se for curto demais, os retornos filtrados ainda conterão mais ruído de alta frequência. Se for longo demais, a variação local dos preços será agregada em uma faixa de tempo maior e haverá menos janelas contribuindo, o que pode aumentar outras formas de erro de estimação. Os pesos e o tamanho da janela atuam em conjunto; um valor de \(k_n\) não faz sentido sem a função de peso e o intervalo de amostragem.
No desenho clássico balanceado, com horizonte temporal fixo e \(n\) observações cada vez mais frequentes, a janela cresce na ordem de \(\sqrt n\), muitas vezes escrita como \(k_n\sim\theta\sqrt n\), para uma constante positiva de ajuste \(\theta\). Sob as hipóteses do artigo, o estimador pode convergir à taxa \(n^{1/4}\), ou ter erro de estimação da ordem de \(n^{-1/4}\). Essa taxa é mais lenta que \(n^{1/2}\) no caso sem ruído e é ótima no cenário ruidoso-base estudado pelos autores; não é uma promessa para todo conjunto de dados de mercado.
A constante \(\theta\), a função de peso e qualquer procedimento de escolha baseado nos dados afetam viés e variância em amostras finitas. Uma escolha automática pode depender de estimativas de ruído e volatilidade que também são incertas. Mostre a sensibilidade a janelas razoáveis, explique a convenção de tempo de amostragem e os limites da sessão, e não escolha a janela depois de ver qual resultado favorece uma conclusão desejada.
Um pequeno cálculo hipotético
Considere seis retornos observados hipotéticos, em pontos-base:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
Use um peso triangular \(g(u)=\min(u,1-u)\) e uma janela deliberadamente curta \(k=3\). Os dois pesos internos da grade que não são zero são \(g(1/3)=g(2/3)=1/3\). Para uma ilustração aritmética em uma grade finita, defina
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
Com a convenção de índices acima, há \(n-k+2=5\) janelas sobrepostas. Cada uma combina um retorno próximo de \(1\) bp e outro de \(0\) bp; logo, \(\bar r_i=(1/3)(1+0)=1/3\) bp e
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
Usando a normalização correspondente para a grade finita, obtemos
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
O exemplo verifica a aritmética e as unidades; seis retornos e uma janela curta na escala de três observações são insuficientes para justificar a aproximação assintótica. Os valores foram escolhidos para deixar o cálculo transparente. Não são dados de mercado, um processo de ruído simulado nem evidência de que a estimativa recuperou a variância integrada latente. Não há cálculo de erro-padrão ou previsão.
Entenda as hipóteses da correção
A derivação padrão foi concebida para um processo contínuo de preço eficiente observado com frequência sob ruído aditivo e condições de regularidade. Um exemplo com ruído centrado e independente é um ponto de partida útil, mas dependência entre ruído e preço, erros serialmente correlacionados, ruído variável no tempo, horários de observação irregulares ou amostragem endógena podem exigir um estimador modificado ou uma teoria específica. Aït-Sahalia, Mykland e Zhang estudam a estimação de volatilidade integrada sob ruído de microestrutura dependente; o artigo mostra por que a fórmula para ruído iid não é universal.
Saltos levantam uma questão distinta sobre o alvo. Se o objeto for variação quadrática, os quadrados dos saltos fazem parte dela; se for variância integrada contínua, não. Um estimador padrão de pre-averaging não separa saltos automaticamente. Truncamento robusto a saltos ou outra construção requer suas próprias hipóteses e parâmetros. Uma operação isolada extrema também pode afetar várias janelas sobrepostas, por isso a validação dos dados e o tratamento de valores atípicos continuam necessários.
O pre-averaging tampouco resolve sozinho todos os problemas de dados multivariados ou assíncronos. Christensen, Kinnebrock e Podolskij desenvolvem métodos de covariância por pre-averaging e uma extensão Hayashi–Yoshida robusta a ruído para observações não síncronas em seu estudo. Essas construções tratam questões adicionais do desenho dos dados. Aplicar uma fórmula univariada separadamente a cada ativo não sincroniza horários automaticamente nem garante uma matriz de covariância válida.
Diferencie pre-averaging de TSRV e realized kernels
Esses estimadores tratam problemas relacionados de variação em alta frequência, mas organizam as informações de maneiras diferentes. A volatilidade realizada de duas escalas, ou TSRV, calcula a média de estimativas em grades de amostragem esparsas e deslocadas e subtrai uma estimativa escalada da grade fina para corrigir o principal viés de ruído. O pre-averaging, por sua vez, filtra janelas curtas e sobrepostas de retornos com pesos suaves, eleva os retornos filtrados ao quadrado e aplica uma correção correspondente. O artigo original de duas escalas apresenta essa construção distinta.
Um realized kernel parte da soma dos retornos ao quadrado e acrescenta autocovariâncias ponderadas dos retornos em várias defasagens. A largura de banda controla o alcance das defasagens incluídas. Já o pre-averaging modifica retornos locais antes de elevá-los ao quadrado. Ambos usam pesos e parâmetros de ajuste, mas fórmulas, normalizações e hipóteses não são intercambiáveis. O guia de realized kernels explica a construção baseada em defasagens e a largura de banda.
A escolha deve acompanhar os dados e a quantidade de interesse, não o nome do estimador. Compare o desenho de amostragem, o modelo de ruído, o tratamento das extremidades, o alvo na presença de saltos e o desempenho em amostras finitas. A robustez assintótica não garante que o método seja o melhor para ativos esparsos, sessões curtas, ruído variável ou uma fonte de dados irregular. O guia de two-scale explica suas escolhas de escala e correção.
Relate uma medida do intervalo, não uma conclusão de negociação
Para reproduzir o resultado, informe o ativo e o campo de preço, o intervalo de tempo, a frequência de amostragem, as regras de horário e sessão, as unidades dos retornos, a função de peso, o tamanho da janela, a normalização, a convenção para as extremidades e as hipóteses sobre o ruído. Se a estimativa for usada para inferência, informe também o estimador de variância ou o procedimento de intervalo de confiança e as hipóteses necessárias. Uma tabela de sensibilidade para janelas razoáveis pode mostrar se a conclusão depende de uma única escolha de ajuste.
A variância integrada mede o intervalo de observação já concluído. A raiz quadrada expressa uma escala de volatilidade para esse mesmo intervalo; anualizá-la acrescenta uma convenção de tempo, mas não a transforma em previsão. Prever um horizonte futuro exige um modelo preditivo separado e avaliação fora da amostra. O guia de cálculo da volatilidade realizada explica o referencial básico de soma de retornos ao quadrado, enquanto o guia de variação quadrática distingue a variação do caminho do alvo de variância integrada contínua.
A estimativa não estabelece por que o preço se moveu, não identifica uma estratégia lucrativa nem garante uma medida de risco de execução. Custos de negociação, liquidez, saltos, dinâmica da volatilidade e incerteza da estimação são questões separadas. Pre-averaging é uma ferramenta de medição estatística cujo valor depende de as hipóteses declaradas corresponderem aos dados observados.
Perguntas frequentes
Q1Pre-averaging é o mesmo que calcular uma média móvel dos preços?
Não. O estimador forma somas ponderadas de retornos próximos, depois as eleva ao quadrado e aplica uma correção. Tirar a média dos níveis de preço e calcular diferenças é outra transformação, com pesos e comportamento de borda distintos.
Q2Pre-averaging elimina todo o ruído de microestrutura?
Não. Ele reduz o efeito principal sob hipóteses específicas de ruído e amostragem. Ruído dependente ou variável, saltos, valores atípicos e problemas de horário ainda podem afetar o resultado.
Q3Por que duas estimativas de pre-averaging podem diferir?
Elas podem usar funções de peso, tamanhos de janela, normalizações em amostra finita, campos de preço, regras de extremidade ou procedimentos de limpeza diferentes. Essas escolhas devem ser informadas e analisadas quanto à sensibilidade.
Q4Uma estimativa de pre-averaging é uma previsão de volatilidade?
Não por si só. Ela mede a variação no intervalo usado em seu cálculo. Uma previsão exige um modelo preditivo separado e avaliação fora da amostra.
Fontes e leituras adicionais
Relatar um problema
Vamos preparar um e-mail com o link deste artigo. Mark só receberá o relato depois que você enviar
Verificação rápida
Terminou o guia? Confira o que aprendeu com 3 perguntas
Pergunta 01
Qual é o principal objetivo de formar retornos pre-averaged?
Escolha uma resposta para ver a explicação
Glossário de opções
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Ler o guia completoQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
Ler o guia completo