Regresión MIDAS: datos de frecuencias mixtas y pronóstico de volatilidad
Aprende cómo MIDAS combina datos financieros diarios y semanales con ponderaciones parsimoniosas de rezagos, cómo construir un pronóstico de volatilidad y cuándo puede inducir a error.
En esta guíaMIDAS aborda la diferencia entre frecuencias de observación
Resumen breve
MIDAS (muestreo de datos mixtos) conecta observaciones registradas con frecuencias distintas sin forzar primero todas las series a un mismo calendario. Un pequeño número de parámetros estimados pondera el historial de observaciones de mayor frecuencia y puede ayudar a pronosticar una variable financiera de menor frecuencia. Las ponderaciones describen un patrón predictivo bajo el modelo elegido; no demuestran causalidad ni una ventaja de trading.
MIDAS aborda la diferencia entre frecuencias de observación
Los datos financieros y económicos no llegan con el mismo reloj. Un objetivo de volatilidad puede medirse semanalmente, mientras que sus posibles predictores son rendimientos diarios o medidas realizadas intradía. Una serie macroeconómica puede ser trimestral, mientras el precio de un activo se observa cada día bursátil. Una regresión ordinaria espera una fila por observación para el objetivo y sus predictores, por lo que antes de estimarla hay que decidir cómo tratar esos calendarios diferentes.
Una opción es agregar las entradas diarias en un promedio o una suma semanal. Es sencillo, pero impone un peso concreto a cada día y puede perder en qué momento de la semana ocurrió un movimiento. Otra opción es repetir un valor trimestral en filas diarias o interpolarlo. La repetición puede hacer que un dato de evolución lenta parezca muchas observaciones nuevas; la interpolación puede crear una trayectoria suave que nunca se observó. Ninguna operación aporta información nueva.
MIDAS ofrece una forma directa de conectar las frecuencias. Mantiene el objetivo en su frecuencia natural más baja e incorpora rezagos estructurados de la serie de mayor frecuencia. El nombre alude al muestreo de datos mixtos, no a un único modelo de volatilidad. Las regresiones MIDAS se usan para pronosticar volatilidad y en otros casos en los que los predictores se muestrean con más detalle que el resultado. La pregunta central es cuánto del historial reciente de alta frecuencia incluir y cómo restringir sus ponderaciones.
Un rezago ponderado convierte muchas observaciones en un predictor compacto
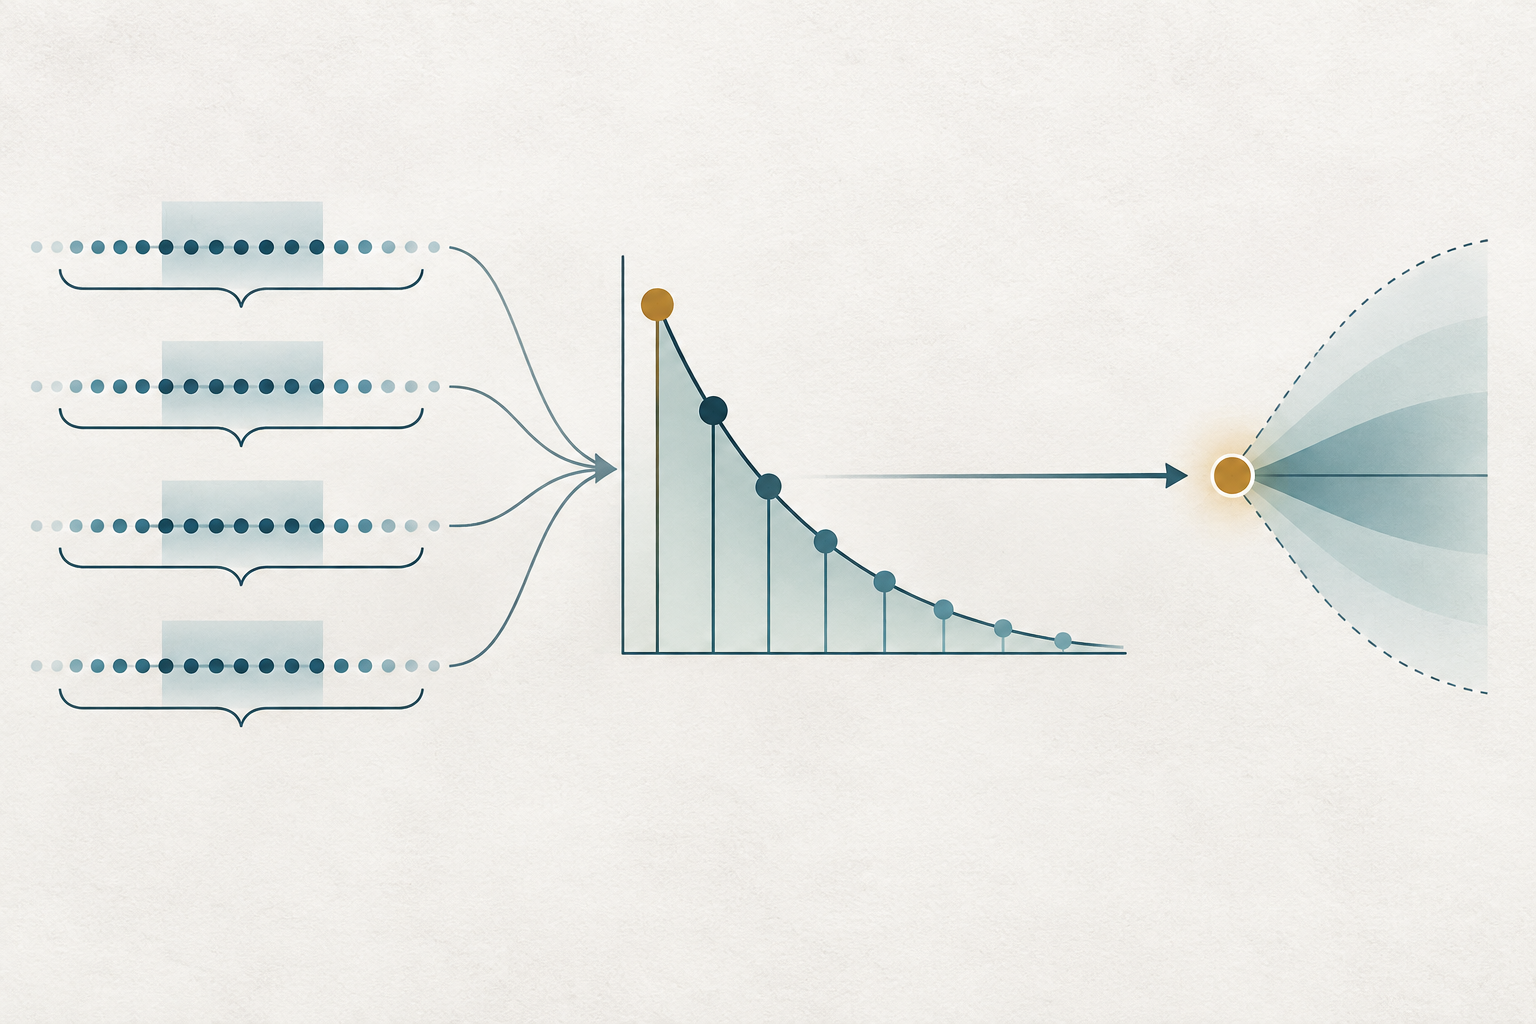
Sea \(y_{t+1}\) un objetivo de menor frecuencia, como la varianza realizada de la próxima semana, que se observa una vez concluida esa semana. Sea \(x_{t-j}\) un predictor diario observado \(j\) sesiones bursátiles antes del origen del pronóstico al cierre de la semana \(t\). Una regresión MIDAS sencilla es \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), donde \(K\) es el número de rezagos diarios, \(w_j(\theta)\) es una ponderación determinada por pocos parámetros y \(u_{t+1}\) es el error de pronóstico.
Las ponderaciones suelen normalizarse de modo que \(\sum_{j=1}^{K}w_j(\theta)=1\). Así, la suma se interpreta con facilidad como un historial ponderado, mientras \(b\) controla la intensidad de su relación con el objetivo. La normalización no implica que las observaciones diarias sean independientes o igual de informativas. Es una parametrización práctica del perfil de rezagos.
El analista puede elegir \(x\) como rendimientos diarios al cuadrado, rendimientos absolutos, una medida de varianza realizada construida con rendimientos intradía u otra variable disponible al origen del pronóstico. \(y\) podría ser la varianza semanal futura, una publicación macroeconómica mensual u otro objetivo de menor frecuencia. La definición del objetivo determina el significado de los coeficientes. Un modelo para una aproximación de varianza realizada no es automáticamente un modelo de varianza instantánea latente, varianza implícita en opciones o rentabilidad de precios.
MIDAS es un marco de regresión, no un estimador universal. La respuesta puede modelarse en niveles, logaritmos o mediante una función de enlace; la estimación depende de la familia de ponderaciones y los supuestos sobre errores elegidos. Una regresión lineal de una aproximación de varianza no negativa puede producir valores ajustados negativos si no se restringe el pronóstico o se transforma el objetivo. La comodidad del modelo no elimina la necesidad de comprobar el soporte y las unidades del objetivo.
La función de ponderación intercambia flexibilidad por estabilidad
Una regresión de retardos distribuidos sin restricciones estima un coeficiente distinto para cada una de las \(K\) entradas diarias. Si \(K\) es grande respecto del número de observaciones semanales del objetivo, las estimaciones pueden ser ruidosas y estar muy correlacionadas. MIDAS define los coeficientes de rezago mediante una función de baja dimensión. Un perfil ilustrativo de Almon exponencial es \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). También es común usar un perfil polinómico Beta normalizado.
Estos perfiles pueden dar más peso a las sesiones recientes, reducirlo gradualmente o asignar relativamente más peso a una parte intermedia de la ventana. Los parámetros describen la curva suave elegida, no la importancia de cada día sin condiciones. Si los datos respaldan una respuesta breve, pero la función elegida impone una cola larga y suave, los coeficientes estimados heredan esa restricción. En cambio, estimar muchos coeficientes diarios libres puede ajustar ruido en lugar de una dinámica estable.
Las restricciones de ponderación son supuestos del modelo. Ponderaciones no negativas normalizadas pueden facilitar la interpretación de un pronóstico de varianza como promedio ponderado, pero excluyen efectos positivos y negativos de rezago que se compensen. Un perfil flexible puede permitir una joroba o cambios de pendiente, aunque demasiados parámetros de forma pueden quedar débilmente identificados. Compara unas pocas formas defendibles, indica qué rezagos estaban disponibles y comprueba si el pronóstico cambia de forma importante al cambiar la familia de ponderaciones.
No existe un \(K\) universal. Una ventana larga puede capturar información persistente, pero añade parámetros o fuerza un perfil más prolongado; una ventana corta puede omitir dinámicas lentas. Elige el número de rezagos con información disponible en el período de estimación y valídalo sin usar el objetivo futuro de evaluación. Un buen ajuste dentro de la muestra no demuestra por sí solo que la ventana capture una señal repetible.
Esquema conceptual de entradas de distintas frecuencias, pesos por rezago y un pronóstico de baja frecuencia; no son datos observados
Alinea el origen del pronóstico con el momento en que se conocía cada dato
Las etiquetas de frecuencia no bastan para establecer un diseño válido de pronóstico. Supón que el objetivo es la varianza de la próxima semana de cinco sesiones y que el pronóstico se emite tras el cierre del viernes. Los predictores pueden incluir observaciones diarias que terminan ese viernes, pero no una estadística de varianza realizada calculada con rendimientos de la semana siguiente. Una estadística semanal o mensual publicada puede difundirse después del período que describe. El backtest debe usar el dato realmente disponible entonces, no el valor revisado o publicado posteriormente.
Antes de estimar, prepara una tabla del origen de pronóstico: cuándo se emite, la marca temporal más tardía permitida para cada predictor, el período objetivo y cuándo se vuelve observable el objetivo. Para rendimientos financieros, especifica si el rendimiento de cierre a cierre incluye el intervalo nocturno, qué sesión define un día y cómo los festivos o las barras ausentes cambian el recuento de rezagos diarios. Cinco sesiones bursátiles y siete días naturales son intervalos distintos.
Los calendarios de publicación generan extremos desiguales. En una fecha, un predictor puede tener un valor diario reciente mientras una serie mensual todavía no se ha publicado. Arrastrar el último valor mensual disponible puede ser válido si el modelo lo trata como información conocida en el origen, aunque desactualizada. No es válido completar el dato aún no publicado con una divulgación posterior. Las revisiones históricas pueden crear un problema de anticipación más sutil: una base actual puede contener una serie macro revisada que no estaba disponible para quien pronosticaba en tiempo real.
Los mercados asíncronos añaden otro problema de alineación. Un cierre diario de acciones y uno de criptomonedas pueden referirse a intervalos UTC distintos; una estimación intradía de volatilidad puede incluir barras que terminan después de la hora del pronóstico. La conversión horaria, los cambios de horario estacional, los cierres de mercados y la construcción de barras forman parte del conjunto de información. Explica cómo se gestionan, en vez de suponer que filas con la misma fecha comparten el mismo corte informativo.
Un ejemplo hipotético convierte entradas diarias en un pronóstico semanal
Supongamos que el objetivo es la varianza realizada de la próxima semana y el pronóstico se emite al cierre del viernes. El modelo usa cinco medidas diarias de varianza realizada de la semana ya terminada. Las ponderaciones estimadas, de la sesión más reciente a la más antigua, son \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\), cuya suma es uno. Las entradas diarias correspondientes, en unidades de rendimiento al cuadrado, son \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
El historial ponderado es \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). Para este modelo hipotético ajustado, supongamos que el intercepto es \(a=0{,}00012\) y la pendiente \(b=0{,}80\). El pronóstico de varianza para la semana siguiente es \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Si resulta útil resumirlo como desviación estándar, su raíz cuadrada es aproximadamente \(0{,}02061\), o \(2{,}06\,\%\) en la semana objetivo bajo la definición elegida.
El cálculo ilustra cómo se mapean los predictores diarios a un objetivo semanal futuro; los valores y coeficientes estimados son inventados. No dice que alguno de esos días causara la varianza de la semana siguiente ni que el activo vaya a subir o bajar. La ponderación de la sesión reciente muestra cómo el modelo predictivo especificado combina las entradas observadas, condicionadas a la muestra y las restricciones. No es una estimación de respuesta causal.
El ejemplo también pone de relieve las unidades. La varianza realizada diaria y la semanal son varianzas de rendimientos, pero corresponden a intervalos de acumulación distintos. La pendiente \(b\), el intercepto y la construcción del objetivo se estiman según esa convención precisa; no se pueden renombrar simplemente las entradas diarias como varianza semanal. Si el objetivo fuera el logaritmo de la varianza semanal, la predicción estaría en unidades logarítmicas y, en general, exponenciar la media condicional del logaritmo no equivaldría a la media condicional de la varianza. La transformación inversa requiere definir explícitamente el objetivo y, cuando corresponda, aplicar una corrección.
La estimación depende del objetivo y de la restricción de rezagos
Con un vector de ponderaciones fijo, la regresión es lineal en el intercepto y la pendiente. Cuando las ponderaciones dependen de parámetros no lineales desconocidos \(\theta\), se suelen usar mínimos cuadrados no lineales o un método relacionado basado en verosimilitud. La estimación busca conjuntamente los parámetros de forma y los coeficientes de regresión, o perfila los coeficientes lineales para cada forma candidata. Los valores iniciales, límites de parámetros, criterios de convergencia y óptimos locales pueden importar; no ocultes soluciones en el límite ni intentos fallidos de convergencia.
Si \(y\) es una medida de volatilidad no negativa, una especificación lineal ordinaria puede producir predicciones ajustadas negativas, en especial fuera de la muestra. Entre las opciones están imponer restricciones que mantengan el nivel no negativo, usar un enlace positivo o modelar el logaritmo del objetivo. Estas decisiones cambian el estimando y la interpretación del pronóstico. En un modelo de objetivo logarítmico, pronosticar la media condicional del logaritmo de la varianza no da automáticamente la media condicional de la varianza; importan la distribución del error y la retransformación.
La incertidumbre muestral también refleja cómo se construyó el objetivo. La varianza realizada semanal calculada con rendimientos intradía contiene error de medición y puede ser sensible al ruido de microestructura, intervalo de muestreo, saltos y datos ausentes. Si las ventanas objetivo semanales se solapan, los errores de pronóstico de orígenes vecinos comparten rendimientos subyacentes. En ese caso, los errores estándar y las comparaciones que suponen errores de pronóstico independientes pueden no ser adecuados. Usa inferencia compatible con el horizonte y la dependencia, e informa del procedimiento de medición del objetivo.
La estabilidad de los parámetros también importa. El perfil de ponderaciones estimado promedia el período de estimación; si cambia la estructura del mercado, la curva podría no describir bien ningún régimen actual. Las estimaciones con ventana expansiva y rodante responden a preguntas distintas: la primera usa más historia pero conserva dinámicas antiguas; la segunda se adapta antes, aunque dispone de menos observaciones y tiene más ruido de estimación. Preespecifica la regla de actualización y compárala con una referencia fija en una evaluación cronológica.
MIDAS está relacionado con GARCH-MIDAS, pero no es lo mismo
MIDAS nombra una forma de combinar observaciones de distintas frecuencias mediante rezagos ponderados. Una regresión MIDAS puede pronosticar directamente un objetivo de volatilidad realizada futura a partir de medidas diarias o intradía anteriores. No tiene que especificar la recursión de varianza condicional de un paso asociada con GARCH.
GARCH-MIDAS es una familia distinta que combina un componente de largo plazo y movimiento lento, a menudo impulsado por variables de menor frecuencia, con un componente de varianza condicional de corto plazo que evoluciona recursivamente. Cada componente tiene su propia parametrización y supuestos. Si un artículo o paquete usa la etiqueta GARCH-MIDAS, revisa sus ecuaciones concretas: las ponderaciones MIDAS pueden regir el componente de largo plazo mientras una recursión GARCH maneja los shocks de corto plazo. La etiqueta no revela por sí sola el objetivo, si se pronostica volatilidad latente o realizada ni cómo se impone positividad.
Los primeros trabajos financieros de MIDAS sobre volatilidad comparan distintos predictores, frecuencias y longitudes de rezago en un marco parsimonioso. Los trabajos metodológicos posteriores desarrollan propiedades de estimación y prueba para regresiones de frecuencias mixtas, incluidas comparaciones con la agregación temporal tradicional. Estos estudios respaldan la mecánica, no la afirmación de que MIDAS siempre supere a GARCH o que los predictores de alta frecuencia siempre mejoren los pronósticos. Los resultados dependen del activo, la muestra, el objetivo, el predictor, el horizonte y el diseño de evaluación.
Elige el modelo según la pregunta. Si quieres pronosticar una medida futura de volatilidad realizada usando historial diario, una regresión MIDAS directa puede ser una candidata natural. Si quieres modelar recursivamente la varianza condicional, compara una especificación GARCH adecuada. Si combinas publicaciones macroeconómicas trimestrales con un objetivo financiero diario, puede ser necesario controlar las fechas de publicación y las versiones de los datos. Modelos con nombres similares pueden responder preguntas distintas; compara el origen, la definición del objetivo y el conjunto informativo antes de evaluar el rendimiento.
El error de medición y la selección pueden dominar la curva de ponderaciones
Los datos de alta frecuencia aportan más detalle temporal, pero pueden aumentar el ruido de medición. Las barras muy breves contienen rebotes entre bid y ask, discreción de precios, cotizaciones obsoletas, negociación asincrónica y errores de datos. Sumar rendimientos al cuadrado a intervalos cada vez más cortos no garantiza una medida mejor de varianza realizada. Elige la cuadrícula de muestreo y las reglas de limpieza antes de examinar el rendimiento del pronóstico, y analiza alternativas plausibles.
La cantidad de resultados de menor frecuencia, no el aparente número de filas diarias del predictor, limita lo que puede aprenderse. Diez años de entradas diarias emparejadas con objetivos semanales siguen proporcionando solo unas 500 semanas de resultados, antes de datos ausentes y del período de evaluación reservado. Una función suave de ponderaciones usa menos coeficientes que rezagos diarios libres, pero su forma también puede quedar débilmente identificada si la muestra es corta, los predictores son muy persistentes o los rezagos candidatos son redundantes.
Muchas decisiones analíticas generan sesgo de selección: probar varias medidas de alta frecuencia, longitudes de rezago, perfiles de ponderación, transformaciones, mercados, horizontes y pérdidas, y luego comunicar solo el mejor resultado. El ajuste dentro de muestra es especialmente vulnerable porque los mismos objetivos orientan la estimación de parámetros y la elección del modelo. Registra la familia de modelos probada, elige una métrica principal y usa un período posterior cronológico reservado o una comparación que tenga en cuenta la selección. Si comparas muchos pronósticos en las mismas fechas, considera dependencia y multiplicidad en vez de tratar cada resultado como una confirmación independiente.
Una curva de ponderaciones estimada no es una explicación causal. Las entradas de alta frecuencia pueden representar noticias, liquidez o actividad de mercado; factores no observados pueden mover tanto los predictores como la volatilidad futura. La utilidad predictiva requiere alineación temporal estable y evidencia fuera de muestra. Para interpretar causalmente el modelo hacen falta un diseño de identificación y supuestos separados, que no se desprenden de la ecuación de rezagos MIDAS.
Un pronóstico no determina una decisión de trading rentable
Un pronóstico de volatilidad puede informar el presupuesto de riesgo, el tamaño de una cobertura o un rango de escenarios, pero no fija el signo del rendimiento ni la dirección de una posición. Una desviación estándar semanal pronosticada de \(2{,}06\,\%\) no es un movimiento prometido, una pérdida máxima ni una cotización de volatilidad implícita en opciones. Describe una medida de dispersión elegida bajo un modelo y una muestra; los rendimientos realizados pueden ser mucho mayores o menores.
Para estudiar una estrategia, define la hora de la señal, de la orden, el instrumento, la regla de exposición y la salida antes de probar. Reestima MIDAS en cada origen histórico solo con información que habría estado disponible entonces. Compara los pronósticos con una referencia predefinida y una pérdida coherente con el objetivo; después simula los rendimientos por separado e incluye spread, comisiones, financiación, préstamo, impacto de mercado y rotación. Un pronóstico de volatilidad puede mejorar estadísticamente sin mejorar los rendimientos netos de costes.
Informa del objetivo y su procedimiento de medición; definiciones y unidades de los predictores; frecuencias baja y alta; origen del pronóstico; número de rezagos; función y restricciones de ponderación; ventana de estimación y calendario de actualización; tratamiento de datos ausentes y versiones históricas; función de pérdida; referencia y fechas de prueba cronológica. Muestra incertidumbre o sensibilidad cuando la elección del perfil de rezagos cambia materialmente el resultado. Para ampliar, consulta las guías de volatilidad realizada, clustering de volatilidad y GARCH y comparaciones de precisión de pronósticos.
Q1¿MIDAS significa que todas las variables se promedian a una sola frecuencia?
No. Una regresión MIDAS mantiene el objetivo en la frecuencia elegida y usa rezagos ponderados estructurados de un predictor de mayor frecuencia. No hace falta interpolar todas las series a un calendario de filas común.
Q2¿La regresión MIDAS y GARCH-MIDAS son lo mismo?
No. MIDAS es un marco de rezagos ponderados con frecuencias mixtas. GARCH-MIDAS combina un componente MIDAS de largo plazo con una recursión de varianza GARCH de corto plazo. Para conocer el objetivo y los componentes hay que revisar las ecuaciones concretas.
Q3Si MIDAS pronostica la volatilidad con más precisión, ¿ya tengo una señal de trading?
No. El pronóstico describe una medida de dispersión elegida. Una estrategia requiere una regla propia de dirección o riesgo, costes de ejecución realistas y una evaluación cronológica de rendimientos netos.