Comparación de la precisión de pronóstico14 min de lectura
Prueba Diebold–Mariano: cómo comparar pronósticos
Aprende cómo la prueba Diebold–Mariano compara pérdidas emparejadas, trata horizontes superpuestos y por qué un valor p bajo no demuestra habilidad para operar.
En esta guíaUn menor error de backtest aún no demuestra que un pronóstico sea mejor
Resumen breve
La prueba Diebold–Mariano compara dos pronósticos mediante sus pérdidas para los mismos resultados observados. El resultado depende de la función de pérdida, la muestra de evaluación, el horizonte y la estimación de la incertidumbre. Un menor error muestral no demuestra por sí solo una mayor precisión esperada, y una mejor precisión tampoco equivale a una estrategia de trading rentable.
Un menor error de backtest aún no demuestra que un pronóstico sea mejor
Supongamos que dos modelos pronostican la misma rentabilidad, volatilidad o variable económica en las mismas fechas. En la muestra de evaluación, el modelo A puede tener un error promedio menor que el modelo B. Eso describe la diferencia observada en la muestra, pero no indica si el resultado es lo bastante estable para repetirse o si se debe a las fechas que coincidieron en la evaluación.
La prueba Diebold–Mariano (DM) convierte esa comparación en una serie temporal emparejada. En cada origen del pronóstico, compara ambos pronósticos con el mismo resultado realizado, los puntúa con una función de pérdida elegida de antemano y estudia la secuencia de diferencias de pérdida. El emparejamiento importa: un día de mercado volátil puede aumentar la pérdida de ambos modelos, mientras que la comparación pregunta si uno suele perder menos precisamente en esos mismos días.
El marco original no se limita al error cuadrático ni presupone errores de pronóstico distribuidos normalmente. Puede comparar distintas funciones de pérdida, incluidas las asimétricas, si corresponden a la pregunta de pronóstico. Sí exige un diseño de evaluación defendible y una estimación de la incertidumbre del promedio de las diferencias de pérdida. Diebold y Mariano (1995) plantean la prueba de igualdad de precisión predictiva; Harvey, Leybourne y Newbold (1997)00719-4) estudian una modificación para muestras pequeñas.
Compara pronósticos equivalentes antes de calcular el estadístico
Cada fila debe corresponder a un origen de pronóstico comparable. Ambos modelos han de pronosticar el mismo objetivo y horizonte, usando únicamente la información disponible en ese origen. Alinea los resultados realizados, las marcas de tiempo, la moneda o unidad, la versión de los datos y las reglas para observaciones faltantes. Si un modelo pronostica el cierre de mañana y otro el promedio de cinco días, sus errores responden preguntas distintas.
Usa pronósticos generados sin mirar al futuro. Una muestra de prueba cronológica o un diseño seudo fuera de muestra con ventana móvil puede ayudar, pero dividir los datos no basta si la misma muestra de prueba se usó repetidamente para ajustar variables, umbrales o variantes del modelo. Conserva el pronóstico realizado en cada origen histórico, junto con la versión de los datos y del modelo que lo produjo. De lo contrario, revisiones de datos macroeconómicos, filtros de sesgo de supervivencia o ajustes posteriores por acciones corporativas pueden cambiar la evaluación a posteriori.
Evalúa ambos modelos en el mismo conjunto de orígenes. Excluir fechas difíciles de un solo modelo rompe la comparación emparejada. Si faltan pronósticos, define una muestra común o explica un tratamiento justificado de las ausencias; no permitas que cada modelo enfrente regímenes de mercado distintos sin indicarlo. Elige las fechas inicial y final antes de comprobar qué muestra produce el resultado preferido.
La función de pérdida define qué significa «más preciso»
Sea yₜ el valor realizado en el origen t y sean ŷA,ₜ y ŷB,ₜ los pronósticos de A y B. Sus errores son eA,ₜ = yₜ − ŷA,ₜ y eB,ₜ = yₜ − ŷB,ₜ. Una función de pérdida L convierte cada error en una puntuación en la que un valor menor es mejor. La pérdida cuadrática L(e) = e² penaliza más los errores grandes. La pérdida absoluta L(e) = |e| aumenta linealmente con el tamaño del error. Para un pronóstico de cuantiles puede usarse una pérdida pinball asimétrica, porque sobrestimar y subestimar pueden tener costos distintos.
La puntuación elegida puede cambiar qué modelo parece mejor. Considera dos pares hipotéticos de errores en las mismas unidades: A tiene errores 0 y 2; B, errores 1 y 1. Las pérdidas cuadráticas promedio son 2 para A y 1 para B, así que B obtiene una puntuación menor. Con pérdida absoluta, el promedio de ambos es 1. Ningún cálculo es universalmente correcto: cada uno responde una pregunta distinta sobre qué errores importan.
La pérdida cuadrática puede ser útil para un pronóstico de la media condicional de los rendimientos, mientras que un pronóstico de volatilidad necesita una puntuación adecuada para su objetivo y uno de valor en riesgo (VaR) puede requerir una pérdida de cuantiles o una prueba retrospectiva específica del riesgo. Elegir la pérdida después de ver qué modelo gana convierte la prueba en otra búsqueda. Define la puntuación y el sentido de «mejor» antes de examinar la comparación.
Un pronóstico de VaR apunta a un cuantil de cola, no a un pronóstico puntual ordinario. La guía de backtesting de VaR explica cómo las pruebas de frecuencia y momento de las excepciones evalúan por separado ese pronóstico de riesgo.
Calcula las diferencias de pérdida emparejadas y especifica la hipótesis nula
Si una pérdida menor es mejor, define la diferencia del período t así:
dₜ = L(eA,ₜ) − L(eB,ₜ)
Con esta convención de signo, un dₜ positivo significa que B tuvo la pérdida menor en ese origen; un valor negativo favorece a A. El promedio muestral es d̄ = (1/n) Σ dₜ. La hipótesis nula de igualdad incondicional de precisión es E[dₜ] = 0. La alternativa bilateral pregunta si las pérdidas esperadas difieren en cualquier dirección. Una alternativa unilateral especificada de antemano puede preguntar si un modelo concreto tiene una pérdida esperada menor.
El estadístico básico es:
DM = d̄ / √(Ŝd / n)
Ŝd estima la varianza de largo plazo de la serie de diferencias de pérdida, no solo la varianza de los errores de pronóstico de cada modelo. Bajo la hipótesis nula y condiciones de regularidad adecuadas, el estadístico es asintóticamente normal estándar. Los valores positivos grandes favorecen a B según la convención anterior; los negativos grandes favorecen a A. El valor p mide la compatibilidad de los datos con la hipótesis y los supuestos muestrales especificados, no la probabilidad de que uno de los modelos sea verdadero.
El emparejamiento elimina diferencias irrelevantes en la escala general de error solo en la medida en que se reflejen en las diferencias por origen. No vuelve independiente la serie de pérdidas, no elimina automáticamente la incertidumbre por estimar parámetros ni corrige una búsqueda entre muchos objetivos y especificaciones. El diseño y la estimación de incertidumbre deben tener en cuenta esas decisiones.
Un ejemplo a un paso separa la diferencia muestral de la evidencia
Supongamos que hay 100 pronósticos hipotéticos emparejados a un paso. La pérdida cuadrática promedio del modelo A es 0.26 y la del modelo B es 0.23, en unidades de puntos porcentuales al cuadrado. La diferencia promedio es, por tanto, d̄ = 0.26 − 0.23 = 0.03, a favor de B en la muestra. Para simplificar este ejemplo, supongamos que la varianza de largo plazo estimada de dₜ es 0.04 y que no hay covarianza serial entre los orígenes.
El error estándar de la diferencia promedio es √(0.04 / 100) = 0.02. El estadístico sin ajustar es 0.03 / 0.02 = 1.50. Para un horizonte h = 1 y T = 100, el factor de muestra pequeña de Harvey–Leybourne–Newbold es √[(T + 1 − 2h + h(h − 1)/T) / T] = √0.99 ≈ 0.995. Al multiplicarlo, el estadístico ajustado es aproximadamente 1.49; con la distribución t₉₉ aproximada como referencia, el valor p bilateral es alrededor de 0.14.
B tiene el menor error cuadrático medio observado, pero este ejemplo no aporta evidencia sólida contra la igualdad de precisión esperada a los niveles de significación habituales. No rechazar no demuestra que los modelos tengan la misma precisión. Rechazar seguiría siendo una conclusión condicionada a la puntuación, los orígenes y los supuestos elegidos. Los valores de varianza y pérdidas son datos hipotéticos para explicar el cálculo, no resultados empíricos.
Las raíces cuadradas correspondientes de los errores cuadráticos medios (RMSE) son aproximadamente 0.510 y 0.480 puntos porcentuales, una diferencia descriptiva de 0.030 puntos. Aun así, el estadístico DM usa diferencias emparejadas de pérdidas cuadráticas; no es una prueba t de las dos raíces cuadradas.
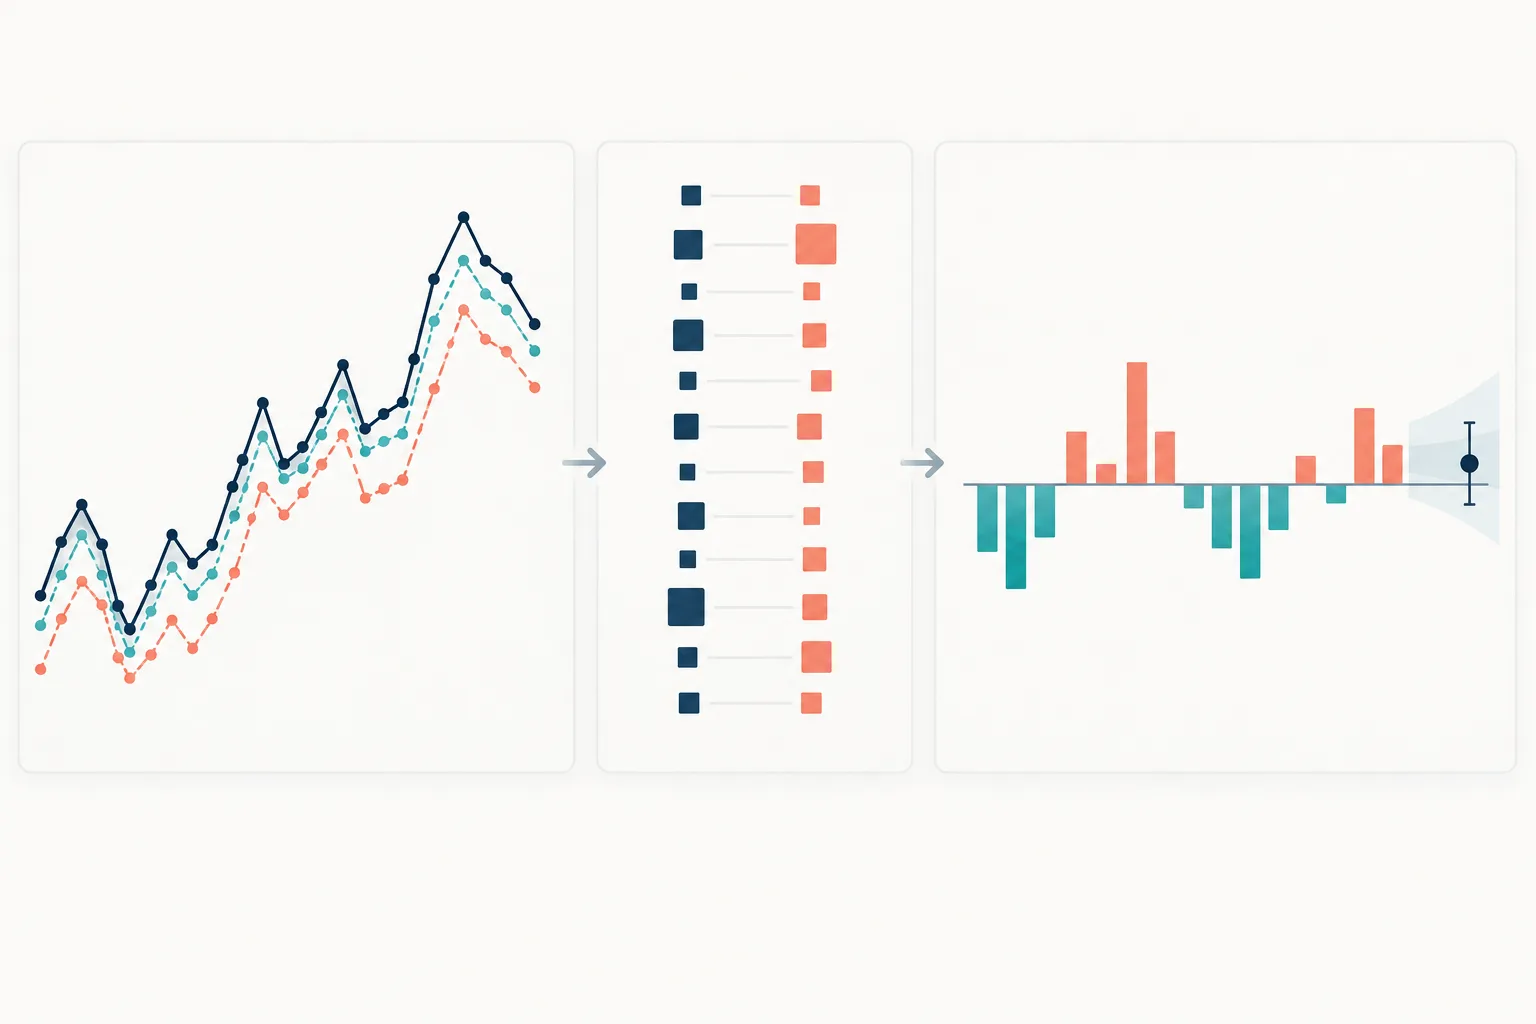
Representación conceptual de las pérdidas emparejadas y sus diferencias en la prueba Diebold–Mariano; no muestra datos reales de mercado ni un resultado empírico.
Los horizontes superpuestos hacen que las diferencias de pérdida dependan entre sí
Si se emiten pronósticos diarios a cinco días, dos pronósticos contiguos comparten cuatro de sus cinco días objetivo. Por ello, los errores, las pérdidas y las diferencias de pérdida pueden moverse conjuntamente. Tratar 100 orígenes diarios como 100 comparaciones independientes puede subestimar la incertidumbre y hacer que el estadístico parezca demasiado grande.
La varianza de largo plazo incorpora la covarianza serial de dₜ. Un estimador habitual consistente frente a heterocedasticidad y autocorrelación (HAC) tiene la forma:
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
Aquí, γ̂ₖ es la autocovarianza muestral en el rezago k, wₖ es un peso del núcleo y m es el ancho de banda elegido. Newey y West (1987) presentan un estimador HAC semidefinido positivo. Para errores ideales de pronóstico a h pasos y bajo los supuestos pertinentes, el solapamiento suele generar dependencia hasta al menos h − 1 rezagos; el marco original de DM analiza un estimador truncado para ese caso. Los datos reales pueden tener dependencias más largas por objetivos persistentes, estimación móvil o construcción de estrategias, así que h − 1 no es una regla universal para elegir el ancho de banda.
Indica el horizonte, el núcleo, el ancho de banda y cualquier ajuste de muestra pequeña. Muestra si las conclusiones cambian bajo opciones razonables para modelar la dependencia, en lugar de elegir un ancho de banda porque produce el valor p preferido. Si se espacian los orígenes lo suficiente para evitar el solapamiento, indícalo y explica qué información o tamaño muestral se sacrifica. La incertidumbre que tiene en cuenta la dependencia forma parte de la prueba, no es una opción de presentación.
Los modelos anidados y los cambios en la habilidad predictiva requieren otras preguntas
La comparación DM habitual se interpreta con mayor facilidad cuando los pronósticos no están anidados bajo la hipótesis nula de precisión igual. Si un modelo grande contiene un modelo de referencia más pequeño, los coeficientes adicionales estimados pueden añadir ruido al pronóstico incluso cuando sus valores verdaderos son cero. Bajo esa hipótesis, la diferencia ordinaria de errores cuadráticos medios puede tener una distribución no estándar. Para comparar el error cuadrático medio de pronóstico fuera de muestra entre modelos anidados, un método como el ajuste de Clark–West considera ese efecto del ruido de estimación; no reemplaza de forma general la prueba DM en cualquier diseño. Consulta Clark y West (2007).
La hipótesis nula DM ordinaria se refiere a la pérdida promedio incondicional en toda la muestra de evaluación. Puede ocultar cambios a lo largo del tiempo: A puede ir mejor en períodos tranquilos y B en períodos volátiles, aunque sus promedios generales sean parecidos. Si la pregunta es si la precisión relativa depende de información conocida en la fecha del pronóstico, las pruebas de capacidad predictiva condicional usan diferencias de pérdida junto con instrumentos especificados de antemano. Giacomini y White (2006) desarrollan ese marco. Sus supuestos y el diseño de la ventana de evaluación importan; añadir indicadores arbitrarios después de inspeccionar los resultados no es un atajo válido.
La prueba debe corresponder a la estructura de comparación: pronósticos no anidados, modelos anidados, capacidad condicional cambiante o una familia elegida entre muchos candidatos son casos distintos. Para el último caso, la guía de White Reality Check y Hansen SPA explica la corrección a nivel de familia tras buscar entre muchas reglas de trading.
Una pérdida de pronóstico menor no demuestra que la estrategia sea rentable
Un pronóstico puede ser estadísticamente más preciso sin mejorar los resultados netos de trading. Una estrategia debe convertirlo en una posición, decidir cuándo operar y asumir spreads, comisiones, deslizamiento, impacto de mercado, financiación, costos de préstamo y límites de riesgo. Una mejora pequeña del error cuadrático medio de los rendimientos quizá no cambie ninguna decisión útil, mientras que un modelo con un error promedio algo mayor podría identificar mejor un evento extremo importante para una regla concreta.
Mantén la evaluación del pronóstico y la evaluación de la cartera como pasos separados. Primero, contrasta el pronóstico con un objetivo y una pérdida que correspondan a la tarea declarada. Después, evalúa una regla de trading completamente especificada con datos que no se usaron para elegir el pronóstico y con supuestos realistas de ejecución y financiación. El valor p de una prueba de pronóstico no es un rendimiento de backtest, un ratio de Sharpe ni la probabilidad de obtener beneficios futuros.
Probar repetidamente modelos, objetivos, horizontes, funciones de pérdida y ventanas muestrales genera sesgo de selección aunque cada cálculo individual de DM sea correcto. Registra toda la búsqueda y utiliza un método de corrección para la familia si la pregunta de investigación es si sobrevivió alguno de los candidatos. La guía de bootstrap por bloques cubre la incertidumbre que conserva la dependencia para un estadístico preseleccionado; por sí sola no corrige una búsqueda de modelos que no se documentó.
Informa detalles suficientes para que otra persona pueda reproducir el análisis
Nombra ambos modelos de pronóstico, su relación con el modelo de referencia, el objetivo, el horizonte, el calendario de orígenes, las fechas de evaluación, el conjunto de información, la versión de los datos y la regla de muestra común. Define matemáticamente la pérdida e indica si un dₜ positivo favorece a A o a B. Informa n, la pérdida promedio de cada modelo, d̄, el estimador de varianza de largo plazo, el núcleo y el ancho de banda HAC, el ajuste de muestra pequeña, la distribución de referencia, la dirección de la prueba y el valor p.
Indica también si los modelos están anidados, cómo se estimaron sus parámetros, si la comparación se eligió antes o después de revisar los resultados y qué otras variantes se probaron. Si la muestra se usó para seleccionar el modelo, describe la prueba como parte de esa selección en lugar de llamarla evidencia fuera de muestra intacta. Un informe claro permite ver qué compara exactamente la prueba y qué problemas de incertidumbre o selección quedan fuera de ella.
Preguntas frecuentes
Q1¿La prueba Diebold–Mariano exige errores de pronóstico normalmente distribuidos?
No. El marco puede admitir errores que no sigan una distribución normal. Aun así, necesita una estimación adecuada de la varianza de las diferencias de pérdida y condiciones de regularidad que respalden la distribución de referencia.
Q2¿Puedo comparar dos modelos que pronostican horizontes distintos?
No como comparación equivalente de precisión. Alinea primero el objetivo y el horizonte; de lo contrario, cada modelo responde una pregunta de pronóstico distinta.
Q3¿Basta un resultado DM significativo para elegir un modelo de trading?