

Roll Bid–Ask Spread Estimator: सूत्र, उदाहरण और सीमाएँ
जानें कि Roll estimator नकारात्मक रिटर्न सहप्रसरण से प्रभावी bid–ask spread का अनुमान कैसे लगाता है, एक काल्पनिक गणना देखें और इसकी मान्यताओं की सीमाएँ समझें।
इस गाइड मेंRoll estimator किसे मापने के लिए बनाया गया है
संक्षिप्त सारांश
Roll estimator लेनदेन-मूल्य के लगातार रिटर्न के नकारात्मक covariance से मॉडल-आधारित प्रभावी bid–ask spread का अनुमान लगाता है। इसमें दर्ज किए गए quote के बजाय transaction prices चाहिए, लेकिन नतीजा efficient price, trade direction, sampling और पूरे नमूने में spread स्थिर रहने की मान्यताओं पर निर्भर करता है।
Roll estimator किसे मापने के लिए बनाया गया है
Quoted spread किसी समय पर ask और bid का अंतर है। Effective spread इसके बजाय वास्तविक trades के मूल्य की तुलना उसी समय के midpoint से करके उनके सामने आई लागत का सार देता है। Roll estimator effective spread का low-frequency proxy है: transaction-price बदलावों का serial covariance लेकर यह अनुमान लगाता है कि अल्पकालिक price reversal के पीछे कौन-सा मूल्य-अंतर हो सकता है।
इसका लाभ यह है कि अपेक्षाकृत कम डेटा चाहिए। भरोसेमंद transaction prices हों, लेकिन पुराने bid–ask quotes या trade-direction flags न हों, तब भी estimator निकाला जा सकता है। इसलिए ऐतिहासिक तुलना या अधूरे quote archives वाले बाजारों में यह उपयोगी हो सकता है। यह quote book को दोबारा नहीं बनाता, हर trade का पक्ष नहीं पहचानता और trader को अभी उपलब्ध spread नहीं बताता। Roll का मूल लेख efficient market के लिए इस माप को निकालता है और बताता है कि अनुमानित वस्तु effective spread है, जरूरी नहीं कि प्रदर्शित quoted spread ही हो (Roll, 1984)।
यह estimate पूरी transaction-cost माप भी नहीं है। इसमें commission, किसी खास order का market impact, प्रतीक्षा की लागत, न भरी गई मात्रा या observation के बाद का price move शामिल नहीं है। इसे ऐतिहासिक transaction-price व्यवहार के एक model-based सार की तरह लें, executable quote या पूरे backtest cost model की तरह नहीं।
Bid–ask bounce नकारात्मक covariance पैदा करता है
मान लें \(x_t\) log transaction price है, \(m_t\) वह अप्रेक्षित log value है जिसके आसपास bid और ask रखे जाते हैं, और \(s\) log-price इकाइयों में पूरा effective spread है। सरल symmetric model में,
\[ x_t=m_t+\frac{s}{2}q_t, \]
जहाँ ask पर buyer-initiated trade के लिए \(q_t=+1\) और bid पर seller-initiated trade के लिए \(q_t=-1\)। इसलिए देखे गए return का रूप है
\[ r_t=\Delta x_t=\Delta m_t+\frac{s}{2}(q_t-q_{t-1}). \]
मान लें trade signs स्वतंत्र हैं और \(+1\) तथा \(-1\) की संभावना बराबर है, efficient-value innovations में serial covariance नहीं है और पूरे नमूने में spread स्थिर है। जब trade एक ओर से दूसरी ओर जाता है, तो underlying value लगभग न बदले तब भी transaction price spread पार करता है। Ask पर buy और फिर bid पर sell होने से पहले नकारात्मक return और बाद में सकारात्मक reversal होता है; उलटे क्रम में भी ऐसा ही होता है। एक ही तरफ दो लगातार trades हों तो इन observations के बीच spread वाला हिस्सा शून्य हो सकता है।
इन मान्यताओं के तहत spread वाला घटक औसतन लगातार returns को विपरीत दिशा में ले जाता है:
\[ \operatorname{Cov}(r_t,r_{t-1})=-\frac{s^2}{4}. \]
इस समीकरण से \(s\) निकालने पर Roll सूत्र मिलता है। covariance का यह pattern मॉडल का परिणाम है, इस बात का प्रमाण नहीं कि हर दिखाई देने वाला price reversal bid–ask spread से ही आया।
<!-- Illustration placement: after section 3; text-free conceptual comparison of a smooth underlying value path with transaction prices alternating above and below it. No labels, axes, or values. -->
Autocorrelation नहीं, first-order covariance इस्तेमाल करें
First-order covariance को \(C_1=\operatorname{Cov}(r_t,r_{t-1})\) लिखें। \(T\) returns वाले नमूने के लिए एक आम convention है
\[ \widehat C_1=\frac{1}{T-1}\sum_{t=2}^{T}(r_t-\bar r)(r_{t-1}-\bar r), \]
जहाँ \(\bar r\) sample mean है। यदि \(\widehat C_1<0\), तो plug-in estimate है
\[ \widehat s_{\text{Roll}}=2\sqrt{-\widehat C_1}. \]
नतीजे की इकाई covariance में इस्तेमाल returns जैसी होती है। \(r_t\) log return हो तो \(\widehat s\) proportional या log-price spread है। इनपुट dollar price change हो तो estimate price इकाइयों में होगा। अलग-अलग assets या अवधियों के estimates की तुलना से पहले transformation, sampling interval और covariance convention बताएं।
Roll, correlation के बजाय covariance पर जोर देते हैं। Correlation को unconditional return variance से भाग दिया जाता है, जिसमें efficient value की नई सूचना से होने वाला उतार-चढ़ाव भी शामिल रहता है। Spread mechanism बदले बिना भी यह news-driven variance बदल सकता है। Unnormalized covariance का मॉडल में squared spread से सीधा संबंध है; उसकी जगह autocorrelation लेने से estimator और उसका अर्थ बदल जाता है। अध्ययन में log prices, scaled returns या अलग denominator हो तो वह convention साफ बताएं।
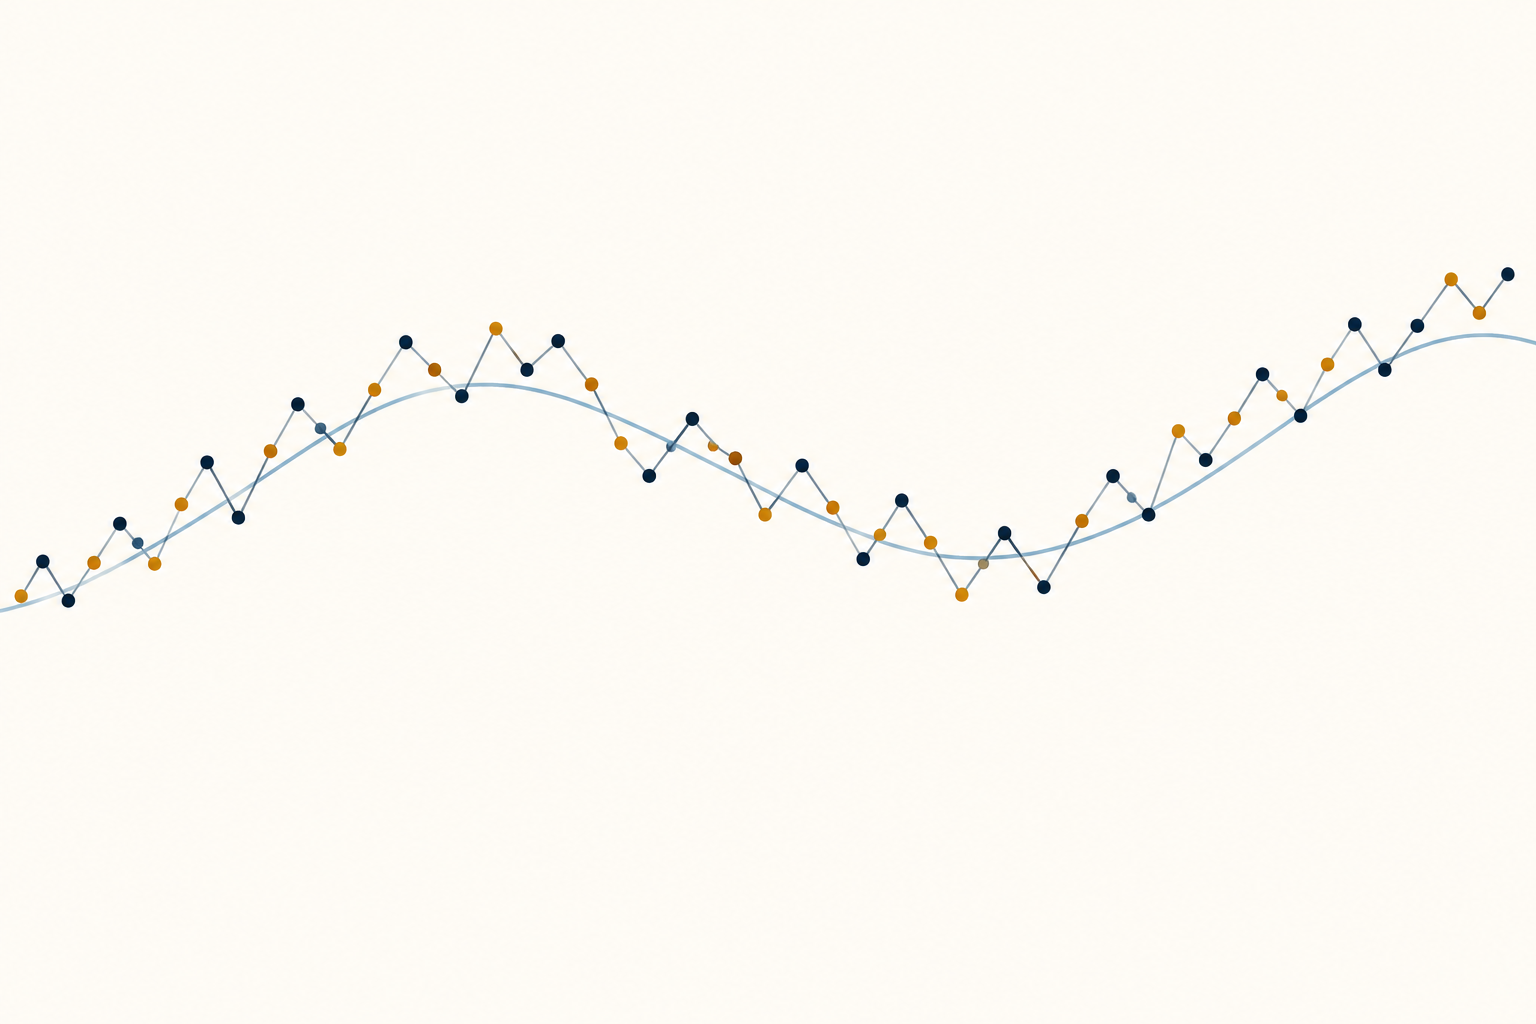
काल्पनिक गणना में −1.44 bp² से 2.40 bp का अनुमान मिलता है
मान लें transaction-price log returns का एक काल्पनिक नमूना basis points में है और उसका demeaned first-order sample covariance \(-1.44\,\text{bp}^2\) है। तब
\[ \widehat s_{\text{Roll}}=2\sqrt{-(-1.44)}=2\sqrt{1.44}=2(1.20)=2.40\,\text{bp}. \]
मॉडल के तहत यह पूरा proportional-spread estimate \(2.40\) basis points, यानी \(0.024\%\), है। काल्पनिक midpoint \($100\) पर पूरे spread का dollar conversion प्रति share लगभग
\[ \$100\times 0.00024=\$0.024 \]
होगा। Midpoint से किसी एक तरफ इसका आधा, करीब \($0.012\) प्रति share है। यदि quotes न बदलें और trader ask पर 1,000 shares खरीदे, फिर bid पर बेचे, तो commission, दूसरी fees, price movement और market impact से पहले पूरे spread का price difference लगभग \($24\) होगा। ये उदाहरण के रूपांतरण हैं, देखे गए quotes या सुनिश्चित execution cost नहीं।
इस गणना से यह पता नहीं चलता कि \($100\) सचमुच executable midpoint था, कितनी मात्रा उपलब्ध थी या किसी order को कौन-सा मूल्य मिलता। Roll estimate ऐतिहासिक नमूने को एक statistic में समेट सकता है, लेकिन दिन के समय, order size या market state से होने वाले फर्क छिपा सकता है। Asset, interval और spread definition समान न हों तो estimate की तुलना अभी दिख रहे spread से न करें।
Spread और sampling window बदलने से अनुमानित मात्रा भी बदलती है
स्थिर \(s\) एक सरलीकरण है। Roll समय के साथ बदलते spread पर भी विचार करते हैं और मॉडल के तहत average squared spread से संबंध निकालते हैं। उस स्थिति में square-root formula आम तौर पर arithmetic average spread नहीं, root-mean-square spread देता है। चूँकि spread वर्ग के रूप में आता है, कुछ बहुत चौड़े-spread observations अनुमान को असमान रूप से प्रभावित कर सकते हैं।
मूल मॉडल का एक परिणाम इससे व्यापक सुनाई दे सकता है: मान्यताएँ पूरी हों तो nonoverlapping observation interval की लंबाई बदलने पर अपेक्षित spread-induced covariance अपरिवर्तित रहता है। इसका अर्थ यह नहीं कि वास्तविक daily, weekly और intraday estimates बराबर होंगे। वास्तविक trade signs कई observations तक बने रह सकते हैं, कुछ intervals में trade नहीं होता और spread की स्थिति बदलती रहती है। Interval बदलने से sampled price बनने वाला transaction और हर return में शामिल information noise भी बदलते हैं।
परिणाम देखने से पहले sampling rule तय करें। उदाहरण के लिए, official closing trades, midpoint marks और stale last prices मिलाने के बजाय एकसमान नियम से sampled transaction prices की तुलना करें। बताएं कि returns calendar time या trading sessions पर आधारित हैं, holidays और nontrading periods कैसे संभाले, और corporate actions या contract rolls समायोजित किए या नहीं। Formula वही होने पर भी अलग sample interval एक अलग empirical design है।
Positive covariance होने पर मूल estimate परिभाषित नहीं होता
Square root तभी वास्तविक संख्या है जब sample covariance नकारात्मक हो। \(\widehat C_1=0\) हो तो plug-in गणना शून्य देती है; \(\widehat C_1>0\) हो तो मूल formula परिभाषित नहीं होता। शून्य या सकारात्मक sample covariance इस बात का प्रमाण नहीं कि सही spread शून्य है। इसकी वजह sampling noise, trade direction की persistence, price discreteness, efficient-value returns में serial dependence या छोटे नमूने में spread को noise से अलग न कर पाना हो सकता है।
कुछ empirical implementations square root लेने से पहले positive covariance को शून्य कर देते हैं। कुछ absolute value लेते हैं या केवल नकारात्मक covariance वाली windows की रिपोर्ट करते हैं। इससे संख्या निकल सकती है, लेकिन ये अतिरिक्त नियम हैं, Roll equation के परिणाम नहीं। बताएं कि कितने estimates परिभाषित नहीं थे, कितनी बार estimate शून्य किया और exclusions से नमूना बदला या नहीं। चुपचाप absolute value लेने से मॉडल के विपरीत covariance भी सकारात्मक spread estimate बन सकता है।
छोटे नमूने में covariance खुद भी error के साथ अनुमानित होता है और फिर उस पर square root लगाया जाता है। Harris ने Roll model के तहत finite-sample गुण निकाले और दिखाया कि noise sample covariance को सकारात्मक बना सकता है तथा nonlinear transformation महत्वपूर्ण bias पैदा कर सकता है (Harris, 1990)। Point estimate के साथ नमूने की लंबाई और उचित windows के प्रति उसकी संवेदनशीलता दें; price data जितनी precision का समर्थन करे उससे अधिक न दिखाएं।
Trade signs या efficient-price बदलाव बने रहें तो मॉडल विफल होता है
सरल derivation के लिए सिर्फ negative covariance होना पर्याप्त नहीं। इसमें स्वतंत्र और समान संभावना वाले buy- और sell-initiated trades, efficient value के आसपास symmetric spread, efficient-value innovations में serial covariance न होना और sampling process द्वारा transaction-price mechanism का प्रतिनिधित्व करने जैसी मान्यताएँ हैं। Market-order splitting और inventory management trade signs को लगातार बना सकते हैं। खरीदार अगर समूहों में आते हैं, तो transaction returns का spread-संबंधी हिस्सा लगातार एक दिशा में रह सकता है और negative covariance मॉडल की भविष्यवाणी से कमजोर पड़ सकता है।
Midpoint का रास्ता भी serial dependence दिखा सकता है। Momentum, reversal, stale prices, asynchronous observations या निर्धारित price adjustments effective spread बदले बिना negative या positive return covariance बना सकते हैं। Price discreteness और tick-size effects भी अपने reversal पैदा कर सकते हैं। नमूने पर इन प्रभावों का प्रभुत्व जरूरी नहीं; वे फिर भी estimate को प्रभावित कर सकते हैं, क्योंकि estimator एक moment से spread निकालता है और उस moment को प्रभावित करने वाली कोई अन्य प्रक्रिया नतीजे को confound कर सकती है।
समय के साथ बदलता spread ऐतिहासिक औसत और स्थिर market property के बीच फर्क पैदा करता है। News, open और close, कम trading या market stress के समय spread चौड़ा हो सकता है। पूरे period का estimate इन घटनाओं को छिपा सकता है, जबकि छोटी windows में covariance का अनुमान बहुत noisy हो सकता है। समय के साथ बदलते परिणाम देखें और window की परिभाषा बताएं। मॉडल के तहत negative serial covariance bid–ask bounce के अनुकूल है; यह सभी अल्पकालिक price movements का causal decomposition नहीं।
Quote data और दूसरे low-frequency estimators अलग सवालों के जवाब देते हैं
भरोसेमंद quote और trade data उपलब्ध हों तो प्रत्येक trade price की तुलना समकालीन midpoint से करके और trade direction शामिल करके effective spread सीधे निकाला जा सकता है। इसके लिए synchronized, cleaned observations और locked, crossed, stale या out-of-sequence quotes के स्पष्ट नियम चाहिए। यह उस dataset में हुए trades को मापता है; Roll transaction prices के serial covariance से spread का अनुमान लगाता है। Trade sign के लिए भी अनुमान का नियम चाहिए हो सकता है; trade-direction classification guide इसे समझाती है।
दूसरे low-frequency तरीके अलग जानकारी और मान्यताएँ लेते हैं। Hasbrouck केवल basic Roll plug-in transformation पर निर्भर न रहकर daily closing prices से Gibbs-sampler estimate निकालते हैं (Hasbrouck, 2009)। Corwin और Schultz daily high और low prices से ऐसा estimator बनाते हैं जो उन्हीं trade-direction dynamics पर निर्भर नहीं करता (Corwin and Schultz, 2012)। इन विकल्पों से हर price series में quoted spread दिखने नहीं लगता; हर तरीके की अपनी मान्यताएँ और validation scope हैं।
कौन-सा measure चुनें यह व्यावहारिक सवाल पर निर्भर है। Quote data सीमित हो तो ऐतिहासिक cross-market तुलना के लिए low-frequency proxy उपयोगी हो सकता है, बशर्ते failure rate और मान्यताएँ बताई जाएँ। Order का निर्णय लेते समय मौजूदा bid, ask, depth और order size देखें। Futures spread and slippage guide quoted spread और realized execution difference अलग करती है, जबकि ETF liquidity guide बताती है कि volume अकेले executable liquidity क्यों नहीं बताता।
मान्यताएँ बताएं और estimate को signal column से अलग रखें
पुनरुत्पादित किए जा सकने वाले report में बताएं कि observations trades हैं, official closes हैं या दूसरा transaction-price proxy; input price changes हैं या log returns; sampling interval; observations की संख्या; covariance denominator; और zero या positive covariance को कैसे संभाला। Asset universe, date range, corporate-action और roll adjustments, data filters तथा spread को price, percentage या basis-point इकाई में दिखाने की जानकारी भी दें। Spread स्थिर रहने की मान्यता संभव न हो तो सबसे नकारात्मक covariance वाली window चुनने के बजाय पहले से तय subperiods के estimates दिखाएँ।
Roll estimate किसी मॉडल के तहत ऐतिहासिक transaction-cost proxy है। यह आज का quote नहीं दिखाता, execution price की गारंटी नहीं देता, strategy की पूरी लागत नहीं मापता और अगले return का पूर्वानुमान नहीं करता। Backtest के लिए venue, order size, timing, commissions और fill behavior से मेल खाने वाले order-size-aware spread, commissions, market impact, partial fills और timing model की जरूरत है। कम estimated spread अपने आप में tradable edge का प्रमाण नहीं। अलग sampling frequencies में देखी गई volatility का व्यापक संदर्भ realized volatility guide में है।
आम सवाल
Q1क्या Roll estimator के लिए पुराने bid और ask quotes जरूरी हैं?
नहीं। Basic version transaction prices और लगातार returns के covariance का उपयोग करता है। इसलिए quote history न हो तब भी इसका उपयोग हो सकता है, लेकिन estimate मॉडल-आधारित है और हर समय का असली quote वापस नहीं देता।
Q2क्या positive autocovariance का मतलब है कि spread शून्य है?
नहीं। Positive sample covariance पर basic formula परिभाषित नहीं होता। Estimate को शून्य पर सीमित करने का convention असली spread शून्य होने का प्रमाण नहीं है; नियम और ऐसे नमूनों का अनुपात बताएं।
Q3क्या Roll estimate को live backtest में spread की तरह इस्तेमाल कर सकते हैं?
अकेले नहीं। यह विशिष्ट मान्यताओं के तहत ऐतिहासिक proxy है। Backtest को अपने venue, order size, timing, commissions और fill behavior से मेल खाने वाली लागत और execution assumptions फिर भी चाहिए।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
Basic Roll estimator spread का अनुमान लगाने के लिए कौन-सा input लेता है?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
विस्तृत गाइड पढ़ेंएट द मनीवह स्थिति जिसमें विकल्प का स्ट्राइक मूल्य अंतर्निहित परिसंपत्ति के बाजार मूल्य के बहुत करीब हो। उसमें अभी महत्वपूर्ण आंतरिक मूल्य न हो, फिर भी बचे हुए समय और अनिश्चितता के कारण प्रीमियम हो सकता है।
विस्तृत गाइड पढ़ें