

MIDAS-Regression erklärt: Daten mit gemischten Frequenzen und Volatilitätsprognosen
Erfahre, wie MIDAS-Regression tägliche und wöchentliche Finanzdaten mit sparsamen Lag-Gewichten verbindet, eine Volatilitätsprognose bildet und wo Mischfrequenzmodelle irreführen können.
In diesem LeitfadenMIDAS löst einen Unterschied in der Beobachtungsfrequenz
Kurze Zusammenfassung
MIDAS (Mixed Data Sampling) verbindet Beobachtungen unterschiedlicher Frequenz, ohne jede Reihe vorab auf einen gemeinsamen Kalender zu zwingen. Wenige geschätzte Parameter formen die gewichtete Historie höherfrequenter Beobachtungen und können so eine niedrigfrequente Finanzgröße prognostizieren. Die Gewichte beschreiben ein Vorhersagemuster unter einem gewählten Modell; sie belegen weder Kausalität noch einen Handelsvorteil.
MIDAS löst einen Unterschied in der Beobachtungsfrequenz
Finanz- und Wirtschaftsdaten folgen nicht derselben Uhr. Eine Volatilitätszielgröße kann wöchentlich gemessen werden, während mögliche erklärende Größen tägliche Renditen oder untertägige realisierte Maße sind. Eine makroökonomische Reihe kann vierteljährlich vorliegen, während ein Vermögenspreis täglich beobachtet wird. Eine gewöhnliche Regression erwartet pro Beobachtung eine Zeile mit Zielgröße und Regressoren. Vor der Schätzung muss daher entschieden werden, wie mit den unterschiedlichen Kalendern umzugehen ist.
Eine Möglichkeit besteht darin, tägliche Eingaben zu einem Wochenmittel oder einer Wochensumme zusammenzufassen. Das ist einfach, erzwingt aber ein bestimmtes Gewicht für jeden Tag und kann verwischen, an welcher Stelle der Woche eine Bewegung auftrat. Eine andere Möglichkeit ist, einen Quartalswert auf tägliche Zeilen zu wiederholen oder zu interpolieren. Durch Wiederholung kann eine langsam veränderliche Zahl wie viele neue Beobachtungen wirken; Interpolation kann einen glatten Verlauf erzeugen, der nie beobachtet wurde. Keine der beiden Operationen schafft neue Information.
MIDAS bietet einen direkten Weg, die Frequenzen zu verbinden. Es belässt die Zielgröße in ihrer natürlichen niedrigeren Frequenz und nimmt strukturierte Lags der höherfrequenten Reihe auf. Der Name bezeichnet Mixed Data Sampling und kein einzelnes Volatilitätsmodell. MIDAS-Regressionen werden für Volatilitätsprognosen und andere Fälle genutzt, in denen Regressoren feiner abgetastet werden als die Zielgröße. Die zentrale Frage lautet, wie viel der jüngsten hochfrequenten Historie eingeht und wie ihre Gewichte eingeschränkt werden.
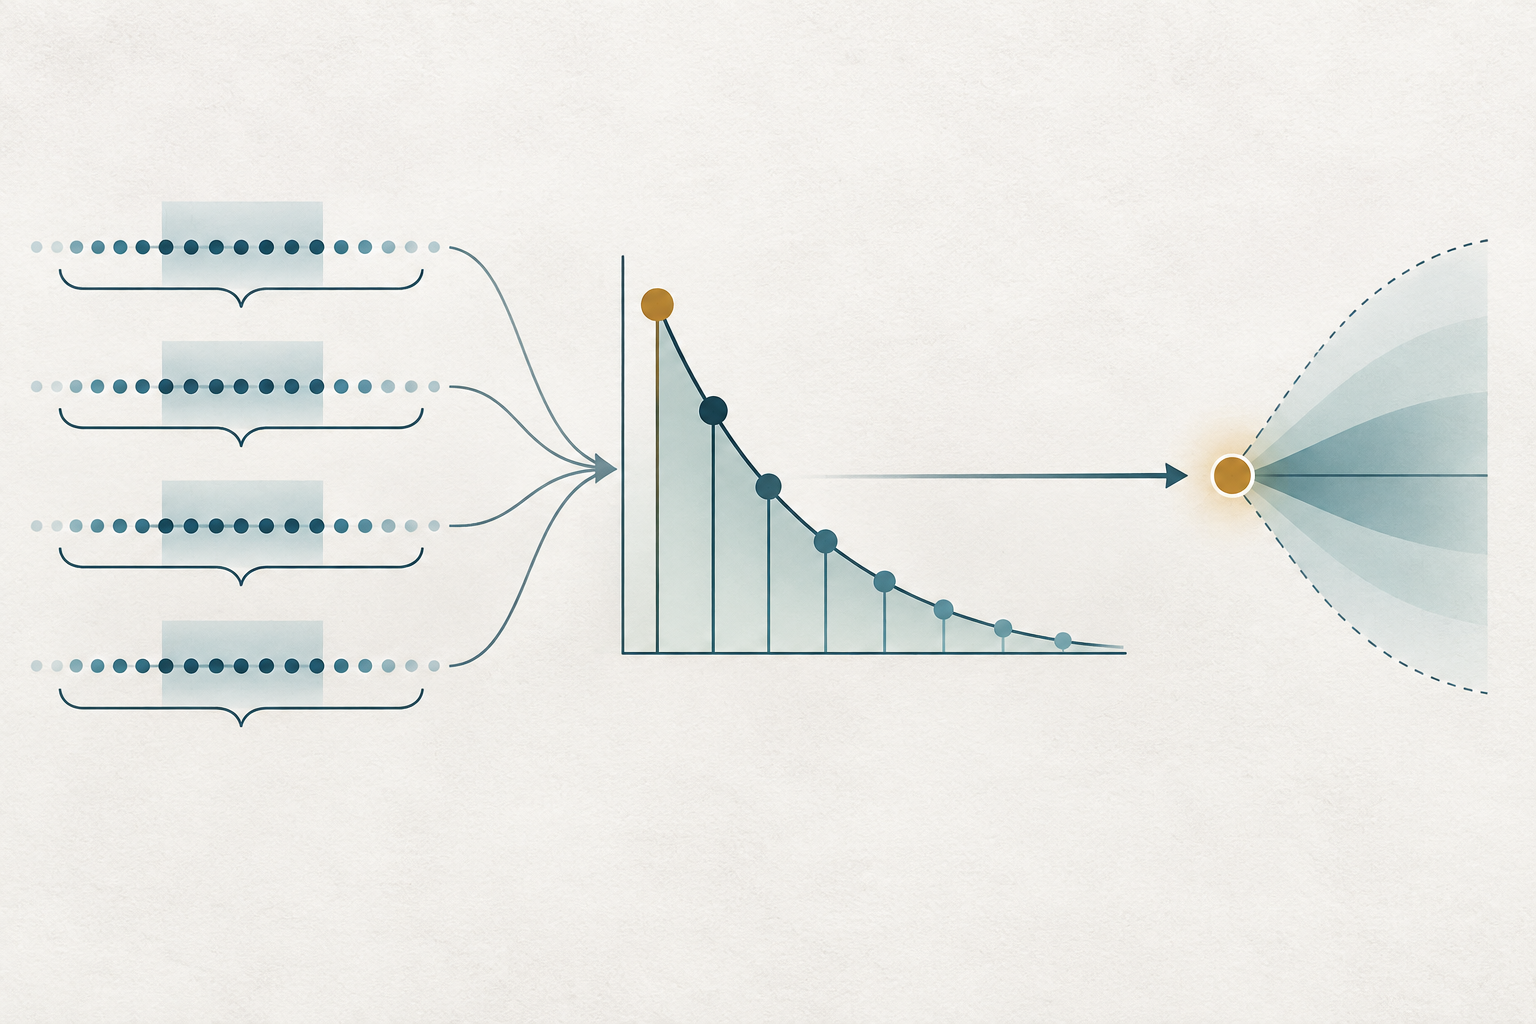
Ein gewichteter Lag verdichtet viele Beobachtungen zu einem kompakten Prädiktor
Sei \(y_{t+1}\) eine niedrigfrequente Zielgröße, etwa die realisierte Varianz der nächsten Woche, die erst nach Ende dieser Woche beobachtet wird. Sei \(x_{t-j}\) ein täglicher Prädiktor, der \(j\) Handelssitzungen vor dem Prognoseursprung am Ende von Woche \(t\) gemessen wird. Eine einfache MIDAS-Regression lautet \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\). Dabei ist \(K\) die Anzahl täglicher Lags, \(w_j(\theta)\) das von wenigen Parametern gesteuerte Gewicht und \(u_{t+1}\) der Prognosefehler.
Die Gewichte werden häufig so normiert, dass \(\sum_{j=1}^{K}w_j(\theta)=1\) gilt. Dadurch lässt sich die Summe als gewichtete Historie lesen, während \(b\) bestimmt, wie stark diese Zusammenfassung mit der Zielgröße zusammenhängt. Die Normierung bedeutet weder, dass tägliche Beobachtungen unabhängig sind, noch dass sie gleich informativ sind. Sie ist eine praktische Parametrisierung des Lag-Profils.
Als \(x\) kann man tägliche quadrierte Renditen, absolute Renditen, aus Intraday-Renditen gebildete realisierte Varianz oder eine andere am Prognoseursprung verfügbare Größe einsetzen. \(y\) kann eine künftige Wochenvarianz, eine monatliche Makroveröffentlichung oder eine andere niedrigfrequente Zielgröße sein. Die Definition des Ziels bestimmt die Bedeutung der Koeffizienten. Ein Modell für eine Realized-Variance-Näherung ist nicht automatisch ein Modell der latenten momentanen Varianz, der optionsimpliziten Varianz oder einer Kursrendite.
MIDAS ist ein Regressionsrahmen und kein universeller Schätzer. Die Zielgröße kann in Niveaus, Logarithmen oder mit einer Linkfunktion modelliert werden; die Schätzung hängt von der gewählten Gewichtsform und den Fehlerannahmen ab. Eine lineare Regression einer nichtnegativen Varianznäherung kann negative angepasste Werte liefern, sofern die Prognose nicht eingeschränkt oder die Zielgröße transformiert wird. Die praktische Einfachheit des Modells ersetzt nicht die Prüfung von Wertebereich und Einheiten.
Die Gewichtsfunktion tauscht Flexibilität gegen Stabilität
Eine uneingeschränkte verteilte Lag-Regression schätzt für jede der \(K\) täglichen Eingaben einen eigenen Koeffizienten. Ist \(K\) im Verhältnis zur Zahl wöchentlicher Zielbeobachtungen groß, können die Schätzungen verrauscht und stark korreliert sein. MIDAS legt die Lag-Koeffizienten stattdessen über eine Funktion mit wenigen Dimensionen fest. Ein beispielhaftes exponentielles Almon-Profil lautet \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). Auch ein normiertes Beta-Polynom-Profil ist verbreitet.
Solche Profile können neueren Sitzungen mehr Gewicht geben, langsam abklingen oder einem mittleren Abschnitt des Lag-Fensters relativ mehr Gewicht zuweisen. Die Parameter beschreiben die gewählte glatte Kurve; sie messen nicht ohne Weiteres die Bedeutung jedes einzelnen Tages. Zeigen die Daten eine kurzlebige Beziehung, erzwingt die gewählte Funktion aber einen langen glatten Nachlauf, übernehmen die geschätzten Koeffizienten diese Einschränkung. Umgekehrt können viele frei geschätzte Tageskoeffizienten eher Rauschen als stabile Dynamik erfassen.
Gewichtsbeschränkungen sind Modellannahmen. Nichtnegative, auf eins normierte Gewichte machen eine Varianzprognose als gewichteten Durchschnitt gut interpretierbar, schließen aber gegenläufige positive und negative Lag-Effekte aus. Ein flexibles Profil kann einen Buckel oder wechselnde Steigungen abbilden, doch zu viele Formparameter sind möglicherweise schwach identifiziert. Vergleiche eine kleine Zahl begründbarer Profile, nenne die verfügbaren Lags und prüfe, ob sich die Prognose bei einer anderen Gewichtsfamilie wesentlich verändert.
Ein universelles \(K\) gibt es nicht. Ein längeres Fenster kann anhaltende Information erfassen, fügt aber Parameter hinzu oder erzwingt einen längeren Kurvenverlauf. Ein kurzes Fenster kann langsamere Dynamik verpassen. Wähle die Lag-Zahl nur mit Informationen aus der Schätzperiode und validiere sie ohne das künftige Bewertungsziel. Eine gute Anpassung in der Stichprobe allein zeigt nicht, dass das Lag-Fenster ein wiederholbares Signal erfasst.
Den Prognoseursprung daran ausrichten, wann Werte bekannt waren
Frequenzbezeichnungen allein ergeben noch kein gültiges Prognosedesign. Angenommen, die Zielgröße ist die Varianz der kommenden Fünf-Tage-Handelswoche und die Prognose wird nach dem Freitagsschluss erstellt. Prädiktoren können tägliche Werte bis einschließlich Freitag enthalten, nicht aber eine realisierte Varianz, die aus Renditen der kommenden Woche berechnet wurde. Eine veröffentlichte Wochen- oder Monatsstatistik kann später erscheinen als der Zeitraum, den sie beschreibt. Ein Backtest muss den Wert verwenden, der zum damaligen Zeitpunkt tatsächlich verfügbar war, nicht einen später revidierten oder veröffentlichten Wert.
Erstelle vor der Schätzung eine Tabelle zum Prognoseursprung: Zeitpunkt der Prognose, spätester zulässiger Zeitstempel jedes Prädiktors, Zielperiode und Zeitpunkt, ab dem das Ziel beobachtbar ist. Bei Finanzrenditen ist anzugeben, ob die Rendite von Schluss zu Schluss ein Nachtintervall enthält, welche Marktsitzung einen Tag definiert und wie Feiertage oder fehlende Balken die Zahl täglicher Lags ändern. Fünf Handelssitzungen und sieben Kalendertage sind unterschiedliche Intervalle.
Veröffentlichungskalender haben zeitliche Lücken. An einem bestimmten Datum kann ein Prädiktor einen frischen Tageswert haben, während eine monatliche Reihe noch nicht veröffentlicht wurde. Den letzten verfügbaren Monatswert fortzuschreiben kann gültig sein, wenn das Modell ihn am Prognoseursprung als veraltete, aber bekannte Information behandelt. Ungültig ist es, den noch nicht veröffentlichten Wert mit einer späteren Veröffentlichung zu füllen. Revisionen historischer Daten schaffen ein subtileres Look-ahead-Problem: Eine heutige Datenbank kann eine revidierte Makroreihe enthalten, die einem Echtzeitprognostiker damals nicht zur Verfügung stand.
Asynchrone Märkte bringen ein weiteres Ausrichtungsproblem. Ein täglicher Aktien-Schlusskurs und ein täglicher Kryptoschlusskurs können unterschiedliche UTC-Zeitintervalle bezeichnen; eine untertägige Volatilitätsschätzung kann Balken enthalten, die erst nach dem Prognosezeitpunkt enden. Zeitzonenumrechnung, Sommerzeit, Marktschließungen und die Konstruktion der Balken gehören zur Informationsmenge. Beschreibe den Umgang damit, statt anzunehmen, dass Zeilen mit gleichem Datum denselben Informationsstichtag haben.
Ein hypothetisches Beispiel wandelt tägliche Eingaben in eine Wochenprognose um
Angenommen, das Ziel ist die realisierte Varianz der kommenden Woche und die Prognose wird zum Freitagschluss erstellt. Das Modell verwendet fünf tägliche Realized-Variance-Werte der gerade beendeten Woche. Die geschätzten Gewichte von der jüngsten zur ältesten Sitzung seien \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\), also insgesamt eins. Die entsprechenden Tageswerte in Einheiten quadrierter Renditen seien \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
Die gewichtete Historie beträgt \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). Sei der Achsenabschnitt dieses hypothetisch geschätzten Modells \(a=0{,}00012\) und die Steigung \(b=0{,}80\). Dann lautet die Varianzprognose für die nächste Woche \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Falls eine Standardabweichungsangabe nützlich ist, beträgt ihre Quadratwurzel ungefähr \(0{,}02061\), also \(2{,}06\,\%\) über die Zielwoche gemäß der gewählten Definition.
Die Rechnung veranschaulicht die Abbildung täglicher Prädiktoren auf ein künftiges wöchentliches Ziel; Werte und geschätzte Koeffizienten sind erfunden. Sie bedeutet nicht, dass einer der aufgeführten Tage die Varianz der Folgewoche verursacht hat oder dass der Vermögenswert steigen beziehungsweise fallen dürfte. Das Gewicht der jüngsten Sitzung zeigt, wie das spezifizierte Prognosemodell die beobachteten Eingaben bedingt auf Stichprobe und Restriktionen kombiniert. Es ist keine kausale Wirkungsgröße.
Das Beispiel macht auch eine Einheitenfrage sichtbar. Tägliche und wöchentliche realisierte Varianz sind beides Renditevarianzen, beziehen sich aber auf unterschiedliche kumulierte Zeiträume. Steigung \(b\), Achsenabschnitt und Zielkonstruktion werden für genau diese Konvention geschätzt; die täglichen Eingaben lassen sich nicht einfach in Wochenvarianz umbenennen. Ist die Zielgröße die logarithmierte Wochenvarianz, liegt die Prognose in Log-Einheiten. Das Exponenzieren des bedingten Log-Mittelwerts ergibt im Allgemeinen nicht den bedingten Mittelwert der Varianz. Für eine Rücktransformation in Niveaus muss das genaue Prognoseziel angegeben und gegebenenfalls eine Rücktransformationskorrektur berücksichtigt werden.
Die Schätzung hängt von Zielgröße und Lag-Beschränkung ab
Bei festem Gewichtsvektor ist die Regression linear in Achsenabschnitt und Steigung. Hängen die Gewichte von unbekannten nichtlinearen Parametern \(\theta\) ab, verwendet man häufig nichtlineare kleinste Quadrate oder ein verwandtes Maximum-Likelihood-Verfahren. Die Schätzung kann Gewichtsformparameter und Regressionskoeffizienten gemeinsam suchen oder die linearen Koeffizienten für jede mögliche Form herausprofilieren. Startwerte, Parametergrenzen, Konvergenzkriterien und lokale Optima können wichtig sein. Fehlgeschlagene Konvergenz oder Randlösungen dürfen im Bericht nicht verborgen bleiben.
Ist \(y\) ein nichtnegatives Volatilitätsmaß, kann eine gewöhnliche lineare Spezifikation negative angepasste Werte erzeugen, besonders außerhalb der Stichprobe. Möglichkeiten sind Einschränkungen, die Niveaus nichtnegativ halten, eine positive Linkfunktion oder die Modellierung des Logarithmus der Zielgröße. Diese Entscheidungen ändern Schätzziel und Prognoseinterpretation. Bei einem Log-Ziel ist die Prognose des bedingten Mittelwerts der Log-Varianz nicht automatisch der bedingte Mittelwert der Varianz; Fehlerverteilung und Rücktransformation sind relevant.
Die Stichprobenunsicherheit hängt auch von der Konstruktion des Ziels ab. Wöchentliche realisierte Varianz aus Intraday-Renditen ist messfehlerbehaftet und kann empfindlich auf Mikrostrukturrauschen, Abtastintervall, Sprünge und fehlende Beobachtungen reagieren. Überlappen sich die Zielwochen, teilen benachbarte Prognosefehler zugrunde liegende Renditen. Standardfehler und Vergleiche unter der Annahme unabhängiger Prognosefehler können dann ungeeignet sein. Verwende Inferenz, die zum Prognosehorizont und zur Abhängigkeitsstruktur passt, und berichte das Messverfahren der Zielgröße.
Auch Parameterstabilität ist ein Thema. Ein geschätztes Gewichtsprofil mittelt über die Schätzstichprobe; bei veränderter Marktstruktur beschreibt die Kurve womöglich kein aktuelles Regime gut. Erweiterungsfenster und rollierende Schätzungen beantworten unterschiedliche Fragen: Das erste nutzt mehr Historie, behält aber ältere Dynamik bei; das zweite passt sich schneller an, hat jedoch weniger Beobachtungen und mehr Schätzrauschen. Lege die Aktualisierungsregel vorab fest und vergleiche sie in einer chronologischen Auswertung mit einer festen Benchmark.
MIDAS ist mit GARCH-MIDAS verwandt, aber nicht identisch
MIDAS bezeichnet eine Art, Beobachtungen mit verschiedenen Abtastfrequenzen über gewichtete Lags zu verbinden. Eine MIDAS-Regression kann ein realisiertes Volatilitätsziel direkt aus früheren täglichen oder untertägigen Maßen prognostizieren. Sie muss keine Ein-Schritt-Rekursion der bedingten Varianz wie in einem GARCH-Modell festlegen.
GARCH-MIDAS ist eine eigene Modellfamilie. Sie kombiniert eine langsam veränderliche Langfristkomponente der Volatilität, häufig getrieben durch niedrigfrequente Variablen, mit einer rekursiv fortgeschriebenen kurzfristigen bedingten Varianzkomponente. Beide Komponenten haben eigene Parametrisierungen und Annahmen. Bei einer Arbeit oder Software mit der Bezeichnung GARCH-MIDAS sind die genauen Gleichungen entscheidend: MIDAS-Gewichte können die Langfristkomponente steuern, während eine GARCH-Rekursion kurzfristige Schocks abbildet. Der Name allein verrät weder Zielgröße noch, ob latente oder realisierte Volatilität prognostiziert wird, noch wie Positivität sichergestellt ist.
Die ursprüngliche MIDAS-Arbeit zur Finanzvolatilität vergleicht in einem sparsamen Prognoserahmen unterschiedliche Prädiktoren, Frequenzen und Lag-Längen. Spätere methodische Arbeiten entwickeln Schätz- und Testeigenschaften von Mischfrequenz-Regressionen weiter, unter anderem im Vergleich mit traditioneller zeitlicher Aggregation. Diese Beiträge stützen die Methodik, aber nicht die Aussage, MIDAS schlage GARCH immer oder hochfrequente Prädiktoren verbesserten stets eine Prognose. Ergebnisse hängen von Anlage, Stichprobe, Ziel, Prädiktor, Horizont und Evaluationsdesign ab.
Wähle das Modell nach der Fragestellung. Soll ein künftiges Maß realisierter Volatilität aus täglicher Historie prognostiziert werden, ist eine direkte MIDAS-Regression ein naheliegender Kandidat. Soll bedingte Varianz rekursiv modelliert werden, vergleiche eine passende GARCH-Spezifikation. Werden vierteljährliche Makroveröffentlichungen mit einem täglichen Finanzziel verbunden, können Veröffentlichungsstände und -zeitpunkte zu berücksichtigen sein. Ähnlich benannte Modelle können unterschiedliche Fragen beantworten; vergleiche daher zuerst Prognoseursprung, Zieldefinition und Informationsmenge.
Messfehler und Auswahl können die Gewichtskurve überlagern
Hochfrequente Daten liefern mehr zeitliche Details, können aber auch mehr Messrauschen enthalten. Sehr kurze Balken enthalten Bid-Ask-Bounce, diskrete Preisstufen, veraltete Quotes, asynchronen Handel und Feed-Fehler. Quadrierte Renditen über immer kürzere Intervalle zu summieren garantiert keine bessere Realized-Variance-Schätzung. Wähle Abtastgitter und Bereinigungsregeln vor der Auswertung der Prognoseleistung und prüfe plausible Alternativen.
Wie viel sich lernen lässt, begrenzt die Anzahl niedrigfrequenter Zielwerte, nicht die scheinbare Zahl täglicher Prädiktorzeilen. Zehn Jahre täglicher Eingaben, gepaart mit wöchentlichen Zielwerten, liefern vor fehlenden Werten und Holdout-Auswertung nur etwa 500 Wochenperioden. Eine glatte MIDAS-Gewichtsfunktion benötigt weniger Koeffizienten als freie Tages-Lags; bei kurzer Stichprobe, sehr persistenten Prädiktoren oder redundanten Lags kann auch ihre Form schwach identifiziert sein.
Viele Analyseentscheidungen erzeugen Auswahlverzerrung: mehrere hochfrequente Maße, Lag-Längen, Gewichtprofile, Transformationen, Märkte, Prognosehorizonte und Verlustfunktionen testen und anschließend nur das beste Ergebnis berichten. Die Anpassung in der Stichprobe ist besonders anfällig, weil dieselben Zielwerte sowohl Parameter als auch Modellwahl leiten. Dokumentiere die getestete Modellfamilie, lege eine primäre Kennzahl fest und verwende einen späteren chronologischen Holdout oder einen Vergleich, der die Auswahl berücksichtigt. Werden viele Prognosen für dieselben Termine verglichen, müssen Abhängigkeit und Mehrfachtests berücksichtigt werden.
Eine geschätzte Gewichtskurve ist keine kausale Erklärung. Hochfrequente Eingaben können Nachrichten, Liquidität oder Marktaktivität abbilden; unbeobachtete Faktoren können sowohl Prädiktoren als auch künftige Volatilität beeinflussen. Prognostischer Nutzen erfordert stabile zeitliche Ausrichtung und Evidenz außerhalb der Schätzstichprobe. Eine kausale Interpretation benötigt ein eigenes Identifikationsdesign und zusätzliche Annahmen, die nicht aus der MIDAS-Lag-Gleichung folgen.
Eine Prognose bestimmt keine profitable Handelsentscheidung
Eine Volatilitätsprognose kann in Risikobudget, Hedge-Größe oder Szenarioband einfließen, legt aber weder das Vorzeichen einer Rendite noch die Richtung einer Position fest. Eine prognostizierte wöchentliche Standardabweichung von \(2{,}06\,\%\) ist keine zugesagte Kursbewegung, kein maximaler Verlust und keine optionsimplizite Volatilitätsnotierung. Sie beschreibt ein gewähltes Streuungsmaß unter Modell und Stichprobe; realisierte Renditen können viel größer oder kleiner sein.
Für eine Strategiestudie müssen Signalzeit, Orderzeit, Instrument, Engagementsregel und Ausstieg vor dem Test feststehen. Schätze MIDAS-Parameter historisch nur mit Informationen neu, die am jeweiligen Prognoseursprung verfügbar gewesen wären. Vergleiche Prognosen mit einer vorab festgelegten Benchmark und einem zur Zielgröße passenden Verlustmaß; simuliere danach Renditen gesondert nach Spread, Gebühren, Funding, Leihe, Marktimpact und Umsatz. Eine statistisch bessere Volatilitätsprognose muss nach Kosten keine höheren Renditen erzeugen.
Berichte Zielgröße und Messverfahren, Definitionen und Einheiten der Prädiktoren, niedrige und hohe Frequenz, Prognoseursprung, Lag-Zahl, Gewichtsfunktion und Beschränkungen, Schätzfenster und Aktualisierungsplan, Umgang mit fehlenden Daten und Datenständen, Verlustfunktion, Benchmark und chronologische Testtermine. Zeige Unsicherheit oder Sensitivität der Prognose, wenn die Wahl des Lag-Profils das Ergebnis wesentlich verändert. Verwandte Grundlagen bieten die Leitfäden zu realisierter Volatilität, Volatilitätsclustern und GARCH sowie Prognosegenauigkeitsvergleichen.
Zu den zentralen Primärquellen gehören Ghysels, Santa-Clara und Valkanovs MIDAS-Studie zur Volatilitätsprognose, Ghysels, Sinko und Valkanovs methodischer Überblick mit Erweiterungen sowie Andreou, Ghysels und Kourtellos' Analyse von Mischfrequenz-Regressionsmodellen. Ihre empirischen Ergebnisse beziehen sich auf die dort untersuchten Stichproben und Designs; sie garantieren keine Leistung in heutigen Märkten oder anderen Anlageklassen.
Häufige Fragen
Q1Bedeutet MIDAS, dass alle Daten auf eine Frequenz gemittelt werden?
Nein. Eine MIDAS-Regression belässt die Zielgröße in ihrer gewählten Frequenz und verwendet strukturierte gewichtete Lags eines höherfrequenten Prädiktors. Nicht alle Reihen müssen auf denselben Zeilenkalender interpoliert werden.
Q2Sind MIDAS-Regression und GARCH-MIDAS dasselbe?
Nein. MIDAS bezeichnet einen Rahmen für gewichtete Lags mit gemischten Frequenzen. GARCH-MIDAS kombiniert eine langfristige MIDAS-Komponente mit einer kurzfristigen GARCH-Varianzrekursion. Ziel und Komponenten müssen anhand der konkreten Gleichungen geprüft werden.
Q3Ist eine genauere MIDAS-Volatilitätsprognose automatisch ein Handelssignal?
Nein. Die Prognose betrifft ein gewähltes Streuungsmaß. Eine Handelsstrategie benötigt eine eigene Richtungs- oder Risikoregel, realistische Ausführungskosten und eine chronologische Auswertung der Nettorenditen.
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Welche Hauptaufgabe hat eine MIDAS-Gewichtsfunktion?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
Detaillierten Leitfaden lesenRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Detaillierten Leitfaden lesenCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Detaillierten Leitfaden lesen