

Diebold–Mariano-Test: So vergleichen Sie Prognosen
Erfahren Sie, wie der Diebold–Mariano-Test gepaarte Prognoseverluste vergleicht, überlappende Horizonte berücksichtigt und warum ein kleiner p-Wert keine Handelsfähigkeit belegt.
In diesem LeitfadenEin kleinerer Backtestfehler ist noch kein Beleg für eine bessere Prognose
Kurze Zusammenfassung
Der Diebold–Mariano-Test vergleicht zwei Prognosen, indem er ihre Verluste für dieselben realisierten Ergebnisse gegenüberstellt. Das Resultat hängt von der Verlustfunktion, der Evaluationsstichprobe, dem Prognosehorizont und der Unsicherheitsschätzung ab. Ein geringerer Stichprobenfehler belegt nicht automatisch eine bessere erwartete Genauigkeit; höhere Prognosegenauigkeit ist außerdem nicht gleichbedeutend mit einer profitablen Handelsstrategie.
Ein kleinerer Backtestfehler ist noch kein Beleg für eine bessere Prognose
Angenommen, zwei Modelle prognostizieren dieselbe Rendite, Volatilität oder wirtschaftliche Größe über dieselben Zeitpunkte. Modell A kann in der Evaluationsstichprobe einen kleineren durchschnittlichen Fehler als Modell B aufweisen. Das beschreibt den beobachteten Stichprobenunterschied, sagt aber nicht, ob er zuverlässig wiederkehrt oder durch die zufällig getesteten Zeitpunkte entstanden ist.
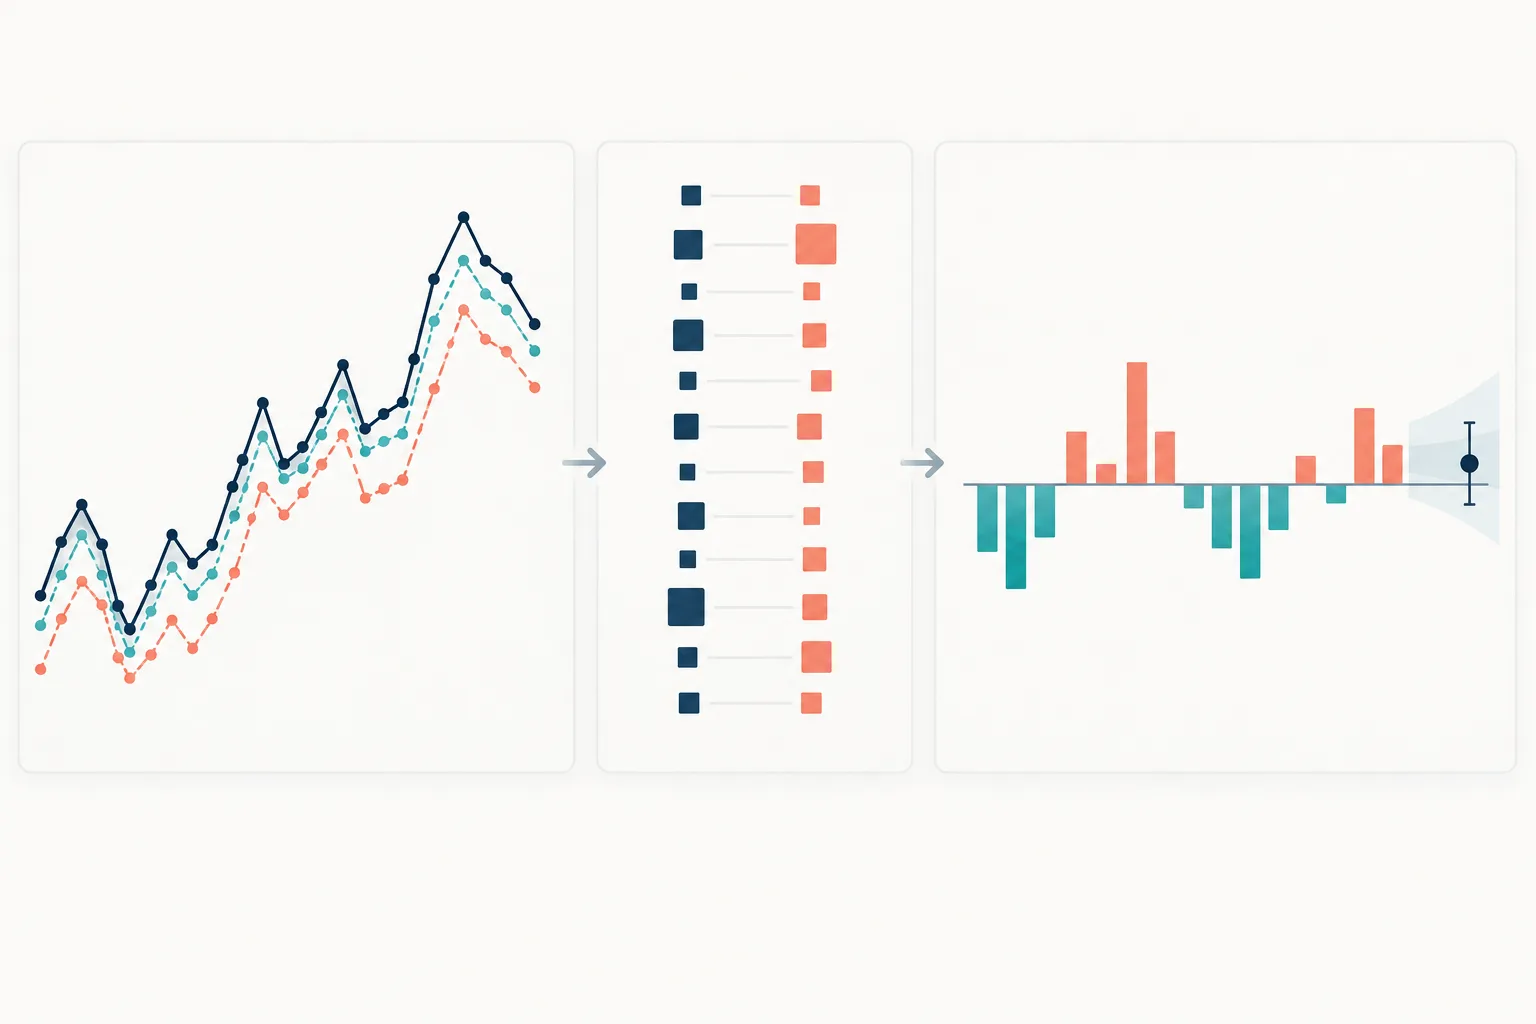
Der Diebold–Mariano-Test (DM-Test) macht aus diesem Vergleich eine gepaarte Zeitreihe. An jedem Prognoseursprung vergleicht er beide Prognosen mit demselben realisierten Ergebnis, bewertet sie anhand einer vorab gewählten Verlustfunktion und untersucht anschließend die Folge der Verlustdifferenzen. Die Paarung ist wichtig: Ein turbulenter Markttag kann die Verluste beider Modelle erhöhen; die Frage lautet, ob eines der Modelle an genau diesen Tagen tendenziell weniger verliert.
Der ursprüngliche Rahmen ist weder auf quadratische Fehler noch auf normalverteilte Prognosefehler beschränkt. Er kann verschiedene, auch asymmetrische Verlustfunktionen vergleichen, sofern sie zur Prognosefrage passen. Voraussetzung sind jedoch ein vertretbares Evaluationsdesign und eine Schätzung der Unsicherheit des durchschnittlichen Verlustunterschieds. Diebold und Mariano (1995) formulieren den Test auf gleiche Prognosegenauigkeit; Harvey, Leybourne und Newbold (1997)00719-4) untersuchen eine Modifikation für kleine Stichproben.
Vor der Berechnung müssen die Prognosen vergleichbar sein
Jede Zeile sollte einen vergleichbaren Prognoseursprung darstellen. Beide Modelle müssen dasselbe Ziel für denselben Horizont prognostizieren und dabei nur Informationen verwenden, die am jeweiligen Ursprung verfügbar waren. Stimmen Sie realisierte Werte, Zeitstempel, Währung oder Einheit, Datenstand und Regeln für fehlende Beobachtungen aufeinander ab. Wenn ein Modell den morgigen Schlusskurs und das andere einen Fünf-Tage-Durchschnitt prognostiziert, beantworten ihre Fehler unterschiedliche Fragen.
Verwenden Sie Prognosen ohne Blick in die Zukunft. Ein chronologischer Testzeitraum oder ein rollierendes Pseudo-Out-of-Sample-Design kann dabei helfen. Eine Aufteilung allein genügt aber nicht, wenn dieselbe Teststichprobe wiederholt zur Anpassung von Merkmalen, Schwellenwerten oder Modellvarianten genutzt wurde. Bewahren Sie die Prognose jedes historischen Ursprungs sowie den damals verwendeten Daten- und Modellstand auf. Überarbeitete Makrodaten, Survivorship-Filter oder spätere Anpassungen an Kapitalmaßnahmen können das Ergebnis sonst nachträglich verändern.
Bewerten Sie beide Modelle anhand derselben Ursprünge. Werden schwierige Zeitpunkte nur für ein Modell ausgelassen, geht die gepaarte Vergleichbarkeit verloren. Bei fehlenden Prognosen sollten Sie eine gemeinsame Stichprobe verwenden oder eine begründete Behandlung der fehlenden Werte angeben. Die Modelle dürfen nicht stillschweigend unterschiedlichen Marktphasen ausgesetzt werden. Legen Sie Anfang und Ende der Stichprobe fest, bevor Sie prüfen, welche Auswahl das gewünschte Ergebnis liefert.
Die Verlustfunktion bestimmt, was „genauer“ bedeutet
Sei yₜ der realisierte Wert am Zeitpunkt t und seien ŷA,ₜ und ŷB,ₜ die Prognosen von A und B. Die Fehler lauten eA,ₜ = yₜ − ŷA,ₜ und eB,ₜ = yₜ − ŷB,ₜ. Eine Verlustfunktion L wandelt jeden Fehler in einen Wert um, bei dem niedriger besser ist. Der quadratische Verlust L(e) = e² bestraft große Abweichungen stärker. Der absolute Verlust L(e) = |e| wächst linear mit der Abweichung. Für eine Quantilprognose kann eine asymmetrische Pinball-Verlustfunktion passen, weil Über- und Unterschätzungen unterschiedliche Kosten haben.
Je nach gewählter Bewertung kann ein anderes Modell besser erscheinen. Betrachten wir zwei hypothetische Fehlerpaare in derselben Einheit: A hat die Fehler 0 und 2, B die Fehler 1 und 1. Der durchschnittliche quadratische Verlust beträgt 2 für A und 1 für B; damit schneidet B besser ab. Beim absoluten Verlust beträgt der Durchschnitt für beide 1. Keine Rechnung ist universell richtig: Sie beantwortet jeweils eine andere Frage dazu, welche Fehler relevant sind.
Bei einer Renditeprognose für den bedingten Mittelwert kann der quadratische Fehler nützlich sein. Für eine Volatilitätsprognose braucht es eine zum Ziel passende Bewertung; eine VaR-Prognose benötigt eine Quantilverlustfunktion oder einen risikospezifischen Backtest. Wird die Verlustfunktion erst nach Kenntnis des Gewinners ausgewählt, wird der Test selbst zu einer weiteren Suche. Legen Sie daher die Bewertung und die Richtung von „besser“ vor dem Vergleich fest.
Eine VaR-Prognose zielt auf ein Verteilungsquantil im Randbereich und nicht auf eine gewöhnliche Punktprognose. Der Leitfaden zum VaR-Backtesting erläutert, wie Ausnahmenhäufigkeit und zeitliche Verteilung bei dieser gesonderten Risikoprognose geprüft werden.
Verlustdifferenzen bilden und die Nullhypothese angeben
Bei einer Verlustfunktion, bei der niedrigere Werte besser sind, definieren Sie die Differenz für Periode t als:
dₜ = L(eA,ₜ) − L(eB,ₜ)
Nach dieser Vorzeichenkonvention bedeutet ein positives dₜ, dass B an diesem Ursprung den niedrigeren Verlust hat; ein negatives dₜ spricht für A. Der Stichprobenmittelwert ist d̄ = (1/n) Σ dₜ. Die Nullhypothese gleicher unbedingter Prognosegenauigkeit lautet E[dₜ] = 0. Eine zweiseitige Alternative fragt nach einem Unterschied in beide Richtungen. Eine vorab festgelegte einseitige Alternative kann prüfen, ob ein ausdrücklich benanntes Modell den niedrigeren erwarteten Verlust hat.
Die grundlegende Teststatistik lautet:
DM = d̄ / √(Ŝd / n)
Dabei schätzt Ŝd die Langfristvarianz der Verlustdifferenzreihe, nicht bloß die Varianz der Prognosefehler eines der Modelle. Unter der Nullhypothese und geeigneten Regularitätsbedingungen ist die Statistik asymptotisch standardnormalverteilt. Große positive Werte sprechen unter der genannten Vorzeichenkonvention für B, große negative für A. Der p-Wert beschreibt, wie gut die Daten mit der festgelegten Nullhypothese und den Stichprobenannahmen vereinbar sind; er ist nicht die Wahrscheinlichkeit, dass eines der Modelle wahr ist.
Durch die Paarung werden Unterschiede im allgemeinen Fehlerniveau nur insoweit berücksichtigt, wie sie in den Differenzen je Ursprung erfasst sind. Sie macht die Verlustreihe nicht unabhängig, beseitigt nicht automatisch die Unsicherheit der Parameterschätzung und korrigiert auch keine Suche über zahlreiche Ziele oder Spezifikationen. Solche Entscheidungen gehören in das Design und die Unsicherheitsschätzung.
Ein Ein-Schritt-Beispiel trennt den Stichprobenunterschied von der Evidenz
Nehmen wir 100 gepaarte, hypothetische Ein-Schritt-Prognosen an. Der durchschnittliche quadratische Verlust beträgt für Modell A 0,26 und für B 0,23, gemessen in quadrierten Prozentpunkten. Damit ist d̄ = 0,26 − 0,23 = 0,03 und spricht in der Stichprobe für B. Zur Vereinfachung sei die geschätzte Langfristvarianz von dₜ gleich 0,04, und zwischen den Prognoseursprüngen gebe es keine serielle Kovarianz.
Der Standardfehler des durchschnittlichen Unterschieds ist √(0,04 / 100) = 0,02. Die unkorrigierte Statistik beträgt 0,03 / 0,02 = 1,50. Bei Horizont h = 1 und T = 100 lautet der Kleinstichprobenfaktor nach Harvey–Leybourne–Newbold: √[(T + 1 − 2h + h(h − 1)/T) / T] = √0,99 ≈ 0,995. Multipliziert ergibt sich eine korrigierte Statistik von etwa 1,49. Mit der näherungsweisen t₉₉-Referenzverteilung liegt der zweiseitige p-Wert bei etwa 0,14.
B hat den niedrigeren beobachteten mittleren quadratischen Fehler, doch liefert dieses Beispiel bei üblichen Signifikanzschwellen keinen starken Beleg gegen gleiche erwartete Genauigkeit. Eine Nichtzurückweisung beweist keine Gleichheit der Modelle. Auch eine Zurückweisung gilt nur für die gewählte Bewertung, die Prognoseursprünge und die Annahmen. Die Verlust- und Varianzwerte sind hypothetische Lehrbeispiele, keine empirischen Ergebnisse.
Bedingt auf diesen Werten betragen die entsprechenden Wurzeln der mittleren quadratischen Fehler (RMSE) etwa 0,510 und 0,480 Prozentpunkte; die beschreibende Differenz liegt bei 0,030 Prozentpunkten. Die DM-Statistik verwendet weiterhin gepaarte Differenzen der quadratischen Verluste und testet nicht die Differenz der beiden Quadratwurzeln.
Überlappende Horizonte machen die Verlustdifferenzen abhängig
Werden täglich Fünf-Tage-Prognosen erstellt, teilen benachbarte Prognosen vier ihrer fünf Zieltage. Ihre Fehler, Verluste und Verlustdifferenzen können sich daher gemeinsam bewegen. Werden 100 tägliche Prognoseursprünge wie 100 unabhängige Vergleiche behandelt, kann das die Unsicherheit unterschätzen und die Teststatistik zu groß erscheinen lassen.
Die Langfristvarianz berücksichtigt die serielle Kovarianz in dₜ. Ein verbreiteter heteroskedastizitäts- und autokorrelationskonsistenter (HAC) Schätzer hat die Form:
Ŝd = γ̂₀ + 2 Σₖ₌₁ᵐ wₖ γ̂ₖ
Dabei ist γ̂ₖ die Stichprobenautokovarianz bei Verzögerung k, wₖ ein Kernelgewicht und m die gewählte Bandbreite. Newey und West (1987) beschreiben einen positiv semidefiniten HAC-Kovarianzschätzer. Bei idealen h-Schritt-Prognosefehlern entsteht unter den einschlägigen Annahmen durch die Überlappung häufig Abhängigkeit bis mindestens zur Verzögerung h − 1; der ursprüngliche DM-Rahmen behandelt hierfür einen abgeschnittenen Schätzer. Reale Daten können wegen persistenter Zielgrößen, rollierender Schätzung oder Strategiekonstruktion längere Abhängigkeit aufweisen. h − 1 ist daher keine allgemeingültige Regel für die Bandbreite.
Geben Sie Horizont, Kernel, Bandbreite und eine etwaige Kleinstichprobenkorrektur an. Zeigen Sie, ob die Schlussfolgerungen unter plausiblen Einstellungen zur Abhängigkeit bestehen bleiben, statt die Bandbreite nach einem bevorzugten p-Wert auszuwählen. Wenn die Prognoseursprünge weit genug auseinanderliegen, um Überlappung zu vermeiden, erläutern Sie auch, welche Information oder Stichprobengröße dadurch verloren geht. Eine Abhängigkeit berücksichtigende Unsicherheitsschätzung gehört zum Test und ist keine bloße Anzeigeoption.
Verschachtelte Modelle und wechselnde Prognosefähigkeit verlangen andere Fragen
Der gewöhnliche DM-Vergleich ist am einfachsten zu interpretieren, wenn die Prognosen unter der Nullhypothese gleicher Genauigkeit nicht verschachtelt sind. Enthält ein größeres Modell ein kleineres Basismodell, können die zusätzlich geschätzten Koeffizienten Prognoserauschen hinzufügen, selbst wenn ihre wahren Werte null sind. Dann kann die gewöhnliche Differenz der mittleren quadratischen Prognosefehler unter dieser Null eine nicht standardmäßige Verteilung haben. Für Out-of-Sample-MSPE-Vergleiche verschachtelter Modelle berücksichtigt eine Methode wie die Clark–West-Anpassung diesen Effekt des Schätzrauschens. Sie ist jedoch kein allgemeiner Ersatz für den DM-Test in jedem Modelldesign. Siehe Clark und West (2007).
Die gewöhnliche DM-Nullhypothese betrifft den durchschnittlichen, unbedingten Verlust über die gesamte Evaluationsstichprobe. Sie kann Veränderungen im Zeitverlauf verdecken: A kann in ruhigen Phasen besser sein und B in volatilen Phasen, während die Gesamtmittel ähnlich ausfallen. Geht es darum, ob die relative Genauigkeit von Informationen abhängt, die am Prognosedatum bekannt waren, verwenden Tests der bedingten Prognosefähigkeit Verlustdifferenzen zusammen mit vorab festgelegten Instrumenten. Giacomini und White (2006) entwickeln einen solchen Rahmen. Annahmen und Evaluationsfenster bleiben wichtig; beliebige Indikatoren nach Sichtung der Ergebnisse hinzuzufügen ist keine gültige Abkürzung.
Die Testwahl sollte der Vergleichsstruktur folgen: Nicht verschachtelte Prognosen, verschachtelte Modelle, wechselnde bedingte Prognosefähigkeit und eine aus vielen Kandidaten ausgewählte Familie sind unterschiedliche Fälle. Für den letzten Fall erläutert der Leitfaden zu White Reality Check und Hansen SPA die familienweite Korrektur nach der Suche über zahlreiche Handelsregeln.
Ein geringerer Prognoseverlust belegt keine profitable Strategie
Eine Prognose kann statistisch genauer sein, ohne das Netto-Handelsergebnis zu verbessern. Eine Strategie muss die Prognose in eine Position übersetzen, Handelszeitpunkte festlegen und Spreads, Gebühren, Slippage, Markteinfluss, Finanzierung, Leihkosten und Risikolimits berücksichtigen. Eine geringe Verbesserung des mittleren quadratischen Renditefehlers kann für Entscheidungen unbedeutend sein. Umgekehrt kann ein Modell mit leicht höherem Durchschnittsfehler ein für eine bestimmte Regel wichtiges Extremereignis besser erkennen.
Behandeln Sie Prognosebewertung und Portfolioauswertung als getrennte Schritte. Prüfen Sie zuerst die Prognose anhand eines Ziels und Verlustmaßes, die zur Vorhersageaufgabe passen. Bewerten Sie anschließend eine vollständig festgelegte Handelsregel mit Daten, die nicht für die Auswahl der Prognose verwendet wurden, und mit realistischen Annahmen zur Ausführung und Finanzierung. Der p-Wert eines Prognosetests ist weder Backtest-Rendite noch Sharpe Ratio noch eine Wahrscheinlichkeit künftiger Gewinne.
Wer wiederholt Modelle, Ziele, Horizonte, Verlustfunktionen und Stichprobenfenster ausprobiert, erzeugt Selektionsverzerrung, selbst wenn jede einzelne DM-Berechnung korrekt ist. Dokumentieren Sie die gesamte Suche und verwenden Sie eine familienweite Methode, wenn die Forschungsfrage lautet, ob irgendein Kandidat nach dieser Suche Bestand hat. Der Leitfaden zum Block-Bootstrap behandelt eine abhängigkeitserhaltende Unsicherheitsschätzung für eine vorab ausgewählte Statistik. Eine undokumentierte Modellsuche korrigiert er nicht automatisch.
Berichten Sie genug, damit andere die Analyse nachvollziehen können
Nennen Sie beide Prognosemodelle, ihre Beziehung zum Benchmark, Zielgröße, Horizont, Zeitplan der Prognoseursprünge, Evaluationszeitraum, Informationsmenge, Datenstand und Regel für die gemeinsame Stichprobe. Definieren Sie die Verlustfunktion mathematisch und geben Sie an, ob ein positives dₜ für A oder B spricht. Berichten Sie n, den durchschnittlichen Verlust beider Modelle, d̄, den Schätzer der Langfristvarianz, HAC-Kernel und Bandbreite, Kleinstichprobenkorrektur, Referenzverteilung, Testrichtung und p-Wert.
Geben Sie außerdem an, ob die Modelle verschachtelt sind, wie die Parameter geschätzt wurden, ob der Vergleich vor oder nach Einsicht in die Ergebnisse ausgewählt wurde und welche anderen Varianten geprüft wurden. Wurde die Stichprobe für die Modellauswahl verwendet, sollte der Test als Teil dieser Suche bezeichnet und nicht als unberührte Out-of-Sample-Evidenz dargestellt werden. Ein klarer Bericht zeigt, was genau verglichen wird und welche Unsicherheits- oder Auswahlprobleme der Test offenlässt.
Häufige Fragen
Q1Setzt der Diebold–Mariano-Test normalverteilte Prognosefehler voraus?
Nein. Der Rahmen kann nicht normalverteilte Prognosefehler berücksichtigen. Er verlangt dennoch eine geeignete Varianzschätzung der Verlustdifferenzen und Regularitätsbedingungen für die Referenzverteilung.
Q2Kann ich zwei Modelle mit unterschiedlichen Prognosehorizonten vergleichen?
Nicht als direkten Vergleich der Prognosegenauigkeit. Stimmen Sie Ziel und Horizont zuerst ab; andernfalls beantworten die Modelle unterschiedliche Prognosefragen.
Q3Reicht ein signifikanter DM-Befund zur Auswahl eines Handelsmodells?
Nein. Er liefert Evidenz zu erwarteten Prognoseverlusten in einem festgelegten Vergleich. Modellsuche, Entscheidungsregeln, Ausführungs- und Finanzierungskosten sowie die Out-of-Sample-Strategieperformance müssen zusätzlich bewertet werden. Primärliteratur - Diebold und Mariano, “Comparing Predictive Accuracy” (1995) - Harvey, Leybourne und Newbold, “Testing the Equality of Prediction Mean Squared Errors” (1997)00719-4) - Giacomini und White, “Tests of Conditional Predictive Ability” (2006) - Clark und West, “Approximately Normal Tests for Equal Predictive Accuracy in Nested Models” (2007) - Newey und West, “A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix” (1987)
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Wenn dₜ = L(eA,ₜ) − L(eB,ₜ) gilt: Welches Modell spricht ein positiver Stichprobenmittelwert für?
Wähle eine Antwort, um die Erklärung zu sehen