

হায়াশি–ইয়োশিদা কোভ্যারিয়েন্স এস্টিমেটর: অসমসময়ের দাম
দুই সম্পদের দাম ভিন্ন সময়ে পর্যবেক্ষিত হলে overlapping return interval ব্যবহার করে Hayashi–Yoshida পদ্ধতি কীভাবে integrated covariance মাপে এবং পদ্ধতিটির সীমা কোথায়—তা জানুন।
এই গাইডেলেনদেনের সময় আলাদা হলে সম্পদদামের covariance মাপা কঠিন কেন
সংক্ষিপ্ত সারাংশ
Hayashi–Yoshida (HY) estimator এমন দুইটি price series-এর integrated covariance মাপে যেগুলো ভিন্ন ভিন্ন সময়ে পর্যবেক্ষিত হয়। দুই দামের timestamp আগে মিলিয়ে interpolation না করে, যেসব return increment-এর সময়-পরিসর পরস্পর overlap করে সেগুলোর গুণফল নেওয়া হয়। প্রচলিত রূপে HY diffusion model-এর অধীনে asynchronous sampling সমস্যা সামলায়; এটি বাজারের microstructure noise সরায় না বা covariance-কে forecast-এ পরিণত করে না।
লেনদেনের সময় আলাদা হলে সম্পদদামের covariance মাপা কঠিন কেন
দুইটি asset একই বাজার-সময়ে লেনদেন করলেও তাদের trade বা quote update ঠিক একই মুহূর্তে নাও হতে পারে। বেশি liquid শেয়ারে ঘন ঘন price print হতে পারে, অথচ কম সক্রিয় শেয়ারে কিছু সময় কোনো নতুন trade বা quote নাও আসতে পারে। ফলে দুই দামের পরিবর্তন ভিন্ন time grid-এ দেখা যায়। লক্ষ্য হতে পারে একই সময়ের co-movement মাপা, কিন্তু পর্যবেক্ষিত দুই return-এর জোড়া যে একই সময়-পরিসর ঢাকে, তা নিশ্চিত নয়।
একটি পরিচিত উপায় হলো নিয়মিত সময়ের grid তৈরি করে প্রতিটি asset-এর সর্বশেষ দেখা দাম সামনে বহন করা। এতে return column-গুলো aligned হয়, কিন্তু বহন করা অপরিবর্তিত দাম latent price-এর নতুন independent observation নয়। এর ফলে একাধিক zero return ও পরে দেরিতে একসঙ্গে ধরা পড়া price move তৈরি হতে পারে, যা co-movement-এর মাপ বিকৃত করে। Epps দেখিয়েছিলেন, measurement interval ছোট হলে stock return-এর পর্যবেক্ষিত correlation কমতে পারে; asynchronous observation এর একটি গুরুত্বপূর্ণ কারণ, যদিও market data-র অন্য প্রভাবও থাকতে পারে। ছোট interval-এ এই pattern-কে সাধারণত Epps effect বলা হয় (Epps, 1979)।
Hayashi ও Yoshida আগে interpolation rule বেছে না নিয়ে মূল asynchronous increment দিয়েই কাজ করা estimator প্রস্তাব করেন। তাদের প্রথম গবেষণায় উচ্চ-কম্পাঙ্কের উপযুক্ত sampling condition-এ diffusion price-এর জন্য consistency প্রতিষ্ঠিত হয় (Hayashi & Yoshida, 2005); পরের গবেষণায় সাধারণ asynchronous sampling scheme-এ asymptotic normality দেখানো হয় (Hayashi & Yoshida, 2008)। মূল ধারণাটি বলা সহজ, কিন্তু ভুলভাবে ব্যবহার করা যায়: কাছাকাছি timestamp নয়, return যে সময়-পরিসর জুড়ে আছে তার overlap দিয়ে increment মেলাতে হয়।
হিসাবের আগে covariance-এর লক্ষ্য নির্ধারণ করুন
একটি সাধারণ continuous diffusion model-এ, যৌথ horizon \([0,T]\)-তে দুই asset-এর latent efficient log price \(X_t\) ও \(Y_t\) ধরা যাক:
\[ dX_t=\mu^X_t\,dt+\sigma^X_t\,dW^X_t,\qquad dY_t=\mu^Y_t\,dt+\sigma^Y_t\,dW^Y_t, \]
এবং তাৎক্ষণিক Brownian correlation \(d[W^X,W^Y]_t=\rho_t\,dt\)। লক্ষ্য হলো integrated covariation:
\[ [X,Y]_T=\int_0^T \sigma^X_t\sigma^Y_t\rho_t\,dt. \]
এটি নির্বাচিত observation window জুড়ে জমা হওয়া path quantity। এটি স্থির price level-এর covariance নয়, এবং স্বয়ংক্রিয়ভাবে correlation-ও নয়। একক হলো দুই return-এর এককের গুণফল: log return-কে percentage point-এ লিখলে estimate-এর একক হবে squared percentage point। Realized volatility হিসাবের গাইড এক-চলকের squared-return measure ব্যাখ্যা করে, আর অর্থায়নে quadratic variation গাইড সেই path quantity বোঝায় যাকে multivariate realized covariance প্রসারিত করে।
লক্ষ্যটি ধনাত্মক বা ঋণাত্মক—দুইই হতে পারে। ধনাত্মক integrated covariation মানে একই সময়ের price increment-গুলোর cross-product একই চিহ্নের হওয়ার প্রবণতা বেশি ছিল; ঋণাত্মক মানে বিপরীত চিহ্নের product প্রাধান্য পেয়েছে। কোনো চিহ্নই একা বলে না কেন asset দুটো একসঙ্গে নড়েছে, একটি অন্যটির কারণ কি না, বা কোনো portfolio rule লাভজনক হবে কি না।
আগের দাম বহন করে synchronization করলে estimate কেন বিকৃত হতে পারে
সাধারণ realized covariance হিসাব করতে analyst নিয়মিত clock time বেছে নিয়ে প্রতিটি asset-এর সর্বশেষ দাম ব্যবহার করতে পারেন। এটি সুবিধাজনক, কিন্তু ফল grid-এর ব্যবধান ও interpolation convention-এর ওপর নির্ভর করতে পারে। দাম stale হলে grid-এর একাধিক observation একই quote পুনরাবৃত্তি করে। পরবর্তী update-টি তখন অন্য asset-এর paired return-এর চেয়ে দীর্ঘ সময় জুড়ে থাকা একক return বলে মনে হতে পারে।
এতে contemporaneous covariance apparent lead–lag-এ সরে যেতে পারে, অথবা grid সূক্ষ্ম হলে শূন্যের দিকে নেমে যেতে পারে। Epps-এর empirical result ছোট measurement interval-এ observed co-movement বদলানোর কথা বলে; পরের গবেষণা দেখায় যে asynchronous sampling এবং noisy observed price থাকলে previous-tick covariance biased হতে পারে। তাই উচ্চ-কম্পাঙ্কে observed correlation কমে যাওয়া একটি diagnostic pattern, asynchronous timing-ই একমাত্র কারণ—তার প্রমাণ নয়।
HY একটি নির্দিষ্ট synchronization choice এড়িয়ে প্রতিটি observed return-এর নিজস্ব interval ধরে রাখে। তবে timestamp-এর মান অপ্রাসঙ্গিক হয় না: দুই series-এর common clock, সঠিক session boundary, এবং horizon-এর শুরু-শেষের স্পষ্ট নিয়ম দরকার। পদ্ধতিটি noisy transaction price, ভুল quote, বা আলাদা trading session মিশে যাওয়াও ঠিক করে না।
পর্যবেক্ষণ-সময়সীমা overlap করলে return-গুলো গুণ করুন
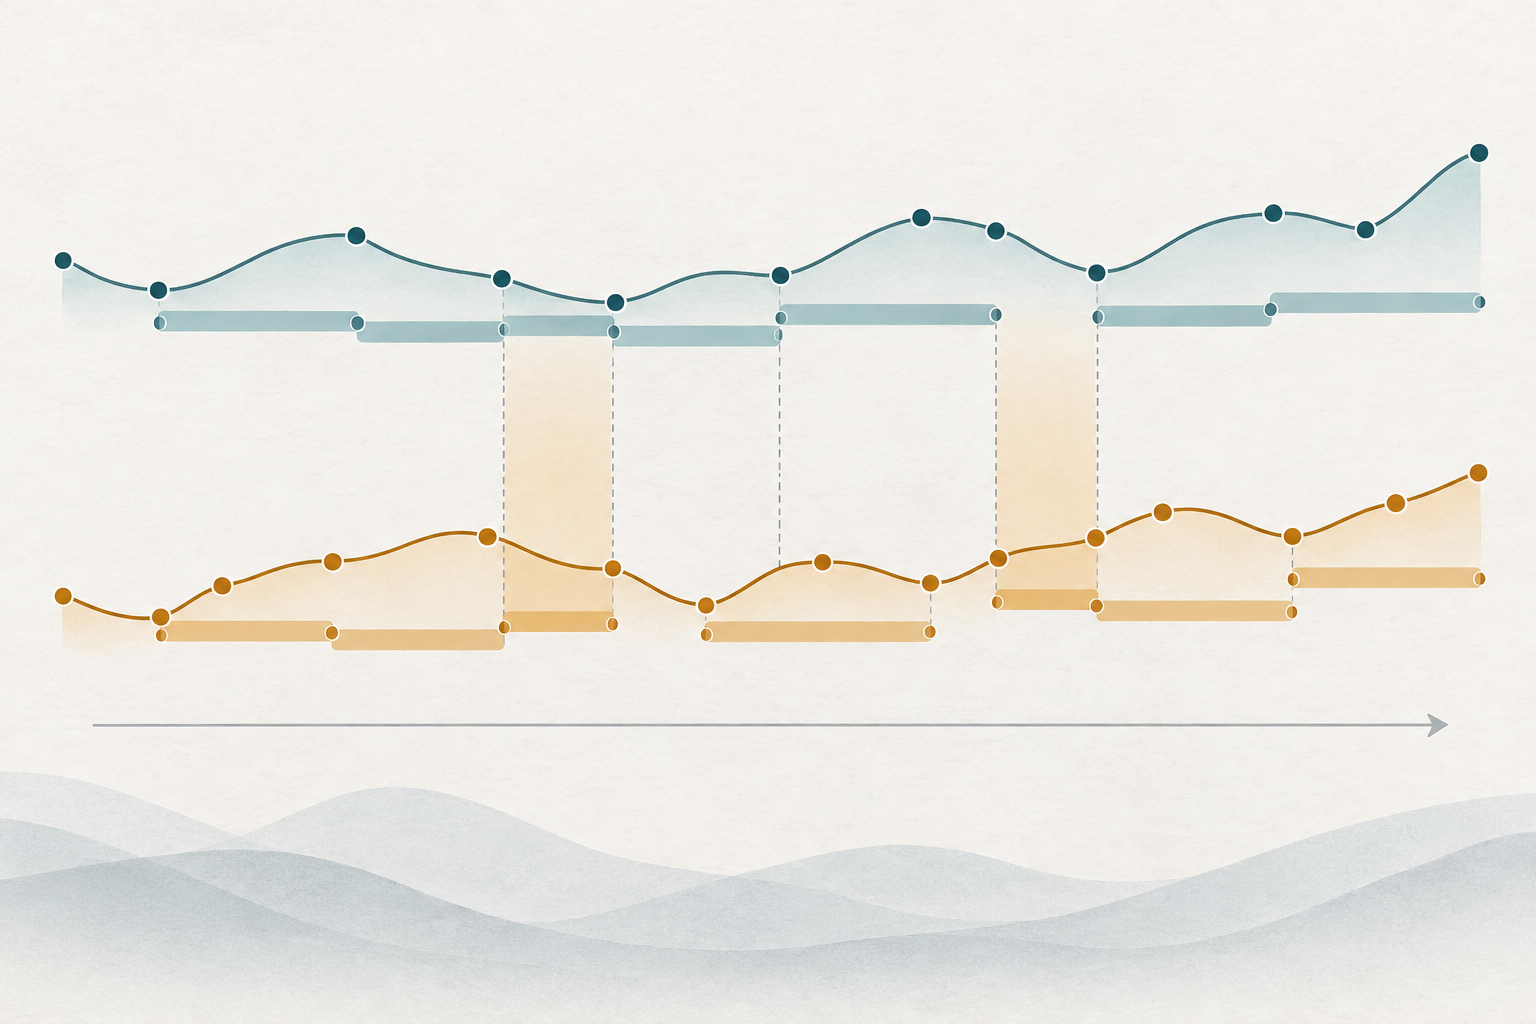
ধরা যাক asset \(X\) পর্যবেক্ষিত হয়েছে \(0=t_0<t_1<\cdots<t_n=T\) সময়ে এবং asset \(Y\) হয়েছে \(0=s_0<s_1<\cdots<s_m=T\) সময়ে। পর্যবেক্ষিত log-return increment:
\[ \Delta X_i=X_{t_i}-X_{t_{i-1}},\qquad \Delta Y_j=Y_{s_j}-Y_{s_{j-1}}. \]
প্রতিটি return-এর সময়-পরিসর হলো \(I_i=(t_{i-1},t_i]\) ও \(J_j=(s_{j-1},s_j]\)। HY estimator:
\[ \widehat{[X,Y]}^{HY}_T =\sum_{i=1}^{n}\sum_{j=1}^{m} \Delta X_i\,\Delta Y_j\, \mathbf{1}\{|I_i\cap J_j|>0\}. \]
Indicator তখনই cross-product অন্তর্ভুক্ত করে যখন return interval দুটির overlap-এর দৈর্ঘ্য ধনাত্মক। শুধু একটি endpoint মিলে গেলে তা ধনাত্মক সময়ের overlap নয়। একটি increment অন্য asset-এর একাধিক increment-এর সঙ্গে overlap করতে পারে; প্রতিটি এমন pair একবার করে যোগ হয়। পদ্ধতিটি price forward-fill করে না এবং কোনো return-কে কল্পিত ছোট return-এ ভাগও করে না।
প্রচলিত continuous-diffusion setup-এ, যথেষ্ট ছোট observation interval ও উপযুক্ত sampling condition থাকলে সর্বোচ্চ interval length কমার সঙ্গে সঙ্গে এই sum integrated covariation-এর দিকে যায়। মূল ফলটি asynchronous observation নিয়ে; এটি ধরে যে observed price-এ raw tick data-তে প্রায়ই দেখা microstructure noise নেই।
<!-- learn:illustration -->
ছোট একটি কাল্পনিক overlap হিসাব পুনরায় করুন
ধরা যাক দুই asset-কে একই পাঁচ-unit session জুড়ে পর্যবেক্ষণ করা হয়েছে। সারণিতে কাল্পনিক log return percentage point-এ এবং প্রতিটি return যে interval ঢাকে তা দেখানো হয়েছে। observation time আলাদা, তাই সব interval endpoint মেলে না।
| X সম্পদের সময়-অন্তর | রিটার্ন | Y সম্পদের সময়-অন্তর | রিটার্ন | ওভারল্যাপ গুণফল |
|---|---|---|---|---|
| \((0,1.8]\) | \(+0.40\%\) | \((0,1.0]\) | \(+0.30\%\) | \(+0.12\ \mathrm{pp}^2\) |
| \((0,1.8]\) | \(+0.40\%\) | \((1.0,2.4]\) | \(+0.50\%\) | \(+0.20\ \mathrm{pp}^2\) |
| \((1.8,3.2]\) | \(+0.20\%\) | \((1.0,2.4]\) | \(+0.50\%\) | \(+0.10\ \mathrm{pp}^2\) |
| \((1.8,3.2]\) | \(+0.20\%\) | \((2.4,3.9]\) | \(-0.20\%\) | \(-0.04\ \mathrm{pp}^2\) |
| \((3.2,5]\) | \(-0.10\%\) | \((2.4,3.9]\) | \(-0.20\%\) | \(+0.02\ \mathrm{pp}^2\) |
| \((3.2,5]\) | \(-0.10\%\) | \((3.9,5]\) | \(+0.10\%\) | \(-0.01\ \mathrm{pp}^2\) |
যেমন, \(X\)-এর প্রথম interval, \(Y\)-এর প্রথম interval-এর সঙ্গে 0 থেকে 1.0 পর্যন্ত এবং দ্বিতীয়টির সঙ্গে 1.0 থেকে 1.8 পর্যন্ত overlap করে; তাই দুই cross-product-ই যোগ হয়। পরের \(X\) return-টি \(Y\)-এর দ্বিতীয়টির সঙ্গে 1.8 থেকে 2.4 এবং তৃতীয়টির সঙ্গে 2.4 থেকে 3.2 পর্যন্ত overlap করে। \(X\)-এর শেষ দুই overlap থেকে \(0.02-0.01\ \mathrm{pp}^2\) আসে। ছয়টি অন্তর্ভুক্ত product যোগ করলে:
\[ \widehat{[X,Y]}^{HY}_T =0.12+0.20+0.10-0.04+0.02-0.01 =0.39\ \mathrm{pp}^2. \]
এক percentage point decimal-return এককে \(0.01\), তাই \(0.39\ \mathrm{pp}^2=3.9\times10^{-5}\) decimal log-return squared এককে। এই input-গুলো কেবল হিসাব বোঝানোর জন্য বানানো; বাস্তব price বা market observation নয়। ফলটি এই window-এর cumulative covariance estimate—percentage return, correlation বা market observation নয়।
চিহ্ন ও মাপ ব্যাখ্যা করুন, covariance-কে trading signal বানাবেন না
উদাহরণে positive sum মানে overlap করা interval-গুলোর positive-positive এবং negative-negative product, negative product-গুলোর চেয়ে বেশি ছিল। এর অর্থ কোনো asset 0.39% বেড়েছে বা তাদের নড়াচড়ার 39% অভিন্ন—এমন নয়। Covariance return unit, window length ও activity-র সঙ্গে scale হয়; বড় মান ভিন্ন একক বা horizon-ও বোঝাতে পারে, standardized dependence বেশি—তা নয়।
Correlation এককবিহীন, এবং covariance-কে volatility estimate দিয়ে scale করতে হয়। আলাদা sampling বা আলাদা estimation-এর variance term দিয়ে তৈরি সাধারণ অনুপাত সবসময় বৈধ correlation estimate নয়। সীমিত নমুনায় ফল \([-1,1]\)-এর বাইরেও যেতে পারে। Integrated covariance একা common news, price adjustment-এর বিলম্ব, common exposure বা অন্য mechanism আলাদা করতে পারে না।
Portfolio-তে ব্যবহার করলে asset weight, horizon, return unit ও covariance convention জানান। Positive HY estimate-কে long signal বা negative estimate-কে hedge নির্দেশনা হিসেবে নেবেন না। Forex pair correlation গাইড ব্যাখ্যা করে কেন correlation ও shared exposure সতর্কভাবে বুঝতে হয়। Historical realized measure নির্বাচিত data window সংক্ষেপ করে; পরের return পূর্বাভাস দেয় না এবং hedge ভবিষ্যৎ loss পুষিয়ে দেবে—এমন নিশ্চয়তাও দেয় না।
প্রচলিত HY-এর sampling ও price assumption জানুন
ক্লাসিক estimator-টি diffusion-ধরনের price-এর জন্য তৈরি, যেগুলো আলাদা ও asynchronous সময়ে discrete ভাবে পর্যবেক্ষিত হয়। ব্যবহারিক approximation-এর জন্য যথেষ্ট observation দরকার, যাতে প্রতিটি series-এর সর্বোচ্চ gap analysis window-এর তুলনায় ছোট হয়। দীর্ঘ no-trade gap অনেক সম্ভাব্য movement জুড়ে থাকা wide return তৈরি করে; formula তখনও হিসাব করা যায়, তবে fine-sampling approximation দুর্বল হতে পারে।
Observed transaction price-এ bid–ask bounce, price discreteness, stale quote, latency ও অন্যান্য measurement effect থাকতে পারে। HY-এর overlap rule সময়ের অমিল সামলায়; এই price error সরায় না। Griffin ও Oomen asynchronous sampling ও iid microstructure noise-এর অধীনে realized covariance, lead–lag adjustment, ও HY-এর বৈশিষ্ট্য বিশ্লেষণ করেন। তারা দেখান finite-sample performance noise ও correlation condition-এর ওপর নির্ভর করে (Griffin & Oomen, 2011)। তাই plain HY-কে সাধারণভাবে noise-robust বলা ঠিক নয়।
Model-এর জন্য বিশ্বাসযোগ্য common horizon-ও দরকার। একটি market অন্যটির আগে বন্ধ হলে, একই calendar window একই সক্রিয় trading period বোঝায় নাও হতে পারে। Time-zone conversion, daylight-saving shift, auction print, corporate action, missing interval ও outlier filtering overlap set পাল্টাতে পারে। Timestamp-কে নিছক administrative detail না ভেবে এসব সিদ্ধান্ত লিখে রাখুন।
বিন্দু-অনুমান থেকে আলাদা করে পরিসংখ্যানগত অনুমান ও নয়েজ-ব্যবস্থাপনা বেছে নিন
Point estimate confidence interval নয়। Hayashi ও Yoshida পরে সাধারণ asynchronous sampling scheme-এ asymptotic normality প্রতিষ্ঠা করেন; কিন্তু ব্যবহারিক standard error-এর জন্য sampling design-সঙ্গত feasible variance estimator ও assumption দরকার। Sparse বা অসম observation estimate-কে স্থিতিশীল দেখালেও uncertainty বড় হতে পারে।
Noisy high-frequency price-এর জন্য noise ও asynchronous sampling—দুটির জন্য তৈরি পদ্ধতি ব্যবহার করুন, অথবা noise সীমিত করে এমন sampling ও preprocessing rule-এর যুক্তি দিন। Christensen, Kinnebrock ও Podolskij noisy diffusion model-এ asynchronous data-এর জন্য pre-averaging covariance estimator তৈরি করেন; এর মধ্যে pre-averaged HY-ধরনের estimator আছে, যা raw price আগে align না করেও ব্যবহার করা যায় (Christensen et al., 2010)। Barndorff-Nielsen ও সহলেখকদের multivariate realized kernel noise ও nonsynchronous trading-সহ covariation লক্ষ্য করে এবং positive-semidefinite covariance estimate দেওয়ার জন্য নির্মিত (Barndorff-Nielsen et al., 2011)। Realized-kernel estimator গাইড-এ এই বিকল্পটি বিস্তারিত আছে।
Portfolio optimizer বা risk system-এর coherent covariance matrix দরকার হলে positive-semidefinite বৈশিষ্ট্য গুরুত্বপূর্ণ। ভিন্ন overlap set ব্যবহার করে জোড়াভিত্তিক HY estimate তৈরি করলে একত্রিত matrix positive-semidefinite হবে—এ নিশ্চয়তা নেই। Eigenvalue বদলে matrix চুপিসারে “সংশোধন” করবেন না; projection, shrinkage বা বিকল্প estimator আলাদা modeling step হিসেবে জানান। Noise-robust পদ্ধতিতেও tuning choice ও নিজস্ব assumption থাকে; সব market-data defect-এর স্বয়ংক্রিয় সমাধান নয়।
পুনরুৎপাদনযোগ্য estimate ও তার সীমা জানান
ভালো report-এ দুই price series trade, quote, না midpoint; common clock ও session; \([0,T]\)-এর শুরু-শেষ; return transformation; overlap convention; sampling gap-এর সারাংশ; এবং ব্যবহৃত estimator উল্লেখ থাকা উচিত। Covariance unit ও window দেখান। Stale observation, outlier, jump, auction, market close ও microstructure noise কীভাবে সামলেছেন তা লিখুন। Input asynchronous হলে raw interval ব্যবহার করেছেন, নাকি আগে price synchronize করেছেন—তা জানান।
অভ্যাসবশত integrated covariance-কে rate বা annualized number-এ রূপান্তর করবেন না। Window estimate-কে rate বা annualized value-এ বদলালে time-scaling assumption এবং overnight period ও market closure কীভাবে ধরা হয়েছে তা জানান। Correlation estimate করতে variance denominator-এর estimator উল্লেখ করুন এবং ফল matrix constraint মানে কি না যাচাই করুন। এই reporting choice-গুলো overlap formula-র মতোই ব্যাখ্যাকে প্রভাবিত করে।
Hayashi–Yoshida estimator-এর সুবিধা হলো asynchronous interval-এর cross-product সরাসরি ও পুনরুৎপাদনযোগ্যভাবে জমা করা, synchronized price বানানোর দরকার ছাড়াই। এর classical guarantee উপযুক্ত noise-free diffusion framework এবং যথেষ্ট ঘন sampling-এর শর্তাধীন। এটি causality প্রতিষ্ঠা করে না, microstructure noise সমাধান করে না, বা নির্ভরযোগ্য hedge কিংবা trading rule নিশ্চিত করে না।
সাধারণ প্রশ্ন
Q1HY estimator-এর জন্য দুই asset-কে একই মুহূর্তে trade করতে হয়?
না। এটি সময়ের অমিল সামলানোর জন্যই তৈরি। Observation timestamp আলাদা হলেও return interval overlap করলে product যোগ করে।
Q2Noisy transaction price-এ সরাসরি HY ব্যবহার করা যায়?
Classical estimator diffusion model-এর অধীনে asynchronous sampling সামলায়, arbitrary microstructure noise নয়। Bid–ask bounce, discrete price, stale quote ও এ ধরনের প্রভাবের জন্য আলাদা noise-robust পদ্ধতি বা যুক্তিসমর্থিত sampling procedure লাগতে পারে।
Q3HY estimate কি correlation?
না। এটি integrated covariance estimate করে, যার unit দুই return unit-এর গুণফল। Correlation পেতে volatility দিয়ে scale করতে হয়, আর asynchronous input-এ তৈরি finite-sample estimate correlation-matrix constraint নাও মানতে পারে।
Q4Positive HY estimate-কে trading signal হিসেবে ব্যবহার করা যাবে?
একা নয়। এটি অতীতের window-এর cross-product সংক্ষেপ করে; causality দেখায় না, ভবিষ্যৎ co-movement পূর্বাভাস দেয় না, execution cost বা বদলে যাওয়া risk-ও ধরে না।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
Classical Hayashi–Yoshida sum-এ কোন return pair ঢোকে?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
বিস্তারিত গাইড পড়ুনQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
বিস্তারিত গাইড পড়ুনIV rankThe current IV's position between a lookback-period low and high; one outlier can distort it, so it should not be read as a standalone signal.
বিস্তারিত গাইড পড়ুন