

การประมาณความผันผวนที่เกิดขึ้นจริงด้วย Pre-Averaging
เรียนรู้ว่า pre-averaging ปรับเรียบหน้าต่างผลตอบแทนความถี่สูงอย่างไร แก้อคติจากสัญญาณรบกวนหลักอย่างไร เลือกความยาวหน้าต่างแบบใด และแตกต่างจาก TSRV กับ realized kernel อย่างไร
ในคู่มือนี้เหตุใดผลตอบแทนที่ถี่เกินไปจึงทำให้การเปลี่ยนแปลงของราคาคลาดเคลื่อน
สรุปสั้น
Pre-averaging ใช้ประมาณการเปลี่ยนแปลงของราคาเมื่อราคาที่บันทึกถี่มากมีสัญญาณรบกวนจากโครงสร้างจุลภาค แทนที่จะยกกำลังสองผลตอบแทนดิบทีละค่า วิธีนี้จะรวมผลตอบแทนใกล้กันแบบถ่วงน้ำหนักในหน้าต่างที่ซ้อนทับกัน แล้วหักพจน์ที่แก้ผลกระทบหลักจากสัญญาณรบกวน ผลลัพธ์ขึ้นกับรูปของน้ำหนัก ความยาวหน้าต่าง วิธีสุ่มตัวอย่าง และสมมติฐานเรื่องสัญญาณรบกวน วิธีนี้วัดการเปลี่ยนแปลงในช่วงที่สังเกตไปแล้ว ไม่ใช่การพยากรณ์ความผันผวนหรือสัญญาณซื้อขาย
เหตุใดผลตอบแทนที่ถี่เกินไปจึงทำให้การเปลี่ยนแปลงของราคาคลาดเคลื่อน
หากราคาที่สังเกตตรงกับราคาเชิงประสิทธิภาพและไม่มีองค์ประกอบอื่น ผลรวมกำลังสองของผลตอบแทนระหว่างวันก็เป็นตัวประมาณการเปลี่ยนแปลงตลอดช่วงซื้อขายที่เป็นธรรมชาติ แต่ราคาซื้อขายและราคาเสนอจริงยังสะท้อนการสลับระหว่าง bid กับ ask การปัดตามช่วงราคาขั้นต่ำ ความล่าช้า ความไม่ต่อเนื่องของราคา และวิธีบันทึกข้อมูล เมื่อช่วงห่างในการสุ่มตัวอย่างสั้นมาก ผลกระทบเหล่านี้อาจเป็นสัดส่วนใหญ่ของผลตอบแทนกำลังสองแต่ละค่า การเพิ่มจำนวนข้อมูลจึงอาจเพิ่มส่วนของสัญญาณรบกวน แทนที่จะเพียงเผยการเคลื่อนไหวพื้นฐานของราคาให้มากขึ้น
Pre-averaging รับมือปัญหานี้โดยรวมผลตอบแทนในหน้าต่างเฉพาะที่ช่วงสั้นก่อนยกกำลังสอง ฟังก์ชันน้ำหนักที่เรียบเริ่มจากศูนย์ เพิ่มน้ำหนักให้ผลตอบแทนข้างเคียง แล้วลดกลับเป็นศูนย์ที่ขอบหน้าต่าง ผลรวมถ่วงน้ำหนักทำหน้าที่คล้ายตัวกรองเฉพาะที่: ความคลาดเคลื่อนจากการสังเกตที่เป็นอิสระและผันผวนเร็วอาจหักล้างกันได้บางส่วน ขณะที่การเคลื่อนไหวกว้างกว่าของราคาเชิงประสิทธิภาพยังคงอยู่ หน้าต่างที่ซ้อนทับกันทำให้ใช้ข้อมูลได้ตลอดช่วง
การปรับเรียบอย่างเดียวไม่ได้ทำให้ตัวประมาณปราศจากอคติ สัญญาณรบกวนที่ผ่านการกรองยังเพิ่มการเปลี่ยนแปลง จึงต้องมีพจน์แก้ไข Jacod, Li, Mykland, Podolskij และ Vetter พัฒนาวิธี pre-averaging เพื่อประมาณความผันผวนสะสมภายใต้สมมติฐานที่ระบุชัด และแสดงว่าแบบจำลองที่เหมาะสมมีอัตราการลู่เข้า \(n^{-1/4}\) บทความต้นฉบับ เป็นที่มาของวิธีนี้ ส่วนบทความนี้อธิบายกลไก การเลือกพารามิเตอร์ และข้อจำกัด
แยกราคาที่แฝงอยู่ ราคาที่บันทึก และเป้าหมายการวัด
ให้ \(X_{t_i}\) แทนลอการิทึมของราคาเชิงประสิทธิภาพที่แฝงอยู่ ณ เวลาสังเกต \(t_i\) และ \(Y_{t_i}\) แทนลอการิทึมของราคาที่บันทึก:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
โดย \(\epsilon_{t_i}\) คือสัญญาณรบกวนจากการสังเกต แบบจำลองพื้นฐานที่ใช้กันทั่วไปถือว่า \(X_t\) เป็นเซมิแมนทิงเกลต่อเนื่องที่มีความแปรปรวนเฉพาะที่ \(\sigma_t^2\) เป้าหมายในช่วงคงที่ \([0,T]\) คือความแปรปรวนสะสม:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
ผลตอบแทนที่สังเกตได้เขียนแยกได้เป็น \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\) แม้ความคลาดเคลื่อนของราคาจะเป็นอิสระข้ามเวลาสังเกต ความคลาดเคลื่อนในผลตอบแทนที่อยู่ติดกันก็ใช้ค่าที่ปลายช่วงร่วมกันแต่มีเครื่องหมายตรงข้าม จึงเกิดความสัมพันธ์ตามลำดับเวลาในผลตอบแทน และทำให้ความแปรปรวนที่เกิดขึ้นจริงจากทุกข้อมูลไวต่อจำนวนส่วนเพิ่มที่มีสัญญาณรบกวน
คำอธิบายทางทฤษฎีแบบง่ายมักสมมติว่าสัญญาณรบกวนมีค่าเฉลี่ยเป็นศูนย์ เป็นอิสระตามเวลาและจากกระบวนการราคาเชิงประสิทธิภาพ และมีโมเมนต์จำกัดที่เหมาะสม สมมติฐานเหล่านี้ช่วยอธิบายตัวประมาณ แต่ไม่ได้รับประกันว่าจะใช้ได้กับธุรกรรม ราคาเสนอ หรือราคากึ่งกลาง สัญญาณรบกวนอาจเปลี่ยนตามสภาพคล่องและช่วงเวลาในวัน ขึ้นกับราคาเชิงประสิทธิภาพ หรือมีความสัมพันธ์ตามลำดับเวลา เป้าหมายที่รายงานก็สำคัญเช่นกัน: เมื่อมีการกระโดด ความแปรปรวนกำลังสองรวมกำลังสองของการกระโดด แต่ความแปรปรวนสะสมแบบต่อเนื่องไม่รวม
นี่คือการวัดย้อนหลังจากชุดราคาและช่วงเวลาที่ระบุ ไม่ได้สร้างราคาที่แฝงอยู่แต่ละจุดกลับคืนมา ไม่ได้บอกว่ารายการใดผิด และไม่สามารถบอกความผันผวนในอนาคตได้ ก่อนเปรียบเทียบผล ให้ระบุข้อมูลนำเข้าว่าเป็นราคาซื้อขาย จุดกึ่งกลางของ bid–ask หรือการสร้างราคาแบบอื่น
สร้างผลตอบแทน pre-averaged ที่ซ้อนทับกัน
สำหรับผลตอบแทนที่สังเกตได้ \(n\) ค่า \(r_i=Y_{t_i}-Y_{t_{i-1}}\) ให้เลือกความยาวหน้าต่างจำนวนเต็ม \(k_n\) และฟังก์ชันน้ำหนัก \(g\) บนช่วง \([0,1]\) ผลตอบแทน pre-averaged แบบมาตรฐานคือ
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
โดยทั่วไปฟังก์ชันจะต่อเนื่อง เป็นศูนย์ที่ปลายทั้งสองด้าน และเรียบพอสำหรับผลลัพธ์เชิงเส้นกำกับ ตัวอย่างน้ำหนักสามเหลี่ยมคือ \(g(u)=\min(u,1-u)\) เมื่อน้ำหนักที่ขอบเป็นศูนย์ ผลตอบแทนตรงขอบหน้าต่างจึงไม่ได้น้ำหนักเต็มแบบฉับพลัน รูปร่างน้ำหนักเป็นตัวกรองเฉพาะที่ ไม่ใช่การพยากรณ์หรือแนวโน้มที่ประมาณขึ้น
แต่ละ \(\bar r_i\) รวมผลตอบแทนข้างเคียงก่อนยกกำลังสอง เนื่องจากหน้าต่างซ้อนทับกัน ผลตอบแทน pre-averaged จึงสัมพันธ์กันแม้ผลตอบแทนดิบจะไม่สัมพันธ์ ความพึ่งพานี้เป็นส่วนหนึ่งของพฤติกรรมตัวอย่างของตัวประมาณ จึงห้ามถือว่าผลรวมจากหลายหน้าต่างเป็นข้อมูลอิสระ ช่วงดัชนีหน้าต่างและหลักการจัดการปลายช่วงต้องสอดคล้องกับการปรับมาตรฐานของน้ำหนัก
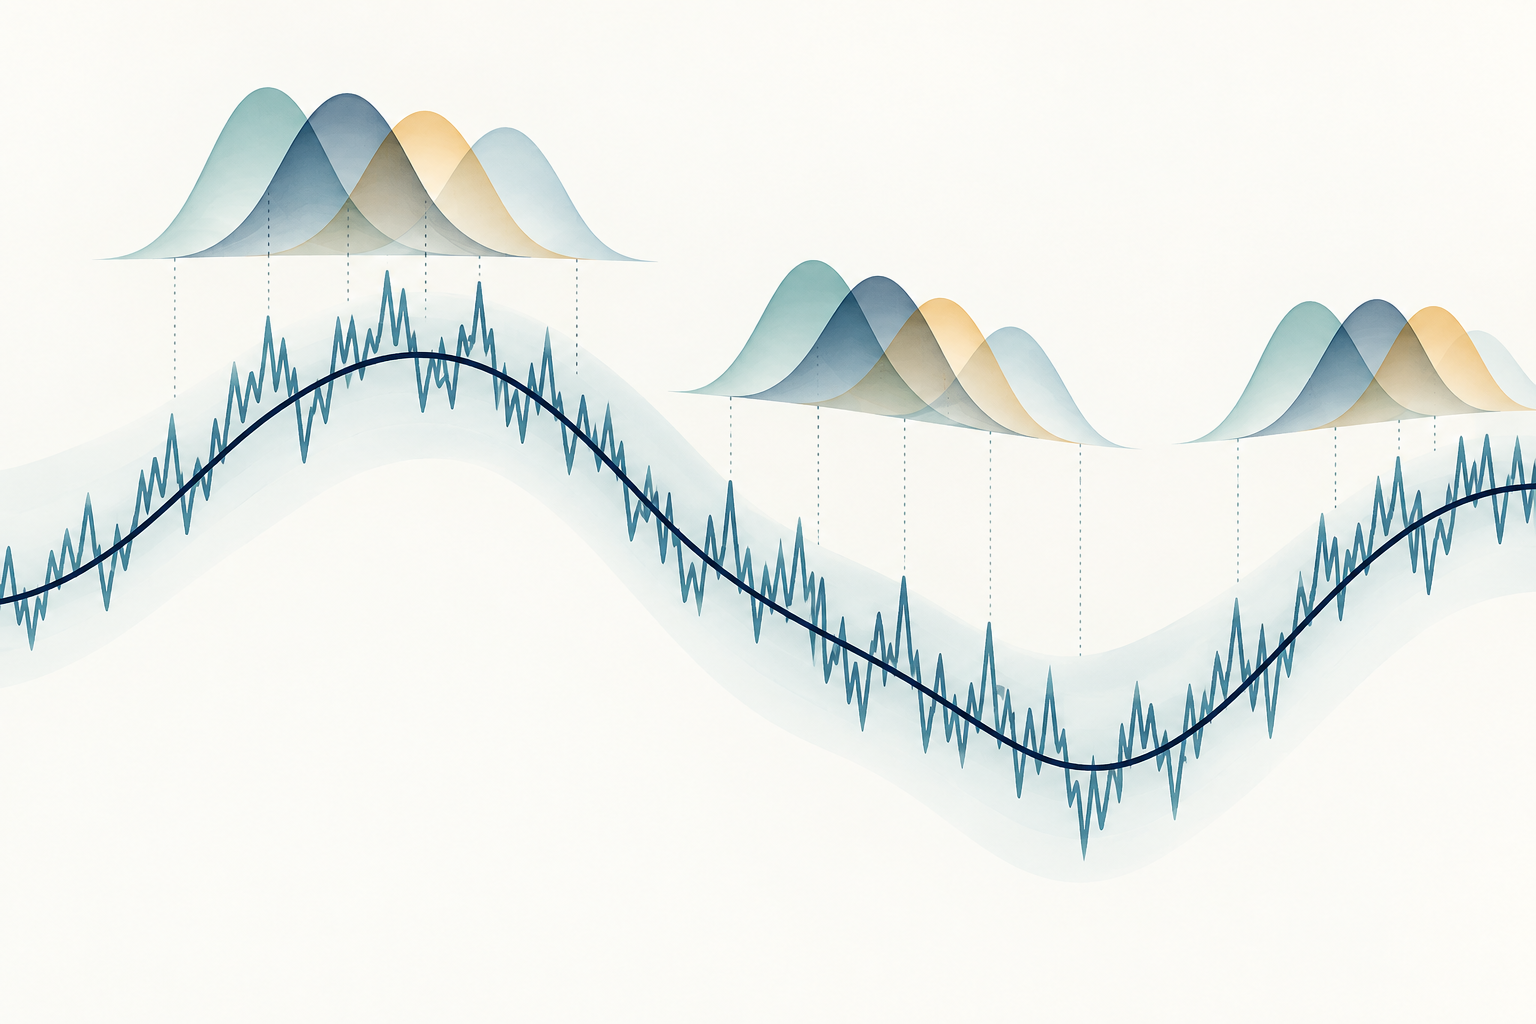
ภาพแสดงเส้นทางแฝงที่เรียบ เส้นทางสังเกตที่ขรุขระ และหน้าต่างหลายช่วงที่ซ้อนทับกันโดยน้ำหนักค่อย ๆ ลดลงที่ขอบ เป็นภาพอธิบายการรวมข้อมูลเฉพาะที่ ไม่ใช่บันทึกราคาตัวอย่างหรือผลลัพธ์จากตัวกรองเชิงประจักษ์
<!-- learn:illustration --> <!-- ภาพแนวคิดไร้ข้อความ: เส้นราคาแฝงที่เรียบอยู่ข้างเส้นทางสังเกตที่ขรุขระ พร้อมหน้าต่างเฉพาะที่ซ้อนทับและลดน้ำหนักที่ปลายเพื่อรวมการเคลื่อนไหวใกล้กัน เป็นเพียงแนวคิด ไม่ใช่ข้อมูลตลาด การพยากรณ์ หรือสัญญาณซื้อขาย -->
แก้ไขส่วนของสัญญาณรบกวนที่ยังเหลือ
Pre-averaging ลดอิทธิพลของความคลาดเคลื่อนจากการสังเกตที่เปลี่ยนเร็ว แต่ผลตอบแทนที่ผ่านการกรองแล้วยกกำลังสองยังมีส่วนของสัญญาณรบกวน สำหรับกริดสม่ำเสมอ รูปแบบทั่วไปของตัวประมาณตัวแปรเดียวที่ใช้ค่าปรับมาตรฐานเชิงเส้นกำกับคือ
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
โดยค่าคงที่ของน้ำหนักคือ
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
พจน์แรกปรับสเกลผลรวมกำลังสองของผลตอบแทน pre-averaged ให้เข้าใกล้ความแปรปรวนสะสม พจน์ที่สองประมาณและหักผลกระทบหลักของสัญญาณรบกวนจากการสังเกตภายใต้แบบจำลอง พจน์นี้ไม่ได้ประมาณสัญญาณรบกวนแต่ละครั้ง และแก้ฟิลด์ราคาที่ผิด เวลาประทับที่ไม่ดี หรือค่าผิดปกติไม่ได้ สูตรตัวอย่างจำกัดที่แน่นอนอาจใช้ \(\psi_1,\psi_2\) แบบไม่ต่อเนื่อง ปรับค่าที่ปลายช่วง และใช้กติกาดัชนีผลตอบแทนเฉพาะ ต้องรายงานและใช้รายละเอียดเหล่านี้อย่างสม่ำเสมอ
การแก้ไขอาจทำให้ค่าประมาณในตัวอย่างจำกัดมีค่าน้อยหรือติดลบ ไม่ได้หมายความว่าสินทรัพย์มีความแปรปรวนทางกายภาพติดลบ แต่หมายถึงค่าปรับที่เลือกมากกว่าพจน์แรกในตัวอย่างนั้น อย่าตั้งค่าประมาณติดลบเป็นศูนย์โดยไม่แจ้ง ให้รายงานผลคำนวณดิบและกฎการตัดค่าที่ใช้แยกต่างหาก เพราะการตัดค่าเปลี่ยนตัวประมาณและอาจส่งผลต่อค่าเฉลี่ยหรือการอนุมานภายหลัง
เลือกความยาวหน้าต่างโดยคำนึงถึงสัญญาณรบกวนและขนาดตัวอย่าง
หน้าต่าง \(k_n\) ควบคุมระดับการปรับเรียบ หากสั้นเกินไป ผลตอบแทนที่กรองแล้วยังเหลือสัญญาณรบกวนความถี่สูงมากกว่า หากยาวเกินไป การเปลี่ยนแปลงราคาเฉพาะที่จะถูกเฉลี่ยในช่วงเวลากว้างขึ้นและมีหน้าต่างที่ใช้ได้น้อยลง ซึ่งอาจเพิ่มข้อผิดพลาดการประมาณแบบอื่น น้ำหนักและความยาวหน้าต่างต้องพิจารณาร่วมกัน ค่า \(k_n\) ไม่มีความหมายหากไม่ระบุฟังก์ชันน้ำหนักและช่วงห่างการสุ่มตัวอย่าง
ภายใต้การออกแบบสมดุลแบบคลาสสิกที่มีช่วงเวลาคงที่และการสังเกต \(n\) ครั้งถี่ขึ้นเรื่อย ๆ หน้าต่างจะโตในระดับ \(\sqrt n\) มักเขียนเป็น \(k_n\sim\theta\sqrt n\) โดย \(\theta>0\) เป็นค่าปรับ ภายใต้สมมติฐานของบทความ ตัวประมาณอาจลู่เข้าด้วยอัตรา \(n^{1/4}\) หรือมีข้อผิดพลาดการประมาณระดับ \(n^{-1/4}\) ซึ่งช้ากว่าอัตรา \(n^{1/2}\) เมื่อไม่มีสัญญาณรบกวน และเป็นอัตราที่เหมาะสมในกรณีมีสัญญาณรบกวนพื้นฐานที่ผู้เขียนศึกษา ไม่ใช่คำรับรองสำหรับชุดข้อมูลตลาดทุกชุด
ค่า \(\theta\), ฟังก์ชันน้ำหนัก และวิธีเลือกค่าจากข้อมูลมีผลต่ออคติและความแปรปรวนในตัวอย่างจำกัด วิธีเลือกอัตโนมัติอาจพึ่งค่าประมาณสัญญาณรบกวนและความผันผวนที่ยังไม่แน่นอน ควรแสดงความไวต่อหน้าต่างที่สมเหตุสมผลหลายค่า อธิบายเวลาอ้างอิงการสุ่มตัวอย่างและขอบเขตช่วงซื้อขาย และอย่าเลือกหน้าต่างหลังเห็นว่าค่าใดสนับสนุนข้อสรุปที่ต้องการมากที่สุด
ตัวอย่างคำนวณสมมติขนาดเล็ก
พิจารณาผลตอบแทนที่สังเกตได้สมมติ 6 ค่า หน่วยเป็น basis points:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
ใช้น้ำหนักสามเหลี่ยม \(g(u)=\min(u,1-u)\) และหน้าต่างสั้น \(k=3\) ที่จงใจเลือกให้สั้น น้ำหนักภายในกริดสองค่าที่ไม่เป็นศูนย์คือ \(g(1/3)=g(2/3)=1/3\) เพื่อแสดงเลขคณิตบนกริดจำกัด ให้กำหนด
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
ตามกติกาดัชนีข้างต้นมีหน้าต่างซ้อนทับกัน \(n-k+2=5\) หน้าต่าง แต่ละหน้าต่างรวมผลตอบแทนข้างเคียง \(1\) bp กับ \(0\) bp จึงได้ \(\bar r_i=(1/3)(1+0)=1/3\) bp และ
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
เมื่อใช้การปรับมาตรฐานกริดจำกัดที่สอดคล้องกัน จะได้
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
ตัวอย่างนี้ใช้ตรวจเลขคณิตและหน่วย ข้อมูลเพียง 6 ผลตอบแทนและหน้าต่างระดับ 3 ช่วงสั้นเกินไปที่จะรองรับการประมาณเชิงเส้นกำกับ ตัวเลขเลือกมาเพื่อให้เห็นการคำนวณชัดเจน ไม่ใช่ข้อมูลตลาด กระบวนการสัญญาณรบกวนจำลอง หรือหลักฐานว่าค่าประมาณกู้คืนความแปรปรวนสะสมที่แฝงอยู่ ไม่มีการคำนวณค่าคลาดเคลื่อนมาตรฐานหรือการพยากรณ์
ทำความเข้าใจสมมติฐานที่รองรับการแก้ไข
การอนุมานมาตรฐานออกแบบสำหรับกระบวนการราคาเชิงประสิทธิภาพแบบต่อเนื่องที่สังเกตบ่อย มีสัญญาณรบกวนบวกเข้า และอยู่ภายใต้เงื่อนไขความสม่ำเสมอ ตัวอย่างสัญญาณรบกวนอิสระค่าเฉลี่ยศูนย์เป็นจุดเริ่มต้นที่มีประโยชน์ แต่การพึ่งพากันระหว่างสัญญาณรบกวนกับราคา ความคลาดเคลื่อนที่มีสหสัมพันธ์ตามลำดับเวลา สัญญาณรบกวนที่เปลี่ยนตามเวลา เวลาสังเกตไม่สม่ำเสมอ หรือการสุ่มตัวอย่างภายใน อาจต้องใช้ตัวประมาณที่ปรับเปลี่ยนหรือทฤษฎีเฉพาะ Aït-Sahalia, Mykland และ Zhang ศึกษาการประมาณความผันผวนสะสมเมื่อมีสัญญาณรบกวนจากโครงสร้างจุลภาคแบบพึ่งพากัน บทความของพวกเขา แสดงว่าไม่ควรมองสูตรสำหรับสัญญาณรบกวน iid ว่าใช้ได้ทั่วไป
การกระโดดทำให้เกิดคำถามต่างหากเกี่ยวกับเป้าหมาย หากต้องการวัดความแปรปรวนกำลังสอง กำลังสองของการกระโดดเป็นส่วนหนึ่งของปริมาณนั้น แต่หากต้องการความแปรปรวนสะสมแบบต่อเนื่องก็ไม่รวม ตัวประมาณ pre-averaging มาตรฐานไม่ได้แยกการกระโดดให้อัตโนมัติ การตัดค่าที่ทนต่อการกระโดดหรือโครงสร้างแบบอื่นมีสมมติฐานและพารามิเตอร์ของตัวเอง ระเบียนราคาที่ผิดปกติเพียงรายการเดียวอาจกระทบหลายหน้าต่างที่ซ้อนกัน การตรวจสอบข้อมูลและจัดการค่าผิดปกติจึงยังจำเป็น
Pre-averaging ยังไม่ใช่คำตอบครบถ้วนสำหรับข้อมูลหลายตัวแปรหรือข้อมูลไม่พร้อมกัน Christensen, Kinnebrock และ Podolskij พัฒนาวิธีความแปรปรวนร่วมแบบ pre-averaging และส่วนขยาย Hayashi–Yoshida ที่ทนต่อสัญญาณรบกวนสำหรับการสังเกตไม่พร้อมกันในงานวิจัย โครงสร้างเหล่านั้นแก้ปัญหาการออกแบบข้อมูลเพิ่มเติม การใช้สูตรตัวแปรเดียวแยกกันกับสินทรัพย์แต่ละตัวไม่ได้ทำให้เวลาประทับตรงกันหรือรับประกันเมทริกซ์ความแปรปรวนร่วมที่ถูกต้อง
แยก pre-averaging ออกจาก TSRV และ realized kernel
ตัวประมาณเหล่านี้จัดการปัญหาการวัดความเปลี่ยนแปลงความถี่สูงที่เกี่ยวข้องกัน แต่จัดระเบียบข้อมูลต่างกัน Two-scale realized volatility (TSRV) เฉลี่ยค่าประมาณจากกริดสุ่มตัวอย่างแบบเบาบางที่เลื่อนตำแหน่งกัน แล้วหักค่าประมาณจากกริดถี่ที่ปรับสเกลเพื่อแก้อคติจากสัญญาณรบกวนหลัก ส่วน pre-averaging กรองหน้าต่างผลตอบแทนสั้นที่ซ้อนทับกันด้วยน้ำหนักเรียบ ยกกำลังสองผลตอบแทนที่กรองแล้ว และใช้การแก้ไขที่เข้าคู่กัน บทความต้นฉบับ two-scale อธิบายโครงสร้างอีกแบบหนึ่ง
Realized kernel เริ่มจากผลรวมกำลังสองของผลตอบแทน แล้วเพิ่มออโตโควาเรียนซ์ของผลตอบแทนที่ถ่วงน้ำหนักตาม lag หลายช่วง bandwidth ควบคุมช่วง lag ที่รวมไว้ ส่วน pre-averaging เปลี่ยนผลตอบแทนเฉพาะที่ก่อนยกกำลังสอง ทั้งสองวิธีใช้ค่าน้ำหนักและพารามิเตอร์ปรับค่า แต่สูตร การปรับมาตรฐาน และสมมติฐานใช้แทนกันไม่ได้ คู่มือ realized kernel อธิบายโครงสร้างตาม lag และ bandwidth
เลือกวิธีตามข้อมูลและปริมาณที่ต้องการ ไม่ใช่ตามชื่อของตัวประมาณ เปรียบเทียบการออกแบบการสุ่มตัวอย่าง แบบจำลองสัญญาณรบกวน การจัดการปลายช่วง เป้าหมายเมื่อมีการกระโดด และพฤติกรรมในตัวอย่างจำกัด ความทนทานเชิงเส้นกำกับไม่ได้รับประกันว่าวิธีนั้นดีที่สุดสำหรับสินทรัพย์ที่ซื้อขายเบาบาง ช่วงซื้อขายสั้น สัญญาณรบกวนที่เปลี่ยนไป หรือฟีดข้อมูลไม่สม่ำเสมอ คู่มือ two-scale อธิบายการเลือกสเกลและการแก้ไขของวิธีนั้น
รายงานการวัดในช่วงที่ผ่านมา ไม่สรุปเป็นผลการซื้อขาย
เพื่อให้ทำซ้ำผลได้ ให้ระบุสินทรัพย์และฟิลด์ราคา ช่วงเวลา ความถี่สุ่มตัวอย่าง กติกาเวลาประทับและช่วงซื้อขาย หน่วยผลตอบแทน ฟังก์ชันน้ำหนัก ความยาวหน้าต่าง การปรับมาตรฐาน กติกาปลายช่วง และสมมติฐานสัญญาณรบกวน หากใช้ตัวประมาณเพื่ออนุมาน ให้รายงานตัวประมาณความแปรปรวนหรือวิธีสร้างช่วงความเชื่อมั่นพร้อมสมมติฐาน ตารางความไวในหลายหน้าต่างที่สมเหตุสมผลช่วยให้เห็นว่าข้อสรุปขึ้นกับการตั้งค่าเพียงค่าเดียวหรือไม่
ความแปรปรวนสะสมวัดช่วงสังเกตที่จบไปแล้ว รากที่สองแสดงสเกลความผันผวนสำหรับช่วงเดียวกัน การปรับเป็นรายปีเพิ่มข้อตกลงเรื่องเวลาแต่ไม่ได้ทำให้ตัวเลขเป็นการพยากรณ์ การพยากรณ์ช่วงเวลาในอนาคตต้องใช้แบบจำลองคาดการณ์แยกต่างหากและประเมินนอกตัวอย่าง คู่มือคำนวณความผันผวนที่เกิดขึ้นจริง อธิบายตัววัดพื้นฐานจากผลรวมกำลังสองของผลตอบแทน ส่วนคู่มือความแปรปรวนกำลังสอง แยกความแปรปรวนของเส้นทางออกจากเป้าหมายความแปรปรวนสะสมต่อเนื่อง
ค่าประมาณไม่ได้ระบุสาเหตุที่ราคาขยับ ไม่ได้พิสูจน์กลยุทธ์ที่ทำกำไร และไม่รับประกันการวัดความเสี่ยงที่นำไปใช้ได้จริง ต้นทุนซื้อขาย สภาพคล่อง การกระโดด พลวัตของความผันผวน และความไม่แน่นอนของตัวประมาณเป็นคำถามคนละส่วน Pre-averaging เป็นเครื่องมือวัดทางสถิติ คุณค่าของมันขึ้นกับว่าสมมติฐานสอดคล้องกับข้อมูลที่สังเกตเพียงใด
คำถามที่พบบ่อย
Q1Pre-averaging เหมือนการหาค่าเฉลี่ยเคลื่อนที่ของราคาหรือไม่?
ไม่เหมือน ตัวประมาณสร้างผลรวมถ่วงน้ำหนักจากผลตอบแทนใกล้กันแล้วจึงยกกำลังสองและแก้ไข การเฉลี่ยระดับราคาแล้วหาผลต่างเป็นการแปลงอีกแบบที่มีน้ำหนักและพฤติกรรมที่ขอบต่างกัน
Q2Pre-averaging กำจัดสัญญาณรบกวนจากโครงสร้างจุลภาคทั้งหมดหรือไม่?
ไม่ วิธีนี้ลดผลกระทบหลักภายใต้สมมติฐานเรื่องสัญญาณรบกวนและการสุ่มตัวอย่างที่กำหนดไว้ สัญญาณรบกวนที่พึ่งพากันหรือเปลี่ยนแปลง การกระโดด ค่าผิดปกติ และปัญหาเวลาประทับยังส่งผลได้
Q3เหตุใดค่าประมาณ pre-averaging สองค่าจึงต่างกันได้?
อาจใช้ฟังก์ชันน้ำหนัก ความยาวหน้าต่าง การปรับมาตรฐานในตัวอย่างจำกัด ฟิลด์ราคา กติกาปลายช่วง หรือวิธีทำความสะอาดข้อมูลต่างกัน ควรรายงานและตรวจความไวของตัวเลือกเหล่านั้น
Q4ค่าประมาณ pre-averaging เป็นการพยากรณ์ความผันผวนหรือไม่?
ไม่ใช่ด้วยตัวมันเอง แต่เป็นการวัดการเปลี่ยนแปลงในช่วงที่นำมาคำนวณ การพยากรณ์ต้องใช้แบบจำลองแยกต่างหากและประเมินนอกตัวอย่าง
แหล่งข้อมูลและการอ่านเพิ่มเติม
รายงานปัญหา
เราจะเตรียมอีเมลพร้อมลิงก์บทความนี้ Mark จะได้รับรายงานเมื่อคุณส่งอีเมลแล้วเท่านั้น
ตรวจสอบอย่างรวดเร็ว
อ่านคู่มือจบแล้ว ลองตอบคำถาม 3 ข้อ
คำถาม 01
จุดประสงค์หลักของการสร้างผลตอบแทน pre-averaged คืออะไร?
เลือกคำตอบเพื่อดูคำอธิบาย
อภิธานศัพท์ออปชัน
Volatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
อ่านคู่มือฉบับละเอียดQuadratic variationThe limit of sums of squared process increments over increasingly fine partitions, measuring accumulated second-order path variation and generating Itô corrections.
อ่านคู่มือฉบับละเอียด