

Probability of Informed Trading (PIN): wzór, przykład i ograniczenia
Dowiedz się, jak model PIN wykorzystuje liczbę transakcji inicjowanych przez kupujących i sprzedających do szacowania handlu opartego na informacji, jak obliczyć wskaźnik oraz ocenić założenia i ograniczenia estymacji.
W tym przewodnikuPIN szacuje modelowy udział napływających zleceń opartych na informacji
Krótkie podsumowanie
Probability of Informed Trading (PIN) to miara mikrostruktury rynku szacowana na podstawie nierównowagi w napływie transakcji inicjowanych przez kupujących i sprzedających. Model mieszaninowy oddziela handel oparty na informacji od zwykłego popytu na płynność, ale wynik zależy od mocnych założeń i starannego dopasowania metodą największej wiarygodności. PIN nie wskazuje konkretnego inwestora dysponującego prywatną informacją, nie przewiduje następnego ruchu ceny i nie potwierdza istnienia zyskownego sygnału.
PIN szacuje modelowy udział napływających zleceń opartych na informacji
Każda zrealizowana transakcja ma kupującego i sprzedającego, ale zwykle nie wiadomo, dlaczego każda ze stron zawarła transakcję. Kupujący może reagować na prywatną informację, równoważyć portfel, zaspokajać potrzebę gotówki albo wykonywać zlecenie według benchmarku. PIN wykorzystuje liczbę transakcji inicjowanych przez kupujących i sprzedających w wielu powtarzających się okresach, aby oszacować, jaką część przepływu zleceń model przypisuje inwestorom działającym na podstawie prywatnej informacji.
Easley, Kiefer, O’Hara i Paperman zaproponowali modelowe podejście do badania handlu opartego na informacji i płynności. W ich modelu dzienne liczby zleceń wynikają z nieobserwowanego stanu informacji. Gdy nie ma prywatnej informacji, zlecenia składają niepoinformowani kupujący i sprzedający. Gdy pojawia się dobra lub zła informacja, poinformowany inwestor dodaje zlecenia po stronie wskazanej przez tę informację. Asymetria liczby transakcji kupna i sprzedaży w wielu dniach pomaga oszacować prawdopodobieństwa ukrytych stanów i intensywności napływu zleceń (Easley i in., 1996).
PIN jest więc estymatą właściwą dla określonej próby i zadanego modelu. Nie stanowi etykiety przypisanej do pojedynczej transakcji, bezpośredniego zliczenia osób dysponujących prywatną informacją ani prawdopodobieństwa, że następna transakcja będzie zawarta przez poinformowanego inwestora. Przy tych samych definicjach i założeniach wyższy wynik oznacza, że dopasowany model przypisuje większą część oczekiwanego napływu zleceń swojej składowej poinformowanych inwestorów.
Model traktuje zdarzenia informacyjne jako stany ukryte
Klasyczny model PIN dzieli każdy okres handlu na jeden z trzech ukrytych stanów. Z prawdopodobieństwem 1 − α zdarzenie informacyjne nie występuje. Z prawdopodobieństwem αδ niesie ono dobre wiadomości, a z prawdopodobieństwem α(1 − δ) — złe wiadomości. Parametr α to prawdopodobieństwo zdarzenia informacyjnego, a δ to warunkowe prawdopodobieństwo dobrych wiadomości, jeśli takie zdarzenie wystąpiło.
Oczekiwana intensywność napływu niepoinformowanych zleceń kupna i sprzedaży wynosi po ε na stronę w każdym okresie. Gdy występuje zdarzenie informacyjne, poinformowany inwestor napływa z oczekiwaną intensywnością μ i handluje w kierunku wynikającym z sygnału: kupuje w dniu dobrych wiadomości, a sprzedaje w dniu złych wiadomości. W najprostszej wersji liczby transakcji kupna i sprzedaży są warunkowo niezależnymi zmiennymi Poissona w każdym stanie. Model nie obserwuje ani stanu, ani typu inwestora; wnioskuje o parametrach na podstawie wzorców zaobserwowanych liczebności.
Są to założenia modelowe, a nie opis, o którym wiadomo, że obowiązuje na każdym rynku. Umożliwiają estymację i interpretację modelu mieszaninowego. Jeśli model nie uwzględnia skupiania transakcji, skorelowanego popytu na płynność, różnic w napływie zleceń w dniach publikacji wiadomości, błędów klasyfikacji stron transakcji lub fragmentacji obrotu między platformami, zjawiska te mogą zostać błędnie przypisane przepływowi zleceń opartemu na informacji.
Wzór PIN porównuje oczekiwany napływ zleceń poinformowanych i niepoinformowanych
W symetrycznej wersji modelu oczekiwana liczba napływających zleceń poinformowanych na okres wynosi αμ. Oczekiwana liczba zleceń niepoinformowanych to ε po stronie kupujących i ε po stronie sprzedających, czyli łącznie 2ε. PIN to składowa poinformowana podzielona przez całkowitą oczekiwaną liczbę zleceń:
PIN = αμ / (αμ + 2ε)
Parametr δ określa, po której stronie handluje poinformowany inwestor, ale znika z ilorazu dla całego napływu. Rozszerzenia modelu mogą dopuszczać bardziej elastyczne intensywności napływu zleceń kupna i sprzedaży lub inne procesy generujące transakcje. Nie należy bez wyjaśnienia zastępować nimi klasycznego wzoru ani przenosić na nie jego interpretacji.
Rozważmy hipotetyczny okres, w którym α = 0.20, μ = 12 oznacza oczekiwaną liczbę napływających zleceń poinformowanych w dniu zdarzenia informacyjnego, a ε = 40 to oczekiwana liczba zleceń niepoinformowanych po każdej stronie na okres. Oczekiwany napływ zleceń poinformowanych wynosi 0.20 × 12 = 2.4. Oczekiwana liczba zleceń niepoinformowanych to 40 + 40 = 80. Udział wynikający z modelu wynosi 2.4 / (2.4 + 80) = 0.0291, czyli około 2.9%.
Przykład ilustruje wyłącznie obliczenie. Nie oznacza, że dokładnie 2.9% zaobserwowanych transakcji zawarli poinformowani inwestorzy, że prawdopodobieństwo informacji w pojedynczej transakcji wynosi 2.9% albo że którykolwiek uczestnik posiadał informację poufną. Intensywności i prawdopodobieństwo zdarzenia są hipotetyczne. W praktyce trzeba je oszacować na podstawie danych oraz podać okres próby i specyfikację modelu.
Na PIN wpływa także mianownik. Jeśli α i μ pozostają bez zmian, ale intensywność napływu niepoinformowanych zleceń po każdej stronie wzrośnie z 40 do 60, PIN wyniesie 2.4 / (2.4 + 120), czyli około 2.0%. Oczekiwana liczba zleceń poinformowanych się nie zmieniła; większa liczba zleceń niepoinformowanych jedynie zmniejszyła ich udział w całości. Spadek PIN nie oznacza więc automatycznie, że ryzyko napływu informacji zmalało. Warto badać parametry oddzielnie, zwłaszcza gdy bazowa aktywność handlowa różni się między okresami.
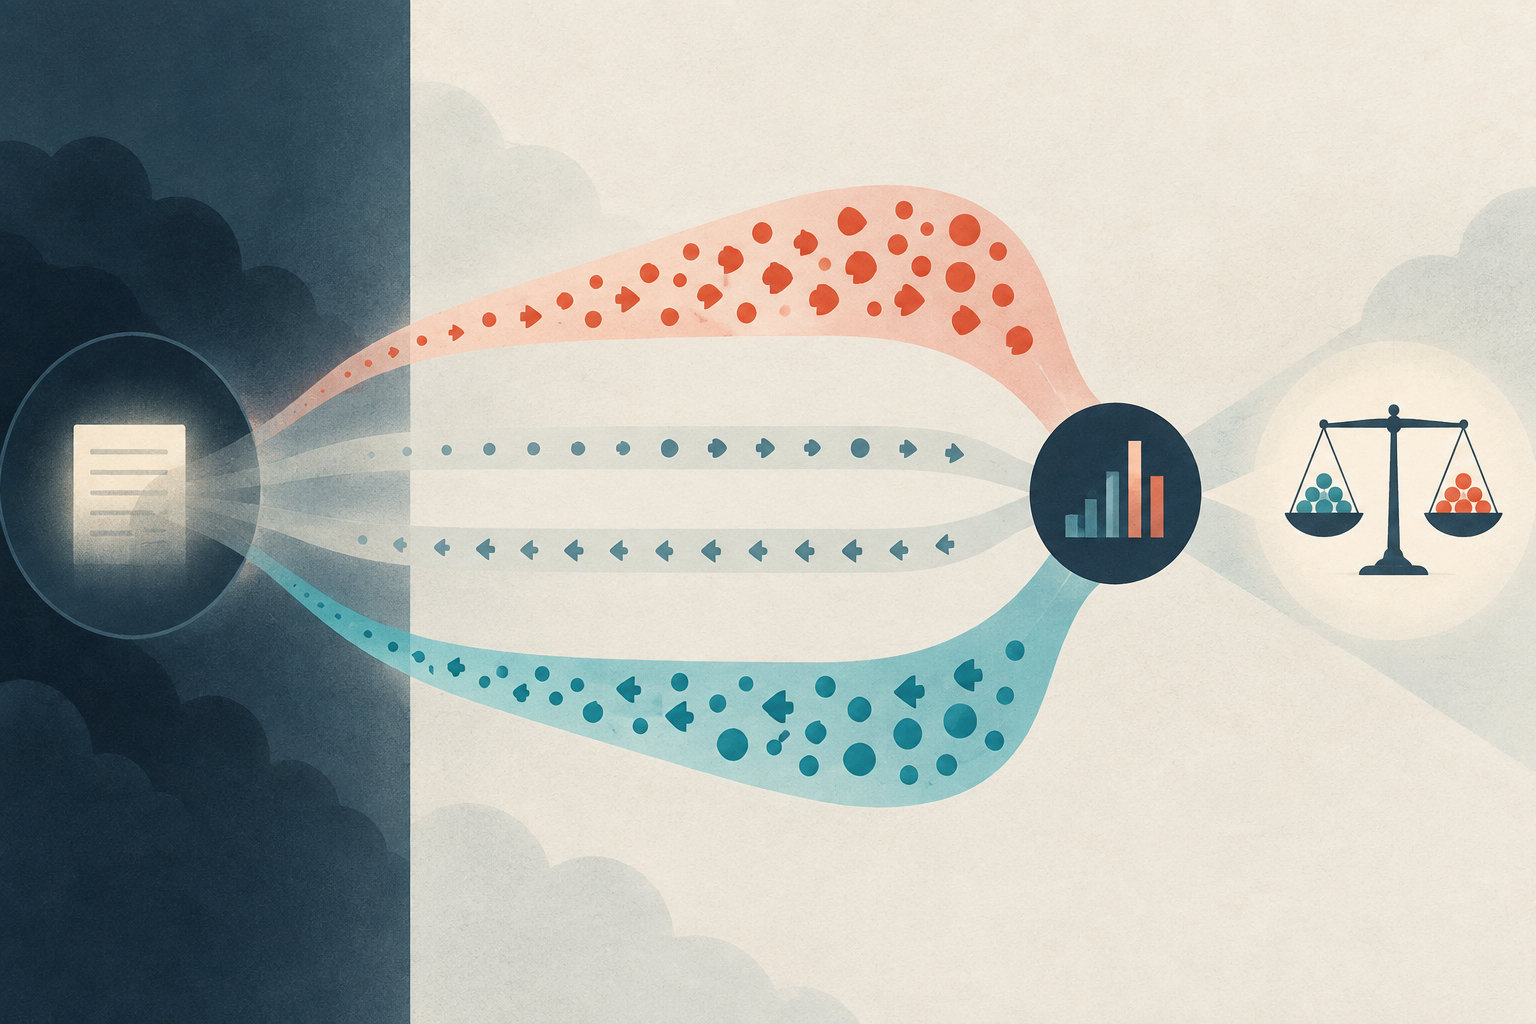
Metoda największej wiarygodności szacuje ukryte parametry z liczby transakcji kupna i sprzedaży
Niech Bₜ oznacza liczbę transakcji inicjowanych przez kupujących w okresie t, a Sₜ — liczbę transakcji inicjowanych przez sprzedających. W klasycznym modelu wiarygodność tych liczebności jest mieszaniną trzech składników. Stan bez zdarzenia ma wagę 1 − α oraz intensywność Poissona ε dla obu stron. Stan dobrych wiadomości ma wagę αδ, intensywność ε + μ dla kupna i ε dla sprzedaży. Stan złych wiadomości ma wagę α(1 − δ), intensywność ε dla kupna oraz ε + μ dla sprzedaży. Aby obliczyć wiarygodność dla danego okresu, mnoży się odpowiednie prawdopodobieństwa Poissona w każdym stanie, a następnie sumuje wyniki dla wszystkich stanów.
Estymator wybiera α, δ, μ i ε tak, aby zmaksymalizować sumę logarytmów wiarygodności w całej próbie. Następnie oblicza się PIN z dopasowanych parametrów. Badacze często estymują model w oknie obejmującym na przykład kwartał, ponieważ dwie liczebności z jednego dnia dostarczają niewiele informacji o mieszaninie. Otrzymany PIN jest estymatą dla całego okna. Dłuższe okno może ustabilizować liczebności, ale zarazem uśrednia zmieniające się warunki rynkowe.
PIN nie jest średnią różnicy między liczbą transakcji kupna a liczbą transakcji sprzedaży. Same liczby netto nie pozwalają odróżnić dnia dobrych wiadomości od okresu, w którym popyt na płynność zwiększa równocześnie aktywność po obu stronach. Metoda największej wiarygodności ocenia na podstawie całej próby, jak liczby kupna i sprzedaży w poszczególnych dniach pasują do trzech stanów ukrytych. Zbyt krótkie okno utrudnia identyfikację mieszaniny, a zbyt długie może zmuszać model do opisywania odmiennych środowisk handlu za pomocą stałych intensywności napływu.
Optymalizacja nie jest nieistotnym szczegółem technicznym. Funkcja wiarygodności może mieć wiele maksimów lokalnych, parametry mogą trafiać na granice, a implementacja może doświadczać niedomiaru lub przepełnienia zmiennoprzecinkowego przy dużych liczbach transakcji. Yan i Zhang opisują istotne obciążenie wynikające z rozwiązań brzegowych i proponują metodę poprawy estymacji (Yan i Zhang, 2012). Wiarygodny wynik wymaga stabilnego numerycznie obliczania funkcji wiarygodności, kilku uzasadnionych wartości początkowych, ograniczeń parametrów zgodnych z modelem i diagnostyki pokazującej, czy wybrane optimum można odtworzyć.
Oznaczanie kierunku transakcji i dobór próby wpływają na estymatę
Klasyczny model wymaga liczby transakcji inicjowanych przez kupujących i sprzedających. Jeżeli źródło danych nie zawiera pola wskazującego stronę agresora, liczebności można uzyskać z klasyfikatora, takiego jak reguła kwotowań, test tickowy lub procedura Lee–Ready. Błędnie sklasyfikowane transakcje przechodzą między Bₜ i Sₜ i mogą zmienić funkcję wiarygodności. Dlatego w dokumentacji estymacji należy podać metodę klasyfikacji, sposób obsługi transakcji po cenie środkowej i transakcji o nieznanym kierunku, zakres platform oraz synchronizację znaczników czasu. Klasyfikacja kierunku transakcji wyjaśnia, dlaczego przypisane kierunki mogą zależeć od kwotowania i źródła danych.
Badacz musi też określić okres, instrument, dopuszczalne warunki transakcji oraz sposób obsługi aukcji, korekt, raportów pozagiełdowych i przedziałów bez transakcji. Połączenie kilku platform może dać inny proces zliczania niż analiza jednej platformy. Zmiana okresu z dziennego na śróddzienny zmienia interpretację intensywności napływu i może pozostawić za mało obserwacji do stabilnej estymacji. Serię PIN można porównywać między aktywami lub okresami tylko wtedy, gdy konstrukcja danych, estymator, okno i wersja modelu są dostatecznie zgodne.
Nie należy po cichu usuwać trudnych obserwacji ani raportować tylko wiarygodnie wyglądającej estymaty. Zachowaj pierwotne liczebności, dokumentuj wyłączenia, sprawdzaj parametry i trafienia w granice oraz porównuj wynik przy rozsądnych alternatywach klasyfikacji i długości okna. Jeśli estymata wyraźnie się zmienia, taka wrażliwość jest częścią wyniku, a nie szumem do ukrycia.
PIN wiąże się z innymi miarami płynności, ale mierzy coś innego
Kwotowany lub efektywny spread bid–ask mierzy ustępstwo cenowe albo koszt realizacji zlecenia. PIN szacuje natomiast udział oczekiwanego napływu zleceń przypisany poinformowanej składowej modelu strukturalnego. Szeroki spread może odzwierciedlać ryzyko negatywnej selekcji, koszty utrzymywania zapasów, opłaty lub konkurencję; sam nie jest wartością PIN. Estymator spreadu Rolla wyznacza spread z autokowariancji stóp zwrotu na podstawie własnych założeń.
Nierównowaga przepływu zleceń podsumowuje różnicę między aktywnością kupujących i sprzedających, często wraz ze składaniem i anulowaniem zleceń limitowanych. Można ją bezpośrednio obserwować w wybranym przedziale, natomiast PIN za pomocą funkcji wiarygodności wnioskuje o latentnym procesie informacyjnym z powtarzających się liczebności. Nierównowaga nie dowodzi handlu opartego na informacji: podobny wzorzec mogą tworzyć potrzeby płynności lub klastrowana realizacja zleceń. Nierównowaga przepływu zleceń opisuje tę odrębną miarę.
VPIN również nie jest po prostu często obliczanym PIN. To statystyka oparta na zegarze wolumenu, zbudowana z nierównowagi w koszykach wolumenu; ma inne zasady klasyfikacji transakcji i doboru próby. Ocena Andersena i Bondarenki podważyła w testowanym przez nich środowisku twierdzenie, że VPIN wiarygodnie mierzy toksyczność lub sygnalizuje zawirowania (Andersen i Bondarenko, 2014). Każdą miarę należy oceniać według jej konstrukcji i dowodów, a nie traktować podobnie brzmiące nazwy jako synonimy.
Estymata wymaga kontroli dopasowania modelu i stabilności
Dopasowana wartość PIN może wyglądać precyzyjnie, choć model liczebności słabo opisuje dane. Gan, Wei i Johnstone badają empiryczne dopasowanie modeli PIN i opisują ograniczenia strukturalne w analizowanych przez siebie rozkładach i wzorcach zależności (Gan i in., 2017). To powód, by sprawdzić dopasowanie w konkretnej próbie, a nie twierdzenie, że każde zastosowanie jest nieprawidłowe.
Przydatne diagnostyki obejmują rozkład liczby transakcji kupna i sprzedaży, ich zależność, częstość okresów bez transakcji, implikowane przez model prawdopodobieństwa tych liczebności, zbieżność i trafienia w granice optymalizatora oraz wrażliwość na alternatywne wartości początkowe. Porównuj symulowane lub dopasowane rozkłady liczebności z danymi i sprawdzaj, czy parametry pozostają wiarygodne w sąsiednich oknach. Błędy standardowe lub przedziały ufności powinny odzwierciedlać używaną metodę estymacji; pojedyncza estymata punktowa ukrywa niepewność próbkowania i wyboru modelu.
Stabilna estymata w sąsiednich oknach nie dowodzi, że model jest poprawnie określony. Z kolei jej zmiana może wynikać ze zmienionego napływu informacji, popytu niepoinformowanych uczestników, zakresu danych lub błędnej specyfikacji. Przed nadaniem wynikom interpretacji rynkowej opisz dowody i ograniczenia.
Użyteczny raport PIN opisuje okres i dopasowanie tak, aby wynik dało się odtworzyć
Wartość PIN trudno interpretować bez informacji o sposobie pomiaru. Podaj instrument lub uniwersum, zakres platform, daty próby, okres obserwacji i strefę czasową, warunki dopuszczenia transakcji oraz procedurę przypisywania kierunku kupującego lub sprzedającego. Określ, czy używasz klasycznego modelu trzech stanów, czy jego rozszerzenia, i podaj oszacowane α, δ, μ oraz ε obok PIN.
Opisz także okno estymacji, implementację funkcji wiarygodności, metodę optymalizacji i strategię wartości początkowych. Raportuj zbieżność, rozwiązania brzegowe, miary niepewności i diagnostyki dopasowania. Jeżeli aukcje, korekty, okresy bez transakcji lub transakcje o nieznanym kierunku były wyłączane albo traktowane szczególnie, wyjaśnij w jaki sposób. Te informacje pozwalają odróżnić stabilny wzorzec od wyniku zależnego od jednej decyzji dotyczącej danych lub optymalizatora.
Okres obserwacji ma znaczenie, ponieważ α jest prawdopodobieństwem zdarzenia na okres, a μ i ε są intensywnościami napływu na okres. Przejście z liczebności dziennych na godzinowe zmienia jednostki i bazowy proces zdarzeń. Parametrów uzyskanych dla różnej długości okresu nie można bezpośrednio porównywać tylko dlatego, że wzór PIN ma taki sam kształt. Przed porównaniem aktywów lub dat uzgodnij definicje okresu i konstrukcję transakcji, a zmiany oszacowanych intensywności traktuj jako materiał do analizy, nie automatycznie jako zmianę handlu opartego na informacji.
Estymata PIN nie jest samodzielnym sygnałem transakcyjnym
PIN powstał jako miara mikrostruktury rynku, a nie reguła otwierania lub zamykania pozycji. Nie mówi, w którą stronę pójdzie cena, jak duży będzie ruch, czy pozorny sygnał został już uwzględniony w kwotowaniu ani czy transakcja może zostać wykonana po widocznej cenie. Pierwotne badanie wyceny aktywów analizowało szacowany PIN w historycznym przekroju NYSE i jego związek z oczekiwanymi stopami zwrotu w tamtej próbie. Wynik ten nie jest bieżącą prognozą ani uniwersalną premią (Easley, Hvidkjaer i O’Hara, 2002).
Jeśli PIN jest zmienną objaśniającą, podaj sposób oznaczania transakcji, okres i okno estymacji, dopasowane parametry, niepewność, kontrole dopasowania modelu oraz analizy wrażliwości. Jeżeli wykorzystujesz go w strategii, przetestuj całą regułę na danych, które nie służyły do jej wyboru, uwzględnij spread, prowizje, poślizg, wpływ na rynek i pojemność strategii, a następnie porównaj wynik z punktem odniesienia. Implementation shortfall to jeden ze sposobów porównania ceny decyzyjnej z rzeczywistymi kosztami realizacji. Estymata interesująca statystycznie nadal może nie mieć użytecznej wartości prognostycznej ani wartości po kosztach.
Częste pytania
Q1Czy PIN to prawdopodobieństwo, że następna transakcja będzie oparta na informacji?
Nie. Klasyczny wzór PIN to iloraz oczekiwanej liczby napływających zleceń poinformowanych, implikowanej przez model, do całkowitej oczekiwanej liczby zleceń w próbie. Nie przypisuje obiektywnego prawdopodobieństwa każdej zaobserwowanej ani przyszłej transakcji.
Q2Czy wyższy PIN oznacza, że akcja osiągnie lepszy wynik?
Nie. PIN szacuje przepływ zleceń powiązany z informacją w ramach określonego modelu. Zależności ze stopami zwrotu opisane dla historycznej próby nie tworzą samodzielnej prognozy ani nie dowodzą, że strategia po uwzględnieniu kosztów przyniesie zyski.
Q3Czym PIN różni się od VPIN?
Klasyczny PIN dopasowuje parametryczny model mieszaninowy do liczby napływających zleceń kupna i sprzedaży w okresach czasowych. VPIN wykorzystuje koszyki wolumenu i nierównowagę obliczaną według zegara wolumenu. Miary różnią się założeniami, danymi wejściowymi i interpretacją, a twierdzenia o skuteczności prognostycznej VPIN były kwestionowane.
Q4Dlaczego dwie estymaty PIN dla tego samego instrumentu mogą się różnić?
Mogą wynikać z innych reguł określania stron transakcji, zakresu platform, długości okresu, okna próby, wariantu modelu, wartości początkowych lub metod optymalizacji. Na dopasowanie wpływają też rozwiązania brzegowe i błędy danych. Estymaty należy porównywać po uzgodnieniu i udokumentowaniu tych wyborów.
Źródła i dalsza lektura
Zgłoś problem
Przygotujemy e-mail z linkiem do tego artykułu. Mark otrzyma zgłoszenie dopiero po jego wysłaniu
Szybki test
Przeczytano? Sprawdź się w 3 pytaniach
Pytanie 01
Co oznacza ε w symetrycznym klasycznym modelu PIN?
Wybierz odpowiedź, aby zobaczyć wyjaśnienie
Słownik opcji
Jasne definicje najważniejszych pojęć, od call, put i łańcucha opcji po IV, greki, open interest i max pain
Przeglądaj słownik opcji