

Proiezioni locali: stimare le risposte all’impulso
Scopri come le proiezioni locali stimano le risposte all’impulso a ogni orizzonte, come leggere gli intervalli di confidenza e perché identificazione e scelte di modello restano importanti.
In questa guidaUna risposta all’impulso descrive cosa accade dopo uno shock
Breve sintesi
Una proiezione locale (LP) stima la risposta a ogni orizzonte futuro con una regressione distinta. I coefficienti così ottenuti formano un percorso di risposta all’impulso, ma la regressione da sola non dimostra che uno shock sia causale. Identificazione, variabili di controllo e calcolo dell’incertezza continuano a determinare il significato di quel percorso.
Una risposta all’impulso descrive cosa accade dopo uno shock
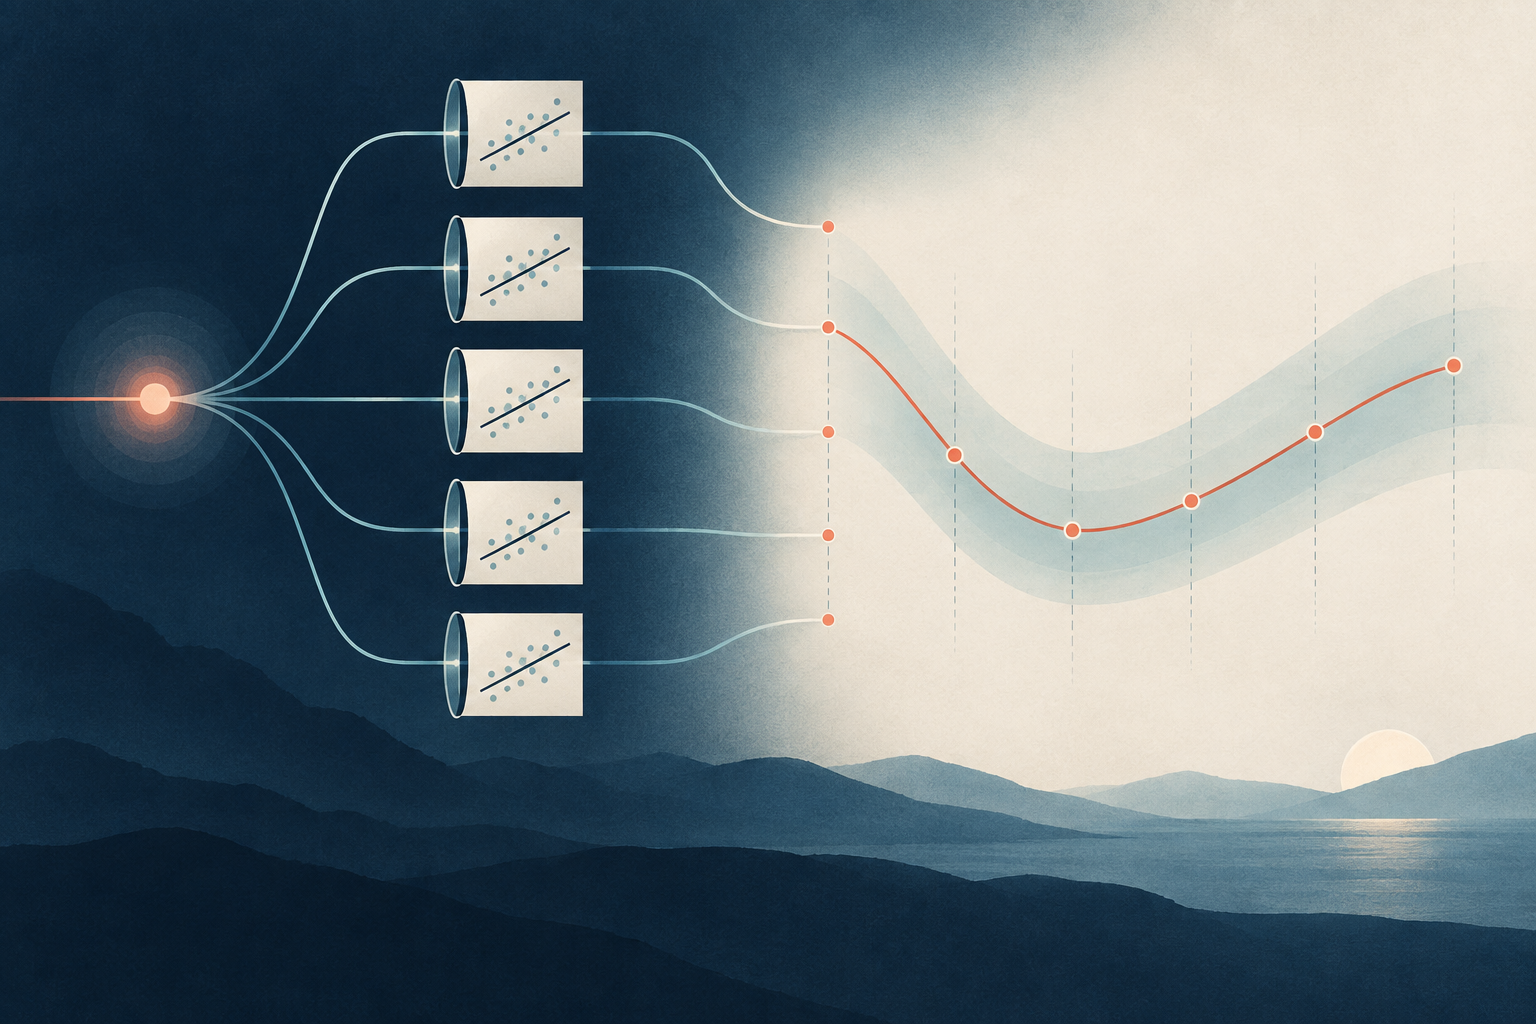
Una funzione di risposta all’impulso (IRF) descrive come evolve un risultato dopo una variazione o uno shock definito. Si può chiedere, per esempio, come reagisce la produzione a un aumento inatteso dei tassi d’interesse, come risponde un titolo a un annuncio datato oppure come reagisce un portafoglio a uno shock di rischio identificato. Il percorso ai vari orizzonti mostra quando compare un effetto, quando raggiunge il massimo e quanto a lungo persiste.
La parola “shock” va definita. Una variazione osservata del tasso ufficiale, di un prezzo di mercato o di un segnale di trading non è automaticamente uno shock strutturale inatteso. Può riflettere in parte informazioni sul risultato stesso. Senza una strategia di identificazione credibile, un coefficiente LP è un’associazione condizionata o una proiezione lineare, non una risposta causale.
Ogni orizzonte ha la propria regressione
Sia \(y_t\) il risultato e \(s_t\) la misura dello shock. Una specificazione LP comune per l’orizzonte \(h\) è
\[ y_{t+h} = \alpha_h + \beta_h s_t + \sum_{j=1}^{p}\Gamma_{h,j}'W_{t-j} + \varepsilon_{t,h}. \]
Qui \(h\) indica il numero di periodi trascorsi dallo shock, \(W_{t-j}\) contiene le variabili di controllo ritardate selezionate e \(\beta_h\) è il coefficiente di interesse. Si stima una regressione diversa per \(h=0,1,2,\ldots\). Rappresentando le stime \(\hat\beta_h\) in funzione di \(h\) si ottiene il percorso di risposta. Con uno shock strutturale e un’identificazione adeguata, quel percorso può stimare una IRF strutturale; altrimenti descrive una proiezione predittiva condizionata.
Questa stima diretta è l’idea centrale del metodo originale di Jordà: stimare una regressione per ogni periodo di interesse invece di estrapolare ripetutamente orizzonti sempre più lontani a partire da un unico sistema dinamico stimato. Le stime separate possono essere flessibili, ma non condividono automaticamente la dinamica regolare imposta da un unico sistema.
Ogni osservazione collega il momento dello shock \(t\) al momento del risultato \(t+h\). Se \(h=0\), si osserva il risultato nel periodo dello shock; se \(h=6\), lo si osserva sei periodi dopo. La data dello shock resta fissa e cambia soltanto il momento in cui si osserva il risultato. Perciò, all’aumentare di \(h\), si perdono righe alla fine del campione. Per interpretare insieme il percorso di risposta, le regressioni dovrebbero usare la stessa definizione dello shock e controlli confrontabili.
Definisci risultato, shock e unità prima della stima
Il coefficiente \(\beta_h\) è interpretabile solo dopo aver specificato le variabili e la loro scala. Se \(s_t=1\) rappresenta un aumento inatteso di 25 punti base del tasso ufficiale, \(\beta_h\) è la risposta stimata a uno shock di tale entità. Se \(s_t\) è misurato in punti percentuali, il coefficiente indica invece la risposta per punto percentuale. Una diversa scala dello shock riscalà tutti i coefficienti.
Anche la variabile dipendente determina se il percorso è cumulativo o si riferisce a ogni singolo periodo. Per esempio, se \(Y_t\) è un indice positivo della produzione, definiamo
\[ r_{t,h} = 100\,[\log(Y_{t+h})-\log(Y_{t-1})]. \]
Allora \(r_{t,h}\) è la variazione percentuale approssimata dell’indice dal livello precedente allo shock fino all’orizzonte \(h\). Un’altra variabile di risultato, come la variazione mensile della produzione, risponde a un’altra domanda. Non descrivere la risposta cumulativa del livello come la variazione che si verifica soltanto nel mese \(h\).
Per variazioni piccole, cento volte una differenza logaritmica si può leggere come una variazione percentuale approssimata. Se la variabile dipendente è la differenza logaritmica cumulativa dell’indice di produzione, \(\beta_h\) misura la differenza di livello stimata rispetto al valore immediatamente precedente allo shock fino all’orizzonte \(h\). Se invece si usa come variabile dipendente la crescita mensile, si stima la risposta del tasso di crescita in ciascun periodo. Un titolo o un grafico che riporti solo “risposta della produzione” può lasciare ambiguo se si intende il livello, la variazione cumulativa o quella del singolo periodo.
Un esempio ipotetico di shock sui tassi mostra come leggere il percorso
Supponiamo che uno studio mensile definisca \(s_t=1\) come un aumento inatteso dei tassi di 25 punti base e utilizzi la misura cumulativa della produzione appena descritta. I numeri seguenti sono valori ipotetici a scopo didattico, non stime ottenute da dati reali. Gli intervalli usano 1,96 volte ciascun errore standard riportato solo per illustrare il calcolo puntuale.
| Orizzonte | Risposta stimata | Errore standard | Intervallo di confidenza puntuale al 95% |
|---|---|---|---|
| 0 mesi | 0,00% | 0,050 | [−0,10%, 0,10%] |
| 1 mese | −0,10% | 0,061 | [−0,22%, 0,02%] |
| 3 mesi | −0,35% | 0,117 | [−0,58%, −0,12%] |
| 6 mesi | −0,60% | 0,163 | [−0,92%, −0,28%] |
| 12 mesi | −0,25% | 0,230 | [−0,70%, 0,20%] |
In questo esempio, la stima a sei mesi è inferiore dello 0,60% al livello precedente allo shock e il suo intervallo puntuale esclude lo zero. La stima a dodici mesi è meno negativa, ma il relativo intervallo include lo zero. Questo, da solo, non dimostra che ci sia stata una ripresa tra il sesto e il dodicesimo mese: le stime sono incerte e correlate tra gli orizzonti, e la sovrapposizione degli intervalli non verifica la differenza tra due orizzonti. Un’affermazione sul percorso richiede un contrasto adeguato o un’inferenza congiunta. Nessuno di questi numeri è una previsione di politica monetaria o un risultato riferito a un’economia reale.
Il valore a sei mesi non significa che la produzione sia diminuita dello 0,60% soltanto durante il sesto mese. In base alla variabile dipendente cumulativa definita, rappresenta la differenza stimata del livello dell’indice di produzione rispetto al riferimento precedente allo shock. Il fatto che l’intervallo a dodici mesi includa lo zero non conferma neppure che l’effetto sia scomparso in quel momento. Significa che il calcolo puntuale, con gli errori standard scelti, non permette di escludere lo zero. Gli intervalli di confidenza indicano la precisione della stima, ma non eliminano i limiti del campione o dell’identificazione.
Identificazione e controlli determinano il significato del coefficiente
LP è un metodo di stima e non fornisce da sé la variazione che identifica l’effetto. Il ricercatore può definire uno shock a partire da un modello strutturale, una misura di sorpresa ad alta frequenza, uno strumento esterno valido o un disegno di ricerca sostenuto da ipotesi difendibili. Ogni approccio richiede elementi che separino lo shock dalle altre notizie e dai feedback del risultato.
I controlli devono rispettare la sequenza temporale della domanda. Le variabili ritardate e precedenti allo shock possono tenere conto delle condizioni passate. Una variabile misurata dopo lo shock potrebbe reagire essa stessa allo shock. Controllare un simile mediatore può rimuovere una parte della risposta totale o introdurre un nuovo bias. Annota quali informazioni erano disponibili immediatamente prima dello shock e spiega perché ogni controllo entra nella regressione.
Un \(\hat\beta_h\) statisticamente significativo non trasforma un evento apparentemente inatteso in uno shock esogeno. Verifica l’anticipazione, gli annunci simultanei, gli errori di misurazione, i cambiamenti delle regole di politica e la selezione del campione. In finanza, notizie sovrapposte o shock comuni possono far muovere insieme i risultati anche quando l’evento studiato non ne è la causa.
Se si usa uno strumento esterno, occorre spiegare perché è correlato con lo shock d’interesse e perché non influenza il risultato attraverso un altro percorso. Con una misura di sorpresa ad alta frequenza, verifica quali notizie rientrano nella finestra dell’annuncio e quanto rapidamente i prezzi incorporano le informazioni. Definisci prima la logica d’identificazione e poi scegli la LP per stimare la risposta a quello shock. Un buon adattamento della regressione o un p-value basso non dimostrano che le ipotesi d’identificazione siano valide.
LP e VAR hanno lo stesso obiettivo di popolazione in condizioni comuni
Le proiezioni locali e i modelli vettoriali autoregressivi (VAR) sono spesso presentati come metodi concorrenti per stimare le IRF. Plagborg-Møller e Wolf mostrano che, con informazioni e identificazione corrispondenti, una normalizzazione compatibile dello shock e strutture dei ritardi non vincolate, i due approcci possono stimare la stessa risposta di popolazione. Il risultato riguarda un estimando comune; non implica che le stime su campioni finiti debbano coincidere o che ogni LP e VAR stimato imponga le stesse restrizioni.
Con un numero fisso \(p\) di ritardi, gli estimandi di risposta possono coincidere approssimativamente fino agli orizzonti \(h\leq p\), mentre a orizzonti più lontani possono emergere differenze. Su campioni finiti, le LP stimano direttamente ciascun orizzonte e possono essere più variabili, mentre un VAR utilizza un modello dinamico congiunto che può produrre un percorso più regolare. Questa struttura può essere utile se è adeguata e fuorviante se i suoi vincoli non si adattano ai dati. Nessuno dei due metodi è sempre superiore per definizione.
Evita quindi di memorizzare come regola fissa che LP sia più robusta e VAR più efficiente: verifica quali vincoli dinamici vengono usati. Anche se specificazioni flessibili e compatibili hanno lo stesso obiettivo di popolazione, differenze nel numero di ritardi o nell’insieme informativo del campione possono cambiare il percorso stimato e la sua precisione. Anche la normalizzazione dello shock deve coincidere per confrontare direttamente l’ampiezza dei coefficienti. Registra insieme unità dello shock, variabili incluse, numero di ritardi, campione e vincoli d’identificazione.
Gli intervalli di confidenza dipendono dall’orizzonte e dal metodo d’inferenza
Per ogni \(h\), la regressione produce una stima e una misura d’incertezza. All’aumentare di \(h\), le osservazioni disponibili possono diminuire perché \(y_{t+h}\) non è osservabile vicino alla fine del campione. Inoltre, gli esiti a più periodi si sovrappongono, quindi residui e stime tra orizzonti possono essere dipendenti. L’errore standard o il bootstrap scelto deve essere coerente con il disegno e con l’obiettivo inferenziale.
Un intervallo puntuale al 95% si costruisce per un orizzonte alla volta. Non garantisce una copertura al 95% dell’intera curva di risposta. Una banda di confidenza simultanea è un oggetto distinto e va indicata quando l’affermazione riguarda tutto il percorso. Montiel Olea e Plagborg-Møller dimostrano risultati utili per specifiche LP con ritardi aggiuntivi, in base alle loro ipotesi; tali risultati non autorizzano a omettere le verifiche diagnostiche o ad applicare una ricetta per gli errori standard a qualunque regressione. Nel loro scenario con radice unitaria, i risultati enunciati non coprono orizzonti che crescono in proporzione alla dimensione del campione. Specifica i controlli, l’intervallo di orizzonti, il metodo di covarianza o bootstrap e se gli intervalli sono puntuali o simultanei.
Gli esiti a più periodi si sovrappongono e possono produrre autocorrelazione nei residui. Ciò non significa che ogni LP si possa correggere usando la stessa lunghezza di ritardo HAC. I risultati inferenziali sulle LP con ritardi aggiuntivi riguardano specifiche regressioni che includono valori ritardati delle variabili del sistema e rispettano determinate condizioni. In un’applicazione, spiega perché l’errore standard scelto è adatto allo stimatore, alla persistenza della serie, alla lunghezza del campione e all’orizzonte d’interesse. Intervalli più ampi agli orizzonti lunghi possono riflettere la riduzione delle osservazioni e delle informazioni disponibili, non un errore di calcolo.
Risposte flessibili aggiungono domande e scelte di stima
I ricercatori possono interagire lo shock con uno stato osservato, come un indicatore di recessione, per chiedersi se le risposte differiscano tra regimi. Possono anche studiare più risultati, dimensioni dello shock o sottocampioni. Ogni estensione modifica l’estimando e utilizza diversamente le osservazioni disponibili; dividere il campione può lasciare un’incertezza ampia, soprattutto a orizzonti lunghi.
Quando possibile, definisci in anticipo quali orizzonti e stati sono importanti. Se provi molti risultati, ritardi, campioni o definizioni dello shock, descrivi la ricerca anziché presentare il percorso selezionato come se fosse l’unica analisi. La smussatura tra orizzonti può rendere il grafico più leggibile, ma aggiunge vincoli o scelte di regolazione. Mostra le stime non smussate e documenta il metodo se riporti anche una curva smussata.
Riporta dettagli sufficienti per replicare il percorso di risposta
Indica risultato, frequenza, trasformazione, definizione e unità dello shock, intervallo di orizzonti, date del campione, controlli e trattamento delle osservazioni mancanti. Spiega le ipotesi d’identificazione separatamente dalla formula di regressione. Riporta coefficiente e incertezza per ciascun orizzonte oppure mostra un grafico con unità e definizioni degli intervalli leggibili.
Specifica il metodo di stima e d’inferenza, compresi numero di ritardi, stimatore di covarianza o bootstrap e natura puntuale o simultanea degli intervalli. Mostra la sensibilità rilevante a una misura alternativa difendibile dello shock, alla scelta dei ritardi o alla finestra campionaria. Una IRF è una sintesi basata su un modello di uno specifico shock identificato e di un risultato; non è un segnale di trading né una garanzia di rendimenti futuri.
L’articolo originale di Jordà sulle proiezioni locali introduce la stima orizzonte per orizzonte. Il risultato di equivalenza tra LP e VAR di Plagborg-Møller e Wolf chiarisce l’obiettivo comune di popolazione e la distinzione con un numero finito di ritardi. L’analisi inferenziale di Montiel Olea e Plagborg-Møller studia gli intervalli di confidenza delle LP con ritardi aggiuntivi in condizioni specifiche. Guide correlate trattano gli studi di evento finanziari, gli errori standard robusti e HAC e i disegni difference-in-differences con tempo relativo all’evento.
Domande frequenti
Q1Una proiezione locale è automaticamente causale?
No. Stima relazioni specifiche per orizzonte. Una IRF causale richiede una strategia difendibile per identificare lo shock e le relative ipotesi.
Q2Le proiezioni locali superano sempre i VAR?
No. In condizioni comuni possono mirare alla stessa risposta, ma il comportamento su campioni finiti dipende da ritardi, vincoli, dimensione del campione e dati. Nessuno dei due metodi prevale in ogni applicazione.
Q3Gli intervalli di confidenza puntuali bastano per un grafico di risposta all’impulso?
Bastano soltanto per affermazioni su ciascun orizzonte separatamente. Se l’affermazione riguarda l’intera curva, usa e riporta una banda simultanea adeguata.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
Che cosa caratterizza una proiezione locale?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
Variation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
Leggi la guida completaDifference-in-differencesA quasi-experimental method subtracting the comparison group's contemporaneous change from the treated group's change to construct an untreated counterfactual.
Leggi la guida completa