

Regressione Fama–MacBeth: spiegazione dei premi per il rischio in due passaggi
Segui la procedura Fama–MacBeth in due passaggi, dalle stime beta di serie storica ai prezzi del rischio trasversali per data, distinguendo poi errore standard, correzione di Shanken e inferenza HAC.
In questa guidaStima il prezzo dell’esposizione, non un beta di serie storica
Breve sintesi
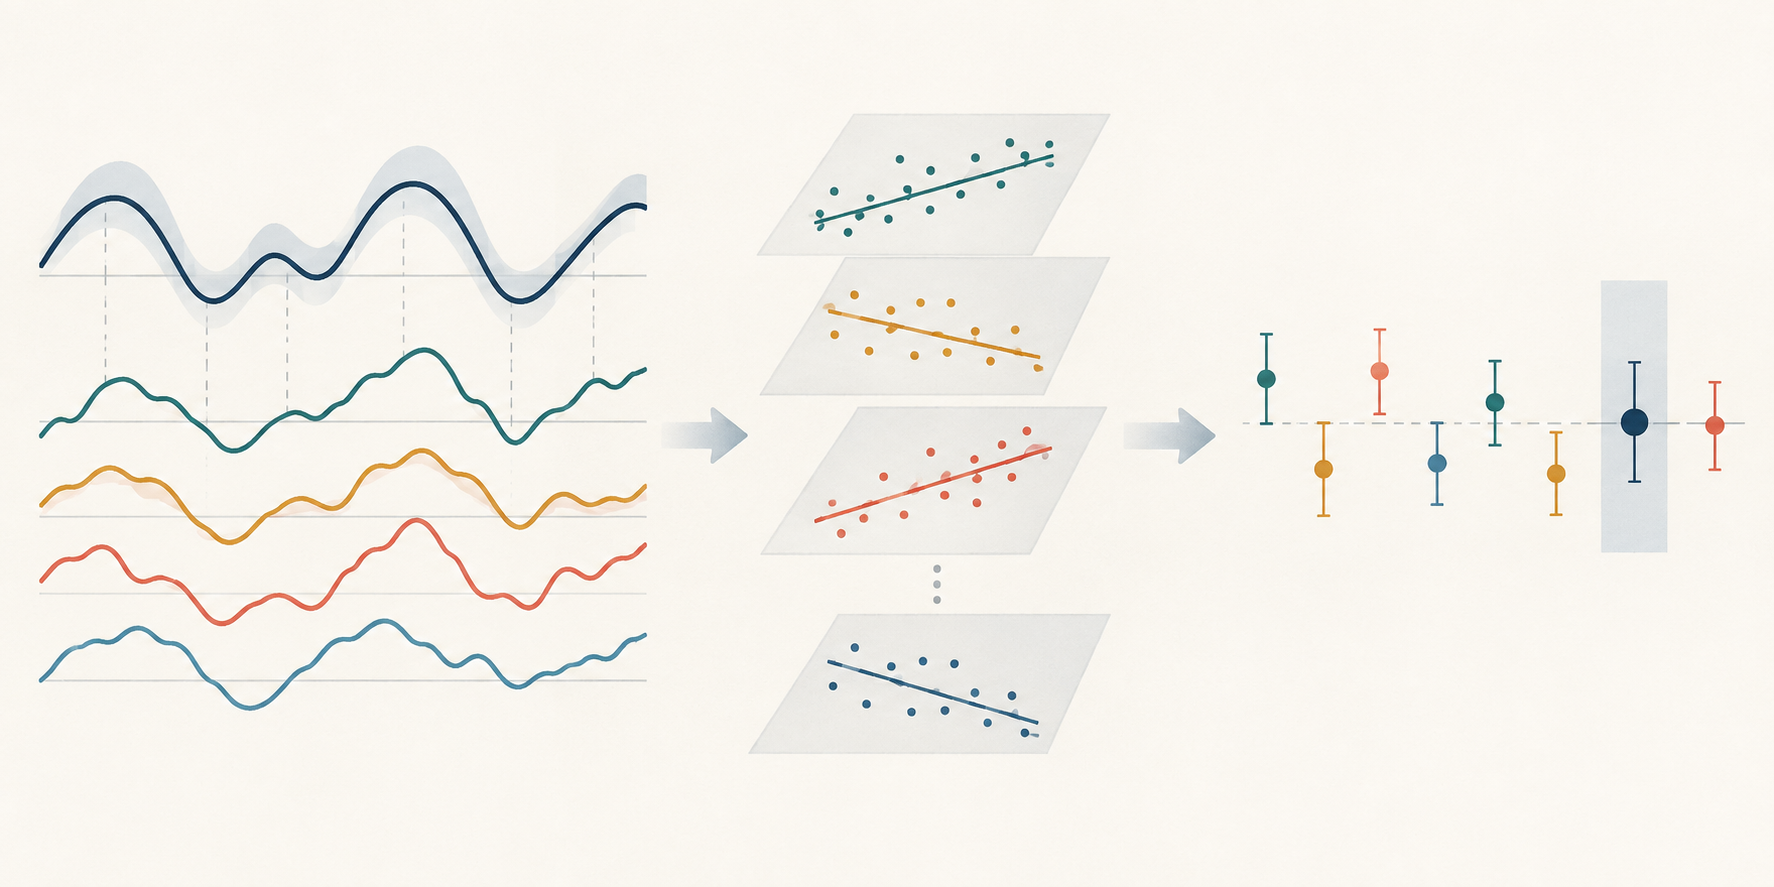
La procedura Fama–MacBeth stima l’esposizione ai fattori di ciascun asset testato dalla sua serie storica, regredisce a ogni data i rendimenti trasversali sugli asset rispetto a tali esposizioni stimate, quindi calcola nel tempo la media delle pendenze dei prezzi del rischio. La serie temporale delle pendenze fornisce la base per il consueto calcolo dell’incertezza. L’errore standard del secondo passaggio non tiene automaticamente conto dei beta stimati, della dipendenza seriale o di un modello di pricing specificato male; inoltre, un prezzo del rischio medio significativo non è una stima dei profitti di trading.
Stima il prezzo dell’esposizione, non un beta di serie storica
Un beta fattoriale e il prezzo del rischio di un fattore rispondono a domande diverse. Il beta descrive come il rendimento di un asset si è mosso insieme a un fattore nella regressione di serie storica del primo passaggio. Un coefficiente di prezzo del rischio, spesso indicato con \(\lambda\), descrive come i rendimenti differiscono tra asset con beta stimati diversi nella sezione trasversale del secondo passaggio. La procedura Fama–MacBeth calcola una stima del prezzo del rischio per ogni data e poi ne riassume i valori nel tempo.
Questo disegno è utile quando la domanda di ricerca riguarda l’associazione tra l’esposizione a un fattore di rischio proposto e i rendimenti medi di un insieme scelto di titoli o portafogli. È una procedura statistica di asset pricing, non un disegno causale. Da sola, inoltre, non specifica un portafoglio negoziabile usando le informazioni disponibili al momento.
Lo studio originale di Fama e MacBeth applicava regressioni trasversali ripetute tra rischio e rendimento ai titoli quotati al NYSE. I lavori successivi, compresi i test empirici di Fama e French, hanno reso le pendenze trasversali mensili un metodo familiare per stimare e testare i prezzi medi del rischio. La procedura si comprende meglio come due problemi di stima collegati, ciascuno con ipotesi proprie.
Primo passaggio: stima l’esposizione di ciascun asset testato
Per ogni asset o portafoglio di test \(i\), stima una regressione di serie storica come:
\[ r^{e}_{i,t} = \alpha_i + \boldsymbol{\beta}_i^\top \mathbf{f}_t + \varepsilon_{i,t}, \] dove \(r^{e}_{i,t}\) è il rendimento in eccesso dell’asset, \(\mathbf{f}_t\) è il vettore dei rendimenti dei fattori alla data \(t\) e \(\boldsymbol{\beta}_i\) è il vettore delle esposizioni. Il valore stimato \(\hat{\boldsymbol{\beta}}_i\) diventa una variabile esplicativa nel secondo passaggio. Un modello con il solo fattore di mercato ha un beta; un modello multifattoriale ha un loading stimato per ciascun fattore.
Il primo passaggio richiede una variazione temporale sufficiente dei fattori per stimare le pendenze. Una finestra lunga può fornire più osservazioni, ma mescolare regimi di mercato diversi. Una finestra breve può rappresentare l’esposizione recente, ma rendere rumorose le stime dei beta. È opportuno indicare frequenza dei rendimenti, date del campione, costruzione dei fattori, regole per i dati mancanti, trattamento dell’intercetta e finestra di stima.
Non è un’istruzione universale stimare ogni beta sull’intero campione. In un test ex post di asset pricing, le stime ottenute sull’intero campione possono descrivere il campione analizzato. In una simulazione storica di trading, invece, usare osservazioni future per stimare il beta introdurrebbe informazione futura nel passato. La simulazione richiede piuttosto una stima point-in-time costruita con dati disponibili prima di ogni decisione simulata.
Secondo passaggio: valuta le esposizioni nella sezione trasversale di ogni data
A ogni data \(t\), regredisci i rendimenti degli asset di test di quella data sui beta del primo passaggio:
\[ r^{e}_{i,t} = \lambda_{0,t} + \hat{\boldsymbol{\beta}}_i^\top \boldsymbol{\lambda}_t + \eta_{i,t}. \] Qui \(\boldsymbol{\lambda}_t\) contiene i prezzi del rischio specifici della data. Con un solo fattore, la pendenza trasversale \(\lambda_t\) misura la differenza di rendimento associata a un’unità di beta stimato nella sezione trasversale di quella data. L’intercetta \(\lambda_{0,t}\) è una distinta intercetta trasversale. Stabilire se stimarla liberamente, vincolarla o interpretarla come rendimento a beta zero dipende dal modello testato e dall’uso di rendimenti grezzi o in eccesso.
La seconda regressione è trasversale tra asset a una data; non è un’altra regressione di serie storica. Il suo adattamento dipende dal numero e dalla composizione degli asset di test, dalla dispersione dei beta stimati e dalla correlazione tra questi beta. Se i beta differiscono appena tra gli asset, la sezione trasversale offre poche informazioni per distinguere un prezzo del rischio dall’altro. Aggiungere molti asset quasi identici non crea variazioni di esposizione che non esistono.
Ripetendo la regressione si ottiene la serie \(\hat{\boldsymbol{\lambda}}_1,\ldots,\hat{\boldsymbol{\lambda}}_T\). La stima Fama–MacBeth per il fattore \(k\) è la media temporale:
\[ \bar{\lambda}_k = \frac{1}{T}\sum_{t=1}^{T}\hat{\lambda}_{k,t}. \] La media usa la stessa unità e frequenza dei rendimenti del secondo passaggio. Ponderare le sezioni trasversali, avere date mancanti o modificare l’universo degli asset cambia il significato di questa media e va dichiarato.
Un esempio distingue un mese dalla media nel tempo
Supponiamo che tre portafogli di test abbiano stime del beta di mercato del primo passaggio pari a (0.5), (1.0) e (1.5). In un mese ipotetico, i rispettivi rendimenti in eccesso sono (0.3\%), (0.8\%) e (1.3\%). I tre punti si trovano sulla retta:
\[ r^{e}_{i,t} = -0.2\% + 1.0\%\times\hat{\beta}_{i}. \] Per quel mese, la pendenza stimata è di 1.0 punto percentuale per unità di beta e l’intercetta è (-0.2\%). Questo adattamento esatto è intenzionalmente piccolo e illustrativo: non dimostra che il beta di mercato sia prezzato, e tre punti non bastano per un test empirico utile.
Immaginiamo ora che la pendenza del secondo passaggio sia stimata separatamente in sei mesi e sia, per unità di beta, pari a (0.8\%), (-0.4\%), (1.0\%), (-0.2\%), (0.6\%) e (0.0\%). La loro media aritmetica è:
\[ (0.8 - 0.4 + 1.0 - 0.2 + 0.6 + 0.0)/6 = 0.3\%\text{ al mese}. \] La pendenza del primo mese non è la stima finale di Fama–MacBeth: la stima è la media delle sei pendenze specifiche per data. I mesi negativi restano nel calcolo; selezionare soltanto quelli positivi cambierebbe l’estimando e introdurrebbe un ulteriore passaggio di selezione. Questi numeri inventati illustrano solo l’aritmetica, non un risultato di mercato né l’affermazione che un fattore preveda i rendimenti.
L’errore standard usuale usa il tempo come dimensione inferenziale
Nel calcolo più semplice, si prende la deviazione standard campionaria \(s_\lambda\) delle \(T\) stime mensili della pendenza e la si divide per \(\sqrt{T}\):
\[ \operatorname{SE}(\bar{\lambda}) = \frac{s_\lambda}{\sqrt{T}}. \] La statistica t corrispondente è la pendenza media stimata divisa per questo errore standard. Il calcolo considera il tempo come dimensione ripetuta per stimare l’incertezza del prezzo medio del rischio. Il numero di asset \(N\) determina quanto bene ciascuna sezione trasversale mensile può stimare la pendenza; non sostituisce \(T\) nell’errore standard della media temporale.
Per le sei pendenze illustrative sopra, la deviazione standard campionaria è circa 0.576 punti percentuali al mese. Dividendo per \(\sqrt{6}\) si ottiene un errore standard convenzionale di circa 0.235 punti percentuali; (0.3/0.235) vale circa 1.28. Sei osservazioni sono troppo poche per una valutazione affidabile della significatività. Il calcolo mostra soltanto perché una media positiva e una media stimata con precisione non sono la stessa affermazione.
L’errore standard usuale dipende inoltre dalle condizioni della serie temporale delle pendenze. Se le stime \(\hat{\lambda}_{k,t}\) sono dipendenti nel tempo, l’errore standard che presuppone osservazioni indipendenti può rappresentare male l’incertezza. Con un campione breve o una composizione degli asset variabile, le statistiche t asintotiche possono essere particolarmente fragili. Riporta lunghezza e frequenza della serie \(\lambda_t\), non soltanto il numero di asset nella sezione trasversale.
Fama–MacBeth e OLS pooled non danno sempre stime puntuali diverse
È comune contrapporre Fama–MacBeth e regressione panel pooled come se dovessero necessariamente produrre pendenze diverse. Esiste un caso speciale importante. Se gli stessi asset sono presenti a ogni data, i regressori beta restano fissi nel tempo e ogni sezione trasversale mensile utilizza lo stesso disegno dei minimi quadrati ordinari, la media dei coefficienti OLS per data coincide con il coefficiente di pendenza comune dell’OLS pooled. Entrambi riassumono lo stesso insieme bilanciato di regressioni trasversali.
L’uguaglianza può venir meno se l’insieme di asset o i pesi cambiano nel tempo, i beta variano, il panel è sbilanciato, le regressioni includono controlli diversi o il modello pooled impone altri vincoli. In questi casi i metodi possono ponderare date o osservazioni in modo diverso e rispondere a domande diverse sul campione. Non scegliere un metodo solo in base al nome: specifica la matrice del disegno, lo schema di ponderazione e il coefficiente obiettivo.
Anche quando le stime puntuali coincidono, il calcolo dell’incertezza può differire. L’inferenza Fama–MacBeth usa la variazione temporale delle pendenze trasversali. Una regressione pooled richiede uno stimatore di covarianza adatto alla struttura degli errori panel. Errori standard clusterizzati per data o asset, una stima di covarianza a due vie o una stima HAC temporale si basano su ipotesi differenti; chiamare il modello pooled o Fama–MacBeth non rende automaticamente corretto nessuno di questi metodi.
Beta stimati e HAC affrontano incertezze distinte
Il secondo passaggio tratta \(\hat{\boldsymbol{\beta}}_i\) come se fosse noto, benché derivi da una regressione stimata nel primo passaggio. L’errore in un regressore generato può influenzare la stima del prezzo del rischio e la sua incertezza. L’analisi di Shanken ricava una correzione per l’inferenza sul pricing dei beta in una specifica configurazione di asset pricing; non è un moltiplicatore universale che corregge ogni disegno in due passaggi. Lavori successivi studiano il comportamento asintotico e stimatori alternativi sotto condizioni diverse. Indica la correzione o il metodo inferenziale usato e le ipotesi che ne giustificano l’applicazione.
L’autocorrelazione seriale di \(\hat{\lambda}_{k,t}\) è un problema distinto. Per esempio, rendimenti sovrapposti su più mesi possono fare sì che pendenze consecutive del secondo passaggio condividano alcune osservazioni. Uno stimatore di covarianza consistente in presenza di eteroschedasticità e autocorrelazione (HAC), come Newey–West, adegua la varianza stimata della media temporale alla dipendenza seriale fino a una finestra di ritardi scelta. Non reintroduce l’errore di stima dei beta del primo passaggio, non corregge l’errata specificazione dei fattori e non elimina il look-ahead bias. Al contrario, una correzione di Shanken non sostituisce il controllo della dipendenza nella serie lambda.
Jagannathan e Wang, così come Shanken e Zhou, analizzano le proprietà delle procedure di pricing dei beta sotto specifiche condizioni di modello e campionamento. I loro risultati invitano a descrivere il disegno effettivo in due passaggi, anziché ripetere l’affermazione generica che gli errori Fama–MacBeth ordinari siano sempre troppo piccoli o sempre validi. Riporta se i beta vengono stimati una volta o aggiornati, come viene gestita la dipendenza della serie lambda, se si applica una correzione per i beta generati e perché tale scelta corrisponde alla domanda.
Un prezzo medio del rischio significativo non è una stima dei profitti di trading
Un valore medio di \(\lambda\) positivo e statisticamente distinguibile indica che, dato l’universo di asset testati, la definizione del fattore, le stime dei beta e la procedura inferenziale scelti, nel campione gli asset con maggiore esposizione stimata hanno avuto rendimenti medi più alti. Non dimostra che un investitore avrebbe realizzato tale differenziale al netto dei costi, che il fattore causi il rendimento o che il modello di pricing sia corretto.
Il risultato può cambiare modificando i fattori inclusi, il periodo campionario, la costruzione dei portafogli, la finestra dei beta, gli asset di test o lo schema dei pesi. La ricerca tra molti fattori, sotto-periodi e specificazioni crea un problema di test multipli. Un test su un singolo prezzo del rischio stimato non riassume neppure gli errori congiunti di pricing di tutti gli asset. Specifica se il risultato è un’associazione condizionata, un test di pricing basato su un modello o una previsione fuori campione; non usare queste etichette come sinonimi.
Per una strategia reale o simulata, esposizioni e pesi del portafoglio devono essere costruiti solo con informazioni disponibili in quel momento. Servono inoltre prezzi d’ingresso effettivamente eseguibili, turnover, costi di negoziazione, finanziamento, capacità e una regola di ribilanciamento. Il beta fattoriale stima un’esposizione; il \(\lambda\) medio non è il rendimento di un portafoglio che incassa automaticamente quel premio beta. Per i concetti correlati, consulta le guide a loadings e modelli fattoriali, errori standard robusti e HAC e rank information coefficient.
Descrivi il disegno affinché altri possano replicarlo
Un risultato interpretabile identifica gli asset di test, i rendimenti dei fattori, la serie risk-free se utilizzata, le unità e frequenze dei rendimenti e il periodo campionario. Specifica anche come vengono stimati i beta, se la finestra del primo passaggio si sovrappone al periodo di test del secondo, quali asset entrano a ogni data, come sono gestiti i rendimenti mancanti e le variazioni di composizione, se le sezioni trasversali sono ponderate e se l’intercetta è inclusa o vincolata.
Per l’inferenza, riporta il numero totale \(T\) di pendenze per data, la loro media e dispersione temporale, lo stimatore dell’errore standard, la banda HAC, l’eventuale correzione per la stima dei beta e le scelte per campioni finiti. Mostra la dispersione dei beta e l’adattamento trasversale insieme alle statistiche t: un elevato numero di asset non compensa esposizioni quasi identiche. Confronta finestre, definizioni dei fattori e costruzioni degli asset di test ragionevoli senza selezionare la versione che casualmente produce il p-value più piccolo.
Il metodo originale e le sue applicazioni sono esempi, non una garanzia che ogni insieme di dati moderno rispetti le ipotesi. Il lavoro del 1973 di Fama e MacBeth, i test trasversali del 1992 di Fama e French, l’analisi di Shanken sul pricing dei beta, l’analisi asintotica di Jagannathan e Wang, il confronto di Shanken e Zhou tra stimatori del pricing dei beta e il metodo di covarianza HAC di Newey e West affrontano aspetti diversi del disegno. Leggi le ipotesi insieme al coefficiente riportato.
Domande frequenti
Q1Una regressione Fama–MacBeth è un test causale?
No. Stima l’associazione tra esposizioni stimate e rendimenti, dati il modello di pricing e il disegno degli asset di test scelti. Un’interpretazione causale richiede un argomento di identificazione distinto.
Q2Aggiungere più asset rende sempre più precisa la stima del prezzo del rischio?
No. Più asset possono migliorare la sezione trasversale di una data, ma la precisione dipende anche dalla dispersione dei beta, dall’accuratezza della loro stima e dal numero di date che contribuiscono alla media.
Q3Quando conviene usare un errore standard HAC?
Valutalo quando la serie dei prezzi del rischio per data può essere eteroschedastica o dipendente nel tempo, per esempio con rendimenti sovrapposti. Indica la finestra dei ritardi e ricorda che HAC non corregge l’errore di stima dei beta del primo passaggio.
Fonti e approfondimenti
Segnala un problema
Prepareremo un’e-mail con il link a questo articolo. Mark riceverà la segnalazione solo dopo l’invio
Controllo rapido
Hai finito la guida? Verifica ciò che hai capito con 3 domande
Domanda 01
Nella procedura standard in due passaggi, che cosa stima la pendenza del secondo passaggio alla data t?
Scegli una risposta per vedere la spiegazione
Glossario delle opzioni
A model decomposing asset returns into exposure to a small set of common factors and an asset-specific residual.
Leggi la guida completaHeteroskedasticityVariation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
Leggi la guida completaStochastic discount factorA random variable that weights future payoffs by time and state value to produce today's price; asset returns satisfy its pricing moment condition.
Leggi la guida completa