

बैकटेस्ट ओवरफिटिंग की संभावना (PBO) और CSCV की व्याख्या
जानें कि combinatorially symmetric cross-validation PBO का अनुमान कैसे लगाता है, OOS rank को logit में कैसे बदलता है और यह भविष्य के नुकसान का पूर्वानुमान क्यों नहीं है
इस गाइड मेंPBO किसी अकेली रणनीति के बजाय चयन प्रक्रिया मापता है
संक्षिप्त सारांश
Probability of backtest overfitting (PBO) पूछता है कि इन-सैंपल (IS) में सबसे अच्छा चुना गया रणनीति-उम्मीदवार आउट-ऑफ-सैंपल (OOS) में उम्मीदवार समूह के मध्यक से नीचे कितनी बार rank करता है। Combinatorially symmetric cross-validation (CSCV) बराबर समय-ब्लॉकों के आधे हिस्से को चयन और बाकी आधे को मूल्यांकन देकर यह अनुपात आँकता है। PBO किसी तय search, score और ऐतिहासिक performance matrix पर निर्भर diagnostic है; live strategy के नुकसान की संभावना नहीं।
PBO किसी अकेली रणनीति के बजाय चयन प्रक्रिया मापता है
शोध दल अलग-अलग lookback, entry threshold, holding period, universe, cost assumption और portfolio constraint आज़मा सकता है, फिर सबसे ऊँचा backtest score पाने वाले विकल्प को रख सकता है। चुने गए परिणाम को sample की खासियतों से मेल बैठाने के कई अवसर मिले। PBO उस search का एक नतीजा संक्षेप में देता है: तय IS/OOS विभाजनों में IS winner उसी candidate set के OOS median से नीचे कितनी बार आता है?
Bailey, Borwein, López de Prado और Zhu ने strategy-selection risk के लिए PBO framework दिया और अनुमान के एक तरीके के रूप में CSCV प्रस्तावित किया। परिभाषा tested configuration में से चुनने की प्रक्रिया से जुड़ी है, केवल किसी एक forecasting equation में बहुत सारे parameters होने से नहीं। हर split में IS वह subset है जिससे candidate चुना जाता है; यह जरूरी नहीं कि हर underlying model इसी अवधि में fit हुआ हो। औपचारिक विवरण PBO के मूल लेख में है।
पूरे sample पर किसी strategy का Sharpe ratio ऊँचा हो सकता है, फिर भी वह कमजोर research family का सबसे भाग्यशाली सदस्य हो सकती है। इसके उलट, selection process अक्सर OOS median से ऊपर candidate चुन सकता है जबकि पूरे group का return नकारात्मक हो। PBO दिए गए candidate set के भीतर relative rank की तुलना करता है; अकेले इससे positive expected return की जाँच नहीं होती।
PBO दूसरे validation tools से अलग प्रश्न का उत्तर देता है
Chronological holdout या walk-forward test देखता है कि पहले के फैसलों में इस्तेमाल न हुए बाद के observations पर तय research process कैसा रहा। Purged cross-validation training label interval और test outcome के overlap को संभालता है; embargo अलग से उचित ठहराया गया buffer जोड़ सकता है। इनमें से कोई भी कदम अकेले यह नहीं मापता कि बड़ी strategy search का winner OOS candidate median से कितनी बार नीचे जाता है। देखें purged cross-validation और embargo guide।
PBO multiple-testing correction भी नहीं है। White’s Reality Check bootstrap से जाँचता है कि data snooping को ध्यान में रखते हुए family का सबसे अच्छा rule benchmark से आगे निकलता है या नहीं। Deflated Sharpe Ratio selection effect और non-normal return को ध्यान में रखकर Sharpe-आधारित significance calculation समायोजित करता है। PBO अलग-अलग split में IS चुने candidate की OOS rank बताता है। इनके statistic और assumption अलग हैं, इसलिए ये एक-दूसरे की जगह अपने-आप नहीं लेते। देखें White का मूल Reality Check लेख और Bailey तथा López de Prado का Deflated Sharpe Ratio लेख।
पूरी और synchronized performance matrix से शुरू करें
M को T पंक्ति और N स्तंभ वाली matrix मानें। हर N स्तंभ एक candidate strategy या configuration है और हर T पंक्ति सभी candidates के लिए वही observation interval है। पंक्ति में संबंधित trading cost के बाद daily return हो सकता है। Trade frequency अलग हो तो पहले common time index तय करके performance को एकसमान तरीके से aggregate करें। एक strategy के daily return की तुलना दूसरी के monthly total से पंक्ति-दर-पंक्ति करना सार्थक matrix नहीं बनाता।
Candidate set असली चयन अवसर दर्शाए: grid search से हटे variant, परिणाम देखने के बाद किए गए manual change, दूसरे universe और अंतिम चुनाव को प्रभावित करने वाले rule। PBO सिर्फ दिए गए candidate और उनके performance history का आकलन कर सकता है। बड़े search के बाद केवल finalists दर्ज किए हों, तो estimate वास्तविक search को कम आँकेगा।
सभी के लिए return convention, currency, leverage treatment और performance criterion एक जैसा रखें। Net Sharpe पर चयन हो तो हर स्तंभ में relevant fee, spread, financing, funding, borrow cost और execution assumption जोड़कर फिर गणना करें। आगे के हर subset में भी metric निकाला जा सकना चाहिए। मूल लेख synchronized row और हर subsample में metric estimate होने की माँग करता है; अलग trade frequency पर series को common index से मिलाने की सलाह देता है।
CSCV हर आधे sample को उसके complement से जोड़ता है
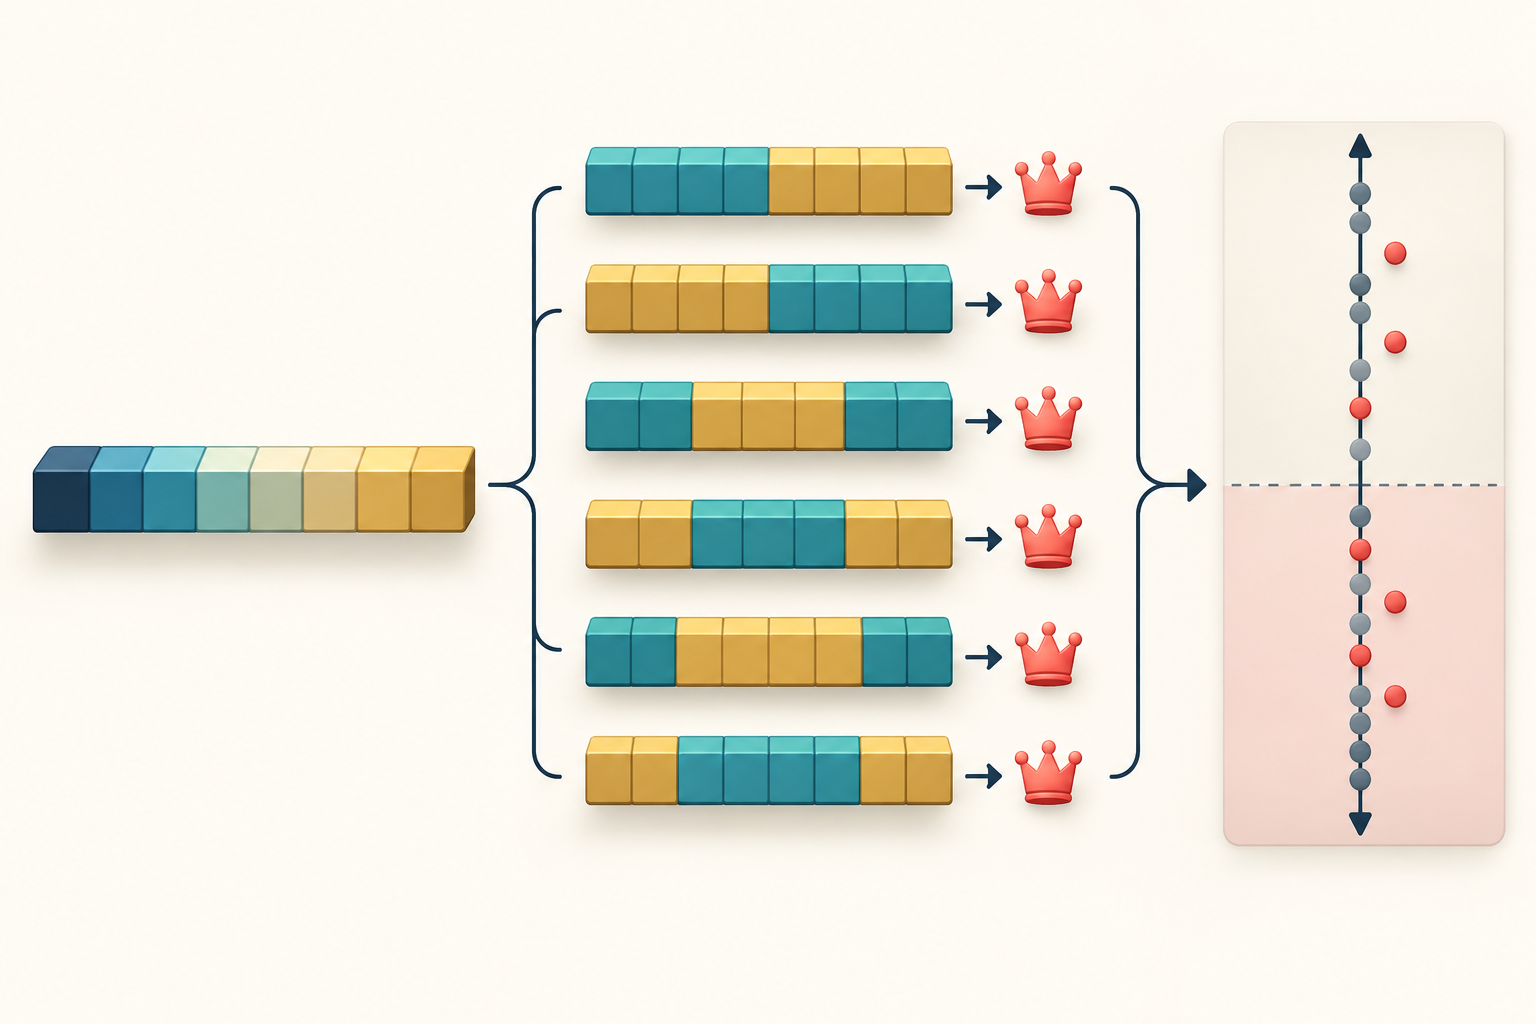
बराबर आकार के अलग-अलग time block की सम संख्या S चुनें और हर block के भीतर समय-क्रम बनाए रखें। S/2 block के हर संभव चयन को in-sample (IS) set बनाएँ और बचे S/2 को out-of-sample (OOS) set रखें। Path-dependent metric के लिए चुने block का मूल क्रम बनाए रखें और लिखें कि उन्हें जोड़ने का metric पर क्या अर्थ है।
IS assignment की संख्या C(S,S/2) है। A, B, C और D चार block हों तो छह assignment AB, AC, AD, BC, BD और CD हैं; हर complement अलग assignment के रूप में गिना जाता है। S = 16 पर C(16,8) = 12,870। ये उसी history के deterministic combination हैं, 12,870 स्वतंत्र market experiment नहीं।
“Symmetric” का मतलब है कि complement दूसरे combination में selection set बनता है: एक split में AB IS और CD OOS, दूसरे में उलटा। “Combinatorial” का मतलब है अर्धे block के सभी चुनाव गिनना, एक random split लेना नहीं। यह chronological replay नहीं है। चुने set में शुरुआती और आखिरी block साथ हो सकते हैं, जबकि complement में बीच के block हों। इसलिए यहाँ OOS का अर्थ “training के बाद का भविष्य” नहीं है।
चुने हुए candidate की OOS rank को logit में बदलें
Split c में research selection rule को IS पर लागू करके सबसे अच्छा candidate n*(c) चुनें। फिर वही performance metric लगाकर complement OOS पर सभी N candidate को score करें। चुने candidate की rank r(c) रखें: सबसे खराब 1, सबसे अच्छा N। Tie का नियम पहले तय कर हर split में वैसा ही रखें।
Relative rank है ω(c) = r(c)/(N+1)। N+1 से भाग देने पर सबसे कम और सबसे ऊँची rank भी शून्य और एक के बीच रहती है। Logit है λ(c) = ln(ω(c)/(1−ω(c)))। OOS median से नीचे rank पर यह negative, median पर zero और उससे ऊपर positive होता है। सभी CSCV assignment में λ(c) ≤ 0 का अनुपात estimated PBO है।
एक PBO संख्या बताती है कि IS winner कितनी बार OOS median तक या उससे नीचे आता है। Logit का पूरा distribution दिखाता है कि चुने candidate आम तौर पर बीच के पास रहते हैं, अक्सर बहुत नीचे गिरते हैं या अधिकतर ऊपर rank करते हैं। Logit relative rank का रूपांतरण है, किसी live trade की संभावना या भविष्य के return का calibrated forecast नहीं।
चार ब्लॉक का काल्पनिक उदाहरण PBO को 66.7% दिखाता है
मान लें चार बराबर ऐतिहासिक block और R1 से R4 तक चार candidate rule हैं। तालिका में छह IS assignment हैं। OOS rank बताती है कि IS में चुना rule complement block पर बाकी चार के मुकाबले कहाँ आया। सभी मान काल्पनिक हैं और केवल गणना दिखाते हैं।
| IS ब्लॉक | IS विजेता | OOS rank r | Relative rank ω = r/5 | Logit ln(ω/(1−ω)) | Median या उससे नीचे? |
|---|---|---|---|---|---|
| AB | R1 | 1 | 0.20 | −1.386 | हाँ |
| AC | R3 | 4 | 0.80 | +1.386 | नहीं |
| AD | R2 | 2 | 0.40 | −0.405 | हाँ |
| BC | R1 | 1 | 0.20 | −1.386 | हाँ |
| BD | R4 | 3 | 0.60 | +0.405 | नहीं |
| CD | R3 | 2 | 0.40 | −0.405 | हाँ |
छह में से चार चुने rule की OOS relative rank आधे से अधिक नहीं है। इसलिए empirical PBO = 4/6 ≈ 0.667, यानी करीब 66.7%। उदाहरण के लिए rank 2 पर ω = 2/(4+1) = 0.4 और λ = ln(0.4/0.6) ≈ −0.405। Rank 3 से ω = 0.6 और उलटे चिह्न वाला logit करीब +0.405 मिलता है।
इसका मतलब अगले महीने पैसे खोने की 66.7% संभावना नहीं है। इस काल्पनिक matrix और rank convention में IS winner छह में से चार विभाजनों पर OOS candidate median तक या उससे नीचे आया। बाकी दो winner का absolute OOS return भी नकारात्मक हो सकता है, भले ही वे peers से ऊपर rank करें।
PBO को सीमाओं वाला conditional diagnostic मानें
PBO candidate family, देखी गई performance matrix, selection metric, time block और tie rule पर निर्भर है। दर्ज न किए गए प्रयोग इसके दायरे से बाहर हैं। “Model-free” का अर्थ है कि forecasting equation जाने बिना candidate के performance history से गणना हो सकती है; इसका अर्थ design choice, data quality या assumption से मुक्त होना नहीं।
CSCV block को बराबर आकार के symmetric subset में जोड़ता है, लेकिन OOS आम तौर पर बाद की एक लगातार chronological अवधि नहीं होती। Block फिर जोड़ने से long-term dependence, seasonality या economic regime का क्रम टूट सकता है। S combination की संख्या और हर block की अवधि तय करता है; strategy horizon और संरचना के अनुसार चुनकर दर्ज करें। Combination अधिक होने से उतनी independent observation नहीं बनतीं, क्योंकि वही block फिर से इस्तेमाल होते हैं।
Statistic source return के bias भी लेता है: survivorship, revised data, उस समय उपलब्ध न रहे feature, अवास्तविक fill, छूटी लागत या बाद में चुना universe सभी candidate history को भ्रामक बना सकते हैं। CSCV अपने-आप overlapping label interval को purge नहीं करता, हर split में पूरी model pipeline दोबारा fit नहीं करता और preprocessing leakage नहीं रोकता। शोध के प्रश्न के अनुसार ये कदम स्पष्ट रूप से लागू करें। Chronological protection के लिए TimeSeriesSplit का आधिकारिक दस्तावेज़ और purged-validation guide देखें।
Maximum drawdown जैसे path-dependent metric में विशेष सावधानी चाहिए: दूर-दूर के block जोड़ने से path और metric बदल सकते हैं। PBO लेख कहता है कि Sharpe से अलग कुछ metric में observation का क्रम मायने रखता है। Rank समझाने से पहले क्रम, gaps, missing observation और compounding का तरीका बताएँ।
पूरी search history और chronological evidence के साथ PBO रिपोर्ट करें
गणना से पहले candidate registry, परिणाम देखने के बाद किए हर बदलाव, performance matrix, selection metric और tie rule सुरक्षित रखें। T, N, S, block construction, C(S,S/2), OOS rank convention, estimated PBO और logit distribution रिपोर्ट करें। Absolute OOS performance, cost, turnover, drawdown और loss वाले candidates की संख्या भी दें; rank अकेले नहीं दिखाती कि सभी कमजोर हैं या नहीं।
बाद के data पर frozen research process जाँचने के लिए walk-forward या वास्तविक chronological holdout इस्तेमाल करें। Model और threshold चुनते समय अंतिम अवधि बंद रखें; बार-बार देखने से वह एक और selection set बन जाती है। TimeSeriesSplit जैसे time-ordered tool अपने documented assumption के अनुसार chronological fold बनाते हैं, जबकि PBO searched candidate family का अलग rank-based गुण मापता है।
इसलिए PBO label-overlap control, multiple-testing analysis, realistic execution modeling, prospective evaluation और live monitoring का पूरक है, विकल्प नहीं। आगे वित्त में multiple testing और false discovery rate और serial correlation के लिए Sharpe-ratio समायोजन देखें। कोई एक statistic ऐतिहासिक rank को टिकाऊ trading edge का प्रमाण नहीं बनाता।
आम सवाल
Q1क्या PBO का मतलब है कि strategy के पैसे खोने की उतनी संभावना है?
नहीं। यह तय split में IS-चुने candidate के OOS median पर या नीचे rank करने की आवृत्ति आँकता है। यह भविष्य के नुकसान की संभावना या calibrated live-return forecast नहीं है।
Q2क्या CSCV, walk-forward testing जैसा है?
नहीं। CSCV हर आधे block को complement से जोड़ता है, इसलिए OOS में पुराने और नए दोनों block हो सकते हैं। Walk-forward हर बाद के test period से पहले training रखता है, ताकि chronological deployment-जैसा रास्ता देखा जा सके।
Q3क्या कम PBO साबित करता है कि चुनी रणनीति में edge है?
नहीं। विजेता कमजोर candidate group से बेहतर होकर भी absolute terms में नुकसान कर सकता है। Net return, uncertainty, cost, leakage और सचमुच बाद के data पर performance का अलग-अलग आकलन करें।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
Estimated PBO में कौन-सी घटना शामिल होती है?
व्याख्या देखने के लिए एक उत्तर चुनें