

Purged cross-validation और embargo: ट्रेडिंग मॉडल में label leakage रोकना
समझें कि overlapping forward labels वाले वित्तीय time series का validation कैसे करें, और purging व embargo, walk-forward, TimeSeriesSplit तथा CPCV से कैसे अलग हैं।
इस गाइड मेंRandom folds भ्रामक नतीजे क्यों दे सकते हैं?
संक्षिप्त सारांश
जब भविष्य के outcome labels की समय-अवधियाँ एक-दूसरे से overlap करती हैं, तो random split training और test के बीच जानकारी लीक कर सकता है। Purging उन training samples को हटाता है जिनके outcome intervals test outcomes से overlap करते हैं। Embargo कुछ splits में test block के बाद रखा गया अलग buffer है। इनमें से कोई भी अपने-आप chronological ordering या feature निर्माण की सही timing सुनिश्चित नहीं करता।
Random folds भ्रामक नतीजे क्यों दे सकते हैं?
Random K-fold rows को training और test folds में बेतरतीब बाँटता है। वित्तीय series में observations निर्भर हों या उनके forward outcome intervals overlap हों, तो इससे नतीजा भ्रामक हो सकता है। किसी training sample का label ऐसे return शामिल कर सकता है जो test sample के label में भी मौजूद है। इससे validation, अनदेखी भविष्य-अवधि का अनुमान लगाने से आसान हो सकती है।
फिर भी K-fold का हर उपयोग गलत नहीं है। उपयुक्तता इस पर निर्भर करती है कि मूल्यांकन का प्रश्न क्या है, samples कैसे बनाए गए, उनमें समयगत निर्भरता कितनी है और label कैसे परिभाषित है। दैनिक return rows को random बाँटना उन समय-अवधियों की जाँच नहीं करता जिन्हें rows दर्शाती हैं।
Decision time, feature और label interval परिभाषित करें
हर sample के लिए decision time t, उस क्षण वास्तव में उपलब्ध जानकारी, feature window, target/label interval और label resolve होने का समय t1 दर्ज करें। पाँच session आगे के return का label (t,t+5] को कवर करता है: यह t के बाद शुरू होता है और पाँचवें session के अंत पर समाप्त होता है।
Feature में वही डेटा होना चाहिए जो prediction के समय t पर उपलब्ध था। दो feature windows में पहले का साझा price history होना अपने-आप leakage नहीं; मॉडल पहले से ज्ञात बाज़ार इतिहास दोबारा उपयोग कर सकता है। लेकिन भविष्य का मान या निर्णय के बाद संशोधित होकर उपलब्ध हुआ data इस्तेमाल करना leakage है। Event labels की अवधि अलग-अलग हो सकती है, इसलिए हर घटना के वास्तविक आरंभ और अंत के timestamp रखें।
Test outcome से overlap करने वाले training labels हटाएँ
Purging उस training sample को हटाता है जिसका वास्तविक outcome/label interval किसी test sample के outcome interval से overlap करे। इसलिए समय-अवधियों की तुलना करें; fold boundary के दोनों ओर सुविधानुसार row-count हटाना पर्याप्त नहीं। अलग अवधि वाले event labels के लिए event के वास्तविक start/end timestamps इस्तेमाल करें, सुविधाजनक स्थिर row-count नहीं।
Francisco López de Prado की Advances in Financial Machine Learning का अध्याय 7 cross-validation और purging से information overlap संभालने की चर्चा करता है। Overlapping labels हटाने से split अपने-आप chronological नहीं हो जाता: training में test block के बाद की observations रह सकती हैं। इसलिए हर fold को future deployment simulation कहने के बजाय बताएं कि split कौन-सा सवाल हल करता है।
दिन-आधारित उदाहरण से overlap जाँचें
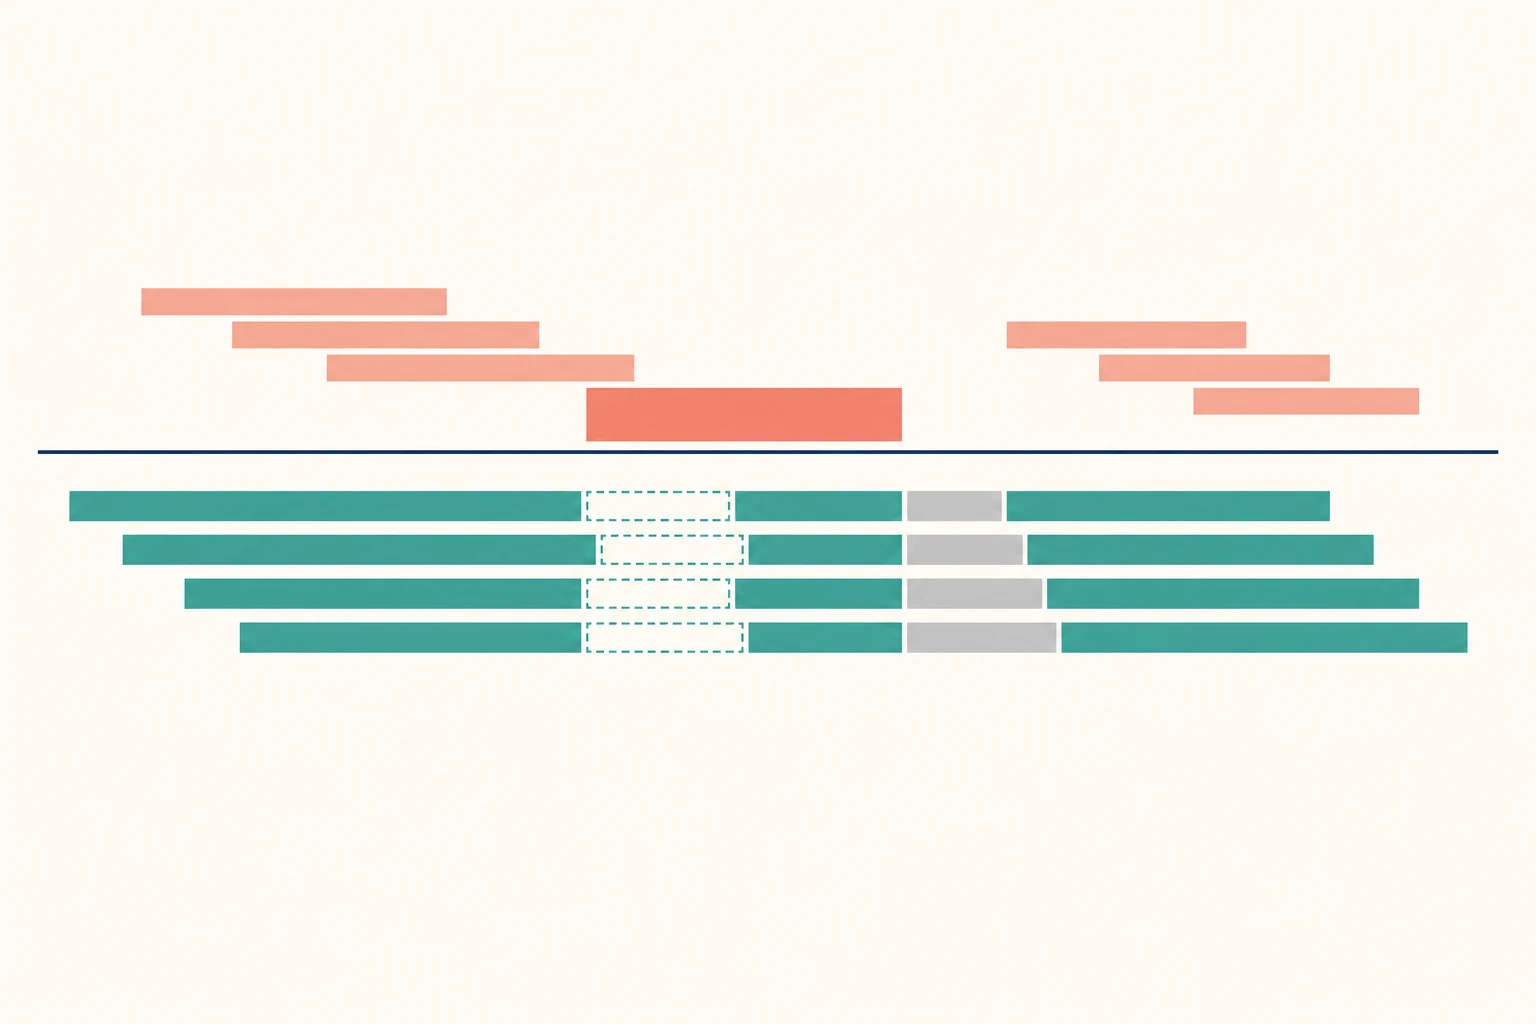
मान लें कि हर दिन निर्णय होता है और forward outcome पाँच sessions का है, यानी label interval (t,t+5]। Test decision dates 11–15 हैं, इसलिए test labels day 20 तक जाते हैं। उदाहरण में दिन लगातार trading sessions हैं और interval का दायाँ सिरा शामिल है, जैसा bracket बताता है।
Training label (7,12] test outcome से overlap करता है—जैसे day 11 पर शुरू होने वाले test label से—इसलिए उसे purge किया जाता है। (16,21] भी day 15 पर शुरू होकर day 20 पर खत्म होने वाले test label से overlap करता है; इसे भी हटाएँ। निर्णय वास्तविक interval overlap पर आधारित है, rows की संख्याओं के बीच किसी स्थिर gap पर नहीं।
बाद के sample का label test outcomes से न भी मिले, फिर भी test block के बाद चुने गए अलग embargo में आने पर उसे training से हटाया जा सकता है। यह सिर्फ उदाहरण है; सभी डेटा या रणनीतियों के लिए gap की कोई सार्वभौमिक लंबाई नहीं बताता।
Embargo को अलग, तर्कसंगत buffer समझें
Embargo test block के बाद तय किया गया buffer है, जिसके दौरान बाद की observations को training में शामिल नहीं किया जाता—उन splits में जो test से पहले और बाद, दोनों ओर के data से train कर सकते हैं। Event या feature construction से बची निर्भरता को यह घटा सकता है, भले बाद के sample का label test label से सीधे overlap न करे।
इसकी कोई सार्वभौमिक प्रतिशत या अवधि नहीं है और यह वास्तविक label intervals की जाँच का विकल्प नहीं है। Sampling frequency, label horizon, feature construction और जिस निर्भरता को घटाना है, उसके आधार पर अवधि चुनें और कारण दर्ज करें। बहुत लंबा buffer उपयोगी training data हटा सकता है; बहुत छोटा buffer संबंधित निर्भरता छोड़ सकता है।
Validation तरीकों को उनके सवाल के अनुसार तुलना करें
Random K-fold observations को folds में बेतरतीब बाँटता है; निर्भरता या overlapping labels होने पर यह आगे की अवधि का पूर्वानुमान करने जैसा नहीं हो सकता। Walk-forward या rolling-origin validation अतीत पर train करके आगे के समयखंड पर test करती है, फिर सीमा आगे बढ़ाती है। यह ऐतिहासिक deployment के अधिक करीब है, पर feature leakage या test data से model selection अपने-आप नहीं रोकती।
scikit-learn का TimeSeriesSplit क्रमिक chronological splits देता है और gap training तथा test के बीच rows की संख्या छोड़ता है। आधिकारिक दस्तावेज़ के अनुसार test durations की तुलना के लिए observations समान अंतर पर होनी चाहिए; gap row-count है, बदलते event-time intervals की जाँच करने वाला engine नहीं। Purged K-fold वास्तविक label overlap हटाता है, पर test block के बाद की rows पर train कर सकता है। Combinatorial purged CV (CPCV) कई test groups से अनेक paths बनाता है; यह अपने-आप chronological historical simulation नहीं बनता और दूसरी leakage भी नहीं हटाता।
Advances in Financial Machine Learning के अध्याय 12 में walk-forward और CPCV तरीकों तथा उनके उपयोग के संदर्भ पर चर्चा है।
Label interval के बाहर भी leakage देखें
गलत timestamp वाले या भविष्य की जानकारी से बने features validation को फिर भी दूषित कर सकते हैं। इसी तरह वर्तमान database में बाद के revisions या केवल बचे हुए securities हों तो survivorship/revision bias आता है। Split से पहले पूरी dataset पर preprocessing या feature selection करना भी test information को training तक पहुँचा सकता है।
बहुत-से model trials के बाद सबसे अच्छा चुनना selection bias जोड़ता है, चाहे labels अलग हों। अवास्तविक trading costs या ऐसे fills मानना जो वास्तविकता में नहीं मिलते, backtest बढ़ा-चढ़ाकर दिखा सकते हैं। Bailey और सहलेखकों का Probability of Backtest Overfitting अनेक परीक्षणों में सर्वोत्तम नतीजा चुनने का जोखिम बताता है। Split design अकेले इन समस्याओं को ठीक नहीं करता।
Preprocessing और selection training folds के अंदर करें
हर fold में transformations, feature selection और parameter choice को केवल training data पर fit करें। Candidates को nested time-aware validation से चुनें, ताकि outer test fold एक ही समय में model selection और उसकी performance estimate दोनों न बने।
तरीका तय होने के बाद अंतिम chronological अवधि को untouched holdout रखें। उसके परिणाम देखकर model बार-बार बदलें तो उसे स्वतंत्र final test न कहें। Cross-validation चुने हुए split और data के तहत performance मापती है; भविष्य के performance की गारंटी नहीं देती।
Validation प्रक्रिया को दोहराने योग्य लिखें
Sample unit, decision time, feature source और उपलब्ध होने का समय, हर feature window और वास्तविक label interval (t,t1] दर्ज करें। Split strategy, folds, purging का interval rule, embargo अवधि व उसका कारण, और TimeSeriesSplit में gap row-count लिखें।
यह भी बताएँ कि training में test block के बाद की observations थीं या नहीं, costs और fills कैसे मापे, और model selection किन folds में की। आगे पढ़ें: bias-variance trade-off और financial-model overfitting, finance में multiple testing और false discovery rate, और serial correlation के साथ Sharpe का वार्षिकीकरण।
आम सवाल
Q1क्या random K-fold वित्तीय data के लिए हमेशा गलत है?
नहीं। मूल्यांकन का प्रश्न और sample structure अनुकूल हों तो यह उपयोगी हो सकता है। लेकिन समयगत निर्भरता या overlapping outcome intervals नतीजे को भटका सकते हैं; विधि चुनने से पहले samples और labels जाँचें।
Q2क्या embargo, purging की जगह ले सकता है?
नहीं। Purging overlap करने वाले outcome intervals वाले training samples हटाता है। कुछ splits में embargo test block के बाद अलग buffer हटाता है। दोनों के काम अलग हैं और कोई भी prediction time पर अनुपलब्ध feature को सही नहीं ठहराता।
Q3क्या CPCV भविष्य के प्रदर्शन की गारंटी देता है?
नहीं। CPCV किसी तय split scheme के तहत कई test paths बनाता है। यह data leakage, बार-बार model आज़माने, बदलते बाज़ार या भविष्य की execution uncertainty नहीं मिटाता।
स्रोत और आगे पढ़ें
समस्या की रिपोर्ट करें
हम इस लेख का लिंक जोड़कर ईमेल तैयार करेंगे। भेजने के बाद ही Mark को आपकी रिपोर्ट मिलेगी
त्वरित जाँच
गाइड पढ़ने के बाद 3 सवालों से खुद को जाँचें
सवाल 01
Purging में training sample कब हटाया जाना चाहिए?
व्याख्या देखने के लिए एक उत्तर चुनें
विकल्प शब्दावली
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
विस्तृत गाइड पढ़ेंFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
विस्तृत गाइड पढ़ेंऑप्शन असाइनमेंटएक्सरसाइज नोटिस के बाद कॉन्ट्रैक्ट पूरा करने की जिम्मेदारी ऑप्शन विक्रेता को देने की प्रक्रिया, जिससे शेयर देने या खरीदने का दायित्व बन सकता है।
विस्तृत गाइड पढ़ें