

Régression MIDAS : données à fréquences mixtes et prévision de la volatilité
Découvrez comment la régression MIDAS combine des données financières quotidiennes et hebdomadaires avec des pondérations parcimonieuses des retards, comment produire une prévision de volatilité et où ces modèles peuvent induire en erreur.
Dans ce guideMIDAS répond au décalage entre fréquences d'observation
Bref résumé
MIDAS (échantillonnage de données mixtes) relie des observations enregistrées à des fréquences différentes sans imposer d'abord un calendrier unique à toutes les séries. Quelques paramètres estimés pondèrent l'historique des observations à fréquence élevée et peuvent aider à prévoir une cible financière à fréquence plus faible. Les pondérations décrivent un profil prédictif sous un modèle donné ; elles ne prouvent ni causalité ni avantage de trading.
MIDAS répond au décalage entre fréquences d'observation
Les données financières et économiques ne suivent pas la même horloge. Une cible de volatilité peut être mesurée chaque semaine tandis que ses prédicteurs possibles sont des rendements quotidiens ou des mesures réalisées intrajournalières. Une série macroéconomique peut être trimestrielle alors que le prix d'un actif est observé chaque séance. Une régression ordinaire attend une ligne par observation pour la cible et les variables explicatives ; il faut donc décider comment traiter ces calendriers différents avant d'estimer le modèle.
Une option consiste à agréger les entrées quotidiennes en moyenne ou en somme hebdomadaire. C'est simple, mais cela impose un poids particulier à chaque jour et peut effacer le moment de la semaine où un mouvement s'est produit. Une autre option consiste à répéter une valeur trimestrielle sur des lignes quotidiennes ou à l'interpoler. La répétition peut faire passer un chiffre lentement variable pour de nombreuses nouvelles observations ; l'interpolation peut créer une trajectoire lisse qui n'a jamais été observée. Aucune de ces opérations ne crée de l'information.
MIDAS offre une manière directe de relier les fréquences. La cible conserve sa fréquence naturelle plus faible, tandis que la régression inclut des retards structurés de la série à fréquence plus élevée. Le nom désigne l'échantillonnage de données mixtes, et non un modèle de volatilité unique. Les régressions MIDAS servent à prévoir la volatilité et dans d'autres situations où les prédicteurs sont échantillonnés plus finement que le résultat. La question centrale est de savoir quelle part de l'historique haute fréquence récent inclure et comment contraindre ses pondérations.
Un retard pondéré condense de nombreuses observations en un prédicteur compact
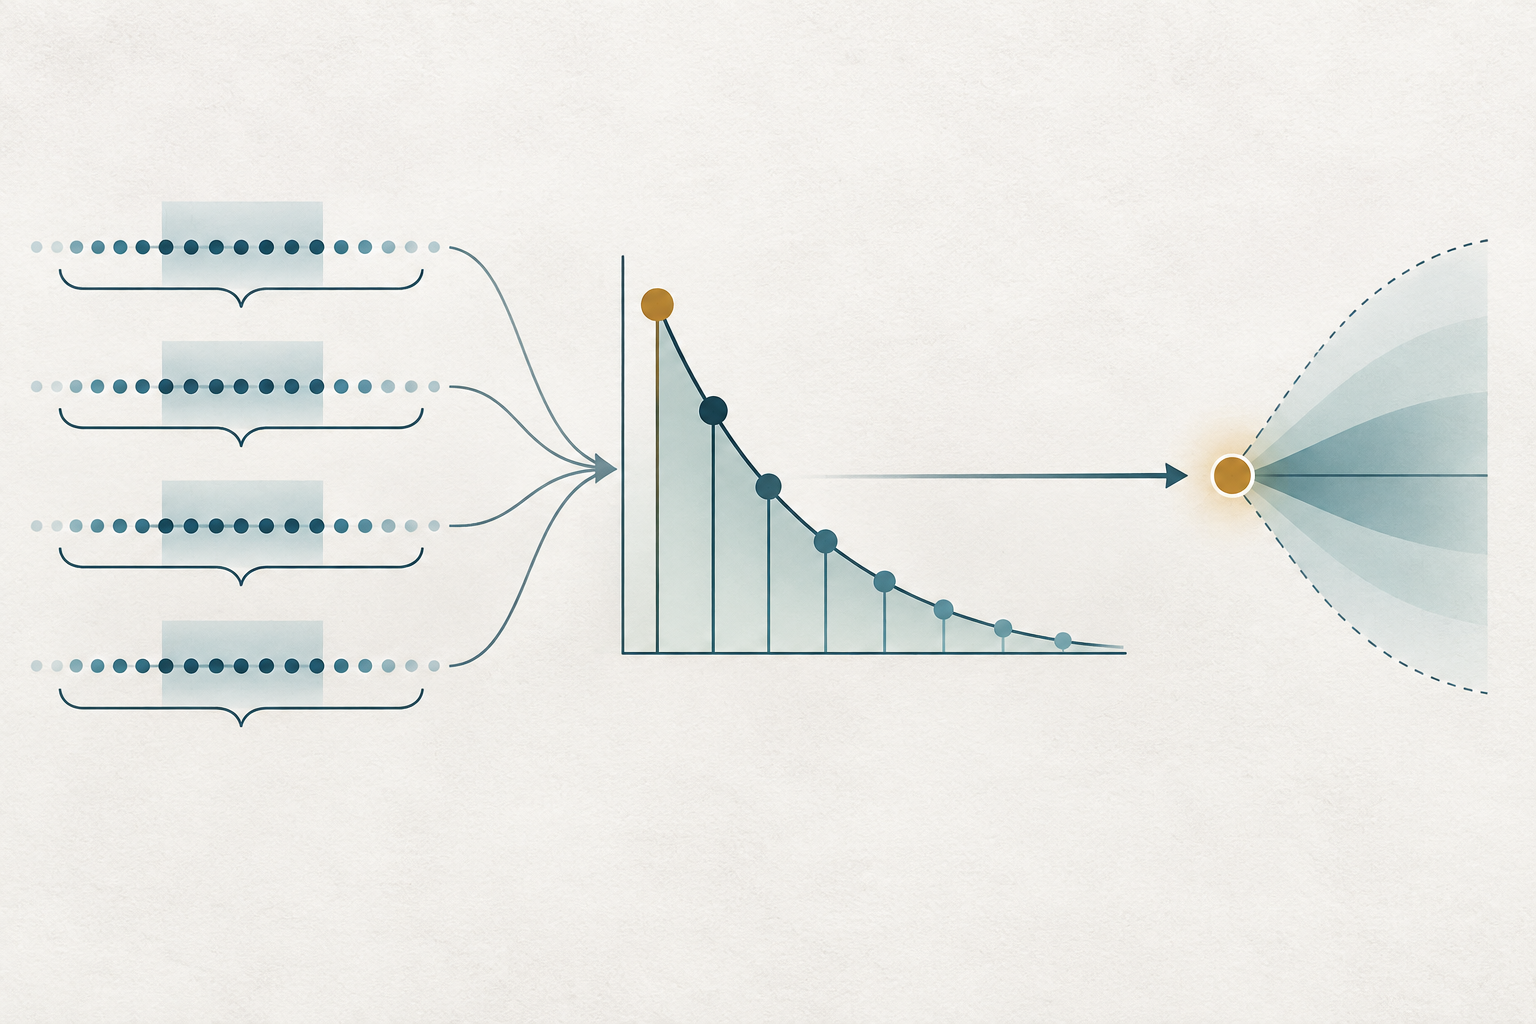
Soit \(y_{t+1}\) une cible à fréquence plus faible, par exemple la variance réalisée de la semaine suivante, observée après la fin de cette semaine. Soit \(x_{t-j}\) un prédicteur quotidien observé \(j\) séances avant l'origine de prévision, à la clôture de la semaine \(t\). Une régression MIDAS simple s'écrit \(y_{t+1}=a+b\sum_{j=1}^{K}w_j(\theta)x_{t-j}+u_{t+1}\), où \(K\) est le nombre de retards quotidiens, \(w_j(\theta)\) est une pondération pilotée par quelques paramètres et \(u_{t+1}\) l'erreur de prévision.
Les pondérations sont souvent normalisées de sorte que \(\sum_{j=1}^{K}w_j(\theta)=1\). La somme se lit alors comme un historique pondéré, tandis que \(b\) détermine la force de son lien avec la cible. La normalisation ne signifie pas que les observations quotidiennes soient indépendantes ou aussi informatives les unes que les autres. Elle constitue une paramétrisation pratique du profil des retards.
L'analyste peut choisir \(x\) comme rendements quotidiens au carré, rendements absolus, mesure de variance réalisée calculée à partir de rendements intrajournaliers ou toute autre variable disponible à l'origine de prévision. La cible \(y\) peut être une future variance hebdomadaire, une publication macroéconomique mensuelle ou un autre résultat à fréquence plus faible. Sa définition détermine le sens des coefficients. Un modèle d'une approximation de variance réalisée n'est pas automatiquement un modèle de variance instantanée latente, de variance implicite des options ou de rendement d'un actif.
MIDAS est un cadre de régression, pas un estimateur universel. La réponse peut être modélisée en niveau, en logarithme ou au moyen d'une fonction de lien ; l'estimation dépend de la famille de pondérations et des hypothèses d'erreur. Une régression linéaire d'une approximation de variance non négative peut produire des valeurs ajustées négatives si le pronostic n'est pas contraint ou si la cible n'est pas transformée. La commodité du modèle ne dispense pas de vérifier le support et les unités de la cible.
La fonction de pondération arbitre entre flexibilité et stabilité
Une régression à retards distribués sans contrainte estime un coefficient séparé pour chacune des \(K\) entrées quotidiennes. Si \(K\) est grand par rapport au nombre d'observations hebdomadaires de la cible, les estimations peuvent être bruitées et fortement corrélées. MIDAS définit plutôt les coefficients des retards par une fonction de faible dimension. Un profil illustratif d'Almon exponentiel est \(w_j(\theta)=\frac{\exp(\theta_1j+\theta_2j^2)}{\sum_{\ell=1}^{K}\exp(\theta_1\ell+\theta_2\ell^2)}\). Un profil polynomial Beta normalisé est aussi courant.
Ces profils peuvent donner davantage de poids aux séances récentes, le faire décroître progressivement ou accorder un poids relatif plus élevé à une partie centrale de la fenêtre. Les paramètres décrivent la courbe lisse choisie ; ils ne mesurent pas sans réserve l'importance de chaque journée. Si les données soutiennent une réponse brève mais que la fonction retenue impose une longue queue lisse, les coefficients estimés héritent de cette contrainte. À l'inverse, estimer librement trop de coefficients quotidiens risque d'ajuster le bruit plutôt qu'une dynamique stable.
Les contraintes de pondération sont des hypothèses de modèle. Des pondérations non négatives normalisées peuvent rendre un pronostic de variance interprétable comme une moyenne pondérée, mais elles excluent les effets positifs et négatifs de retards qui se compensent. Un profil flexible peut admettre un sommet ou une pente changeante, mais un trop grand nombre de paramètres de forme risque d'être faiblement identifié. Comparez quelques profils défendables, indiquez les retards disponibles et vérifiez si le pronostic change sensiblement avec la famille de pondérations.
Il n'existe pas de \(K\) universel. Une fenêtre plus longue peut capter une information persistante, mais ajoute des paramètres ou impose une courbe plus longue ; une fenêtre courte peut manquer une dynamique lente. Choisissez le nombre de retards à partir des informations disponibles dans la période d'estimation et validez-le sans utiliser la cible future d'évaluation. Un bon ajustement en échantillon ne suffit pas à montrer que la fenêtre capte un signal reproductible.
Aligner l'origine de prévision sur le moment où chaque valeur était connue
Les étiquettes de fréquence ne suffisent pas à définir un protocole de prévision valide. Supposons que la cible soit la variance de la prochaine semaine de cinq séances et que le pronostic soit établi après la clôture du vendredi. Les prédicteurs peuvent inclure les observations quotidiennes terminées ce vendredi, mais pas une variance réalisée calculée à partir des rendements de la semaine à venir. Une statistique hebdomadaire ou mensuelle peut être publiée après la période qu'elle décrit. Un backtest doit utiliser la valeur réellement disponible à l'époque, et non la valeur révisée ou publiée ultérieurement.
Avant l'estimation, dressez un tableau des origines de prévision : heure de production, horodatage le plus tardif autorisé pour chaque prédicteur, période cible et date à laquelle la cible devient observable. Pour les rendements financiers, précisez si le rendement de clôture à clôture comprend une période nocturne, quelle séance définit une journée et comment les jours fériés ou les barres manquantes modifient le compte des retards quotidiens. Cinq séances et sept jours calendaires sont des intervalles différents.
Les calendriers de publication créent des bords irréguliers. À une date donnée, un prédicteur peut avoir une valeur quotidienne récente alors qu'une série mensuelle n'a pas encore été publiée. Reporter la dernière valeur mensuelle disponible peut être valide si le modèle la traite comme une information connue à l'origine, mais ancienne. Il n'est pas valide de compléter une observation non publiée avec une publication ultérieure. Les révisions historiques créent un problème plus subtil d'anticipation : une base actuelle peut contenir une série macroéconomique révisée qu'un prévisionniste en temps réel n'aurait pas pu connaître.
Les marchés asynchrones compliquent aussi l'alignement. Une clôture quotidienne des actions et une clôture quotidienne des cryptomonnaies peuvent couvrir des intervalles UTC différents ; une mesure intrajournalière de volatilité peut inclure des barres qui se terminent après l'heure de prévision. Conversion des fuseaux horaires, heure d'été, fermeture des marchés et construction des barres font partie de l'ensemble d'information. Décrivez leur traitement au lieu de supposer que des lignes portant la même date partagent la même coupure informationnelle.
Un exemple hypothétique transforme des entrées quotidiennes en prévision hebdomadaire
Supposons que la cible soit la variance réalisée de la semaine suivante et que le pronostic soit établi à la clôture du vendredi. Le modèle utilise cinq mesures quotidiennes de variance réalisée pour la semaine qui vient de s'achever. Les pondérations estimées, de la séance la plus récente à la plus ancienne, sont \(0{,}40,0{,}25,0{,}16,0{,}11,0{,}08\), soit une somme égale à un. Les entrées quotidiennes correspondantes, en unités de rendement au carré, sont \(0{,}0004,0{,}0001,0{,}0009,0{,}0004,0{,}0001\).
L'historique pondéré vaut \(0{,}40(0{,}0004)+0{,}25(0{,}0001)+0{,}16(0{,}0009)+0{,}11(0{,}0004)+0{,}08(0{,}0001)=0{,}000381\). Pour ce modèle ajusté hypothétique, prenons une constante \(a=0{,}00012\) et une pente \(b=0{,}80\). Le pronostic de variance pour la semaine suivante est \(0{,}00012+0{,}80(0{,}000381)=0{,}0004248\). Si un résumé en écart-type est utile, sa racine carrée est d'environ \(0{,}02061\), soit \(2{,}06\,\%\) sur la semaine cible selon la définition retenue.
Le calcul illustre le passage des prédicteurs quotidiens à une cible hebdomadaire future ; valeurs et coefficients sont inventés. Il ne signifie pas qu'une journée mentionnée a causé la variance de la semaine suivante ni que l'actif devrait monter ou baisser. Le poids de la séance récente indique comment le modèle spécifié combine les entrées observées, conditionnellement à l'échantillon et aux restrictions. Ce n'est pas une estimation d'effet causal.
L'exemple soulève aussi une question d'unités. Variances réalisées quotidienne et hebdomadaire sont toutes deux des variances de rendements, mais elles portent sur des périodes d'accumulation différentes. La pente \(b\), la constante et la construction de la cible sont estimées selon cette convention précise ; les entrées quotidiennes ne peuvent pas simplement être rebaptisées variance hebdomadaire. Si la cible est le logarithme de la variance hebdomadaire, la prévision est en unités logarithmiques et exponentier la moyenne conditionnelle du logarithme n'égale généralement pas la moyenne conditionnelle de la variance. Toute retransformation vers les niveaux exige une cible clairement définie et, le cas échéant, une correction.
L'estimation dépend de la cible et de la contrainte sur les retards
Avec un vecteur de pondérations fixe, la régression est linéaire en la constante et la pente. Lorsque les pondérations dépendent de paramètres non linéaires inconnus \(\theta\), on utilise souvent les moindres carrés non linéaires ou une méthode apparentée fondée sur la vraisemblance. L'estimation recherche les paramètres de forme et les coefficients ensemble, ou profile les coefficients linéaires pour chaque forme candidate. Valeurs initiales, bornes des paramètres, critères de convergence et optima locaux peuvent compter ; les échecs de convergence ou solutions en bord de domaine ne doivent pas être dissimulés.
Si \(y\) est une mesure de volatilité non négative, une spécification linéaire ordinaire peut produire une valeur ajustée négative, surtout hors échantillon. On peut imposer des contraintes garantissant des niveaux non négatifs, utiliser une fonction de lien positive ou modéliser le logarithme de la cible. Ces choix modifient l'estimande et l'interprétation de la prévision. Dans un modèle en log-cible, la prévision de la moyenne conditionnelle du log de la variance ne donne pas automatiquement la moyenne conditionnelle de la variance ; la loi des erreurs et la retransformation comptent.
L'incertitude d'échantillonnage dépend aussi de la construction de la cible. Une variance réalisée hebdomadaire calculée à partir de rendements intrajournaliers comporte une erreur de mesure et peut dépendre du bruit de microstructure, de l'intervalle d'échantillonnage, des sauts et des observations manquantes. Si les fenêtres cibles hebdomadaires se chevauchent, les erreurs de prévision d'origines voisines partagent des rendements. Erreurs-types et comparaisons supposant des erreurs indépendantes peuvent alors être inadaptées. Utilisez une inférence correspondant à l'horizon et à la dépendance, et décrivez la mesure de la cible.
La stabilité des paramètres est un autre enjeu. Un profil estimé moyenne toute la période d'estimation ; si la structure du marché change, la courbe peut ne bien décrire aucun régime actuel. Les fenêtres expansives et glissantes répondent à des questions différentes : la première utilise plus d'historique mais conserve des dynamiques anciennes ; la seconde s'adapte plus vite, au prix de moins d'observations et de davantage de bruit d'estimation. Préspécifiez la règle de mise à jour et comparez-la à une référence fixe dans une évaluation chronologique.
MIDAS est lié à GARCH-MIDAS, mais les deux ne sont pas identiques
Le terme MIDAS désigne une manière de combiner des observations de fréquences différentes au moyen de retards pondérés. Une régression MIDAS peut prévoir directement une cible de volatilité réalisée future à partir de mesures quotidiennes ou intrajournalières passées. Elle n'a pas à spécifier la récurrence de variance conditionnelle à un pas associée à un modèle GARCH.
GARCH-MIDAS est une famille distincte qui combine une composante de volatilité de long terme évoluant lentement, souvent pilotée par des variables à plus basse fréquence, et une composante de variance conditionnelle de court terme qui évolue récursivement. Chacune a sa paramétrisation et ses hypothèses. Dans un article ou logiciel étiqueté GARCH-MIDAS, il faut examiner les équations exactes : les pondérations MIDAS peuvent régir la composante de long terme tandis qu'une récurrence GARCH traite les chocs de court terme. L'étiquette seule ne précise ni la cible, ni si le pronostic porte sur une volatilité latente ou réalisée, ni comment la positivité est assurée.
Les premiers travaux financiers sur MIDAS et la volatilité comparent différents prédicteurs, fréquences et nombres de retards dans un cadre parcimonieux. Des travaux méthodologiques ultérieurs étudient l'estimation et les propriétés de test des régressions à fréquences mixtes, notamment en les comparant à l'agrégation temporelle traditionnelle. Ces contributions étayent les mécanismes, mais ne garantissent pas que MIDAS surpasse toujours GARCH ni que les prédicteurs haute fréquence améliorent systématiquement les prévisions. Les résultats dépendent de l'actif, de l'échantillon, de la cible, du prédicteur, de l'horizon et du protocole d'évaluation.
Choisissez le modèle selon la question. Pour prévoir une future mesure de volatilité réalisée à partir de l'historique quotidien, une régression MIDAS directe est une candidate naturelle. Pour modéliser récursivement la variance conditionnelle, comparez une spécification GARCH adaptée. Pour combiner des publications macroéconomiques trimestrielles à une cible financière quotidienne, il peut falloir tenir compte des dates de publication et des versions de données. Des modèles aux noms proches peuvent répondre à des questions différentes ; comparez leurs origines de prévision, définitions de cible et ensembles d'information avant leurs performances.
Erreur de mesure et sélection peuvent dominer la courbe de pondération
Les données haute fréquence apportent plus de détail temporel mais peuvent accroître le bruit de mesure. Les barres très courtes contiennent rebond bid-ask, discrétisation des prix, cotations anciennes, transactions asynchrones et erreurs de flux. Additionner les rendements au carré à des intervalles toujours plus courts ne garantit pas une meilleure estimation de la variance réalisée. Choisissez la grille d'échantillonnage et les règles de nettoyage avant d'examiner les performances, puis étudiez des solutions de rechange plausibles.
Le nombre de résultats à basse fréquence, et non le nombre apparent de lignes de prédicteurs quotidiens, limite l'information disponible. Dix ans d'entrées quotidiennes appariées à des cibles hebdomadaires ne donnent qu'environ 500 périodes hebdomadaires avant valeurs manquantes et période d'évaluation réservée. Une fonction lisse réduit le nombre de coefficients par rapport à des retards quotidiens libres, mais sa forme peut rester faiblement identifiée si l'échantillon est court, les prédicteurs très persistants ou les retards candidats redondants.
De nombreux choix analytiques créent un biais de sélection : tester plusieurs mesures haute fréquence, longueurs de retards, profils de pondération, transformations, marchés, horizons et fonctions de perte, puis ne rapporter que le meilleur résultat. L'ajustement en échantillon est particulièrement vulnérable puisque les mêmes cibles orientent les paramètres et le choix du modèle. Conservez la famille de modèles essayés, définissez une métrique principale et utilisez un échantillon ultérieur chronologique réservé ou une comparaison tenant compte de la sélection. Si vous comparez de nombreuses prévisions aux mêmes dates, tenez compte de leur dépendance et des tests multiples.
Une courbe de pondération estimée n'est pas une explication causale. Les entrées haute fréquence peuvent servir d'indicateurs pour les nouvelles, la liquidité ou l'activité du marché ; des facteurs non observés peuvent influencer à la fois les prédicteurs et la volatilité future. L'utilité prédictive requiert un alignement temporel stable et des résultats hors échantillon. Une interprétation causale exige un plan d'identification distinct et des hypothèses supplémentaires à l'équation des retards MIDAS.
Une prévision ne définit pas une décision de trading rentable
Une prévision de volatilité peut éclairer un budget de risque, une couverture ou une plage de scénarios, mais elle ne détermine ni le signe d'un rendement ni la direction d'une position. Un écart-type hebdomadaire prévu de \(2{,}06\,\%\) n'est ni un mouvement promis, ni une perte maximale, ni une cotation de volatilité implicite des options. Il porte sur une mesure de dispersion choisie sous un modèle et un échantillon ; les rendements réalisés peuvent être beaucoup plus grands ou plus faibles.
Pour étudier une stratégie, définissez avant tout test l'heure du signal et de l'ordre, l'instrument, la règle d'exposition et la sortie. Réestimez les paramètres MIDAS historiques uniquement avec les informations disponibles à chaque origine de prévision. Évaluez les prévisions face à une référence préspécifiée et une perte adaptée à la cible, puis simulez séparément les rendements après spread, frais, financement, emprunt, impact de marché et rotation. Une meilleure précision statistique de volatilité ne garantit pas de meilleurs rendements nets de coûts.
Indiquez la cible et sa méthode de mesure ; définitions et unités des prédicteurs ; fréquences basse et haute ; origine de prévision ; nombre de retards ; fonction et contraintes de pondération ; fenêtre d'estimation et calendrier de mise à jour ; traitement des données manquantes et des versions historiques ; fonction de perte ; référence ; dates d'évaluation chronologique. Montrez l'incertitude ou la sensibilité si le profil de retards modifie sensiblement le résultat. Pour aller plus loin, consultez les guides sur la volatilité réalisée, le clustering de volatilité et GARCH et les comparaisons de précision des prévisions.
Les principales sources sont l'étude MIDAS de prévision de la volatilité de Ghysels, Santa-Clara et Valkanov, la revue méthodologique et ses extensions de Ghysels, Sinko et Valkanov, et l'analyse des modèles de régression à fréquences mixtes d'Andreou, Ghysels et Kourtellos. Leurs résultats empiriques se rapportent aux échantillons et dispositifs étudiés ; ils ne garantissent pas les performances sur les marchés actuels ou dans d'autres classes d'actifs.
Questions fréquentes
Q1MIDAS signifie-t-il que toutes les données sont ramenées à une fréquence unique par moyenne ?
Non. Une régression MIDAS conserve la cible à la fréquence choisie et utilise des retards pondérés structurés d'un prédicteur à fréquence plus élevée. Il n'est pas nécessaire d'interpoler toutes les séries sur le même calendrier de lignes.
Q2Régression MIDAS et GARCH-MIDAS sont-ils identiques ?
Non. MIDAS est un cadre de retards pondérés à fréquences mixtes. GARCH-MIDAS associe une composante MIDAS de long terme à une récurrence de variance GARCH de court terme. Il faut examiner les équations pour connaître la cible et les composantes précises.
Q3Une prévision MIDAS de volatilité plus précise constitue-t-elle un signal de trading ?
Non. La prévision porte sur une mesure de dispersion choisie. Une stratégie nécessite une règle distincte de direction ou de risque, des coûts d'exécution réalistes et une évaluation chronologique des rendements nets.
Sources et lectures complémentaires
Signaler un problème
Nous préparons un e-mail avec le lien de cet article. Mark ne reçoit le signalement qu’après son envoi
Vérification rapide
Guide terminé ? Vérifiez vos acquis avec 3 questions
Question 01
Quel est le rôle principal d'une fonction de pondération MIDAS ?
Choisissez une réponse pour voir l'explication
Glossaire des options
A time-series model that updates conditional variance from past squared shocks and prior variance; it models volatility persistence, not return direction.
Lire le guide approfondiRealized volatilityVolatility calculated from price changes that occurred under a stated return, sampling-window, and annualization rule; different conventions can produce different values.
Lire le guide approfondiCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Lire le guide approfondi