

Quandt–Andrews-Test: Sup-Wald-Test bei unbekanntem Bruchdatum
Erfahren Sie, wie der Quandt–Andrews-Sup-Wald-Test einen unbekannten einzelnen Regressionsbruch sucht, warum Trimming wichtig ist und weshalb die Nullverteilung keine gewöhnliche F-Verteilung ist.
In diesem LeitfadenEin unbekanntes Bruchdatum verändert die Fragestellung
Kurze Zusammenfassung
Der Quandt–Andrews-Ansatz prüft, ob die Koeffizienten einer Regression konstant bleiben, wenn ein einzelnes Bruchdatum unbekannt ist. Dazu wird an jedem zulässigen Datum eine Prüfgröße berechnet und anschließend ihr größter Wert verwendet. Da das Datum durch eine Suche ausgewählt wird und unter der Nullhypothese ohne Bruch nicht identifiziert ist, folgt das Maximum nicht der gewöhnlichen F-Verteilung für ein festes Datum.
Ein unbekanntes Bruchdatum verändert die Fragestellung
Ein Chow-Test beantwortet eine klar abgegrenzte Frage: Haben sich die Regressionskoeffizienten an einem Datum geändert, das vor der Auswertung festgelegt wurde? In vielen Finanz- und Makroanwendungen lässt sich ein einziges überzeugendes Datum nicht im Voraus bestimmen. Wer mehrere Daten prüft und das signifikanteste Chow-Ergebnis meldet, macht die Datumsauswahl zum Teil des Tests. Die üblichen kritischen Werte für ein einzelnes Datum berücksichtigen diese Suche dann nicht.
Quandts Zwei-Regime-Verfahren und Andrews’ späterer asymptotischer Rahmen begegnen diesem Problem, indem sie eine Prüfgröße über eine Menge möglicher Bruchdaten auswerten. In der angewandten linearen Regression heißt das Maximum – je nach konkreter Prüfgröße und Kovarianzbehandlung – häufig Quandt-Likelihood-Ratio (QLR), sup-F oder sup-Wald. Andrews entwickelt sup-Wald-, LM- und LR-ähnliche Tests für allgemeinere parametrische Modelle mit unbekanntem Veränderungspunkt (Quandt, 1960; Andrews, 1993).
Der Umfang ist hier bewusst eng gefasst: Geprüft wird eine mögliche Änderung in einer festgelegten Regressionsbeziehung, deren Zeitpunkt unbekannt ist. Der Test schätzt weder eine unbekannte Zahl von Änderungen noch deren Ursache und identifiziert auch keine Handelsgelegenheit. Der Bai–Perron-Leitfaden behandelt das andere Problem, mehrere unbekannte Bruchdaten zu modellieren.
Die Regression mit einem Bruch und die Restriktionen festlegen
Die geordnete Stichprobe enthalte Beobachtungen (t=1,ldots,T), die Zielvariable (y_t) und den Regressorvektor (x_t). Ein reines Ein-Bruch-Modell lautet
yₜ = xₜ′β₁ + uₜ, t ≤ k yₜ = xₜ′β₂ + uₜ, t > k
Dabei ist (k) die letzte Beobachtung des ersten Regimes. Unter der Nullhypothese ohne Bruch sind die getesteten Koeffizientenvektoren gleich, also gilt gemeinsam (H₀: β₁ = β₂). Die Ein-Bruch-Alternative besagt, dass sie sich für mindestens ein zulässiges Datum unterscheiden. In einem partiellen Änderungsmodell darf nur eine vorab festgelegte Teilmenge der Koeffizienten variieren; dadurch ändern sich die Zahl der Restriktionen und die Referenzverteilung. Geben Sie an, welche Koeffizienten sich ändern dürfen.
Die Reihenfolge der Beobachtungen muss ein sinnvolles Bruchdatum ergeben. Bei Tagesrenditen ist (k) normalerweise ein Index der Handelssitzungen und nicht automatisch ein Kalendertag. Fehlende Beobachtungen, Feiertage, nicht synchrone Märkte, Kontraktwechsel und eine Änderung der Zieldefinition können verändern, was „davor“ und „danach“ bedeutet. Legen Sie Stichprobe und Datumsdefinition fest, bevor Sie die ausgewählte Teilung mit einem Ereignis verknüpfen.
Eine Zurückweisung spricht gegen das spezifizierte Modell mit konstanten Koeffizienten und für irgendeine Ein-Bruch-Alternative im durchsuchten Bereich. Sie zeigt weder, dass eine bestimmte Ankündigung den Bruch verursacht hat, noch dass Regressoren exogen sind oder die Koeffizienten nach dem Bruch fortbestehen. Bei falsch spezifiziertem bedingtem Mittelwert, Fehlerdynamik oder Messprozess kann der Test auf diese Fehlspezifikation statt auf eine saubere Parameteränderung reagieren.
Kandidatendaten trimmen und beide Seiten jeder Teilung schätzen
Ein Datum nahe einem Stichprobenende lässt auf einer Seite zu wenige Beobachtungen für eine zuverlässige Schätzung. Ein Trimmanteil (varepsilon) schließt diese Endpunkte aus und beschränkt die Suche auf Bruchanteile (lambda=k/T) in einem vorab festgelegten Intervall, etwa ([varepsilon,1-varepsilon]). Bei diskreten Stichproben wird dieses Intervall in ganzzahlige Daten übersetzt; zugleich müssen in beiden Segmenten genügend Beobachtungen und Regressoren mit vollem Rang verbleiben. Berichten Sie die genaue Konvention, einschließlich der Frage, ob (k) die letzte Beobachtung vor oder die erste nach dem Bruch bezeichnet.
Für jedes zulässige (k) wird das gepoolte Nullmodell sowie das entsprechende Zwei-Regime-Modell geschätzt. Anschließend berechnet man eine Prüfgröße für die Restriktionen zur Koeffizientenänderung. Im klassischen OLS-Fall mit unabhängigen, homoskedastischen Fehlern und gemeinsamer Regressormenge lässt sich diese über die Verringerung der Residuenquadratsumme ausdrücken. Unter normalverteilten Fehlern hat eine Prüfgröße für ein vorab festgelegtes Datum eine exakte F-Referenzverteilung in endlichen Stichproben; ohne Normalität folgt diese exakte Aussage nicht. Eine Wald-Variante bewertet die geschätzte Koeffizientendifferenz anhand ihrer geschätzten Kovarianz. Bei Heteroskedastizität oder serieller Abhängigkeit braucht es eine passende robuste Kovarianz und ein dazu passendes Referenzverfahren. Nur die Standardfehler zu ändern macht den gewöhnlichen F-kritischen Wert nach der Datumsuche nicht gültig.
Trimming ist Teil des Testdesigns und keine kosmetische Einstellung. Stärkeres Trimming verkürzt die Suche und vermeidet sehr kleine Regime, schließt aber größere Brüche nahe den Stichprobenenden aus. Schwächeres Trimming lässt solche Kandidaten zu, macht asymptotische Näherungen und Schätzungen in endlichen Stichproben aber anfälliger. Legen Sie den Bereich anhand von Stichprobengröße, Modelldimension und Forschungsfrage fest, bevor Sie den Höchstwert betrachten.
<!-- learn:illustration -->
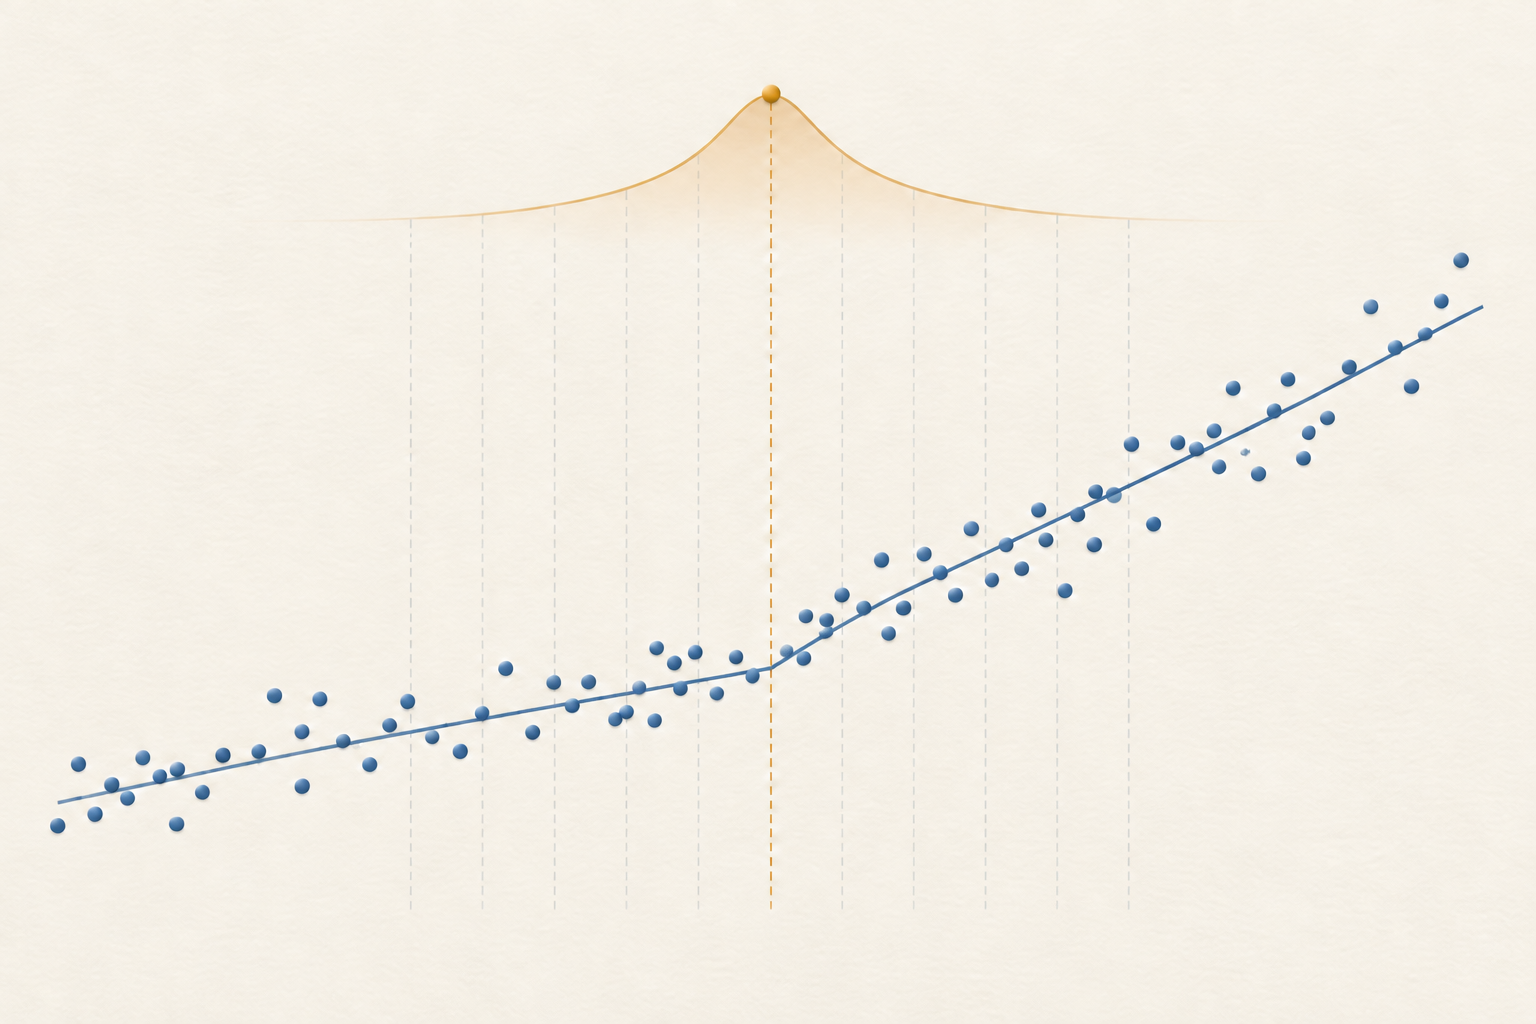
Die Sup-Wald-Statistik ist die größte Prüfgröße über alle Kandidatendaten
Sei (W(k)) für jedes Kandidatendatum (k) die Wald-Statistik der festgelegten Koeffizientenrestriktionen. Die Sup-Wald-Statistik für einen Bruch lautet
supW = max{k ∈ K} W(k)
wobei (K) die getrimmte Menge zulässiger Daten bezeichnet. In der klassischen linearen Regression wird häufig das Maximum der Chow-F-Statistiken über die Kandidatendaten gebildet und als sup-F oder QLR berichtet. Das Maximierungsdatum (hat{k}=argmax_{kin K} W(k)) liefert die größte Statistik in dieser Suche. Es ist eine ausgewählte Schätzung, kein Konfidenzintervall und kein genauer Zeitstempel des wirtschaftlichen Wandels.
Die Bezeichnungen hängen zusammen, sind aber nicht immer austauschbar. Ein konventioneller homoskedastischer Chow-F-Test für ein festes Datum hat unter seinen Annahmen eine exakte F-Referenzverteilung in endlichen Stichproben. Das Maximum über Daten, eine asymptotische Sup-Wald-Statistik mit robuster Kovarianz und eine Likelihood-Ratio-Statistik müssen weder denselben endlichen Stichprobenwert noch dieselben kritischen Werte haben. Berichten Sie die tatsächlich berechnete Statistik, den Kovarianzschätzer, die Trimmregel und die Quelle der kritischen Werte, statt sich allein auf „QLR“ zu verlassen.
Die Kandidatenstatistiken sind stark abhängig, weil benachbarte Teilungen fast dieselben Beobachtungen wiederverwenden. Der Test entspricht weder dem kleinsten p-Wert eines festen Datums noch dessen Multiplikation mit der Zahl der Daten oder voneinander unabhängigen Einzeltests. Die Nullverteilung wird für den Prozess des Maximums unter Berücksichtigung der Suche hergeleitet.
Das Maximum der Suche hat eine nichtstandardmäßige Nullverteilung
Unter der Nullhypothese ohne Bruch gibt es kein tatsächliches Bruchdatum zu schätzen. Der Datumsparameter kommt unter der Alternative vor, verschwindet aber unter der Null. Deshalb gelten die üblichen Regularitätsargumente für einen Wald- oder F-Test mit festem Datum nicht. Das Maximum über Kandidatendaten hat folglich eine nichtstandardmäßige asymptotische Verteilung. Ein Vergleich mit einem Standard-F-kritischen Wert überschätzt im Allgemeinen die Evidenz gegen Stabilität.
Andrews leitet asymptotische Verteilungen und kritische Werte für Sup-Wald-, LM- und LR-ähnliche Tests her; die Trimmgrenzen und die Zahl der getesteten Restriktionen gehen dabei ein (1993). Die passenden Werte hängen außerdem vom Modell und den Kovarianzannahmen ab. Verwenden Sie eine Tabelle, Implementierung oder Näherung, die zum konkreten Test passt; übernehmen Sie keinen kritischen Wert für eine andere Trimmquote oder Restriktionszahl. Andrews veröffentlichte später ein Erratum, weil einige berichtete Sup-Test-kritische Werte für acht Restriktionen zu niedrig waren; für diesen Fall ist daher die korrigierte Tabelle erforderlich (Erratum 2003). Hansen liefert numerische Näherungen für asymptotische p-Werte von Strukturbruchtests (1997).
Andrews und Ploberger leiten zudem Durchschnitts- und Exponentialtests für Störparameter her, die nur unter der Alternative auftreten (1994). Das sind verwandte suchbewusste Verfahren, keine anderen Namen für Sup-Wald. Wenn Sie einen Bootstrap oder eine andere Korrektur für endliche Stichproben verwenden, beschreiben Sie das Resampling so, dass es die Nullstruktur und dieselbe Suche reproduziert. Ein allgemeiner Bootstrap löst weder Datumsselektion noch Abhängigkeit automatisch.
Ein Beispiel mit zwölf Beobachtungen macht Trimming und Maximum nachvollziehbar
Betrachten wir eine bewusst kleine, hypothetische Regression nur mit Achsenabschnitt und den Beobachtungen
y = [0, 1, 1, 1, 1, 1, 3, 3, 3, 3, 3, 3]
Es gibt (T=12) Beobachtungen. Zur Illustration setzen wir (varepsilon=0.25), sodass jedes Segment mindestens drei Beobachtungen enthalten muss und die möglichen letzten Vor-Bruch-Daten (k=3,ldots,9) sind. Das Beispiel zeigt nur die Rechenweise der Suche; es empfiehlt weder diese Trimmquote noch eine Inferenzstichprobe.
Der gepoolte Mittelwert ist (23/12), und die Residuenquadratsumme des gepoolten Modells lautet
RSS₀ = Σ yₜ² − (Σ yₜ)²/12 = 59 − 529/12 = 179/12
Bei (k=6) haben Summe und Quadratsumme des ersten Segments jeweils den Wert 5; seine Residuenquadratsumme beträgt daher (5−5²/6=5/6). Das zweite Segment enthält sechs Werte von 3 und hat somit eine Residuenquadratsumme von null. Folglich ist (RSS₁(6)=5/6). Bei einer Restriktion und zwei geschätzten Segment-Achsenabschnitten ergibt sich für das feste Datum
F(6) = [(RSS₀ − RSS₁(6))/1] / [RSS₁(6)/(12−2)] = 169
Mit derselben Rechnung für alle sieben Kandidaten erhält man für (k=3,ldots,9) näherungsweise die F-Werte (7.21, 12.10, 25.28, 169.00, 20.71, 8.94, 4.59). Der Sup-F-Wert ist somit ihr Maximum 169 bei (k=6). Damit ist nur geprüft, welcher Kandidat in dieser konstruierten Folge den größten Wert erreicht; ein p-Wert ergibt sich nicht. Weil das Datum gesucht wurde, muss 169 mit einem suchbewussten nichtstandardmäßigen kritischen Wert für ein passendes Design verglichen werden, nicht mit der gewöhnlichen F-Verteilung für ein fixes Datum.
Zurückweisung und Nichtzurückweisung im Rahmen des Designs interpretieren
Eine Zurückweisung bedeutet, dass die Null konstanter Koeffizienten beim gewählten Signifikanzniveau, gegeben die Annahmen und kritischen Werte des Tests, nicht zum größten Wert im zulässigen Bereich passt. Sie identifiziert keinen eindeutigen, exakt datierten Bruch. Benachbarte Kandidaten können ähnliche Statistiken aufweisen, und der Höchstwert kann sich ändern, wenn Stichprobenende, Trimming, Regressoren oder Kovarianzverfahren variieren. Berichten Sie daher den Verlauf der Kandidatenstatistiken oder eine geeignete Analyse der Datumsunsicherheit, statt (hat{k}) als exakt darzustellen.
Eine Nichtzurückweisung belegt keine Koeffizientenstabilität. Die Teststärke kann für eine kleine Änderung, eine Änderung nahe einem getrimmten Endpunkt oder eine Änderung in einem nicht getesteten Koeffizienten gering sein. Ein Test auf einen einzelnen Bruch kann außerdem mehrere teilweise gegensätzliche Änderungen übersehen. Umgekehrt können Ausreißer, Varianzänderungen, fehlende Dynamik, eine geänderte Datendefinition oder wiederholte Modellsuche Hinweise auf Instabilität liefern. Der Test beantwortet eine klar begrenzte statistische Frage, nicht die Ursache einer Abweichung.
Das Datum wird mit denselben Daten ausgewählt, die für den Test verwendet werden. Behandeln Sie es nicht wie ein vorab festgelegtes Ereignisdatum, um anschließend mit einem zweiten unbereinigten Signifikanztest eine unabhängige Bestätigung zu behaupten. Wenn das Datum eine Prognoseanpassung oder Handelsregel auslöst, definieren Sie diese Regel konkret und bewerten Sie sie mit späteren Daten. Die In-Sample-Sup-Statistik belegt weder Fortbestand noch wirtschaftlichen Wert nach dem Bruch.
Chow-, CUSUM- und Bai–Perron-Fragen unterscheiden
| Verfahren | Kernfrage | Was es nicht leistet |
|---|---|---|
| Chow-Test | Unterscheiden sich Koeffizienten an einem vorab festgelegten Datum? | Unbekannte Daten suchen und dabei die Referenzverteilung für ein Einzeldatum beibehalten |
| Quandt–Andrews-Sup-Test | Gibt es im getrimmten Bereich Hinweise auf einen Bruch? | Eine unbekannte Zahl von Brüchen wählen oder deren Ursache erklären |
| Regression-CUSUM | Widerspricht ein geordneter Pfad rekursiver Residuen der Koeffizientenstabilität? | Für sich genommen ein ausgewähltes einzelnes Bruchdatum liefern |
| Bai–Perron | Wie viele Brüche und welche Daten werden in einem Mehrfachbruchmodell gestützt? | Spezifikation und Auswahl des Ein-Bruch-Tests ersetzen |
Ein Hidden-Markov- oder Regimewechselmodell stellt wieder eine andere Frage: Lassen sich Beobachtungen mit latenten Zuständen modellieren, die sich wiederholt gemäß Übergangswahrscheinlichkeiten ändern? Ein Test auf einen einzelnen unbekannten Bruch betrachtet eine dauerhafte Vorher-Nachher-Teilung innerhalb seines Suchbereichs. Die Verfahren können sich ergänzen, ihre Annahmen und Ergebnisse sind aber nicht austauschbar. Siehe den Leitfaden zu Regimewechseln.
Die Suche so berichten, dass andere sie reproduzieren können
Geben Sie Zielvariable und Regressoren, reine oder partielle Änderung, getestete Koeffizientenrestriktionen, Stichprobendaten und Reihenfolge sowie die Konvention für das Bruchdatum an. Berichten Sie (T), die Zahl der Restriktionen, den Trimmanteil oder die genaue Kandidatenmenge, die Mindestsegmentgröße und ob Sie Sup-Wald, Sup-F/QLR, Sup-LM oder ein anderes Verfahren verwenden. Nennen Sie außerdem Kovarianzschätzer, Methode für kritischen Wert oder p-Wert und jede Korrektur für endliche Stichproben.
Zeigen Sie die Prüfgröße über die Kandidatendaten und melden Sie das Maximierungsdatum als ausgewählte Position; ergänzen Sie nach Möglichkeit Unsicherheit oder Sensitivität. Erläutern Sie, ob Modell und Testdesign vorab festgelegt waren, wie fehlende Beobachtungen und Echtzeitdaten behandelt wurden und welche weiteren Stichproben oder Regressoren untersucht wurden. Bei Prognoseanwendungen muss die Suche im Trainingsdatensatz bleiben; ein geändertes Modell wird an späteren, unberührten Daten ausgewertet.
Ein statistisch signifikanter Test auf einen unbekannten Bruch identifiziert weder die Ursache eines Ereignisses noch eine profitable Marktphase. Ein nicht signifikantes Ergebnis zertifiziert keine Stabilität. Eine belastbare Schlussfolgerung bleibt auf die spezifizierte Ein-Bruch-Alternative, den getrimmten Zeitraum, die Regression, die Stichprobe und das suchbewusste Inferenzverfahren beschränkt.
Häufige Fragen
Q1Ist der Quandt–Andrews-Test nur ein an vielen Daten wiederholter Chow-Test?
Er berechnet verwandte Statistiken für Kandidatendaten, aber die Inferenz muss das Maximum berücksichtigen. Wer das größte gewöhnliche Chow-Ergebnis mit seinem p-Wert für ein festes Datum meldet, ignoriert die Suche und verwendet im Allgemeinen die falsche Nullverteilung.
Q2Zeigt das Maximierungsdatum, wann ein wirtschaftliches Ereignis den Bruch verursacht hat?
Nein. Es ist das Kandidatendatum mit der größten Statistik in der ausgewählten Stichprobe und dem getrimmten Bereich. Es ist weder ein kausaler Zeitstempel noch ein Konfidenzintervall; benachbarte Daten und andere Designentscheidungen können ähnliche Ergebnisse liefern.
Q3Bedeutet eine Zurückweisung, dass genau ein Bruch auftrat?
Nein. Sie verwirft eine bestimmte Null konstanter Koeffizienten zugunsten irgendeiner Ein-Bruch-Alternative im Suchbereich. Mehrere Änderungen, Ausreißer, Varianzverschiebungen oder eine Fehlspezifikation können ebenfalls Instabilität anzeigen; mehrere Brüche zu schätzen ist eine andere Aufgabe.
Q4Darf ich das Sup-Wald-Maximum mit einer gewöhnlichen F-Tabelle vergleichen?
Im Allgemeinen nicht. Verwenden Sie kritische Werte oder p-Werte, die zu Sup-Statistik, Trimming, Restriktionszahl, Modell und Kovarianzannahmen passen. Die gewöhnliche F-Verteilung gilt unter ihren Annahmen für ein vorab festgelegtes Datum, nicht automatisch für das Suchmaximum. Primärforschung - Quandt, “Tests of the Hypothesis That a Linear Regression System Obeys Two Separate Regimes” (1960) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point” (1993) - Andrews, “Tests for Parameter Instability and Structural Change with Unknown Change Point: A Corrigendum” (2003) - Hansen, “Approximate Asymptotic P Values for Structural-Change Tests” (1997) - Andrews and Ploberger, “Optimal Tests When a Nuisance Parameter Is Present Only Under the Alternative” (1994) - Chow, “Tests of Equality Between Sets of Coefficients in Two Linear Regressions” (1960) - Bai and Perron, “Estimating and Testing Linear Models with Multiple Structural Changes” (1998) - Brown, Durbin, and Evans, “Techniques for Testing the Constancy of Regression Relationships over Time” (1975)
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Was macht der Quandt–Andrews-Sup-Wald-Test bei unbekanntem Bruchdatum?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
A model generating observations from finite discrete latent states with Markov transition probabilities and state-dependent emissions.
Detaillierten Leitfaden lesenam GeldEine Lage, in der der Ausübungspreis einer Option nahe am Marktpreis ihres Basiswerts liegt. Der innere Wert kann gering oder null sein, während wegen verbleibender Zeit und Unsicherheit noch eine Prämie bestehen kann.
Detaillierten Leitfaden lesen