

Bai–Perron-Tests für mehrere Strukturbrüche in Regressionen
Erfahre, wie Bai–Perron-Verfahren eine unbekannte Zahl und Lage von Regressionsbrüchen durchsuchen, wie Trimming und kritische Werte wirken und was sich aus den Schätzungen nicht ableiten lässt.
In diesem LeitfadenWelche Frage ein Test auf mehrere Regressionsbrüche stellt
Kurze Zusammenfassung
Bai–Perron-Verfahren schätzen Regressionsbruchdaten gemeinsam für eine vorgegebene Zahl von Brüchen. Anschließend bewerten Tests oder Modellwahlregeln, wie viele Brüche die Daten stützen. Bruchdaten und Bruchzahl hängen von der Regression, der Mindestsegmentlänge, den Fehlerannahmen und dem Suchverfahren ab; sie erklären weder eine Ursache noch einen Handelsvorteil.
Welche Frage ein Test auf mehrere Regressionsbrüche stellt
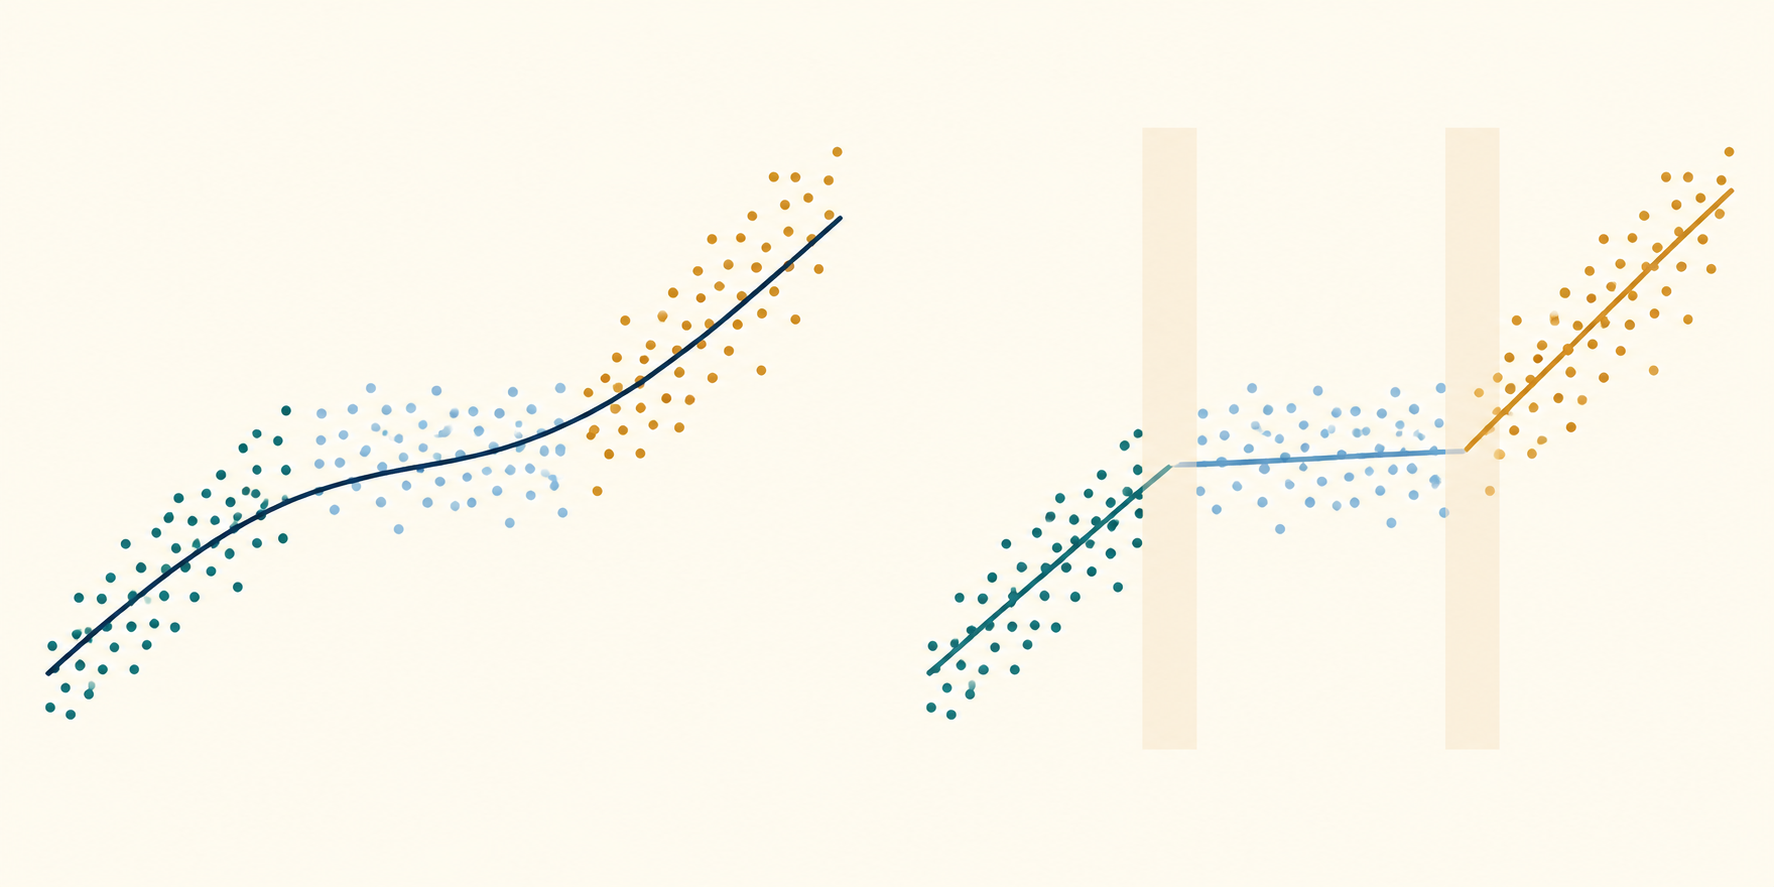
Ein Strukturbruch in einer Regression bedeutet, dass sich ein oder mehrere Koeffizienten an einem unbekannten Punkt der Stichprobe verändert haben könnten. Eine einzige Schätzung über die gesamte Stichprobe kann das verdecken: Ist etwa der Zusammenhang zwischen Rendite und Risiko in einem Zeitraum positiv und später schwächer oder umgekehrt, beschreibt der Durchschnittskoeffizient womöglich keinen der beiden Abschnitte gut. Bai–Perron-Verfahren fassen diese Frage als explizite Suche über mögliche Aufteilungen der Beobachtungen.
Der entscheidende Unterschied zum Chow-Test ist, ob das Datum im Voraus festgelegt wurde. Ein Chow-Test vergleicht Teilstichproben um ein vorgegebenes Datum. Viele Daten auszuprobieren und den größten gewöhnlichen Chow-Statistikwert zu melden, erhält die übliche Referenzverteilung dieses Tests nicht. Bai–Perron-Tests berücksichtigen die Suche über Kandidatendaten und können mehr als einen Bruch untersuchen. Für den Fall eines vorab festgelegten Datums siehe den Leitfaden zum Chow-Test.
Auch vom Regressions-CUSUM ist das Verfahren abzugrenzen. CUSUM untersucht einen zeitlich geordneten Pfad rekursiver Residuen auf Hinweise gegen Stabilität, liefert für sich genommen aber keine ausgewählte Liste mehrerer Bruchdaten. Bai–Perron schätzt stattdessen eine Aufteilung unter einem expliziten abschnittsweisen Regressionsmodell. Keines der Verfahren erklärt, warum sich eine Beziehung verändert hat. Zum Residuenpfad siehe den Leitfaden zum Regressions-CUSUM.
Die Regression mit unbekannten Daten und unbekannter Bruchzahl formulieren
Angenommen, es liegen \(T\) Beobachtungen und \(m\) Brüche an ganzzahligen Daten \(T_1<\cdots<T_m\) vor. Setze \(T_0=0\) und \(T_{m+1}=T\). Segment \(j\) umfasst die Beobachtungen \(T_{j-1}+1,\ldots,T_j\). In einem Modell mit reinem Strukturwandel gilt
\[ y_t=x_t'\beta_j+u_t,\qquad T_{j-1}<t\le T_j,\quad j=1,\ldots,m+1. \]
Dabei ist \(y_t\) die Zielgröße, \(x_t\) der Vektor der enthaltenen Regressoren, \(\beta_j\) der Koeffizientenvektor in Segment \(j\) und \(u_t\) der Fehler. Unbekannt sind nicht nur die Koeffizienten: Sofern sie nicht im Design festgelegt wurden, müssen auch die Bruchdaten und die Zahl \(m\) geschätzt oder ausgewählt werden. Das Modell setzt außerdem eine sinnvolle zeitliche Ordnung der Beobachtungen und einen stabilen Koeffizientenvektor innerhalb jedes Segments voraus.
In einem Finanzbeispiel könnte \(y_t\) eine Portfoliorendite sein und \(x_t\) könnte Marktrendite, Zinsänderung oder ein Volatilitätsmaß enthalten. Ein erkannter Bruch sagt, dass der ausgewählte Ablauf den abschnittsweisen linearen bedingten Mittelwert innerhalb der Stichprobe besser anpasst. Er bedeutet nicht, dass ein benanntes Ereignis den Koeffizienten geändert hat, dass eine erklärende Variable exogen ist oder dass die Beziehung außerhalb der Stichprobe stabil bleibt.
Ein Beobachtungsdatum ist außerdem nicht dasselbe wie ein Kalenderdatum. Bei täglichen Handelssitzungen muss ein Bruch zwischen Sitzung 120 und 121 nicht einem einzigen Kalendertag entsprechen; Feiertage, fehlende Kurse und unregelmäßige Abstände beeinflussen die Zuordnung. Lege die Reihenfolge der Stichprobe und die Berichtsdefinition des Bruchdatums fest, bevor du es als Zeitpunkt eines Ereignisses behandelst.
Reinen oder partiellen Strukturwandel bewusst wählen
In einem Modell mit reinem Strukturwandel darf sich jeder Koeffizient in \(\beta_j\) zwischen Segmenten ändern. Das erlaubt Änderungen des Achsenabschnitts und sämtlicher Steigungen, benötigt aber mehr segmentbezogene Parameter. Bei kurzen Segmenten oder vielen Regressoren können Brüche daher schwer präzise zu schätzen sein. Reiner Wandel ist nur passend, wenn die Fragestellung zulässt, dass sich jede modellierte Beziehung neu einstellt.
In einem Modell mit partiellem Strukturwandel bleiben einige Koeffizienten gemeinsam, während andere sich ändern dürfen. Schreibe beispielsweise \(\beta_j=(\delta',\gamma_j')'\), wobei \(\delta\) für alle Segmente gilt und \(\gamma_j\) segmentbezogen ist. Das kann eine inhaltliche Einschränkung abbilden: etwa einen veränderlichen Achsenabschnitt und eine veränderliche Steigung für politische Exposition, aber einen gemeinsamen Effekt einer Kontrollvariable. Diese Einschränkung verändert sowohl das Anpassungsziel als auch die Referenzverteilung des Tests. Sie sollte begründet und nicht als folgenlose Vereinfachung behandelt werden.
Auch die Berechnung unterscheidet sich. Bei reinem Wandel ist die Residuenquadratsumme (RSS) einer Aufteilung die Summe unabhängiger Segment-RSS-Werte; deshalb kann eine dynamische Programmierung die Aufteilung bei fester Bruchzahl optimieren. Beim partiellen Modell verbinden gemeinsame Koeffizienten alle Segmente. Bai und Perron beschreiben ein iteratives Verfahren: Zunächst werden bei festgehaltenen gemeinsamen Koeffizienten Bruchdaten und veränderliche Koeffizienten geschätzt, danach werden bei gegebener Aufteilung die gemeinsamen Koeffizienten aktualisiert. Die einfache additive Segment-RSS-Rekursion löst dieses eingeschränkte Gesamtproblem nicht allein. Wähle die Spezifikation nach der inhaltlichen oder Prognosefrage und nicht danach, welche Variante mehr Brüche ausweist.
Mindestsegmentlänge festlegen, bevor Kandidatendaten betrachtet werden
Für die Suche braucht jedes Segment eine Mindestzahl an Beobachtungen. Diese Trimmregel verhindert Anpassungen an extrem kurze Intervalle mit instabilen Koeffizienten. Gleichzeitig schließt sie echte Veränderungen aus, die zu nahe am Stichprobenrand oder an einem weiteren Bruch liegen. Die Regel ist Teil des Designs und kein Naturgesetz.
Betrachten wir ein ausdrücklich hypothetisches Beispiel mit \(T=240\) Beobachtungen und einem gewählten Trimming-Anteil von 15 Prozent. Damit beträgt die Mindestsegmentlänge \(h=0{,}15\times240=36\) Beobachtungen. Wenn ein Bruchdatum die letzte Beobachtung des früheren Segments bezeichnet, sind bei einem Bruch die Daten \(36\le T_1\le204\) zulässig. Beide Seiten umfassen dann mindestens 36 Beobachtungen.
Bei zwei Brüchen müssen die zulässigen Datumspaare folgende Bedingungen erfüllen:
\[ 36\le T_1,\qquad T_1+36\le T_2\le204. \]
Somit gilt \(T_1\le168\); \(T_2\) muss mindestens 36 Beobachtungen nach dem ersten Bruch liegen und nach dem zweiten noch 36 Beobachtungen übrig lassen. Das Paar \((72,156)\) ist zulässig: Die drei Segmente enthalten 72, 84 und 84 Beobachtungen. \((80,100)\) ist unzulässig, weil das mittlere Segment nur 20 Beobachtungen umfasst. Bei diesem \(h\) passen höchstens fünf Brüche in 240 Beobachtungen: Sechs Segmente benötigen mindestens \(6\times36=216\) Beobachtungen, sieben dagegen 252.
Der Anteil von 15 Prozent ist hier eine ausdrücklich hypothetische Designwahl und keine Standardempfehlung. Ein höherer Anteil kann kurzlebige Regime und Daten nahe den Stichprobenrändern ausschließen. Ein niedrigerer Anteil lässt kurze Segmente zu, aber möglicherweise fehlen Informationen, um Steigungen und langfristige Kovarianzgrößen zuverlässig zu schätzen. Wähle die Regel anhand von Abtastfrequenz, Regressorzahl, plausibler Regimedauer und Inferenzverfahren. Berichte sie und zeige, wenn inhaltlich sinnvoll, ob sich Schlussfolgerungen bei benachbarten Werten ändern. Bei verzögerten oder fehlenden Beobachtungen können Implementierungen effektive Stichprobengröße und Endpunkte unterschiedlich definieren; dokumentiere daher die tatsächlich verwendete Konvention.
Mit dynamischer Programmierung eine globale Aufteilung bei fester Bruchzahl finden
Bei reinem Strukturwandel und festem \(m\) lässt sich die Suche als Minimierung der gesamten Segment-RSS schreiben:
\[ \min_{T_1,\ldots,T_m}\;\sum_{j=1}^{m+1}\operatorname{SSR}(T_{j-1}+1,T_j), \]
unter den Bedingungen für Reihenfolge und Mindestsegmentlänge. \(\operatorname{SSR}(a,b)\) bezeichnet die kleinste OLS-Residuenquadratsumme eines einzelnen Segments mit Beobachtungen \(a,\ldots,b\). Eine naive Suche prüft jede Kombination von Daten; ihre Anzahl wächst schnell mit \(T\) und \(m\).
Dynamische Programmierung verwendet bereits gelöste Teilprobleme erneut. Sei \(D(r,j)\) die kleinste RSS für eine Aufteilung der Beobachtungen 1 bis \(j\) in \(r\) zulässige Segmente. Eine Form der Rekursion lautet
\[ D(r,j)=\min_i\{D(r-1,i)+\operatorname{SSR}(i+1,j)\}, \]
wobei der trennende Index \(i\) so eingeschränkt ist, dass die ersten \(r-1\) Segmente und das letzte Segment die Mindestlänge erfüllen. Werden die jeweils minimierenden Trennpunkte gespeichert, lassen sich die Daten der Brüche rekonstruieren. Für jede erlaubte Segmentzahl findet das Verfahren eine global RSS-minimale Aufteilung unter Modell und Nebenbedingungen, statt Brüche nacheinander gierig hinzuzufügen. Bai und Perron (2003) entwickeln diese Berechnung und behandeln reine wie partielle Veränderungen.
„Global“ bedeutet hier bedingt auf die gewählte Zahl, Regressoren, deterministische Terme, Trimming und Zielfunktion. Es heißt weder, dass das statistische Modell wahr ist, noch dass die Bruchzahl stimmt oder die Aufteilung über alle denkbaren Spezifikationen optimal ist. Das Verfahren kann mehrere Bruchzahlen effizient vergleichen, aber die Auswahl von \(m\) ist ein eigener Inferenz- oder Modellwahl-Schritt.
Zahl der Brüche mit suchbereinigter Inferenz oder Kriterien auswählen
Nachdem für Kandidatenzahlen optimale Aufteilungen berechnet wurden, gibt es mehrere Wege zur Wahl von \(m\). Ein sequenzieller Test \( \sup F(\ell+1\mid\ell) \) vergleicht ein Modell mit \(\ell\) Brüchen mit einem Modell mit einem zusätzlichen Bruch und verwendet das Supremum über zulässige Daten. Doppelmaximumtests wie UDmax oder WDmax testen die Nullhypothese „keine Brüche“ gegen eine Alternative mit unbekannter Bruchzahl bis zu einem festgelegten Maximum. Informationskriterien, darunter BIC-Varianten, vergleichen Anpassungsverbesserung und Komplexitätsstrafe. Diese Ansätze beantworten verwandte, aber nicht identische Fragen.
Nach der Maximierung über unbekannte Bruchdaten ist der gewöhnliche F-kritische Wert im Allgemeinen nicht passend. Unter der Nullhypothese ohne Brüche sind Kandidatendaten nicht so identifiziert wie unter der Alternative; daraus entstehen nichtstandardmäßige asymptotische Verteilungen. Kritische Werte hängen unter anderem von Trimming, reinem oder partiellem Wandel, Regressoren und Annahmen zur Fehlerkovarianz ab. Bai und Perron (1998) leiten Tests auf mehrere Veränderungen her; ihre spätere Arbeit zu kritischen Werten stellt Werte für verschiedene Trimm- und Modellspezifikationen bereit. Andrews (1993) liefert wichtige Ergebnisse zu Instabilitätstests mit einem unbekannten Bruchpunkt, dessen kritische Werte aber kein Verfahren für mehrere Brüche ersetzen.
Sequenzielle Tests sind gut interpretierbar, doch ihr Ergebnis kann von der Teststärke in jedem Schritt und der vorab gesetzten maximalen Bruchzahl abhängen. Informationskriterien können wegen unterschiedlicher Strafen verschiedene Zahlen auswählen; zudem können alle Kandidatenmodelle nur Näherungen sein. Mehr Brüche bedeuten nicht automatisch eine realistischere Beschreibung: Ein kleiner Anpassungsgewinn kann mit instabilen Segmentkoeffizienten erkauft sein. Berichte Methode, maximale Zahl, Trimming, Testsequenz oder Kriterium und die passenden Annahmen für kritische Werte. Ist die Entscheidung wichtig, zeige Sensitivität, statt eine Auswahl als sicher darzustellen.
Geschätzte Daten als bedingte Schätzungen mit Unsicherheit behandeln
Die minimierenden Daten sind Punktschätzungen unter einem spezifizierten Modell. Berichte sie nicht, als hätte die Stichprobe den exakten Moment einer wirtschaftlichen Veränderung offengelegt. Stichprobenvariation, eine kleine Koeffizientenänderung, nahe beieinanderliegende Brüche, verrauschte Zielgrößen, wenig variierende Regressoren und eine große Mindestsegmentlänge können die Zielfunktion um ihr Minimum abflachen. Dann passen mehrere nahe Aufteilungen fast gleich gut.
Bai und Perron entwickeln unter angegebenen Bedingungen Konfidenzintervalle für Bruchdaten. Diese Intervalle beschreiben Stichprobenunsicherheit der modellierten Bruchdaten, erfassen aber nicht jede Unsicherheit darüber, ob die Regression korrekt spezifiziert ist, welche Variablen einzubeziehen sind, wie viele Brüche vorliegen oder welche Trimmregel gelten sollte. Ist bereits die Bruchzahl unsicher, kann ein enges, bedingt auf eine gewählte Zahl berechnetes Datumsintervall die Gesamtunsicherheit unterschätzen.
Unterscheide in der Berichterstattung die Datumsdefinition, den geschätzten Beobachtungsindex, das zugeordnete Kalenderdatum und das Intervall für jeden Bruch. Sind Intervalle breit oder überlappen sie, beschreibe die Lage als nur schwach eingegrenzt. Wähle nach Betrachtung des Ergebnisses kein Datum aus einem Diagramm und nenne es dann eine unabhängig vorhergesagte Ereigniszeit. Beim Vergleich mit einem bekannten Ereignis ist zu berücksichtigen, ob Ereignis und Zeitfenster erst nach Sichtung der Daten ausgewählt wurden.
Inferenz an serielle Abhängigkeit und veränderliche Varianz anpassen
Die RSS-Aufteilung ist ein Anpassungskriterium; die Gültigkeit von Tests und Konfidenzintervallen hängt von Annahmen über Regressoren und Fehler ab. Finanzregressionen können serielle Korrelation, bedingte Heteroskedastizität, Ausreißer, wechselnde Volatilität, überlappende Renditen und asynchrone Beobachtungen aufweisen. Nehmen Kovarianzschätzer und kritische Werte unabhängige, gleichvariante Fehler an, obwohl Residuen abhängig oder heteroskedastisch sind, kann die ausgewiesene Signifikanz irreführen, selbst wenn die Bruchdaten plausibel aussehen.
Bai–Perron-Arbeiten entwickeln Verfahren unter allgemeineren Bedingungen, darunter Formen von Heteroskedastizität und serieller Abhängigkeit. Trotzdem müssen Kovarianzkorrektur und Referenzwerte zur konkreten Anwendung passen. Ein robuster oder HAC-Kovarianzschätzer behebt weder ausgelassene Dynamik noch endogene Regressoren, einen falsch spezifizierten bedingten Mittelwert oder einen Beobachtungskalender, der unvereinbare Intervalle mischt. Ein robuster Standardfehler allein macht auch die RSS-Zielfunktion nicht zu einem besseren Datenmodell.
Prüfe Residuenabhängigkeit und Varianz innerhalb und zwischen den Kandidatensegmenten. Berichte, ob die Fehlerannahmen segmentbezogene Varianzen, serielle Korrelation oder veränderte Regressorverteilungen zulassen und ob die Theorie des gewählten Tests diese Fälle abdeckt. In sehr kurzen Segmenten ist eine robuste Kovarianzschätzung besonders fragil; Trimming und Modellumfang müssen deshalb gemeinsam geplant werden. Grundlagen zu Regressionsschätzungen und Kovarianzannahmen bietet der Leitfaden zur OLS-Regression.
Bruchanalyse berichten, ohne daraus eine Ursache oder Handelsaussage abzuleiten
Ein reproduzierbarer Bericht nennt Zielvariable, sämtliche Regressoren, Transformationen, Stichprobenzeitraum und Frequenz, Achsenabschnitt und Koeffizientenrestriktionen, reines oder partielles Wandlungsmodell, maximale Kandidatenzahl \(m\), Trimmanteil und Mindestlänge, Datumsdefinition, Optimierungsverfahren sowie Test oder Kriterium zur Wahl von \(m\). Berichte außerdem ausgewählte Bruchzahl, Koeffizienten je Segment, Daten samt Unsicherheitsintervallen, Teststatistiken, Kovarianzbehandlung und Quelle kritischer Werte. Erkläre auch, welche Endpunkte oder Beobachtungen von der Suche ausgeschlossen wurden.
Ein statistisch erkannter Bruch ist ein Hinweis auf Parameterinstabilität in der spezifizierten Regression unter ihren Annahmen. Er identifiziert nicht das Ereignis, das die Veränderung ausgelöst hat, beweist nicht, dass eine bestimmte Nachricht oder politische Maßnahme verantwortlich war, und zeigt nicht, dass Koeffizienten vor und nach dem Bruch fortbestehen. Ein Bruch kann auf eine ausgelassene Variable, geänderte Datendefinition, Volatilitätsepisode, Messproblem oder echte wirtschaftliche Veränderung zurückgehen; der Regressionstest unterscheidet diese Erklärungen nicht.
Im quantitativen Handel nutzt eine Suche über die Gesamtstichprobe Beobachtungen auf beiden Seiten jedes geschätzten Bruchs. So zu handeln, als wäre das ausgewählte Datum in Echtzeit bekannt gewesen, erzeugt Look-ahead-Bias. Bewerte eine vorgeschlagene Regime-Regel chronologisch, schätze sie nur mit zu diesem Zeitpunkt verfügbaren Informationen neu und berücksichtige Geld-Brief-Spanne, Gebühren, Markteinfluss, Finanzierung, Leihe, Umschlag und Latenz. Vergleiche einfache Modelle mit festen Parametern und eine Nicht-Handels-Basislinie; halte tatsächlich spätere Daten zur Validierung zurück. Ein Bruch kann eine Modellprüfung oder Risikoanalyse auslösen, ist aber kein Beleg für Prognosekraft oder einen handelbaren Vorteil.
Bai und Perron (1998) stellen Tests und Schätzverfahren für mehrere Strukturänderungen in linearen Modellen in ihrer Originalarbeit vor. Ihre Arbeit zur Berechnung von 2003 erläutert dynamische Programmierung und partielle Veränderungen; die Arbeit zu kritischen Werten zeigt deren Abhängigkeit vom Design. Andrews' Arbeit zu unbekannten Änderungspunkten bildet eine verwandte Grundlage für einen einzelnen Bruch. Benachbarte Diagnosen sind der vorab datierte Chow-Test und der Regressions-CUSUM-Test.
Häufige Fragen
Q1Liefert Bai–Perron die wahre Zahl der Brüche?
Nein. Das Verfahren schätzt Aufteilungen und bietet Tests oder Kriterien für die Wahl unter mehreren Kandidatenzahlen. Das Ergebnis hängt von Regressionsspezifikation, Trimming, Fehlerannahmen, maximaler Bruchzahl und Auswahlregel ab. Es beweist nicht, dass der Datengenerierungsprozess genau so viele Brüche hatte.
Q2Ist ein Bruchdatum der Tag, an dem ein wirtschaftliches Ereignis die Veränderung verursacht hat?
Nein. Es ist die unter einem angepassten Modell geschätzte Lage einer Parameterinstabilität und unterliegt Stichprobenunsicherheit. Eine Ursache zuzuordnen erfordert zusätzliche Evidenz und ein Design, das konkurrierende Erklärungen ausschließt.
Q3Kann ich direkt anhand der geschätzten Bruchdaten handeln?
Nicht allein anhand einer rückblickenden Schätzung aus der Gesamtstichprobe. Die Suche nutzt auch Beobachtungen nach einem Kandidatenbruch. Eine Live-Regel muss chronologisch mit den damals verfügbaren Informationen, Kosten und späteren Daten geprüft werden; ein erkannter Bruch belegt kein profitables Signal.
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Was bedeutet eine Mindestsegmentregel von 15 Prozent in einem Beispiel mit 240 Beobachtungen?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
A relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Detaillierten Leitfaden lesenMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Detaillierten Leitfaden lesen