

Der Chow-Test auf Strukturbrüche in Regressionen
Erfahren Sie, was der Chow-Test vergleicht, wie seine F-Statistik berechnet wird, warum ein Bruchdatum vorab festgelegt werden muss und welche Annahmen bei Finanzzeitreihen zählen.
In diesem LeitfadenWas der Chow-Test prüft
Kurze Zusammenfassung
Der Chow-Test fragt, ob die Koeffizienten einer Regression in zwei Gruppen gleich sind, die durch ein festgelegtes Bruchdatum getrennt werden. Er vergleicht ein gepooltes Modell, das gleiche Koeffizienten erzwingt, mit getrennten Regressionen für beide Gruppen. Unter seinen Annahmen kann der klassische F-Test die Koeffizientenstabilität verwerfen; er findet weder ein unbekanntes Datum noch erklärt er die Ursache geänderter Koeffizienten oder belegt die Rentabilität einer Handelsregel.
Was der Chow-Test prüft
Eine Regression über eine lange Stichprobe kann eine Veränderung des Zusammenhangs zwischen Ergebnis und Prädiktoren verdecken. Zum Beispiel kann sich das geschätzte Engagement eines Portfolios gegenüber der breiten Marktrendite vor und nach einem Wandel der Marktstruktur unterscheiden. Der Chow-Test übersetzt die Frage in eine gemeinsame Hypothese über die Regressionskoeffizienten auf beiden Seiten eines vorgegebenen Datums.
Angenommen, das Modell enthält k Koeffizienten einschließlich Achsenabschnitt. Die Nullhypothese besagt, dass die Koeffizientenvektoren vor und nach dem Bruch gleich sind; die Alternative, dass mindestens ein geprüfter Koeffizient abweicht. Gregory Chows grundlegender Aufsatz von 1960 formuliert dies als Test auf Gleichheit der Koeffizientensätze zweier linearer Regressionen; siehe Chows Aufsatz.
„Strukturbruch“ steht hier für eine Änderung des bedingten Zusammenhangs, den das gewählte Modell beschreibt. Der Test zeigt weder, dass sich alle Teile des datengenerierenden Prozesses geändert haben, noch ermittelt er eine Ursache. Eine Verwerfung spricht gegen die getestete Stabilitätsrestriktion für die ausgewählte Stichprobe, das Modell und das Datum. Eine Nichtverwerfung beweist keine dauerhafte Stabilität.
Die vermutete Änderung als Koeffizientenrestriktionen formulieren
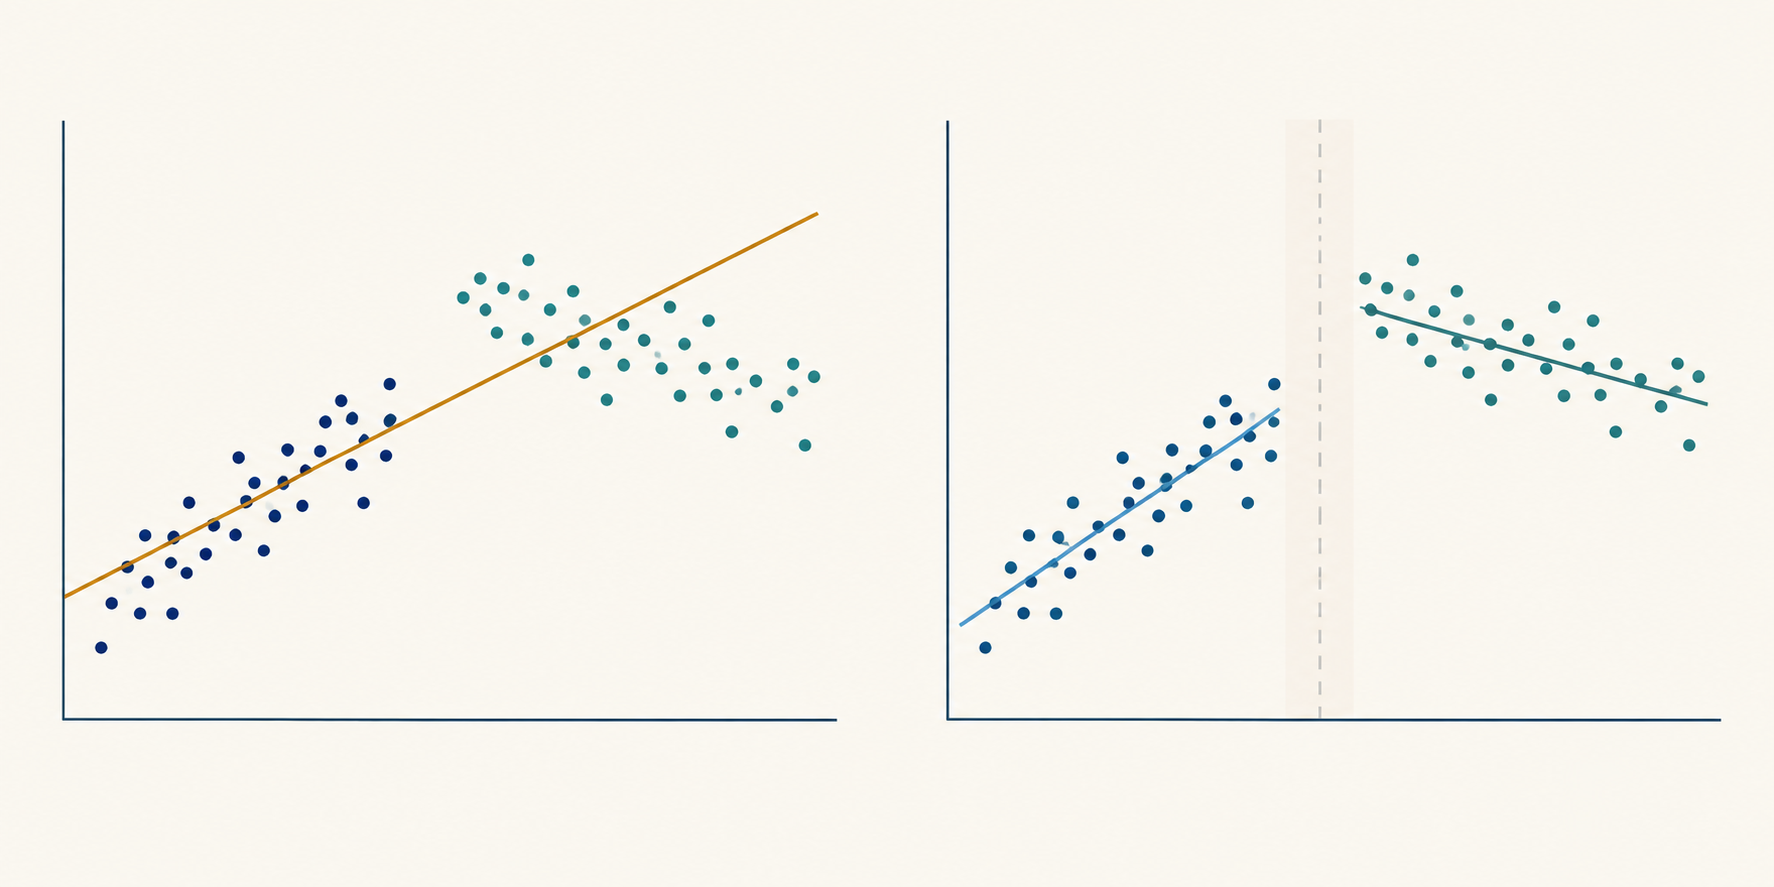
Sei y das Ergebnis und x der Vektor aus Konstante und den enthaltenen erklärenden Variablen. Die gepoolte Regression erzwingt einen Koeffizientenvektor für die gesamte Stichprobe. Um eine Änderung nach dem Datum zuzulassen, setze D vor dem Bruch auf null und danach auf eins und interagiere D mit jedem Regressor: y = x′β + D·x′δ + u. Vor dem Bruch gilt β, danach β + δ.
Die Nullhypothese vollständiger Stabilität lautet H₀: δ = 0. Sie beschränkt gemeinsam die Konstante und alle Steigungen des spezifizierten Modells. Bei einer Konstante und zwei Prädiktoren ist k = 3. Geht es nur um ein Markt-Beta, prüfe nur die Interaktion mit der Marktrendite; mache aus dieser engeren Frage nicht stillschweigend einen Test sämtlicher Koeffizienten.
Die Interaktionsform zeigt, was der Vergleich getrennter Regressionen prüft. Die gepoolte Regression ist das eingeschränkte Modell, in dem die Vor- und Nachbruchkoeffizienten gleichgesetzt sind. Die getrennten Regressionen sind das uneingeschränkte Modell mit unabhängig geschätzten Koeffizientenvektoren. Bei denselben Beobachtungen, Regressoren und Restriktionen prüfen beide Ansätze dieselbe Null vollständiger Gleichheit.
<!-- Illustration placeholder: A text-free conceptual scene showing one cloud of observations split by a clear vertical time boundary, with one shared fitted relationship above and two different fitted relationships below. No words, labels, numeric values, axes text, logos, or interface elements. -->
Das Bruchdatum festlegen, bevor nach einem günstigen Ergebnis gesucht wird
Im klassischen Chow-Ansatz ist das Bruchdatum vorgegeben. Es kann durch eine externe Regeländerung, eine bekannte Vertragsneugestaltung, eine neue Datendefinition oder ein anderes Ereignis begründet sein, dessen Zeitpunkt unabhängig vom Ergebnis feststand. Die Studie sollte zusätzlich festlegen, welcher Gruppe Beobachtungen am Stichtag zugeordnet werden und wie Renditen, Veröffentlichungen und Börsensitzungen abgeglichen werden.
Ein Chow-Test mit festem Datum bildet einen abrupten Bruch ab. Eine angekündigte Regel kann bereits vor dem formellen Start erwartet werden, eine Einführung kann schrittweise erfolgen oder sich die Handelsbedingungen können mehrfach ändern. Unterscheide Ankündigungs-, Inkrafttretens- und tatsächliches Umsetzungsdatum anhand des Mechanismus, der den gemessenen Zusammenhang verändern könnte. Ist eine allmähliche Reaktion Teil der vorab festgelegten Frage, kann eine Rampe oder eine verteilte Interaktion besser passen als ein einzelner Stufenindikator. Wird diese Form erst nach dem Vergleich der kleinsten p-Werte gewählt, entsteht eine weitere Suche.
Wer viele Daten prüft und das Datum mit der größten F-Statistik meldet, wählt die Statistik anhand der Daten aus. Die gewöhnliche F-Referenzverteilung für ein einzelnes festes Datum berücksichtigt diese Auswahl nicht. Dieselbe Gefahr besteht beim Test über viele Vermögenswerte, Ergebnisse, Stichprobenfenster oder Prädiktorsätze: Das auffälligste Ergebnis kann teilweise auf die Suche zurückgehen.
Ist der Wendepunkt unbekannt, verwende ein dafür entwickeltes Verfahren. Andrews’ Arbeit zur Parameterinstabilität bei unbekanntem Wechselpunkt zeigt, dass die resultierende Nullverteilung nicht standardmäßig ist; die kritischen Werte entsprechen nicht einfach dem üblichen Chow-F-Schwellenwert für ein festes Datum. Für mehrere unbekannte Brüche entwickeln Bai und Perron Verfahren zum Testen und Schätzen mehrerer Bruchdaten. Auch diese Methoden haben eigene Annahmen und Trimm-Entscheidungen und sind keine automatische Lösung für jede Zeitreihe. Siehe Andrews (1993) und Bai und Perron (1998).
Die klassische F-Statistik berechnen
Schätze eine gepoolte Regression und notiere ihre Residuenquadratsumme SSRₚ. Schätze dann je eine Regression vor und nach dem Datum und notiere SSR₁ sowie SSR₂. Wenn der gesamte Koeffizientenvektor variieren darf, lautet die klassische Statistik F = [(SSRₚ − SSR₁ − SSR₂) / k] ÷ [(SSR₁ + SSR₂) / (n₁ + n₂ − 2k)]. n₁ und n₂ sind die Beobachtungszahlen der Gruppen; k bezeichnet die je Gruppe geschätzten Koeffizienten einschließlich Konstante.
Der Zähler misst den zusätzlichen quadrierten Fehler der gepoolten Regression durch k Gleichheitsrestriktionen, geteilt durch deren Anzahl. Der Nenner schätzt die gemeinsame Residualvarianz anhand der Residualfreiheitsgrade des geteilten Modells. Die Referenzverteilung ist F mit k Zählerfreiheitsgraden und n₁ + n₂ − 2k Nennerfreiheitsgraden. Jede getrennte Regression benötigt genügend unabhängige Information für ihre k Koeffizienten; bei unzureichendem Rang der Designmatrix ist der Vergleich nicht brauchbar.
Die Formel prüft alle k Koeffizienten gemeinsam unter den klassischen Bedingungen des linearen Modells, darunter unabhängige, normalverteilte Fehler mit gleicher Varianz in beiden Gruppen. Werden nur q Restriktionen getestet, nutze einen gültigen gemeinsamen F-Test zwischen eingeschränktem und uneingeschränktem Modell mit q Zählerfreiheitsgraden. Ersetze q nicht in der vollständigen SSR-Formel, während die Modelle unverändert bleiben. Bei einem Interaktionsdesign ist ein gemeinsamer Wald-Test die allgemeinere Formulierung dieser Restriktionen.
Ein hypothetisches Finanzbeispiel durchrechnen
Angenommen, eine Untersuchung fragt, ob sich der Zusammenhang zwischen wöchentlichen Portfoliorenditen, einem Marktfaktor und einem zweiten Risikofaktor nach einem vorab festgelegten Datum geändert hat, das auf eine hypothetische Börsenregeländerung zurückgeht. Das Modell hat eine Konstante und zwei Steigungen, also k = 3. Es gibt n₁ = 80 Beobachtungen davor und n₂ = 100 danach. Alle Zahlen sind erfunden und keine Marktschätzungen.
Angenommen, die gepoolte Regression hat SSRₚ = 360 quadrierte Basispunkte, die getrennten Regressionen SSR₁ = 130 und SSR₂ = 150. Der Anstieg durch die gemeinsame Koeffizientenrestriktion beträgt 360 − 130 − 150 = 80; der Zähler ist 80 / 3 = 26,67. Die Residualfreiheitsgrade des geteilten Modells betragen 80 + 100 − 2 × 3 = 174, der Nenner somit 280 / 174 ≈ 1,609. Daraus folgt F(3, 174) ≈ 16,57; der konventionelle obere p-Wert liegt unter den genannten klassischen Annahmen bei etwa 1,6 × 10⁻⁹. Der 5-%-kritische Wert liegt bei rund 2,66, also verwirft diese hypothetische Rechnung vollständige Koeffizientenstabilität.
Die Schlussfolgerung ist bewusst eng: Bei geeignetem Modell und passenden Fehlerannahmen unterscheidet sich mindestens ein Koeffizient zwischen den Stichproben. Die Statistik zeigt nicht, ob das Markt-Beta gestiegen oder gefallen ist; dafür sind Schätzwerte und ihre Unsicherheit zu prüfen. Sie belegt weder, dass die Regeländerung den Unterschied verursacht hat, noch sagt sie allein etwas über erwartete Renditen danach, umsetzbare Prognosen oder die Nettoperformance einer Strategie aus.
Interpretieren, welcher Zusammenhang sich geändert hat
Eine Verschiebung des Achsenabschnitts kann bedeuten, dass sich der bedingte Mittelwert von y nach Kontrolle der enthaltenen Prädiktoren verändert hat. Eine veränderte Steigung kann auf eine andere geschätzte Reaktion des Ergebnisses auf einen Prädiktor hinweisen. Der vollständige Chow-Test kombiniert beide Möglichkeiten. Eine Verwerfung spricht gegen die Gleichheit des geprüften Koeffizientenvektors; welcher Koeffizient verantwortlich ist, lässt sich erst durch Schätzwerte und weitere korrekt spezifizierte Restriktionen untersuchen.
Einzelne Koeffiziententests ersetzen den gemeinsamen Test nicht. Mehrere kleine Verschiebungen können gemeinsam mit der Gleichheit unvereinbar sein, selbst wenn kein einzelner Test eindeutig ausfällt. Umgekehrt kann ein signifikanter Einzelkoeffizient nach Durchsicht vieler möglicher Terme ein Ergebnis multipler Tests sein. Formuliere zuerst die gemeinsame Hypothese und berichte anschließend Schätzungen, Konfidenzintervalle und wirtschaftlich sinnvolle Kontraste, die die Frage beantworten.
Ein Chow-Test unterscheidet sich auch von einer unterbrochenen Zeitreihenanalyse. Diese modelliert den Verlauf vor einer Intervention und schätzt Niveau- und/oder Trendänderungen gegenüber diesem Verlauf. Chow fragt, ob festgelegte Regressionskoeffizienten zwischen Gruppen gleich sind; allein konstruiert der Test kein Interventionskontrafaktum. Ein Bruch nahe einem Ereignis kann auch auf einen gleichzeitigen Schock, eine andere Stichprobenzusammensetzung oder eine überarbeitete Messung zurückgehen. Der Leitfaden zu unterbrochenen Zeitreihen behandelt Interventionsverläufe; eine Koeffizientendifferenz allein identifiziert keine Kausalität.
Eine methodische Übersicht zu unterbrochenen Zeitreihen bietet die Arbeit von Bernal, Cummins und Gasparrini.
Fehlerannahmen bei Finanzzeitreihen prüfen
Die einfache Chow-F-Referenz kann irreführen, wenn die Fehler seriell korreliert, heteroskedastisch oder anderweitig mit der Annahme gemeinsamer Varianz unvereinbar sind. Finanzrenditen haben oft eine wechselnde bedingte Varianz; benachbarte Beobachtungen können Informationen oder Schocks teilen, und Beobachtungen um Börsenschließungen sind nicht unbedingt wie gewöhnliche benachbarte Sitzungen zu verstehen. Ein plausibler sichtbarer Bruch bestätigt die klassischen Fehlerannahmen nicht.
Unterscheide eine Änderung der bedingten Mittelwertbeziehung von einer Änderung der Residualvarianz. Bleiben die Steigungen stabil, während sich die Fehlervarianz zwischen Regimen unterscheidet, ist die Annahme gleicher Varianz verletzt; die klassische Statistik auf Basis getrennter SSR kann dann aus dem falschen Grund wie ein Beleg für Koeffizienteninstabilität aussehen. Umgekehrt verändert ein robuster Kovarianzschätzer die Unsicherheitsberechnung, testet aber nicht selbst die Koeffizientenstabilität. Prüfe Interaktionsrestriktionen und Residualskala als getrennte Diagnosefragen.
Eine Möglichkeit besteht darin, die Änderung mit Interaktionen in einer gepoolten Regression auszudrücken und die gewählten Koeffizientenrestriktionen mit einem passenden Kovarianzschätzer zu prüfen. Whites heteroskedastizitätskonsistente Kovarianz behandelt ein anderes Varianzmuster als die klassische Formel; der HAC-Schätzer von Newey und West erlaubt unter seinen Bedingungen Heteroskedastizität und Autokorrelation. Beide erhalten nicht die exakte klassische F-Verteilung in kleinen Stichproben. Der robuste Wald-Test beruht meist auf asymptotischer Approximation; Verzögerungs- und Bandbreitenwahl müssen begründet werden. Siehe White und Newey–West.
Ein robuster Kovarianzschätzer behebt keine ausgelassenen Prädiktoren, eine ungeeignete Funktionsform, endogene Regressoren, ein anhand derselben Ergebnisreihe ausgewähltes Bruchdatum oder zu wenige Beobachtungen in einem Regime. Prüfe Residualabhängigkeit, Varianzänderungen, einflussreiche Beobachtungen und die Robustheit gegenüber vertretbaren Zeitfenstern. Sind abhängige Variable oder Regressoren nicht stationär, kläre zunächst, was die Regression darstellt, bevor du einen signifikanten Bruchtest als aussagekräftigen Beleg für einen stabilen Zusammenhang wertest.
Den Test berichten, ohne daraus eine Handelsbehauptung zu machen
Ein reproduzierbarer Bericht nennt Ergebnisvariable, Prädiktoren, Transformationen, Stichprobenfrequenz, Beobachtungszahlen beiderseits des Datums, die genaue Datumsregel und alle Koeffizientenrestriktionen. Für die klassische Berechnung gehören gepoolte und getrennte SSR, k, Freiheitsgrade, F-Statistik, p-Wert und Fehlerannahmen dazu. Bei einem robusten Interaktionstest sind Kovarianzschätzer, Abstimmungsparameter und die verwendete Referenzverteilung – endlich oder asymptotisch – anzugeben.
Zeige die Vor- und Nachbruchschätzungen samt Unsicherheit statt nur des Verwerfungsentscheids. Erläutere, ob der Unterschied wirtschaftlich relevant ist, bei vertretbaren alternativen Fenstern und Prädiktordefinitionen bestehen bleibt und ob das Datum vorab festgelegt oder gesucht wurde. Ein Koeffizientenbruch kann eine Modellprüfung, Neuschätzung oder Überwachungsregel nahelegen, beweist aber weder, dass eine Handelsstrategie geändert werden sollte, noch dass eine neue funktionieren wird.
Bei Prognose- oder Handelsanwendungen darf die Reaktion nur mit Informationen bewertet werden, die zum jeweiligen historischen Entscheidungszeitpunkt verfügbar waren. Vergleiche Prognosen oder Portfolioergebnisse außerhalb der Stichprobe mit einer klaren Benchmark und berücksichtige Umschlag, Spreads, Gebühren, gegebenenfalls Finanzierung und Kapazitätsgrenzen. Ein signifikanter In-Sample-Bruch ist eine Diagnose der Modellstabilität, kein Beleg für künftiges Alpha. Zur Interpretation von Regressionskoeffizienten siehe den OLS-Leitfaden, zu abhängigen Fehlern den Leitfaden zu robusten Standardfehlern.
Häufige Fragen
Q1Findet der Chow-Test das Bruchdatum?
Nein. Der grundlegende Test bewertet ein vorgegebenes Datum. Für ein unbekanntes Datum ist ein Verfahren nötig, das die Suche berücksichtigt und passende kritische Werte verwendet.
Q2Beweist ein signifikanter Chow-Test, dass ein Ereignis eine Marktbeziehung verändert hat?
Nein. Er verwirft eine Koeffizientengleichheitsrestriktion für das gewählte Modell und die Stichproben. Ein anderes Ereignis, eine Messänderung oder eine veränderte Zusammensetzung kann den Unterschied erklären.
Q3Kann ich die Standardformel des Chow-F-Tests auf tägliche Finanzrenditen anwenden?
Nur wenn die Fehlerannahmen des Modells vertretbar sind. Serielle Abhängigkeit oder wechselnde Varianz können die gewöhnliche F-Referenz unzuverlässig machen. Ein robuster Wald-Test mit Interaktionen kann besser passen, hat aber eigene Bedingungen und löst weder Fehlspezifikation noch die Auswahl des Datums.
Quellen und weiterführende Lektüre
Problem melden
Wir bereiten eine E-Mail mit dem Link zu diesem Artikel vor. Mark erhält den Hinweis erst nach dem Senden
Schnelltest
Fertig gelesen? Prüfe dich mit 3 Fragen
Frage 01
Wie lautet die Nullhypothese für alle Koeffizienten in einem Chow-Test mit festem Datum?
Wähle eine Antwort, um die Erklärung zu sehen
Optionsglossar
Variation in the conditional error variance across regressor values or states, invalidating an equal-variance covariance formula.
Detaillierten Leitfaden lesenMulticollinearityStrong linear dependence among included regressors that makes their separate coefficients imprecise and sensitive to the sample.
Detaillierten Leitfaden lesenCausationA relationship describing how an outcome would differ under a specified intervention or counterfactual change; observed association alone does not identify it.
Detaillierten Leitfaden lesen