

ব্যাকটেস্ট ওভারফিটিংয়ের সম্ভাবনা (PBO) ও CSCV ব্যাখ্যা
Combinatorially symmetric cross-validation কীভাবে PBO অনুমান করে, OOS rank কীভাবে logit হয় এবং কেন এটি ভবিষ্যৎ ক্ষতির পূর্বাভাস নয়—জানুন
এই গাইডেPBO একক কৌশল নয়, নির্বাচন প্রক্রিয়া মাপে
সংক্ষিপ্ত সারাংশ
Probability of backtest overfitting (PBO) জিজ্ঞেস করে, ইন-স্যাম্পলে (IS) সেরা নির্বাচিত কৌশলটি আউট-অফ-স্যাম্পলে (OOS) প্রার্থীসমষ্টির median-এর নিচে কতবার rank করে। Combinatorially symmetric cross-validation (CSCV) সমান আকারের সময়-ব্লকের অর্ধেক নির্বাচন এবং বাকি অর্ধেক মূল্যায়নে দিয়ে এই হার অনুমান করে। PBO নির্দিষ্ট search, score ও ঐতিহাসিক performance matrix-এর ওপর শর্তাধীন একটি diagnostic; live strategy-তে ক্ষতি হওয়ার সম্ভাবনা নয়।
PBO একক কৌশল নয়, নির্বাচন প্রক্রিয়া মাপে
একটি গবেষক দল বিভিন্ন lookback, entry threshold, holding period, universe, cost assumption ও portfolio constraint পরীক্ষা করে সর্বোচ্চ backtest score-ওয়ালা সংস্করণটি রাখতে পারে। নির্বাচিত ফলটি sample-এর বিশেষ বৈশিষ্ট্যের সঙ্গে মানিয়ে নেওয়ার অনেক সুযোগ পেয়েছে। নির্ধারিত IS/OOS ভাগে IS winner একই candidate set-এর OOS median-এর নিচে কতবার যায়—PBO সেই search-এর একটি ফল সংক্ষেপে জানায়।
Bailey, Borwein, López de Prado এবং Zhu কৌশল নির্বাচনের ঝুঁকি বোঝাতে PBO framework দেন এবং এটি অনুমানের একটি পদ্ধতি হিসেবে CSCV প্রস্তাব করেন। সংজ্ঞাটি পরীক্ষিত configuration-গুলোর মধ্য থেকে বেছে নেওয়ার পদ্ধতি নিয়ে; একটি forecast equation-এ বেশি parameter আছে কি না, শুধু তা নয়। প্রতিটি ভাগে IS হলো candidate বাছতে ব্যবহৃত subset; অন্তর্নিহিত প্রতিটি model যে সময়ে fit করা হয়েছিল, তার সঙ্গে এটি এক হওয়া বাধ্যতামূলক নয়। আনুষ্ঠানিক রূপটি দেখুন PBO-এর মূল গবেষণাপত্রে।
একটি কৌশলের পূর্ণ sample-এ Sharpe ratio বেশি হলেও সেটি দুর্বল গবেষণা-পরিবারের সবচেয়ে ভাগ্যবান সদস্য হতে পারে। আবার selection process প্রায়ই OOS median-এর ওপরে candidate বেছে নিতে পারে, যদিও পুরো candidate group-এর return নেতিবাচক। PBO জমা দেওয়া candidate-দের আপেক্ষিক rank তুলনা করে; একা এটি expected return ইতিবাচক কি না যাচাই করে না।
PBO অন্য validation tool-এর চেয়ে আলাদা প্রশ্নের উত্তর দেয়
Chronological holdout বা walk-forward test দেখে, আগে সিদ্ধান্তে ব্যবহার না করা পরবর্তী observation-এ নির্ধারিত research process কেমন করত। Purged cross-validation training label interval ও test outcome-এর overlap সামলায়; প্রয়োজনমতো embargo আলাদা যুক্তিসহ buffer দিতে পারে। কিন্তু এদের কোনোটিই একা বড় strategy search-এর winner OOS candidate median-এর নিচে কতবার নামে তা মাপে না। দেখুন purged cross-validation ও embargo guide।
PBO multiple-testing adjustment-ও নয়। White’s Reality Check bootstrap framework-এ data snooping বিবেচনায় নিয়ে family-র সেরা rule benchmark-কে ছাড়ায় কি না পরীক্ষা করে। Deflated Sharpe Ratio selection effect ও non-normal return বিবেচনা করে Sharpe-ভিত্তিক significance calculation সমন্বয় করে। PBO ভাগগুলোর ওপর IS নির্বাচিত candidate-এর OOS rank সংক্ষেপ করে। তাদের statistic ও assumption আলাদা, তাই একে অন্যের বিকল্প নয়। দেখুন White-এর মূল Reality Check গবেষণাপত্র এবং Bailey ও López de Prado-র Deflated Sharpe Ratio গবেষণা।
সম্পূর্ণ ও synchronized performance matrix দিয়ে শুরু করুন
M-কে T সারি ও N কলামের matrix ধরা যাক। Nটি কলাম candidate strategy বা configuration, আর Tটি সারি সব candidate-এর জন্য একই observation interval বোঝায়। একটি সারিতে প্রাসঙ্গিক trading cost-এর পর daily return থাকতে পারে। candidate-দের trade frequency আলাদা হলে আগে common time index ঠিক করে performance একই নিয়মে aggregate করুন। একটির daily return-এর পাশে অন্যটির monthly total বসালে অর্থবহ row-by-row comparison হয় না।
candidate set-এ বাস্তব selection opportunity প্রতিফলিত হওয়া চাই: grid search-এ বাদ পড়া variant, ফল দেখার পর manual change, বিকল্প universe এবং চূড়ান্ত পছন্দে প্রভাব ফেলা rule-ও রাখুন। PBO কেবল দেওয়া candidate ও তাদের history-ই পরীক্ষা করতে পারে। অনেক বড় search-এর পর শুধু finalist রাখা হলে estimate আসল search-এর ব্যাপ্তি কম দেখাবে।
সব candidate-এর জন্য return convention, currency, leverage treatment ও performance criterion একই রাখুন। Net Sharpe দিয়ে নির্বাচন করলে প্রতিটি column-এ প্রাসঙ্গিক fee, spread, financing, funding, borrow ও execution assumption বসিয়ে তারপর Sharpe হিসাব করুন। পরের subset-গুলোতেও metric হিসাব করা সম্ভব হতে হবে। মূল গবেষণাপত্র synchronized row ও প্রতিটি subsample-এ metric estimate করার শর্ত দেয়; trade frequency ভিন্ন হলে common index-এ series মেলাতে বলে।
CSCV প্রতিটি অর্ধ-নমুনাকে তার complement-এর সঙ্গে জোড়ে
সমান আকারের, overlap-হীন সময়ের block-এর একটি জোড় সংখ্যা S বেছে নিন এবং প্রতিটি block-এর ভেতরে সময়ের ক্রম বজায় রাখুন। S/2 block-এর প্রতিটি সম্ভাব্য নির্বাচন মিলে in-sample (IS) set; বাকি S/2 হলো out-of-sample (OOS)। Path-dependent metric হলে নির্বাচিত block-গুলোকে আসল ক্রমে রাখুন এবং জোড়ার ফল metric-এ কী বোঝায় তা নথিভুক্ত করুন।
IS assignment-এর সংখ্যা C(S,S/2)। A, B, C, D চারটি block হলে ছয়টি assignment: AB, AC, AD, BC, BD ও CD; প্রতিটির complement-ও আলাদা assignment হিসেবে থাকে। S = 16 হলে C(16,8) = 12,870। এগুলো একই history-র deterministic combination, 12,870টি স্বাধীন market experiment নয়।
“Symmetric” মানে একটি combination-এর complement অন্য combination-এ selection set হিসেবে ফের ব্যবহৃত হয়: একবার AB হলো IS, CD OOS; আরেকবার উল্টো। “Combinatorial” মানে একটি random split নেওয়ার বদলে অর্ধেক block বেছে নেওয়ার সব উপায় enumerate করা। এটি chronological replay নয়। নির্বাচিত set-এ শুরুর ও শেষের block একসঙ্গে থাকতে পারে, আর complement-এ মাঝের block থাকতে পারে। তাই OOS মানেই “training-এর পরের ভবিষ্যৎ” নয়।
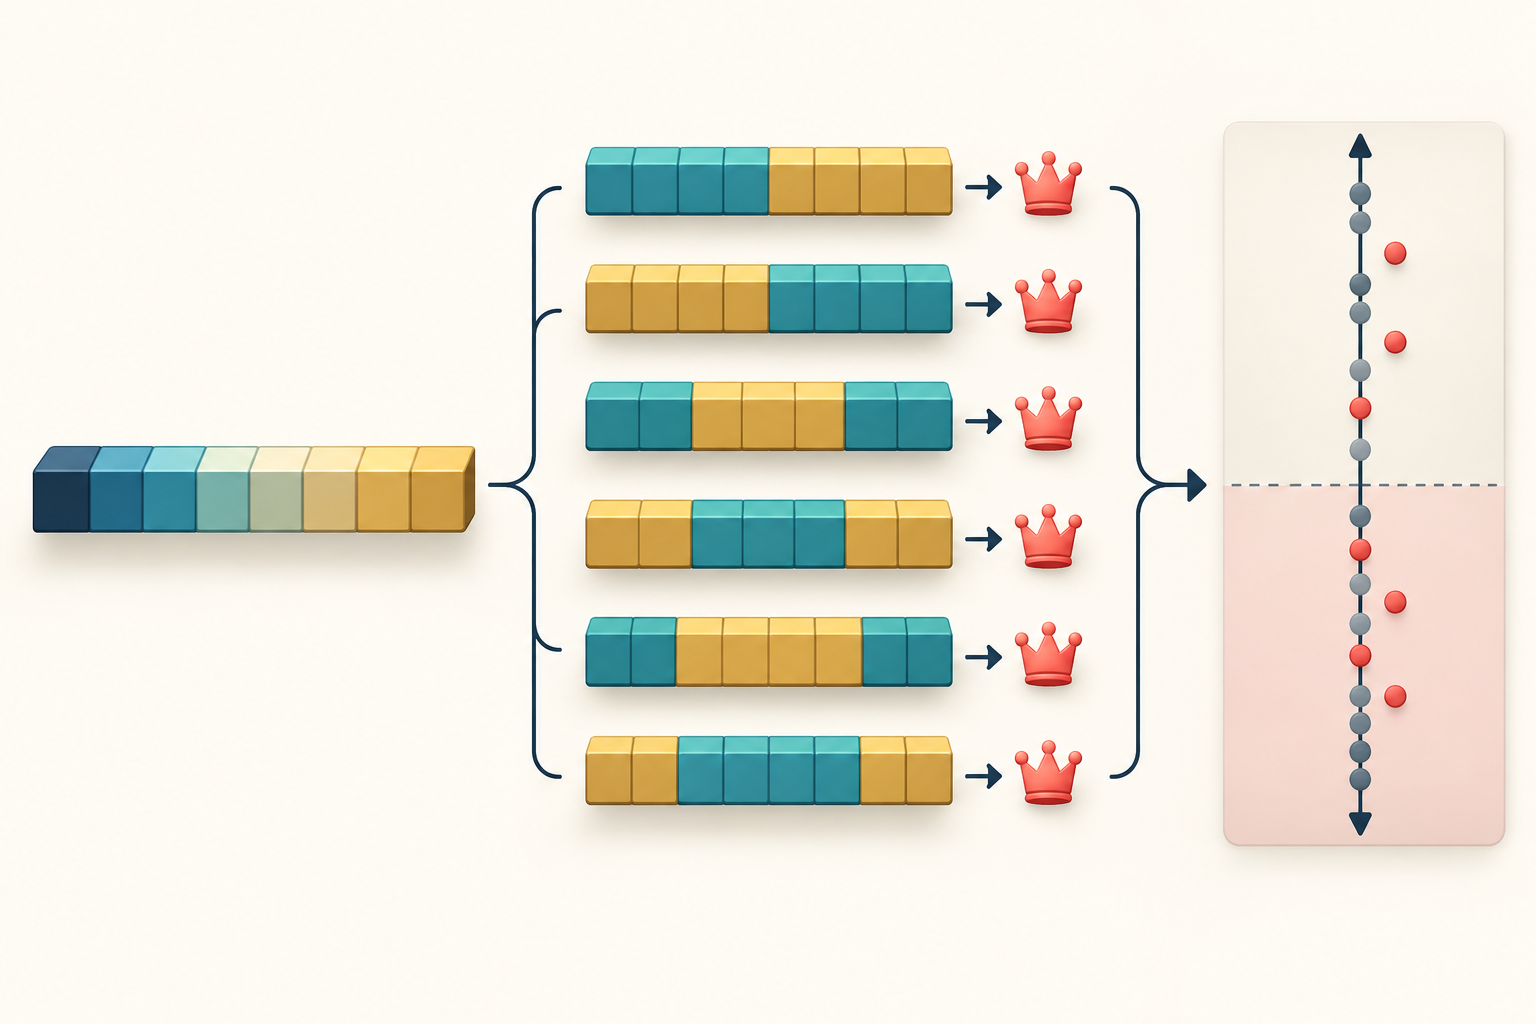
নির্বাচিত candidate-এর OOS rank-কে logit-এ রূপান্তর করুন
প্রতিটি split c-তে IS subset-এ গবেষণার selection rule চালিয়ে সেরা candidate n*(c) বেছে নিন। এরপর একই performance metric দিয়ে complement OOS-এ সব N candidate score করুন। নির্বাচিত candidate-এর OOS rank r(c) নির্ধারণ করুন: 1 সবচেয়ে খারাপ, N সবচেয়ে ভালো। tie কীভাবে সামলাবেন তা আগে ঠিক করে সব split-এ একই রাখুন।
আপেক্ষিক rank হলো ω(c) = r(c)/(N+1)। N+1 দিয়ে ভাগ করায় সর্বনিম্ন ও সর্বোচ্চ rank-ও শূন্য বা এক হয় না। logit: λ(c) = ln(ω(c)/(1−ω(c)))। নির্বাচিত candidate OOS median-এর নিচে থাকলে এটি negative, median-এ zero এবং ওপরে positive। সব CSCV assignment-এর মধ্যে λ(c) ≤ 0 হওয়ার অনুপাতই estimated PBO।
একটি scalar PBO বলে, IS winner কতবার OOS median পর্যন্ত বা তার নিচে নামে। পুরো logit distribution দেখায় নির্বাচিত candidate-রা সাধারণত মাঝামাঝি থাকে, প্রায়ই অনেক নিচে নামে, নাকি ওপরে rank করে। logit আপেক্ষিক rank-এর রূপান্তর; এটি কোনো live trade-এর probability বা ভবিষ্যৎ return-এর calibrated forecast নয়।
চারটি block-এর কাল্পনিক উদাহরণে PBO 66.7%
ধরা যাক, চারটি সমান ঐতিহাসিক block ও R1–R4 নামে চার candidate rule আছে। নিচের টেবিলে ছয়টি IS assignment দেখানো হয়েছে। “OOS rank” হলো ঐ IS subset-এ নির্বাচিত rule-টি complement block-এ চার rule-এর মধ্যে কোথায় আছে। সব মান কাল্পনিক, শুধু হিসাব বোঝানোর জন্য।
| IS block | IS winner | OOS rank r | Relative rank ω = r/5 | Logit ln(ω/(1−ω)) | Median বা তার নিচে? |
|---|---|---|---|---|---|
| AB | R1 | 1 | 0.20 | −1.386 | হ্যাঁ |
| AC | R3 | 4 | 0.80 | +1.386 | না |
| AD | R2 | 2 | 0.40 | −0.405 | হ্যাঁ |
| BC | R1 | 1 | 0.20 | −1.386 | হ্যাঁ |
| BD | R4 | 3 | 0.60 | +0.405 | না |
| CD | R3 | 2 | 0.40 | −0.405 | হ্যাঁ |
ছয়টির মধ্যে চারটি নির্বাচিত rule-এর OOS relative rank অর্ধেকের বেশি নয়। তাই empirical PBO = 4/6 ≈ 0.667, অর্থাৎ প্রায় 66.7%। যেমন rank 2 হলে ω = 2/(4+1) = 0.4 এবং λ = ln(0.4/0.6) ≈ −0.405। Rank 3-এ ω = 0.6 এবং বিপরীত চিহ্নের logit প্রায় +0.405।
এর অর্থ আগামী মাসে 66.7% সম্ভাবনায় টাকা হারাবেন, তা নয়। এই কাল্পনিক matrix ও rank convention-এ IS winner ছয় ভাগের চার ভাগে OOS candidate median-এ বা তার নিচে ছিল। বাকি দুই winner-ও absolute OOS return-এ লোকসান করতে পারে, যদিও peer-দের চেয়ে ওপরে rank করেছে।
PBO-কে শর্তাধীন ও সীমাবদ্ধ diagnostic হিসেবে দেখুন
PBO নির্ভর করে candidate family, দেখা performance matrix, selection metric, time block ও tie rule-এর ওপর। নথিভুক্ত না হওয়া পরীক্ষা এর আওতার বাইরে। “Model-free” মানে forecast equation না জেনেও candidate performance history দিয়ে হিসাব সম্ভব; design choice, data quality বা assumption থেকে মুক্ত—এমন নয়।
CSCV সমান আকারের symmetric subset বানালেও OOS সাধারণত একটানা পরবর্তী chronological period নয়। block জুড়লে দীর্ঘমেয়াদি dependence, seasonality বা economic regime-এর ক্রম ভেঙে যেতে পারে। S combination-এর সংখ্যা এবং প্রতিটি block-এর সময়কাল দুটোই ঠিক করে; কৌশলের horizon ও গঠন ভেবে S বেছে নিন ও লিখে রাখুন। একই block পুনর্ব্যবহার হয় বলে বেশি combination মানে ততগুলো independent observation নয়।
মূল return-এর bias-ও statistic-এ আসে: survivorship, revised data, তখন অপ্রাপ্য feature, অবাস্তব fill, বাদ পড়া cost এবং ফল দেখার পর বাছা universe সব candidate history-কে ভুল দেখাতে পারে। CSCV নিজে থেকে overlapping label interval purge করে না, প্রতিটি split-এ পুরো model pipeline আবার fit করে না, বা preprocessing leakage আটকায় না। গবেষণার প্রশ্ন অনুযায়ী এসব স্পষ্টভাবে করতে হবে। Chronological protection-এর জন্য TimeSeriesSplit-এর official documentation ও purged validation guide দেখুন।
Maximum drawdown-এর মতো path-dependent metric-এ বিশেষ সতর্কতা দরকার: পাশাপাশি নয় এমন block জুড়লে path ও metric বদলাতে পারে। PBO paper বলে, Sharpe-এর মতো নয়, কিছু metric-এ observation-এর ক্রম গুরুত্বপূর্ণ। rank ব্যাখ্যার আগে order, gap, missing observation ও compounding কীভাবে সামলেছেন লিখুন।
পূর্ণ search record ও chronological evidence-এর পাশে PBO জানান
হিসাবের আগে candidate registry, ফল দেখার পর করা প্রতিটি পরিবর্তন, performance matrix, selection metric ও tie rule সংরক্ষণ করুন। T, N, S, block construction, C(S,S/2), OOS rank convention, estimated PBO ও logit distribution জানান। Absolute OOS performance, cost, turnover, drawdown এবং লোকসানি candidate-এর সংখ্যাও দিন; rank একা বলবে না সবাই দুর্বল কি না।
পরে আসা data-তে স্থির করা research process কেমন করে তা দেখতে walk-forward বা প্রকৃত chronological holdout ব্যবহার করুন। model ও threshold বাছার সময় final period বন্ধ রাখুন; বারবার দেখলে সেটিও আরেকটি selection set হয়। TimeSeriesSplit-এর মতো time-ordered tool নিজস্ব নথিভুক্ত assumption অনুযায়ী chronological fold বানায়, আর PBO candidate family-র আলাদা rank-ভিত্তিক বৈশিষ্ট্য মাপে।
তাই PBO label-overlap control, multiple-testing analysis, বাস্তবসম্মত execution model, prospective evaluation ও live monitoring-এর পরিপূরক, বিকল্প নয়। আরও পড়ুন ফাইন্যান্সে multiple testing ও false discovery rate এবং serial correlation অনুযায়ী Sharpe ratio সমন্বয়। কোনো একক statistic ঐতিহাসিক rank-কে স্থায়ী trading edge-এর প্রমাণে বদলায় না।
সাধারণ প্রশ্ন
Q1PBO কি বোঝায় যে কৌশলটির টাকা হারানোর সম্ভাবনা ওই পরিমাণ?
না। নির্দিষ্ট split-এ IS নির্বাচিত candidate OOS median-এ বা তার নিচে কতবার rank করে তা অনুমান করে। এটি ভবিষ্যৎ ক্ষতির probability বা calibrated live-return forecast নয়।
Q2CSCV কি walk-forward test-এর মতো?
না। CSCV অর্ধেক block selection set-কে complement-এর সঙ্গে জোড়ে, ফলে OOS-এ আগের ও পরের block দুটোই থাকতে পারে। Walk-forward প্রতিটি পরবর্তী test period-এর আগে training রাখে, যাতে chronological deployment-সদৃশ পথ দেখা যায়।
Q3PBO কম হলে কি নির্বাচিত কৌশলে edge প্রমাণ হয়?
না। দুর্বল candidate set-কে জিতেও কৌশলটি absolute return-এ লোকসান করতে পারে। Net return, uncertainty, cost, leakage ও সত্যিকারের পরবর্তী data-তে performance আলাদা করে যাচাই করুন।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
কোন ঘটনাটি estimated PBO-তে অবদান রাখে?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
The probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
বিস্তারিত গাইড পড়ুনঅপশন অ্যাসাইনমেন্টএক্সারসাইজ নোটিশের পর চুক্তি পূরণের দায় অপশন বিক্রেতার ওপর বণ্টিত হওয়ার প্রক্রিয়া, যাতে শেয়ার দেওয়া বা কেনার বাধ্যবাধকতা তৈরি হতে পারে।
বিস্তারিত গাইড পড়ুন