

Purged cross-validation ও embargo: ট্রেডিং মডেলে লেবেল লিকেজ ঠেকানো
আর্থিক টাইম সিরিজে forward label ওভারল্যাপ হলে purging ও embargo কীভাবে কাজ করে, এবং এগুলো walk-forward, TimeSeriesSplit ও CPCV থেকে কীভাবে আলাদা তা বুঝুন।
এই গাইডেRandom fold কেন বিভ্রান্তিকর ফল দিতে পারে?
সংক্ষিপ্ত সারাংশ
forward label-এর ফলাফলের সময়সীমা একে অপরের সঙ্গে মিলে গেলে random split প্রশিক্ষণ ও পরীক্ষার মধ্যে তথ্য ফাঁস করতে পারে। Purging এমন training sample বাদ দেয় যার outcome interval test sample-এর outcome-এর সঙ্গে ওভারল্যাপ করে। Embargo হলো কিছু split-এ test block-এর পরে আলাদা একটি buffer। কোনোটিই নিজে থেকে সময়ক্রম ঠিক করে না বা feature তৈরির ভুল সারায় না।
Random fold কেন বিভ্রান্তিকর ফল দিতে পারে?
Random K-fold সারিগুলো এলোমেলোভাবে training ও test fold-এ ভাগ করে। আর্থিক সিরিজে পর্যবেক্ষণ পরস্পর নির্ভরশীল হলে বা তাদের forward outcome interval ওভারল্যাপ করলে এটি সমস্যা তৈরি করতে পারে। Training sample-এর label এমন তারিখের রিটার্ন অন্তর্ভুক্ত করতে পারে যা test sample-এর label-এও আছে। তাতে পরীক্ষা এমন সহজ হয় যা ভবিষ্যতের অদেখা সময়ে বাস্তব পূর্বাভাসের মতো নয়।
তবে K-fold-এর প্রতিটি ব্যবহার ভুল নয়। পদ্ধতিটি উপযুক্ত কি না তা নির্ভর করে মূল্যায়নের প্রশ্ন, sample কীভাবে তৈরি, সময়গত নির্ভরতা এবং label-এর সংজ্ঞার ওপর। কেবল দৈনিক return row এলোমেলোভাবে ভাগ করলেই তাদের প্রতিনিধিত্ব করা সময়কাল যাচাই হয়ে যায় না।
সিদ্ধান্তের সময়, feature এবং label interval সংজ্ঞায়িত করুন
প্রতি sample-এর সিদ্ধান্তের সময় t, তখন বাস্তবে উপলভ্য তথ্য, feature window, target/label interval এবং label নিষ্পত্তির শেষ সময় t1 লিখুন। পাঁচ trading session-এর forward-return label হলে interval (t,t+5]: সিদ্ধান্তের পরে শুরু হয়ে পঞ্চম session-এর শেষে শেষ হয়।
প্রতিটি feature-এ শুধু সেই তথ্য থাকা উচিত যা prediction-এর সময় t-তে জানা সম্ভব ছিল। অতীতের একই price history দুই feature window-তে থাকা নিজে থেকেই leakage নয়; কৌশল আগে থেকে জানা বাজার-ইতিহাস ব্যবহার করতেই পারে। কিন্তু ভবিষ্যতের মান বা সিদ্ধান্তের পরে প্রকাশিত data revision ব্যবহার করলে তথ্য ফাঁস হয়। Label-এর দৈর্ঘ্য ভিন্ন হলে প্রতিটি event-এর প্রকৃত শুরুর ও শেষের timestamp রাখুন।
Test label-এর সঙ্গে মেলা training sample বাদ দিন
Training sample-এর বাস্তব outcome/label interval কোনো test sample-এর outcome interval-এর সঙ্গে ওভারল্যাপ করলে purging সেটিকে বাদ দেয়। এর জন্য সময়ের interval তুলনা দরকার, fold boundary-র দুই পাশে সুবিধামতো কয়েকটি row বাদ দেওয়া নয়। Event label-এর মেয়াদ আলাদা হলে actual event start/end timestamp ব্যবহার করুন; সুবিধার জন্য স্থির row-count বসাবেন না।
Francisco López de Prado-র Advances in Financial Machine Learning-এর অধ্যায় ৭-এ cross-validation ও purging দিয়ে তথ্য-ওভারল্যাপ সামলানোর আলোচনা আছে। ওভারল্যাপ করা label বাদ দিলেই split কালানুক্রমিক হয় না: test block-এর পরের observation-ও training-এ থাকতে পারে। তাই split-টিকে ভবিষ্যৎ deployment-এর অনুকরণ বলার আগে কোন প্রশ্নের উত্তর দিচ্ছে তা ঠিক করুন।
দিন ধরে একটি ওভারল্যাপের উদাহরণ
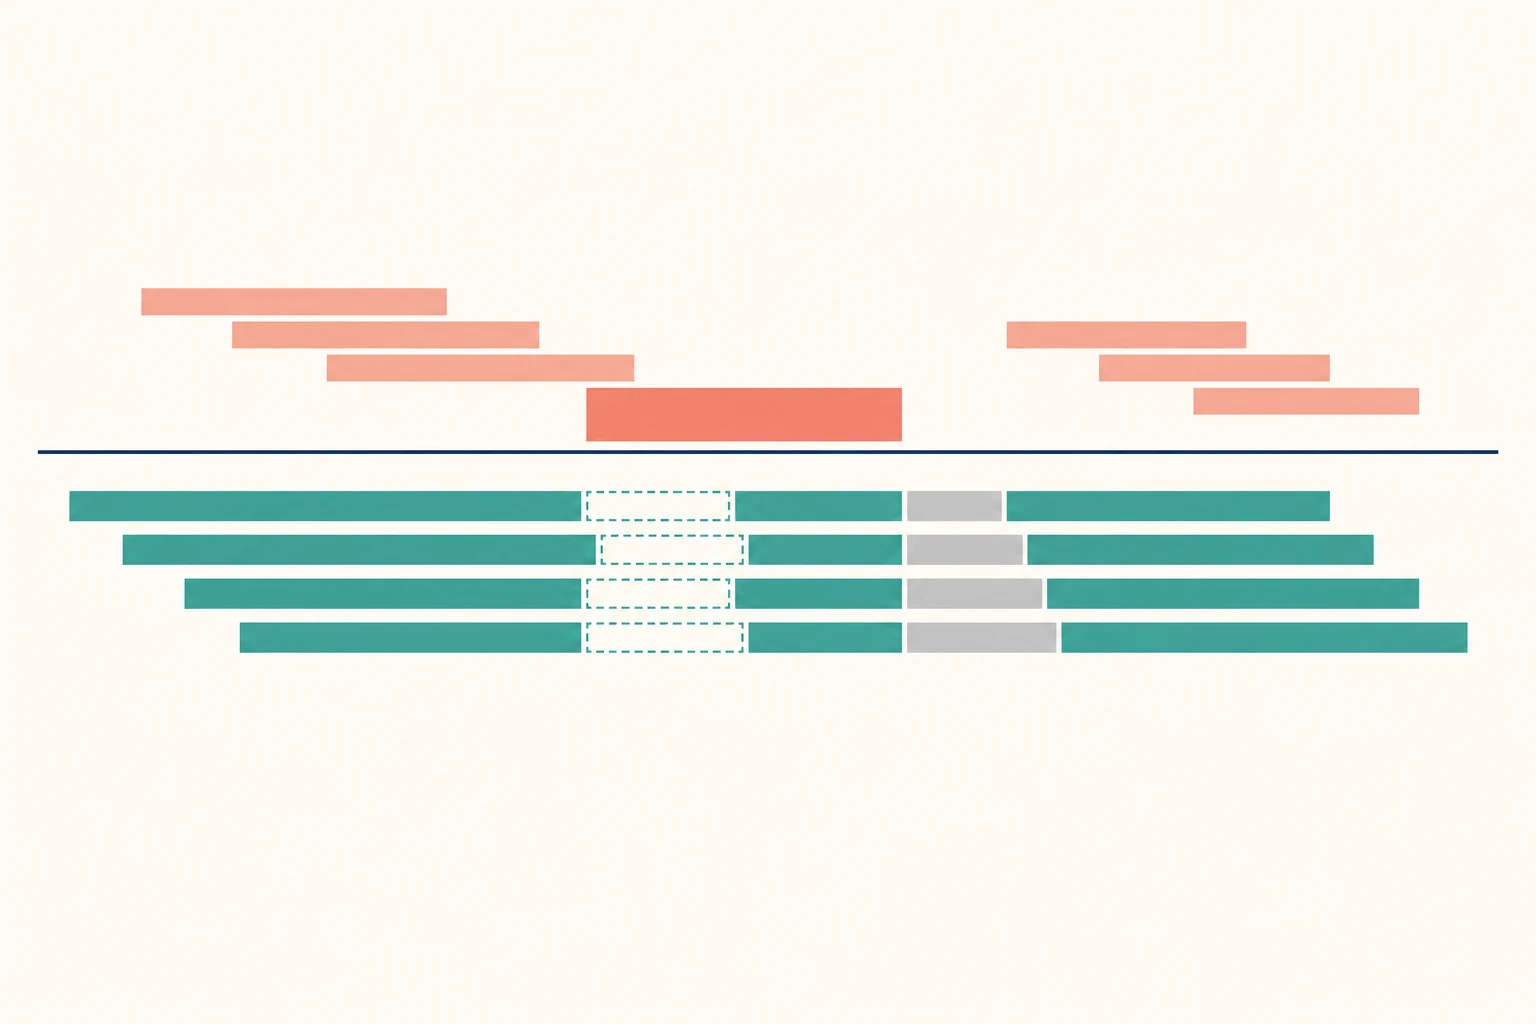
ধরা যাক প্রতিদিন সিদ্ধান্ত নেওয়া হয় এবং forward outcome পাঁচ session, তাই প্রতিটি label interval (t,t+5]। Test decision date 11–15 হলে test label-গুলো day 20 পর্যন্ত যায়। এখানে দিনগুলো ধারাবাহিক trading session সংখ্যা, এবং interval-এর ডান প্রান্ত অন্তর্ভুক্ত—বন্ধনীটি সেটাই বোঝায়।
Training label (7,12] test label-এর সঙ্গে ওভারল্যাপ করে—যেমন day 11-এ শুরু হওয়া test outcome-এর সঙ্গে—তাই সেটি purge হয়। (16,21] interval-টিও day 15-এ শুরু হওয়া test outcome-এর সঙ্গে মেলে, যা day 20-তে শেষ হয়; এটিও purge হবে। এখানে সিদ্ধান্তটি interval-এর ওভারল্যাপ দেখে, সারির মধ্যে স্থির ব্যবধান ধরে নয়।
পরে আসা কোনো sample-এর label test outcome-এর সঙ্গে না মিললেও, আলাদা embargo বেছে নিলে সেটি test block-এর পরের buffer-এ পড়ে training থেকে বাদ যেতে পারে। এটি কেবল উদাহরণ; সব data বা strategy-র জন্য এক দৈর্ঘ্যের gap নির্দেশ করে না।
Embargo-কে আলাদা ও যুক্তিসহ buffer হিসেবে দেখুন
Embargo হলো test block-এর পরে নির্দিষ্ট করা buffer, যা test-এর পরের observation-গুলোকে training-এ নেওয়ার আগে অপেক্ষা করায়—যে split-এ test-এর আগে ও পরে দুই দিকের data-ই training-এ থাকতে পারে। সরাসরি label interval না মিললেও event বা feature construction থেকে বাকি থাকা dependence কমাতে এটি সাহায্য করতে পারে।
কোনো সার্বজনীন শতাংশ বা মেয়াদ নেই, আর এটি actual label-interval পরীক্ষা প্রতিস্থাপন করে না। Sampling frequency, label horizon, feature তৈরির নিয়ম এবং নির্ভরতার ধরন দেখে buffer ঠিক করুন এবং কারণটি নথিভুক্ত করুন। অতিরিক্ত দীর্ঘ embargo দরকারি training data বাদ দিতে পারে; খুব ছোট buffer প্রাসঙ্গিক dependence ঠেকাতে নাও পারে।
প্রশ্ন অনুযায়ী validation পদ্ধতি তুলনা করুন
Random K-fold observation-গুলোকে এলোমেলোভাবে ভাগ করে; dependent sample বা overlapping label থাকলে ভবিষ্যৎ সময়ে পূর্বাভাসের অনুকরণ নাও হতে পারে। Walk-forward বা rolling-origin validation অতীত দিয়ে train করে পরের সময়ের block-এ test করে, তারপর boundary সামনে এগিয়ে দেয়। ঐতিহাসিক deployment-এর কাছাকাছি হলেও এটি feature leakage বা test-data-তে model selection নিজে থেকে ঠেকায় না।
scikit-learn-এর TimeSeriesSplit ক্রমানুসারে split দেয় এবং gap option training ও test-এর মাঝে নির্দিষ্ট সংখ্যক row বাদ দেয়। সরকারি ডকুমেন্টেশন বলে, test duration-গুলোর তুলনা করতে sample-গুলো সমান ব্যবধানে থাকা দরকার; gap row গোনে, variable event-time label যাচাই করে না। Purged K-fold actual label overlap বাদ দিতে পারে, কিন্তু test block-এর পরের row-ও train করতে পারে। Combinatorial purged CV (CPCV) একাধিক test-group সমন্বয়ে একাধিক path তৈরি করে; এটিও স্বয়ংক্রিয়ভাবে ঐতিহাসিক chronological simulation নয় এবং অন্য leakage দূর করে না।
López de Prado-র Advances in Financial Machine Learning-এর অধ্যায় ১২-এ walk-forward ও CPCV পদ্ধতি এবং তাদের ব্যবহার নিয়ে আলোচনা আছে।
Label-এর বাইরেও leakage-এর উৎস খুঁজুন
Feature ভুলভাবে timestamp করা বা ভবিষ্যৎ তথ্য থেকে তৈরি হলে, বর্তমান database-এ পরবর্তী সংশোধন বা কেবল টিকে থাকা securities থাকলে split-পরবর্তী ফলও বিভ্রান্তিকর হতে পারে। পুরো dataset-এ preprocessing বা feature selection চালিয়ে পরে fold ভাগ করলেও test তথ্য training-এ ঢুকে যায়।
অনেক model variant পরীক্ষা করে সেরা ফলটি বেছে নিলে, label আলাদা থাকলেও selection bias তৈরি হয়। অবাস্তব trading cost বা প্রতিটি order অনুমিত দামে পূর্ণ হবে ধরে backtest করলে ফল ফুলে উঠতে পারে। Bailey ও সহলেখকদের Probability of Backtest Overfitting গবেষণা বহু পরীক্ষার মধ্যে সেরা ফল বেছে নেওয়ার ঝুঁকি বিশ্লেষণ করে। Fold তৈরি করার পদ্ধতি একা এসব সমস্যা মেটায় না।
Preprocessing ও selection training fold-এর ভেতরে করুন
প্রতি fold-এ transformation, feature selection ও parameter choice কেবল training data দিয়ে fit করুন। Nested time-aware validation ব্যবহার করে candidate-গুলো যাচাই করুন, যাতে outer test fold-কে একই সঙ্গে model বাছাই এবং performance মাপার কাজে না লাগে।
পদ্ধতি স্থির হলে শেষের একটি chronological সময়সীমা একেবারে untouched final holdout হিসেবে রাখুন। তার ফল দেখে বারবার model বদলে সেই সময়কে স্বাধীন পরীক্ষা বলা যাবে না। Cross-validation নির্দিষ্ট split ও data-তে performance মাপে; ভবিষ্যৎ ফলের নিশ্চয়তা দেয় না।
Validation পদ্ধতি পুনরায় করা যায় এমনভাবে লিখুন
Sample-এর সংজ্ঞা, decision time, feature source ও কখন জানা গিয়েছিল, প্রতিটি feature window, এবং label interval (t,t1] নথিভুক্ত করুন। Split পদ্ধতি, fold, purging-এর interval rule, embargo-র দৈর্ঘ্য ও যুক্তি, এবং TimeSeriesSplit ব্যবহার করলে gap-এর row count জানান।
Training-এ test-এর পরের observation ছিল কি না, খরচ ও fill কীভাবে ধরা হয়েছে এবং model selection কোন fold-এ হয়েছে তা লিখুন। আরও পড়ুন: বায়াস-ভ্যারিয়েন্স ট্রেড-অফ ও আর্থিক মডেলের ওভারফিটিং, ফাইন্যান্সে multiple testing ও false discovery rate, এবং সিরিয়াল সম্পর্কসহ শার্প অনুপাত বার্ষিকীকরণ।
সাধারণ প্রশ্ন
Q1Random K-fold কি আর্থিক ডেটার জন্য সব সময় ভুল?
না। মূল্যায়নের প্রশ্ন ও sample structure-এর সঙ্গে মিললে এটি কাজে লাগতে পারে। কিন্তু সময়গত dependence বা outcome interval-এর overlap ফলকে বিভ্রান্ত করতে পারে, তাই পদ্ধতি বাছার আগে sample ও label পরীক্ষা করুন।
Q2Embargo কি purging-এর বিকল্প?
না। Purging outcome interval মিলে যাওয়া training sample বাদ দেয়। কিছু split-এ embargo test block-এর পরে আলাদা buffer বাদ দেয়। দুটির ভূমিকা আলাদা; কোনোটিই prediction time-এ অজানা feature ব্যবহারের ভুল ঠেকায় না।
Q3CPCV কি ভবিষ্যৎ performance নিশ্চিত করে?
না। CPCV নির্দিষ্ট split পদ্ধতিতে একাধিক test path তৈরি করে। এটি data leakage, বহুবার পরীক্ষা বা ভবিষ্যতের বাজার ও execution-এর অনিশ্চয়তা দূর করে না।
উৎস ও আরও পড়ুন
সমস্যা জানান
এই নিবন্ধের লিংকসহ একটি ইমেল তৈরি হবে। পাঠানোর পরেই Mark প্রতিবেদনটি পাবে
দ্রুত যাচাই
গাইডটি পড়ার পর 3টি প্রশ্নে নিজেকে যাচাই করুন
প্রশ্ন 01
Purging-এ কোন অবস্থায় একটি training sample বাদ দেওয়া উচিত?
ব্যাখ্যা দেখতে একটি উত্তর বেছে নিন
অপশন শব্দকোষ
The relationship between systematic prediction error from model mismatch and instability caused by sensitivity to the training sample.
বিস্তারিত গাইড পড়ুনFamily-wise error rateThe probability of falsely rejecting at least one true null hypothesis within a predefined family of tests.
বিস্তারিত গাইড পড়ুনঅপশন অ্যাসাইনমেন্টএক্সারসাইজ নোটিশের পর চুক্তি পূরণের দায় অপশন বিক্রেতার ওপর বণ্টিত হওয়ার প্রক্রিয়া, যাতে শেয়ার দেওয়া বা কেনার বাধ্যবাধকতা তৈরি হতে পারে।
বিস্তারিত গাইড পড়ুন