

用预平均法估计实现波动率:微观结构噪声下的估计量
了解预平均法如何平滑高频短收益窗口、校正主要噪声偏差、选择窗口长度,以及它与 TSRV 和 realized kernel 的区别。
本指南内容为什么过于频繁的收益会扭曲价格变动
简短摘要
预平均法(pre-averaging)用于估计含有微观结构噪声的高频记录价格变动。它不逐个平方原始收益,而是在重叠窗口中对相邻收益加权求和,再减去主要噪声贡献的校正项。结果取决于权重形状、窗口长度、采样设计和噪声假设。它衡量已观测区间内的变动,不是波动率预测或交易信号。
为什么过于频繁的收益会扭曲价格变动
如果观测价格就是有效价格,没有其他成分,那么日内收益平方和可以自然地估计该时段的变动。但实际成交价和报价还包含买卖价反弹、最小价位舍入、延迟、价格离散化和记录方式的影响。采样间隔非常短时,这些因素可能占每个平方收益的很大比例。因此,增加观测数可能提高噪声贡献,而不只是揭示更多基础价格走势。
预平均法在平方之前,先把短局部窗口内的收益合并。平滑权重从零开始上升,对邻近收益赋权,再在窗口边界回到零。加权和相当于局部滤波:快速且独立的观测误差可能部分抵消,而有效价格较宽泛的走势仍可能保留。重叠窗口让估计使用整个区间的信息。
平滑本身不会让估计量变成无偏估计。滤波后的噪声仍会贡献变动,因此需要校正项。Jacod、Li、Mykland、Podolskij 和 Vetter 在明确假设下推导了用于积分波动率的预平均方法,并指出合适的版本可达到 \(n^{-1/4}\) 收敛速度。原始论文奠定了方法基础;本文聚焦估计量的机制、选择和局限。
区分潜在价格、记录价格与目标量
令 \(X_{t_i}\) 表示观测时刻 \(t_i\) 的潜在有效对数价格,\(Y_{t_i}\) 表示记录的对数价格:
\[ Y_{t_i}=X_{t_i}+\epsilon_{t_i}, \]
其中 \(\epsilon_{t_i}\) 是观测噪声。常见基准模型将 \(X_t\) 视为局部方差为 \(\sigma_t^2\) 的连续半鞅。固定区间 \([0,T]\) 上的目标量是积分方差:
\[ IV_T=\int_0^T \sigma_t^2\,dt. \]
观测收益可写为 \(\Delta_iY=\Delta_iX+\epsilon_{t_i}-\epsilon_{t_{i-1}}\)。即使价格误差在观测时刻间相互独立,相邻收益误差也会以相反符号共享一个端点。这会使收益出现序列相关,并让全样本实现方差对含噪增量的数量敏感。
简单的理论说明通常假设噪声均值为零、在时间上独立、与有效价格过程独立,并具有合适的有限阶矩。这些假设有助于解释估计量,但对成交、报价或中间价并无保证。噪声可能随流动性和时段变化,可能依赖有效价格,也可能具有序列相关。目标量也很重要:存在跳跃时,二次变差包含跳跃平方,而连续积分方差不包含。
这是针对指定价格序列和时间窗口的事后测量。它不会重建每个潜在价格,不会识别哪一笔记录出错,也不会告诉分析者未来波动率。比较估计结果前,应说明输入是成交价、报价中点还是其他构造。
构造重叠的预平均收益
对于 \(n\) 个观测收益 \(r_i=Y_{t_i}-Y_{t_{i-1}}\),选择整数窗口长度 \(k_n\) 和定义在 \([0,1]\) 上的权重函数 \(g\)。一种标准的预平均收益为
\[ \bar r_i=\sum_{j=1}^{k_n-1}g\!\left(\frac{j}{k_n}\right)r_{i+j}, \qquad i=0,\ldots,n-k_n+1. \]
该函数通常连续、两端取零,并具有渐近结果所需的平滑性。三角权重的例子是 \(g(u)=\min(u,1-u)\)。由于窗口端点的权重为零,边缘收益不会突然得到完整权重。权重形状是一种局部滤波,不是预测或拟合出的趋势。
每个 \(\bar r_i\) 在平方前先合并相邻收益。由于窗口重叠,即使原始收益不相关,预平均收益仍会相关。这种依赖属于估计量的抽样行为;不能把大量窗口和视为独立观测。窗口索引范围和端点约定必须与权重归一化相匹配。
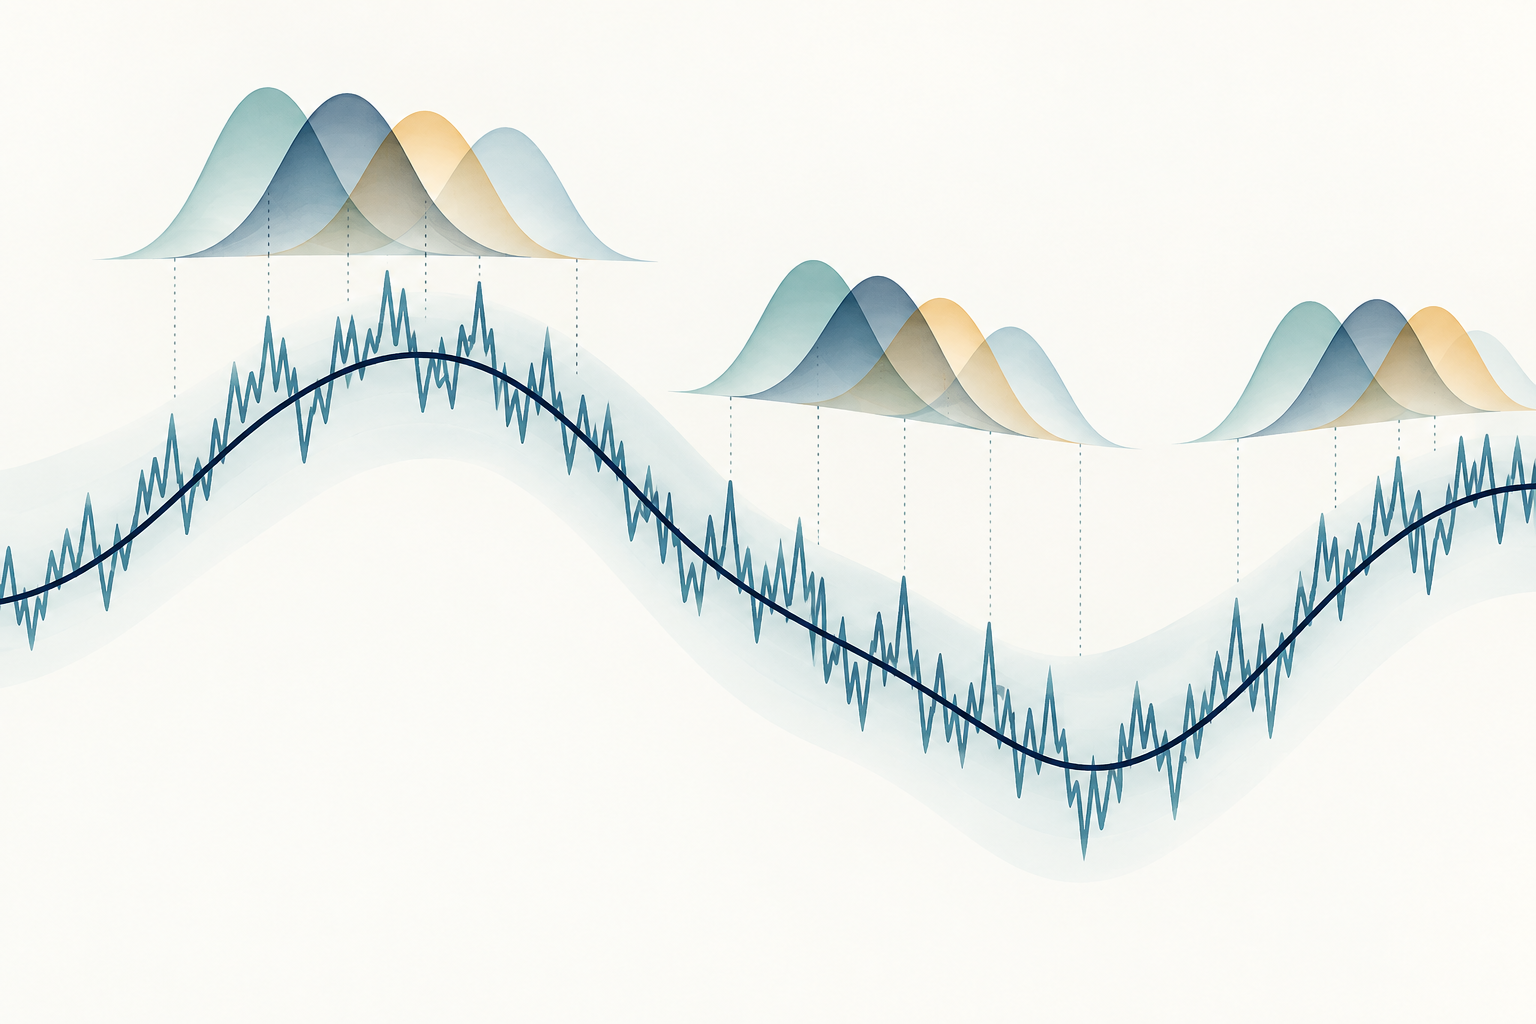
示意图展示平滑的潜在路径、锯齿状的观测路径,以及数个权重在两端递减的重叠窗口。它用于说明局部合并,不是样本价格记录或经验滤波结果。
<!-- learn:illustration --> <!-- 无文字概念图:平滑的潜在价格曲线与锯齿状的观测路径并列,数个重叠、两端权重渐弱的局部窗口汇集相邻变动。仅为概念示意;不是市场数据、预测或交易信号。 -->
校正剩余的噪声贡献
预平均会减弱快速观测误差的影响,但滤波收益的平方仍包含噪声贡献。在规则网格下,使用渐近归一化常数的一种常见单变量估计量形式为
\[ \widehat{IV}_{PA} =\frac{1}{k_n\psi_2}\sum_{i=0}^{n-k_n+1}\bar r_i^2 -\frac{\psi_1}{2\psi_2 k_n^2}\sum_{i=1}^{n}r_i^2, \]
权重常数为
\[ \psi_1=\int_0^1 \{g'(u)\}^2\,du, \qquad \psi_2=\int_0^1 g(u)^2\,du. \]
第一项重新缩放预平均收益平方和,使其接近积分方差。第二项在模型假设下估计并扣除观测噪声的主要贡献。它不会估计每次噪声实现,也无法纠正错误的价格字段、时间戳或异常值。精确的有限样本公式可能采用 \(\psi_1\) 和 \(\psi_2\) 的离散版本、端点修正以及特定的收益索引规则。应报告并一致使用这些细节。
有限样本下,校正后的估计可能很小或为负。这不表示资产具有负的物理方差,而表示该样本中所选校正项超过了第一项。不要默默将负估计设为零。应报告原始计算和任何单独的截断规则,因为截断会改变估计量,并可能影响后续平均或推断。
根据噪声和样本选择窗口长度
窗口 \(k_n\) 控制平滑程度。窗口过短,滤波收益会残留更多高频噪声;窗口过长,局部价格变动会在更宽的时间范围内平均,可用窗口也更少,其他估计误差可能因此增加。权重与窗口长度共同发挥作用;不结合权重函数和采样间隔,单独的 \(k_n\) 没有明确含义。
在固定时间跨度、观测频率随 \(n\) 增加的经典平衡设计中,窗口按 \(\sqrt n\) 的量级增长,常写为 \(k_n\sim\theta\sqrt n\),其中 \(\theta>0\) 是调节常数。在论文假设下,估计量的收敛速度可为 \(n^{1/4}\),即估计误差为 \(n^{-1/4}\) 的量级。这比无噪声时的 \(n^{1/2}\) 速度慢,也是作者研究的基准噪声情形下的最优速度;它并非对所有市场数据集的保证。
\(\theta\)、权重函数和数据驱动的窗口选择都会影响有限样本偏差与方差。自动选择可能依赖本身存在不确定性的噪声和波动率估计。应展示几个合理窗口下的敏感性,说明采样时钟和交易时段边界,并避免在看到哪个窗口最支持预设结论后再作选择。
一个简单的假设计算
取六个假设的观测收益,单位为基点:
\[ (r_1,\ldots,r_6)=(1,0,1,0,1,0)\ \mathrm{bp}. \]
使用三角权重 \(g(u)=\min(u,1-u)\) 和刻意设短的窗口 \(k=3\)。两个非零的网格内部权重为 \(g(1/3)=g(2/3)=1/3\)。为展示有限网格上的算术,定义
\[ \psi_{2,k}=\frac{1}{k}\sum_{j=1}^{k-1}g(j/k)^2=\frac{2}{27}, \qquad \psi_{1,k}=k\sum_{j=1}^{k}\{g(j/k)-g((j-1)/k)\}^2=\frac{2}{3}. \]
按上述索引约定,有 \(n-k+2=5\) 个重叠窗口。每个窗口都合并相邻的 \(1\) bp 和 \(0\) bp 收益,因此 \(\bar r_i=(1/3)(1+0)=1/3\) bp,并且
\[ \sum_i\bar r_i^2=5\left(\frac13\right)^2=\frac59\ \mathrm{bp}^2, \qquad \sum_{i=1}^{6}r_i^2=3\ \mathrm{bp}^2. \]
使用相应的有限网格归一化,可得
\[ \widehat{IV}_{PA} =\frac{1}{3(2/27)}\left(\frac59\right) -\frac{2/3}{2(2/27)3^2}(3) =2.5-1.5=1\ \mathrm{bp}^2. \]
该例用于检查算术和单位;六个收益和三个观测尺度的短窗口不足以支持渐近近似。数值仅为清楚展示计算而设,不是市场数据、模拟噪声过程,也不能证明估计恢复了隐藏的积分方差。这里没有计算标准误或预测。
了解校正所依赖的假设
标准推导针对在正则条件和加性噪声下被频繁观测的连续有效价格过程。零均值独立噪声是有用的起点,但噪声与价格相关、误差存在序列相关、噪声随时间变化、观测时点不规则或采样具有内生性,都可能需要修改估计量或专门的理论。Aït-Sahalia、Mykland 和 Zhang 研究依赖型微观结构噪声下的积分波动率估计;他们的论文说明了为何 iid 噪声公式并非普遍适用。
跳跃会带来另一项目标选择问题。若目标是二次变差,跳跃平方包含在目标量内;若目标是连续积分方差,则不包含。标准预平均估计不会自动分离跳跃。抗跳截断或其他构造需要自身的假设和调节参数。一笔极端记录还可能影响多个重叠窗口,因此数据验证和异常值处理仍然必要。
预平均也不能单独解决多变量或异步数据的所有问题。Christensen、Kinnebrock 和 Podolskij 在研究中提出预平均协方差方法,以及针对非同步观测、抗噪声的 Hayashi–Yoshida 扩展。这些构造处理了额外的数据设计问题。对每个资产分别应用单变量公式,并不会自动同步时间戳,也不保证得到有效的协方差矩阵。
区分预平均、TSRV 与 realized kernel
这些估计量处理相关的高频变动问题,但组织信息的方式不同。Two-scale realized volatility(TSRV)对平移后的稀疏采样网格上的估计取平均,再减去经缩放的密集网格估计,以校正主要噪声偏差。预平均则先用平滑权重过滤短而重叠的收益窗口,再将滤波收益平方并作匹配校正。两尺度原始论文介绍了另一种构造。
Realized kernel 从收益平方和出发,加入不同滞后阶的加权收益自协方差,并用带宽控制所纳入的滞后范围。预平均则在平方之前改变局部收益。两种方法都使用权重和调节选择,但公式、归一化和假设不能互换。Realized kernel 指南介绍基于滞后的构造和带宽讨论。
方法选择应取决于数据与所需量,而不是估计量名称。应比较采样设计、噪声模型、端点处理、跳跃下的目标量和有限样本表现。渐近抗噪并不保证某种方法最适合稀疏资产、短交易时段、时变噪声或不规则数据流。Two-scale 指南说明其尺度与校正选择。
报告区间测量,不作交易结论
为使结果可复现,应注明资产与价格字段、时间区间、采样频率、时间戳与交易时段规则、收益单位、权重函数、窗口长度、归一化、端点约定和噪声假设。若用于统计推断,还应报告方差估计量或置信区间方法及其假设。比较若干合理窗口的敏感性表,可显示结论是否依赖某一种调节选择。
积分方差衡量已经结束的观测区间。平方根表示同一区间的波动率尺度;年化需要额外的时间约定,但不会把数值变成预测。预测未来期限需要单独的预测模型和样本外评估。实现波动率计算指南介绍平方收益和基准,二次变差指南则区分路径变动与连续积分方差目标。
估计结果不能说明价格为何变动,不能证明某种策略盈利,也不保证可执行的风险测量。交易成本、流动性、跳跃、波动率动态和估计不确定性都是独立问题。预平均是一种统计测量工具,其价值取决于假设与观测数据是否相符。
常见问题
Q1预平均等同于对价格取移动平均吗?
不等同。该估计量对相邻收益加权求和,再平方并作校正。先平均价格水平再求差是另一种变换,其权重和边界行为都不同。
Q2预平均能消除所有微观结构噪声吗?
不能。它只在特定噪声和采样假设下减弱主要影响。相关或时变噪声、跳跃、异常值和时间戳问题仍会影响结果。
Q3为什么不同的预平均估计会有差异?
可能采用不同的权重函数、窗口长度、有限样本归一化、价格字段、端点规则或数据清理流程。应报告这些选择并检查敏感性。
Q4预平均估计是波动率预测吗?
不是。它本身只衡量用于计算的区间内的变动。预测需要单独的预测模型和样本外评估。
资料来源与延伸阅读
报告问题
我们会准备一封包含本文链接的邮件。发送后,Mark 才会收到你的反馈
快速检查
读完指南后,用 3 道题检查一下
问题 01
构造预平均收益的主要目的是什么?
选择答案即可查看解释